データ前処理の手順:ビジネスデータをクレンジングする方法
データ前処理の手順を学び、乱雑なビジネス記録を信頼できるインサイトに変えましょう。中小企業向けの例を交えて解説します。ELECTE がそれらをどう自動化するかもご覧ください。
見た目は完成している売上エクスポートを取り出したとします。シートには注文、コスト、日付が並んでいます。ところが、その予測が財務責任者の手元に届くと、カタログには何の変更もないのに平均注文額が急に跳ね上がっていました。
この急上昇は、購買行動の変化ではなく前処理のミスが原因であることがよくあります。重複した請求書がファイルに残ったまま空欄の価格を補完したり、行を分けて取り置く前に抽出データ全体をスケーリングしたりすると、モデルはまだ知るべきでない情報を学習してしまいます。多くの解説はデータ前処理の手順を、どんな順序でも適用できる個別の手法として並べています。しかし、結果を水増しするのはまさにその順序なのです。
ここでは、アナリストが実運用中のビジネスファイルを担当する際に私が推奨する手順を紹介します。実行順序、絶対的な決まりではなく出発点として扱っているしきい値、そして次回のデータ読み込みでも同じ処理になるよう、フィットさせた各設定を固定する方法をお伝えします。
正しい順序で行う7つのデータ前処理ステップ
売上エクスポートは一見完全に見えても、重複した請求書の行、空欄の単価、2種類の形式で保存された日付が隠れていることがあります。これらの問題を誤った順序で処理すると、以降のすべての平均値にその影響が引き継がれます。
データから数値を学習するステップは、すべて分割の後に実行してください。平均値、中央値、スケーリングの範囲をファイル全体で計算すると、検証用の行が学習に影響を与えてしまいます。その結果、スコアは実際のモデルが来月の注文に対して出せる性能よりも高く見えてしまいます。
ステップ | 実施内容 | 完了の目安 |
|---|---|---|
1. プロファイリングとクレンジング | 行数、データ型、欠損率を確認し、完全一致の重複を削除して、日付とラベルを標準化する | カテゴリごとにラベルが1つに統一されたクリーンなベーステーブルができている |
2. データの分割 | 行をシャッフルしてから、学習用データと検証用データに分ける | 2つのデータセットが用意され、学習済みの設定値はまだ一つも算出されていない |
3. 欠損値の処理 | 行を削除する、特徴量を削除する、または学習用データのみを使って補完する | すべての項目が埋まっているか、欠損箇所にフラグが付いている |
4. エンコードと特徴量エンジニアリング | カテゴリを数値に変換し、比率、時間要素、移動平均を作成する | 列の内容が文書化された、モデルに投入できる特徴量テーブルができている |
5. 外れ値の処理 | 極端な値を確認したうえで、上限・下限の設定、変換、またはフラグ付けを行う | 極端な値が推測ではなく根拠をもって説明されている |
6. 数値特徴量のスケーリング | 学習用データでスケーラーを適合させ、検証用データに適用する | 数値列が同程度の範囲にそろっている |
7. パイプラインの固定 | 適合済みの変換をすべて保存し、新しいデータにも同じ処理が適用されるようにする | 新しいデータを読み込むたびに再現できる実行手順が整っている |
ある小売業者が12,000行の注文明細を保有しており、そのうち900行が重複した請求書の行だとします。重複を削除する前に欠損している価格を補完すると、同じ請求書を二重に数えることになり、平均値が価格表から外れてしまいます。
実践ルール: 次の行が必要とする値を計算する前に、いま取り組んでいる行を最後まで終わらせましょう。
いま開いているファイルを、この7つの行に当てはめてみてください。まだ終わっていない最初の行だけが、今日手を付ける価値のある行です。
生の業務データをプロファイリングしてクレンジングする
プロファイリングは、モデルを開く前にマネージャーが1時間で終えられる作業です。元のファイルには手を加えず、すべての変更をクレンジングログに書き込んでください。そうすれば、合計が変わった理由を経理責任者が確認できます。
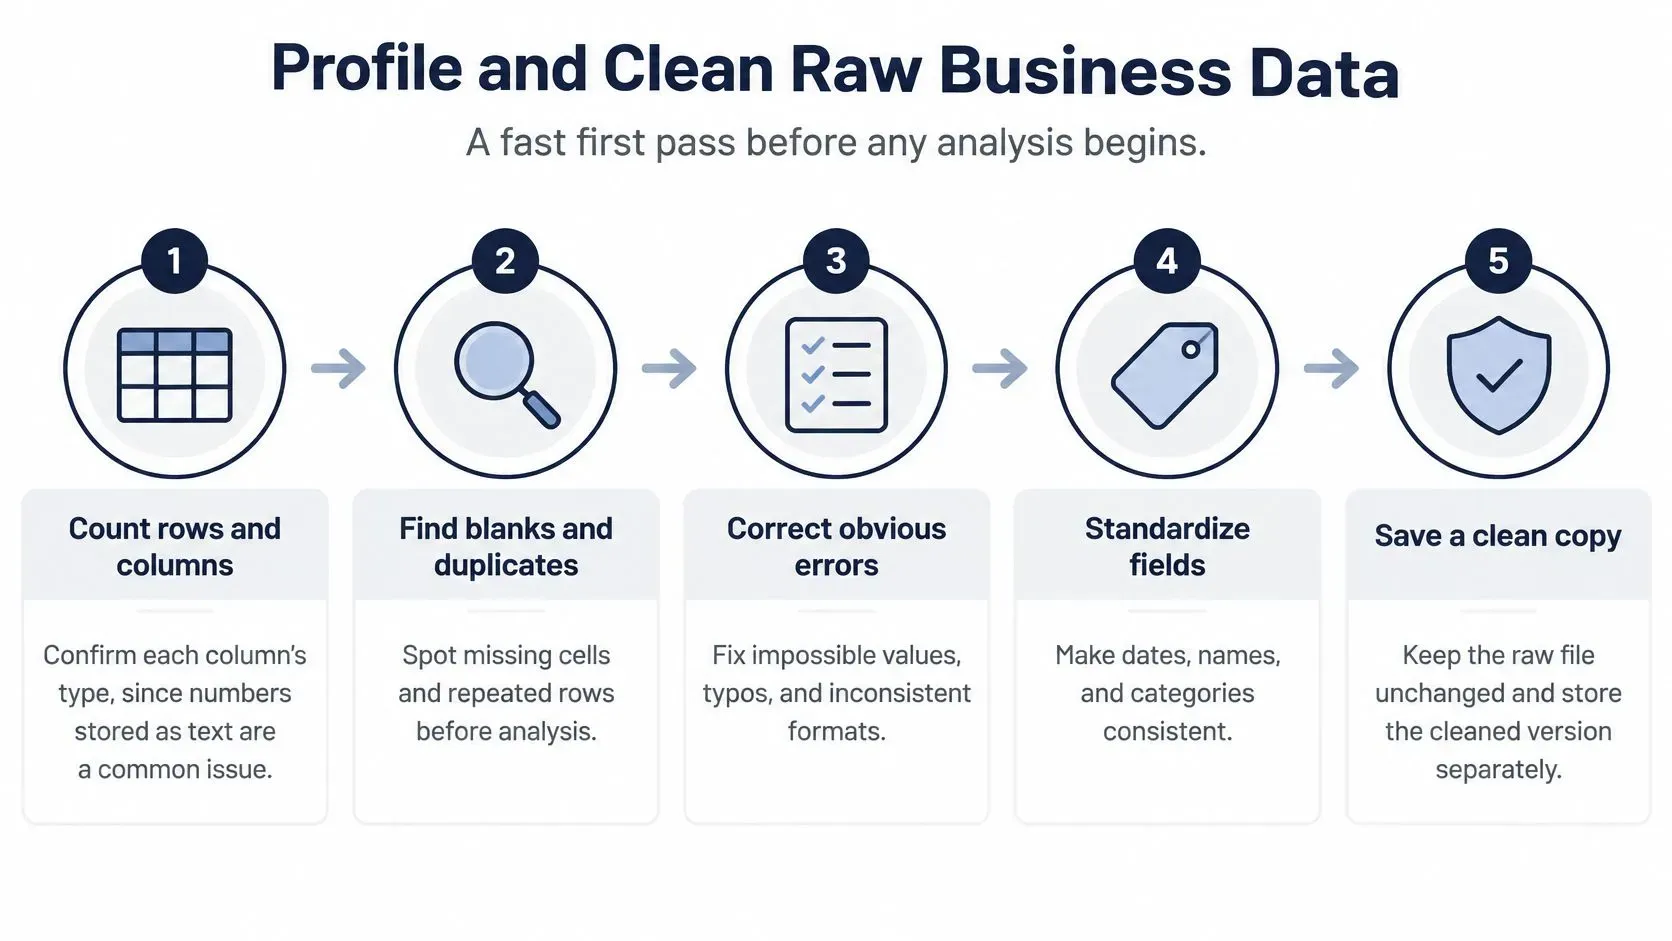
- 行数と列数を数え、各列のデータ型を確認します。 テキストとして保存されたコストは合計されず、しかもエラーも出ません。合計を信頼する前に変換してください。
- すべての列で欠損率を計算します。 空白が30%を超える列は、簡単な補完ではなく欠損値ルールに回します。列ごと削除するのは、空白が50%を超え、かつその項目が意思決定に必須でない場合に限るのがよいと考えます。
- 削除するのは完全一致の重複だけで、似ているだけの行は残します。 請求書番号、日付、金額を合わせて照合してください。明細IDが異なる2件目の注文は、実際の販売です。顧客と日付が同じだからという理由で削除すると、売上を過小に見積もるミスにつながります。
- フォーマットを一度にそろえます。 日付の形式は1つ、通貨は列ごとに1つ、コードに余分なスペースは入れません。形式が混在すると1つの製品が2つの系列に分かれ、後の結合も壊れます。
- カテゴリのラベルを標準化します。
UK、U.K.、United Kingdomは同じ市場です。3年分のECデータの出力で、1つの製品ラインが4通りの表記になっている場合も同じ被害が出ます。ラベルを1つ決めて、残りを対応付けてください。
そのエクスポートで、注文日がある年は2024-03-01、別の年は01/03/2024で保存されているとします。両方を1つの形式にそろえない限り、月次グラフでは3月が二重に数えられるか、抜け落ちてしまいます。
ログとプライバシー対策が守るもの
クレンジングログは短い表です。列、ルール、変更した行数、担当者、日付を記録します。経理から昨年3月の数字が小さくなった理由を聞かれたら、ファイルを記憶から再構築するのではなく、重複ルールを示せばよいのです。
ファイルを分析プラットフォームに渡す前に、顧客名、メールアドレス、支払い情報を取り除いてください。需要予測にこれらは不要です。抽出データに残しておくと、モデルでは取り返せないプライバシー上の問題が生じます。
営業関連の抽出データで「良い状態」とはどういうものか、別の視点も確認したい場合は、Pipecornの営業データ品質に関する知見が、識別子、網羅性、一貫性のチェックリストとして役立ちます。どの列を残す価値があるかの判断に使ってから、上記の欠損率による判断に戻ってください。
学習を始める前にデータを分割する
分割は防護柵です。統計量を推定する処理は、いっさい全データに対して行ってはいけません。
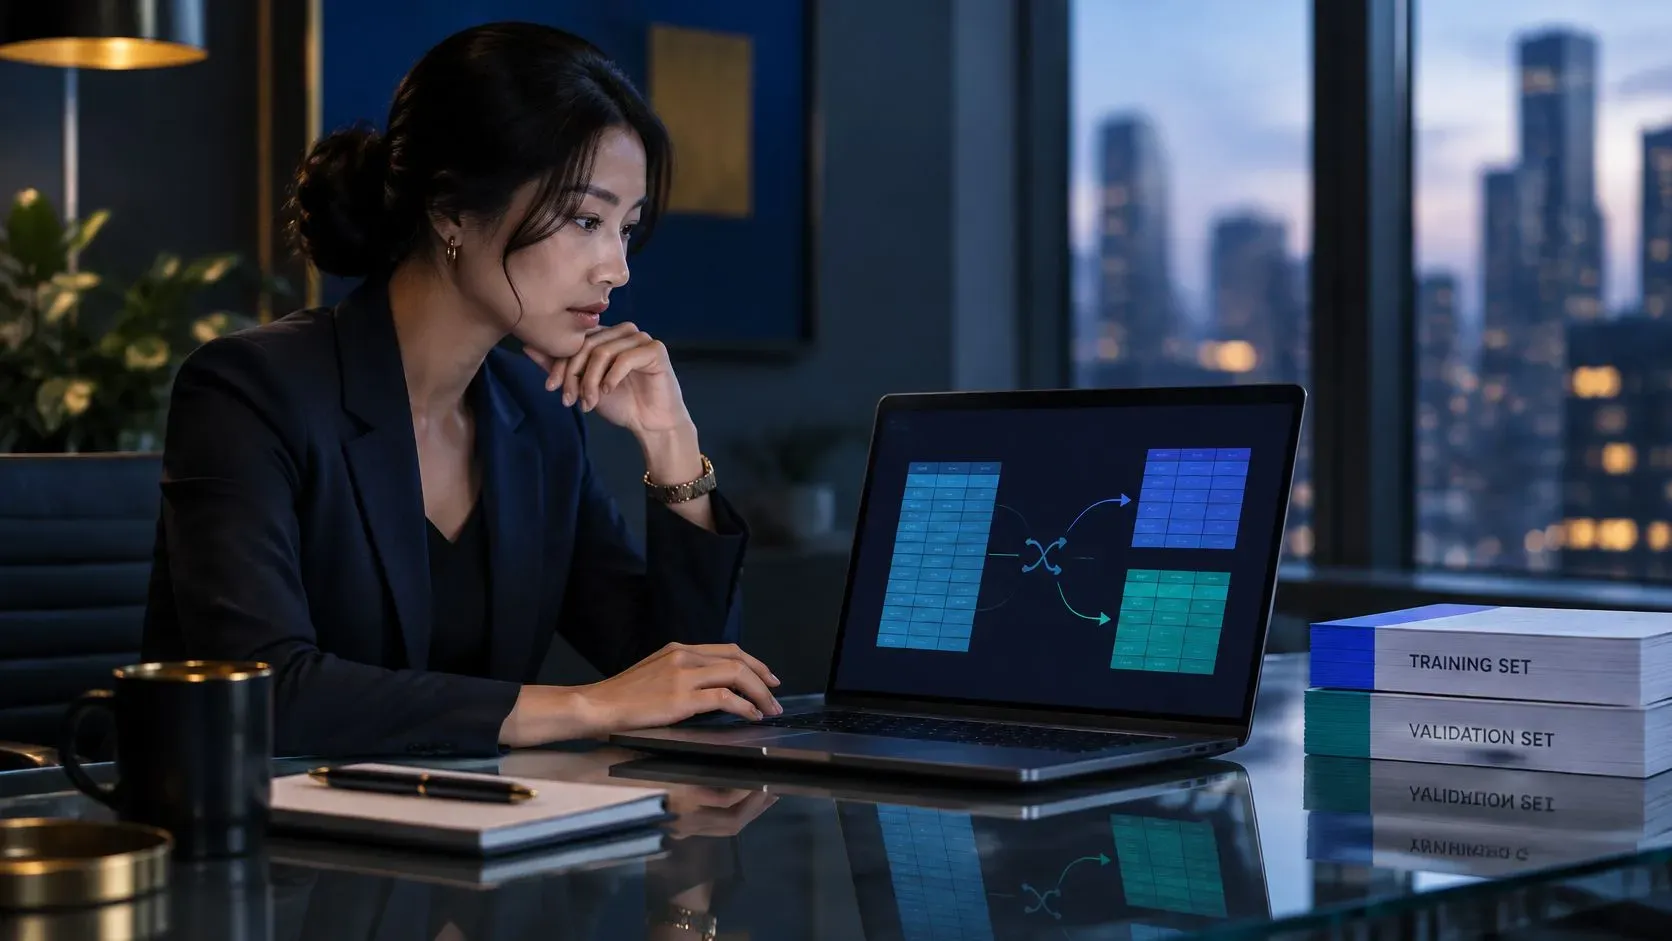
教師あり学習によるテキスト分類について、Googleのテキスト分類ガイドは、分割の前にデータをシャッフルするよう推奨しています。元の順序のままだと、両方のデータセットに偏りが生じるおそれがあるためです。シャッフル後は、一般的に例の80%を学習用、20%を検証用に分けます。その後、両方のデータセットに同じ変換を適用しますが、変換内容を学習するのは学習用の行だけに限ります。
並べ替え済みの売上ファイルが誤った結果を招く理由
エクスポートされたファイルは、日付、地域、顧客の順に並んでいることがよくあります。そのファイルを上から順に分割すると、2023年のデータで学習し、2024年後半のデータで検証することになります。すると、スコアはカレンダーやプロモーションの時期、あるいは特定の地域の構成比に左右されます。モデルが注文を正しく理解できているかどうかは、スコアからは分かりません。
各行が独立した事例である場合は、シャッフルします。たとえば、成約した注文、解約したアカウント、分類済みのチケットです。問いが予測である場合は、シャッフルしません。
予測では時間の順序を保ってください。以前の月で学習し、後の月でテストします。シャッフルすると、モデルが未来を見てしまい、それを実力として評価してしまいます。
テキストフィールドには出現頻度による絞り込みが必要
サポートチケットや商品説明は、数千ものトークンに膨れ上がります。同じGoogleのワークフローでは、出現回数が2回未満のトークンを破棄し、上位20,000個のトークン特徴量を残します。残ったものは、F検定にもとづく重要度スコアでランク付けします。1回しか出てこないトークンは、たいてい誤字か一度限りのSKUです。列として残す価値のあるパターンではありません。
分割後は、すべての変換マッピングを学習データだけで作成し、その固定したマッピングを検証データに適用します。ホールドアウトした行で語彙やカテゴリ一覧を再計算すると、答えが前処理に漏れる別の原因になります。
結果を歪めずに欠損値を補完する
どう対処するかは、フィールドが空欄になる頻度と、その判断にそのフィールドが必要かどうかで決まります。以下の区分はあくまで実務上の目安であり、絶対的な決まりではありません。規制対象のリスクモデルでは、小売の需要予測なら省ける行であっても、削除が認められない場合があります。
欠損率 | 特徴量の重要度 | 対応 |
|---|---|---|
5%未満 | 問わない | 十分なデータが残る場合は、該当する行を削除する |
5%~30% | 低い | 特徴量を削除する |
5%~30% | 高い | 学習用の行のみを使って補完する |
30%超 | 高い | 補完し、欠損フラグ列を追加したうえで、項目が空欄になる原因を調査する |
30%超 | 低い | 特徴量を削除する |
注文ファイル全体はほぼそろっているのに、コスト欄だけが数件空白になっている。これが最初のケースです。その行を削除するほうが、価格をでっち上げるよりも害は小さく済みます。中間帯にある、ほとんど使わないアンケート項目は、埋めた推測値を置く価値がないため、列ごと削除します。チャーン分析に使う契約期間(テニュア)は残し、推定して補います。
Googleのクラスタリング向けデータ準備ガイドは、実践的な選択肢を3つ挙げています。欠損値を含むサンプルを削除する、その特徴量を削除する、他のデータから欠損値を予測する、の3つです。欠損がまれなら、行の削除も妥当です。欠損が頻繁なら、特徴量を削除するか、補完するのが一般的です。
定数で埋めずに、欠損を予測する
数値項目では、値が存在する行で回帰モデルを学習し、空白を推定します。たとえば顧客の年齢が欠けている場合、全社平均の1つの値で置き換えるのではなく、収入と契約期間から推定できます。すでに信頼している関係性を活用できます。
注文金額は分布が偏っています。少数の大口の卸売注文が平均値を押し上げるため、平均値で埋めると、通常のバスケットが実際より高額に見えてしまいます。中央値は典型的な注文に近く、大口の請求書が1件入っても変動が小さくなります。補完の前後で要約統計量を比較してください。大きく変化するなら、その方法は穴を埋めているのではなく、ビジネスの実態を書き換えています。
カテゴリ項目では、空白にUnknownというラベルを付けます。欠損そのものがシグナルであることは少なくありません。たとえば、地域が取得されなかったチェックアウトや、仕入先コードのない商品です。これを正式な水準として扱えば、行を残せるうえ、その項目が意図的に空だったことをモデルに伝えられます。
運用の現場では、頻繁な空白は珍しくありません。2025年の水消費データの欠損に関するある研究では、2019年2月から2023年12月までの建物データセット33,888件の時間別レコードを扱っており、20%の時間で値が欠けています。これは、一律に行を削除すると履歴を失いすぎる水準です(該当の研究)。
補完器(インピュータ)は、学習用の行だけで学習させてください。手法をもう一度見直したい場合は、ELECTEの欠損データガイドで補完方法の選択肢をさらに詳しく解説しています。
カテゴリのエンコードと有用な特徴量の設計
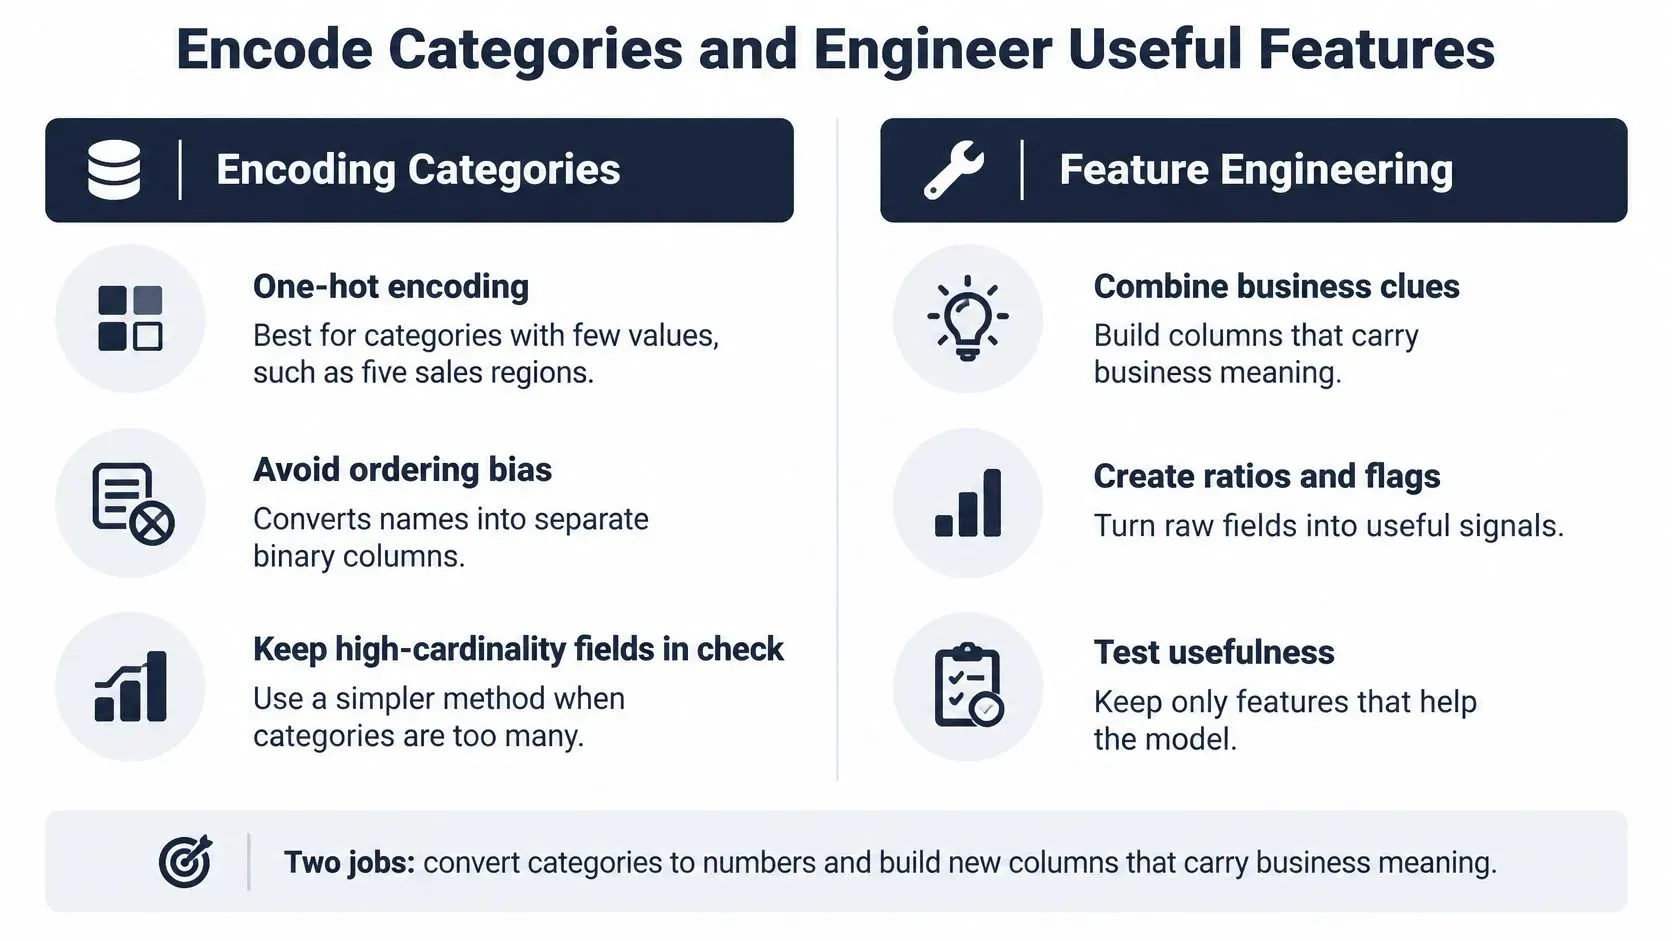
ここでは2つの作業があります。ラベルをモデルが使える数値に変換すること、そして生の項目では答えられないビジネス上の問いに答える列を作ることです。
偽の順位を作らないエンコード
ワンホットエンコーディングは、5つの販売地域のように値が少ないカテゴリに向いています。各地域が個別の「はい/いいえ」の列になり、どの地域も他より「大きい」ことにはなりません。
順序エンコーディングは、S、M、Lのサイズのように、本当に順序がある場合に向いています。数値は、ビジネスですでに使っている順位と対応します。
チャネルや都市のような順序のない名前に、1、2、3を割り当ててはいけません。モデルは、大きいコードほど「より多い」ものだと解釈します。この偽の順位は、あとで自信たっぷりの誤った係数として現れます。水準が数百ある項目では、ワンホットにすると非常に横長のテーブルになります。エンコードの前に、まれな水準をOtherにまとめてください。このグルーピングも、学習用の行だけで決めます。
ビジネス上の問いに答える列
思いつく限りの比率を並べるのではなく、1つの意思決定に結びついた少数の列を作りましょう。
- マージン率:
(price − cost) / priceを使えば、売上だけでは分からない「プロモーション後も原価を上回っているか」を判断できます。 - 最終購入からの経過日数: 解約分析に必要なのは直近の購買状況であり、顧客IDをもう一度コピーすることではありません。
- 曜日と月: 需要計画では、タイムスタンプ全体に埋もれている金曜日のピークや季節ごとの月別傾向が重要です。
- 7日間移動平均: 日次の販売数は大きく上下します。週平均を見れば、需要が上向いているかどうかが分かります。
- 在庫対売上比率: 在庫の実数だけを見るより早く、在庫管理担当者は欠品の兆候に気づけます。
まずは、その1つの意思決定に結びつく特徴量を10〜15個に絞ることをお勧めします。2つの列の相関が0.95を超える場合は、片方を削除してください。2つ目の列は1つ目の繰り返しだからです。データディクショナリには、列名の横にビジネス上の意味を書いておきます。エンコーディングのマップや移動平均を、除外するつもりだった行を含むファイル全体で学習すると、分割時に防いだはずのリークを再び起こすことになります。
数値のスケーリングと外れ値の扱い
極端な値が、必ずしもミスとは限りません。B2B顧客からの40個の注文は、実際の販売です。平均値に影響しすぎないようフラグを付け、履歴には残しておきます。一方、1,000と入力すべきところを100,000と入力した単価は、入力ミスです。桁を修正してください。需要として「処理」してはいけません。
極端な値は、削除する前に確認する
2つのチェックを組み合わせると効果的です。四分位範囲の1.5倍のルールは、列の中心から大きく離れた点を示します。ドメインチェックでは、その値が現実にあり得るかを確認します。たとえば、マイナスの在庫、10年後の日付、販売価格を上回る割引などです。まず検証し、そのうえで1パーセンタイルと99パーセンタイルで上下限を設定する、歪んだ売上に対数変換を適用する、あるいはフラグを追加して生の数値はレポート用に残す、といった対応を取ります。
削除した大口注文は、二度と予測できない売上です。残してしまった入力ミスは、顧客が支払うとモデルが思い込む価格になります。
上下限を設定したら、集計をもう一度実行してください。列の中心はほとんど動かないはずです。中央値が大きく変わる場合は、上下限の設定が効きすぎているため、元の行をもう一度確認してください。
データの特性に合うスケーラーはどれか
スケーリングによって、年間売上のように単位の大きい列が、1注文あたりの数量のように単位の小さい列を圧倒するのを防げます。Scikit-learnの前処理ドキュメントによると、StandardScalerは各特徴量を訓練セットの平均で中心化し、分散でスケーリングしますが、外れ値が多い場合は性能が低下することがあります。RobustScalerは、中心と範囲に外れ値の影響を受けにくい推定値を使う、置き換え可能な代替手段です。
データの特徴 | スケーラー | 適している理由 |
|---|---|---|
ほぼ左右対称で、極端な値が少ない | StandardScaler | 平均を中心に置き、分散でスケーリングする |
大量注文が時折発生するなど、外れ値が多い | RobustScaler | 極端な値の影響を受けにくい中央値と四分位範囲を使う |
1〜5の評価など、値の範囲を固定する必要がある | MinMaxScaler | 分布の形を変えずに値を0〜1に変換する |
スケーラーは学習データのみでフィットし、そのフィット結果を検証データに適用してください。ホールドアウトしたデータで再度フィットすると、検証データ内の極端な値がスケールを左右してしまいます。処理方法を選ぶ前に極端な値を見つける方法を詳しく知りたい場合は、ELECTEの外れ値ガイドをご覧ください。
パイプラインを自動化し、出力を確認する
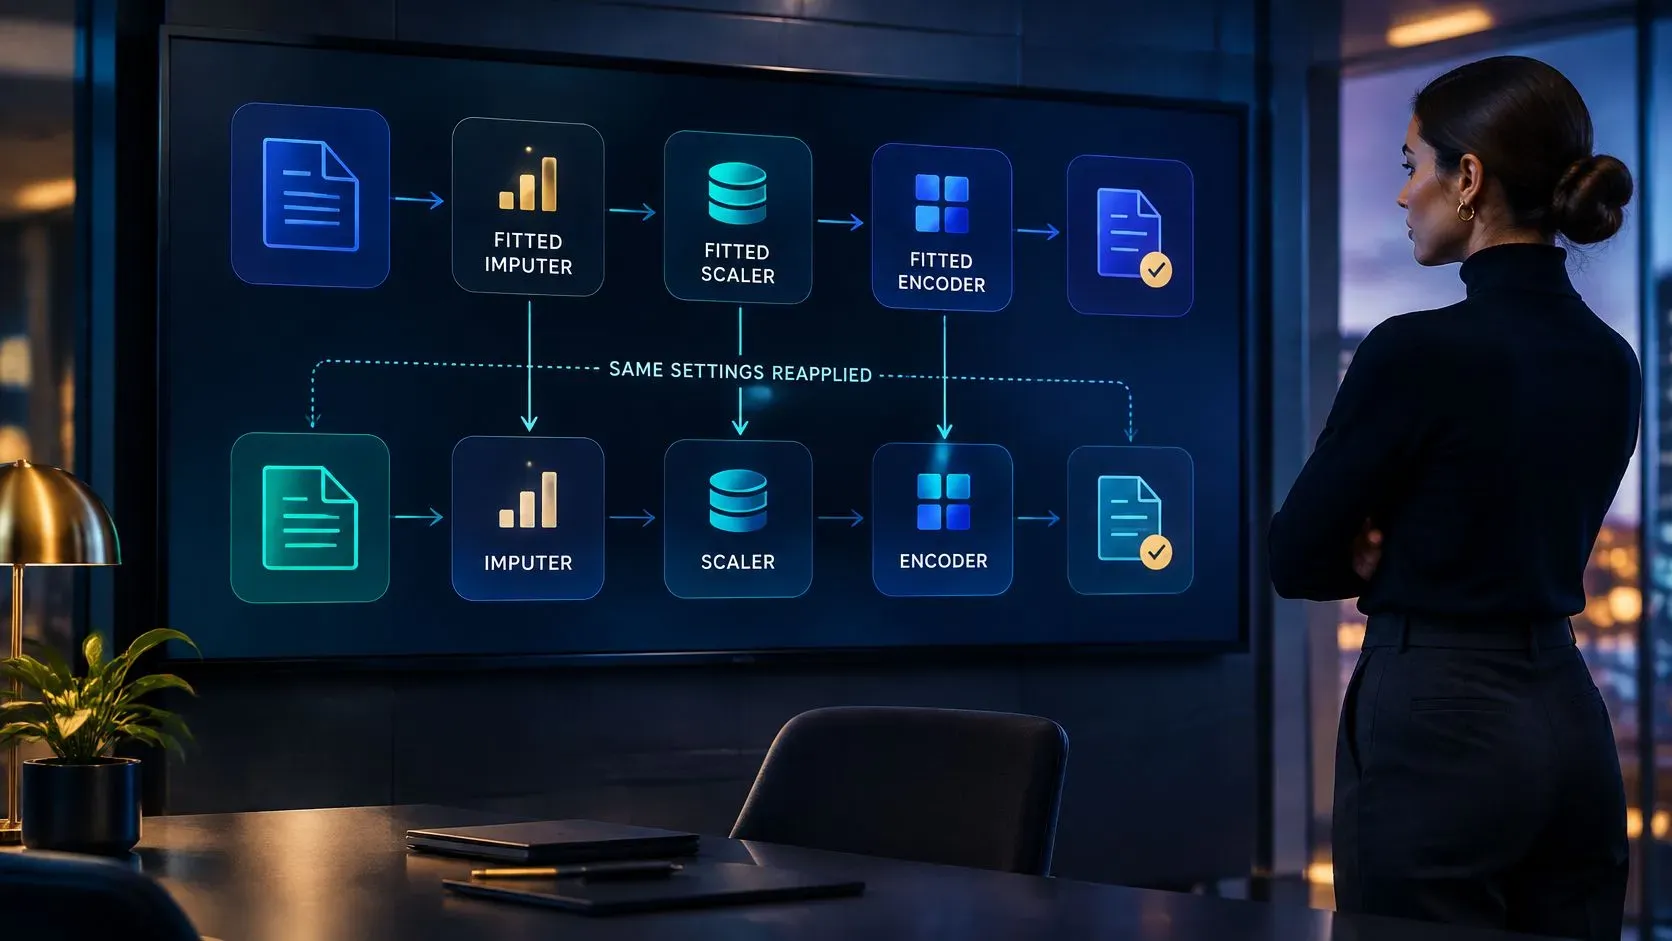
1つのノートブックに保存されたクレンジング済みファイルは、実行のたびにずれが生じることがあります。新しいファイルでは補完値、カテゴリのエンコード、スケールが変わる可能性があり、実際のビジネスに変化がなくてもダッシュボードの数値が変わってしまいます。
パイプラインなら、フィット済みの補完器、エンコーダー、スケーラーをまとめて保持し、新しいファイルにも同じ変換を適用できます。これらのステップは学習用パーティションのみでフィットしてください。フィット済みの設定は、再計算せずに検証データとテストデータに適用します。学習データとテストデータの全体で前処理をフィットすると、評価に情報が漏れる可能性がある理由は、IBMのデータリークに関する解説で説明されています。
実行ごとに行うチェック
ジョブが成功したとしても、処理が実行されたことが確認できるだけです。出力が、元データおよび設定したルールと今も一致しているかを確認してください。
- 行数: 読み込んだファイルとエクスポートを照合します。ログに記録された重複は差し引いて確認してください。
- 列ごとの null 率: 急に増えた場合は原因を調べてください。元データのフィールドが届かなくなっている可能性があります。
- 値の範囲: 価格、数量、日付が許容範囲内に収まっているかを確認します。
- 新しいカテゴリ: 未知の地域や SKU は、通知なしに破棄せず、定義済みのバケットに振り分けてください。
データ検証の実践例では、これらのチェックを業務ファイルにどう適用するかを確認できます。自動化された出力は推定値として扱い、アラートの発動に使う前に、最初の数サイクルは手作業で確認してください。
成長企業向けの AI データ分析プラットフォーム ELECTE は、会計ソフトやアップロードしたファイルに接続し、アナリストなしでデータ分析と予測を実行します。財務分析の自動化により、お客様は週 10 時間以上を節約しています。ただしその効果は、アップロードのたびに再計算するのではなく、レビューで説明できる、学習済みのステップを使うことが前提です。
今週は、1 つのデータセットを 7 行の表に沿って処理し、まだ手作業のステップに印を付けてください。繰り返し行うステップは自動化し、重複か本当の再注文か、入力ミスか大量注文かといった判断が必要なものは、ルールが安定するまでレビュー対象のままにします。
ELECTE は、会計データやアップロードしたファイルに接続してデータを準備し、チームでレビューできる予測とレポートに変換します。これらのデータ前処理のステップを毎回同じ方法で適用したい場合は、ELECTE をご覧のうえ、お手元の数値でプラットフォームがどのように処理するかをご確認ください。
コメント
まだコメントはありません — 会話を始めましょう。