Bedarfsprognose im Einzelhandel: Methoden, Daten und Nutzen
So funktioniert die Bedarfsprognose im Einzelhandel: welche Methoden sich eignen, welche Daten Sie brauchen und wie Sie mit besserer Bestandsplanung Fehlbestände und Überbestände senken.

Für einen Fehlbestand wird meist der Lieferant verantwortlich gemacht. In den meisten Fällen liegt die Ursache näher. Eine Studie zur Bestandsführung im Einzelhandel, vorgestellt auf der IEOM-Konferenz 2025 in Bangladesch, zeigt: 51 % bis 73 % der Fehlbestände im Supermarkt entstehen im eigenen Handelsbetrieb. Zu den Hauptursachen zählen ungenaue Prognosen (auch unterschätzte Nachfrage) und Bestellfehler.
Dieser Befund verschiebt den Blickwinkel. Bedarfsprognose im Einzelhandel ist kein Wettbewerb um den fortschrittlichsten Algorithmus. Sie ist eine operative Disziplin: ehrliche Nachfragesignale aus Daten herausholen, die Fehlbestände und Aktionen bereits verzerrt haben, die Methode an das Verkaufsverhalten des jeweiligen Artikels anpassen und das Ergebnis in Meldebestände übersetzen, mit denen ein Einkäufer am Montagmorgen tatsächlich arbeitet.
Dieser Leitfaden deckt den gesamten Kreislauf ab. Sie erfahren, was die Prognose liefern muss, welche Eingangsdaten das größte Gewicht haben, wie sich sechs gängige Methoden je nach Handelssituation unterscheiden, warum Langsamdreher eine andere Architektur brauchen, wie Vorratskäufe und Kanalwechsel den scheinbaren Aktionseffekt aufblähen, welcher Fehlerkennwert für welche Entscheidung taugt und welche fünf Prüfschritte Sie vor dem nächsten Einkaufszyklus durchlaufen sollten.
Was Bedarfsprognose im Laden bedeutet
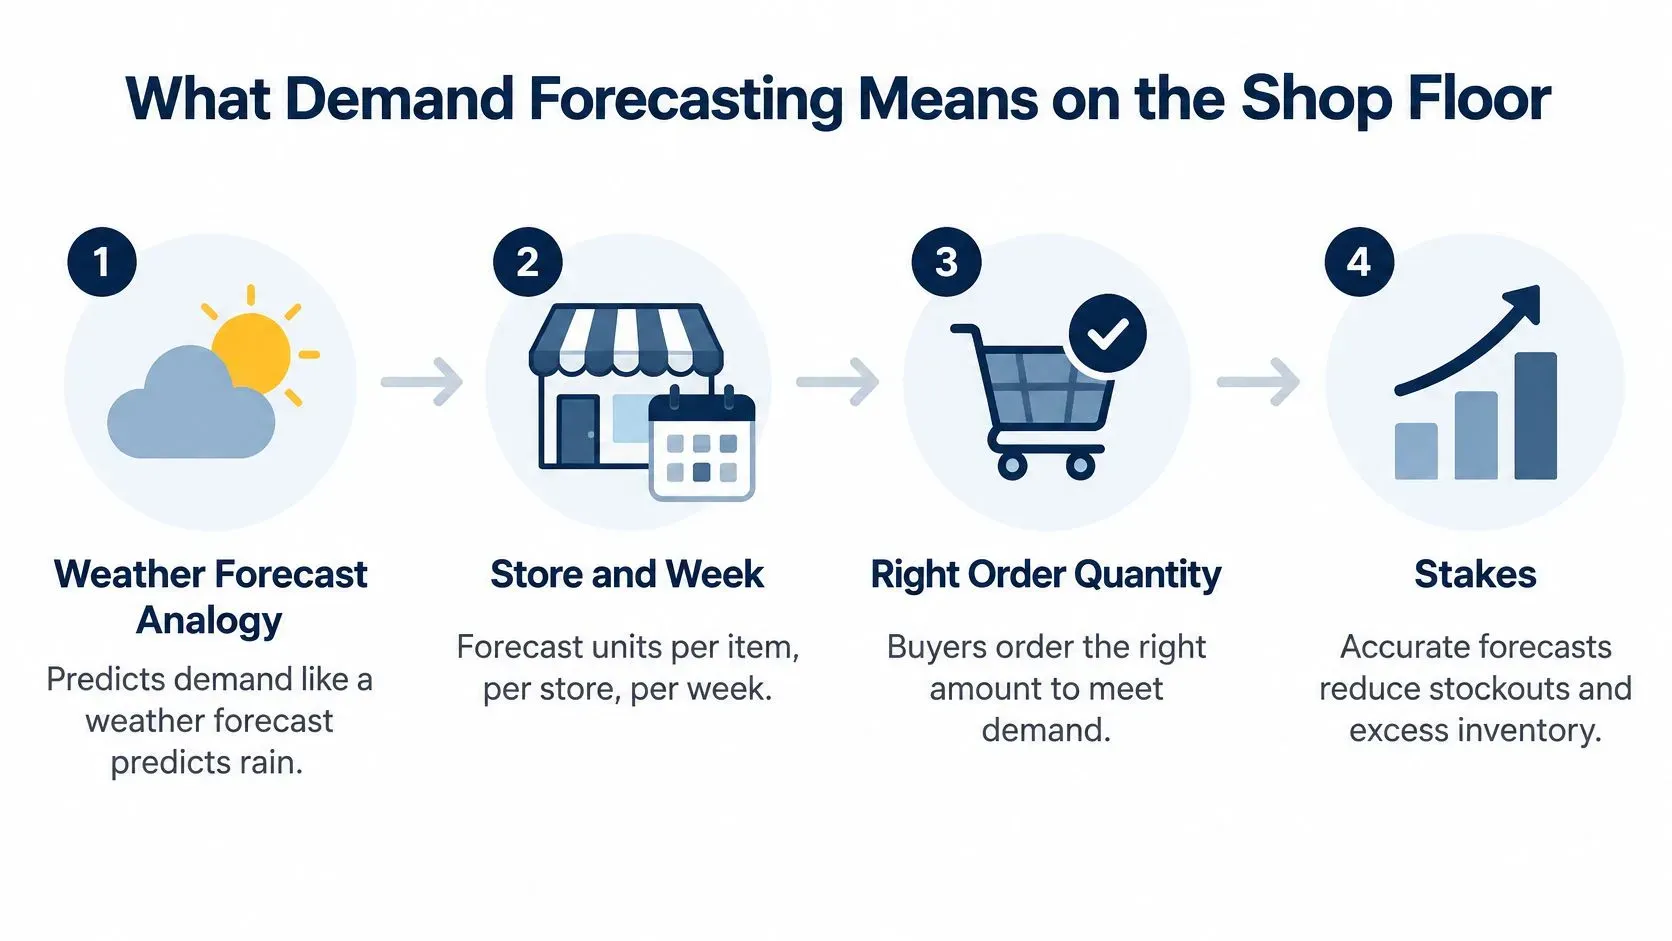
Eine Wettervorhersage wird glaubwürdig, wenn sie lokal und zeitlich konkret ist: Die Regenwahrscheinlichkeit in Ihrer Stadt am Dienstagnachmittag reicht, um zu entscheiden, ob man einen Regenschirm mitnimmt. Die Bedarfsprognose leistet für den Bestand dasselbe. Sie schätzt, wie viele Einheiten eines bestimmten Artikels Kunden in einer bestimmten Filiale in einer bestimmten Woche kaufen, damit der Einkäufer die richtige Menge bestellt und nicht nur eine plausible.
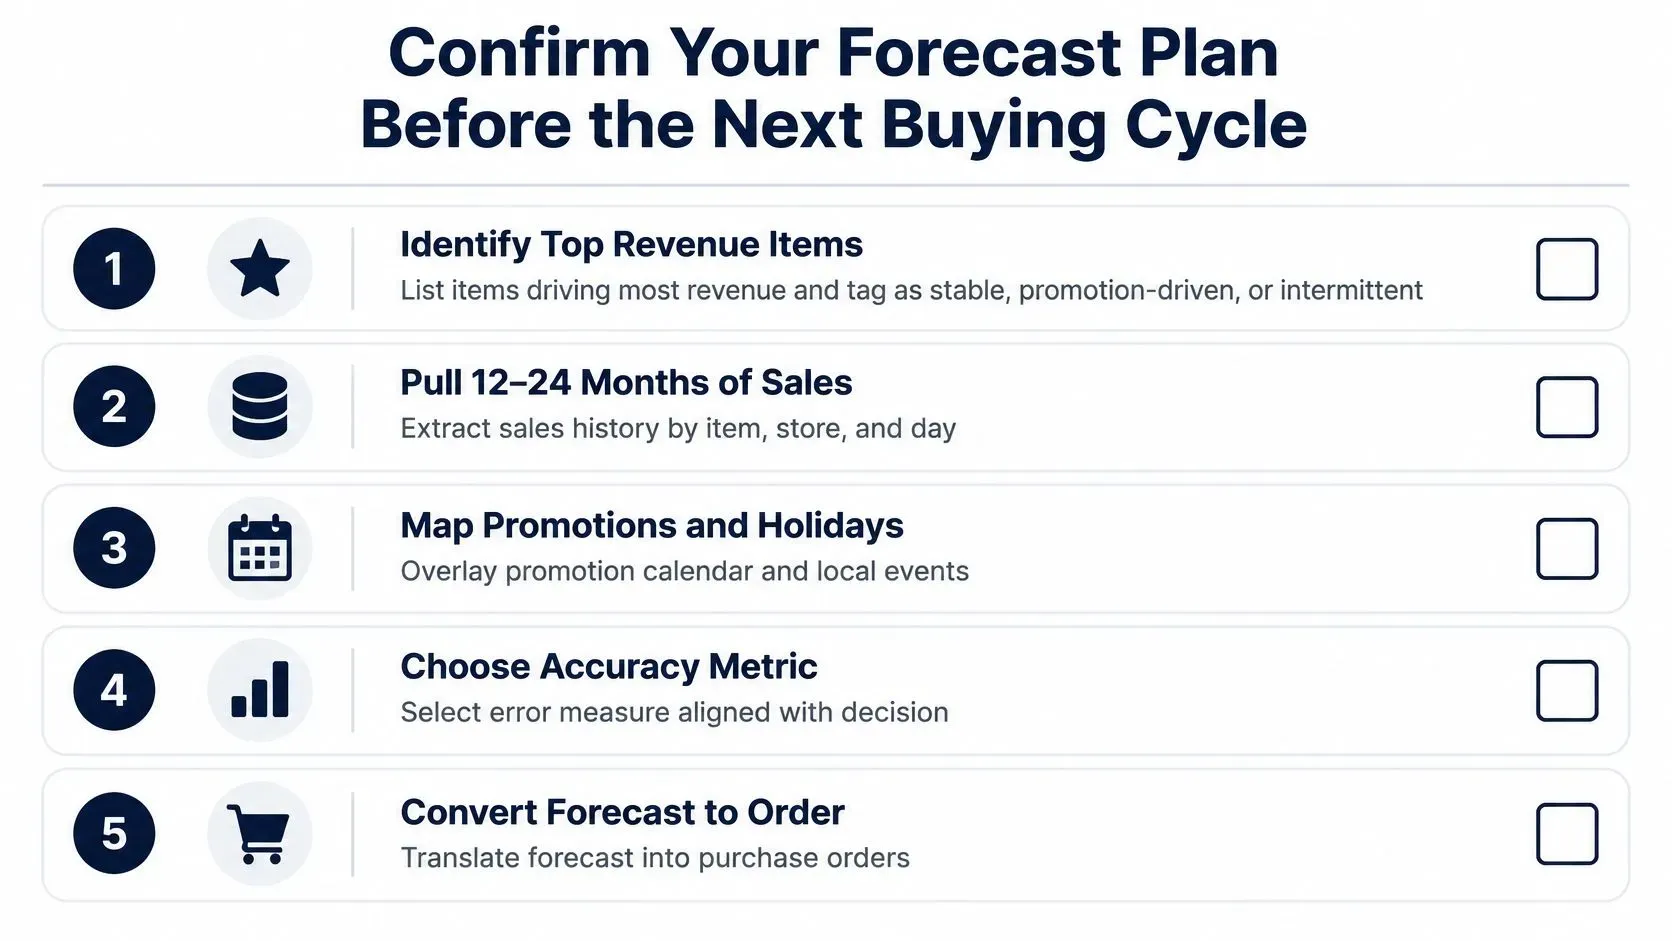
Die folgenden fünf Schritte zeigen die ganze Idee im Kleinen, von der Prognose bis zur Bestellung, die sie auslösen soll.
Zielgröße ist die Nachfrage, nicht die Verkaufssumme, die die Kasse zufällig erfasst hat. Eine Null, die gebucht wurde, während das Shampoo-Regal leer war, ist zensierte Nachfrage. Ein Aktionsspitzenwert kann aus den nächsten zwei Wochen vorgezogen oder aus einer nahegelegenen Filiale abgezogen sein. Kategoriedurchschnitte und Monatsberichte verbergen diese Probleme auf Artikel-Filial-Ebene, daher muss das Signal granular bleiben und häufig aktualisiert werden.
Der Arbeitskreislauf sieht so aus:
- Erfassen Sie Verkaufs- und Bestandshistorie nach Artikel, Filiale und Tag, einschließlich der Tage, an denen ein Regal leer war.
- Bereinigen und angleichen: eine Maßeinheit, ein Kalender, keine doppelten Zeilen, wenn ein Filialsystem eine Woche neu meldet.
- Anpassen und prognostizieren Sie die Nachfrage pro Artikel und Filiale, in der Granularität, die Ihre Bestellentscheidung braucht.
- Übersetzen Sie die Prognose in Bestellungen und Sicherheitsbestand unter Berücksichtigung von Lieferzeiten und des zugesagten Servicegrads.
- Fehler messen und nachsteuern, Artikel für Artikel statt einmal jährlich bei der Budgetplanung.
Jeder Schritt schützt vor einer von drei Kostenarten. Wer zu niedrig prognostiziert, verliert Umsatz, den er nicht zurückholt, weil der Kunde zum Ersatzprodukt greift oder geht. Wer zu hoch prognostiziert, bindet Kapital in Ware, die später reduziert werden muss. Stimmt die Menge ungefähr, aber der Zeitpunkt nicht, zahlen Sie doppelt: Eilfrachtaufschläge auf die dringende Bestellung und Lagerkosten für den Überschuss.
Die Regel, die am meisten Geld spart: Eine Prognose rechtfertigt sich nur, wenn eine Nachschubregel darauf reagiert. Eine perfekte Zahl in einem Bericht verändert nichts im Regal.
Die Dateninputs und warum Fehlbestände sie verzerren
Bevor Sie Modelle vergleichen, prüfen Sie, was hineingeht. Die Eingangsdaten, die die Genauigkeit im Einzelhandel am stärksten verbessern, sind vorhersehbar und unspektakulär, und vielen Teams fehlen zwei oder drei davon.
- Verkaufshistorie nach Artikel, Filiale und Tag. Gröbere Daten verbergen die Aktionswochen und Wochenendspitzen, die das Signal tragen.
- Lagerbestand und Dauer von Fehlbeständen. Ohne sie lässt sich eine ruhige Woche nicht von einem leeren Regal unterscheiden.
- Preise und Rabatthöhe. Ein Preisnachlass von 10 % und einer von 30 % erzeugen nicht dieselbe Reaktionskurve. Speichern Sie daher den Regalpreis, den Kunden zahlen, nicht den Listenpreis.
- Der Aktionskalender, einschließlich Platzierung und Werbeanzeigen.
- Feiertage und lokale Veranstaltungen. Ein Schulfest zwei Straßen weiter bewegt mehr Mineralwasser als ein bundesweiter Feiertag.
- Wetter, besonders für Frische-, Saison- und Gartenkategorien.
- Wettbewerberpreise, sofern Sie sie konsistent beobachten können.
- Lieferzeiten und Lieferverzögerungen der Lieferanten, die bestimmen, wie viel Reichweite Sie brauchen.
Warum ein leeres Regal eine falsche Null erzeugt
Angenommen, Ihr Shampoo verkauft sich im Schnitt 40 Mal pro Woche und das Regal ist drei Tage lang leer. Diese Tage verbuchen null Verkäufe. Ein auf dieser Historie trainiertes Modell lernt, dass die Nachfrage sinkt, sobald der Bestand ausgeht, also das Gegenteil der Wahrheit. Kunden, die nichts fanden, haben ihre Meinung nicht geändert; sie sind woanders hingegangen.
Lieferverzögerungen, langsamer Nachschub und Ihre eigenen Bestellentscheidungen zensieren Verkäufe auf genau dieselbe Weise. Das Modell kann einen verlorenen Verkauf nicht von verlorenem Interesse unterscheiden und bestellt den am schnellsten ausverkauften Artikel weiter zu knapp.
Das Problem ist gut belegt. Ein Review von 2026 zu maschinellem Lernen in der Handelsprognose nennt unvollständige Datensätze, fragmentierte Datenpipelines, verändertes Kundenverhalten, Aktionen, Reaktionen von Wettbewerbern und Saisonalität als Ursachen für verzerrte, anfällige Modelle. Derselbe Review zitiert eine Umfrage unter 661 Bestandsexperten, in der 51 % mitunter mit Prognosen weiterarbeiteten, die sie bereits für unzuverlässig hielten, weil es keine bessere Alternative gab. Zoll- und Handelspolitik (19 %) sowie Inflation oder Rohstoffpreisschwankungen (17 %) zählten zu den größten Störfaktoren.
Die Korrektur in vier Schritten, in der richtigen Reihenfolge
- Markieren Sie jeden Tag mit Lieferengpass in der Verkaufshistorie, mit den Stunden oder Tagen, an denen der Artikel nicht verfügbar war.
- Schätzen Sie die entgangenen Verkäufe für diese Tage anhand vergleichbarer Artikel im selben Geschäft und in derselben Woche.
- Kennzeichnen Sie jeden Zeitraum als verfügbar oder eingeschränkt, bevor ein Trainingslauf startet.
- Trainieren Sie mit der bereinigten Historie und vergleichen Sie die Ergebnisse anhand zurückgehaltener Wochen, niemals anhand der Wochen, die Sie korrigiert haben.
Für die meisten KMU verbessert diese Arbeit die Genauigkeit stärker als ein Wechsel des Algorithmus. Ein Modell kann nur lernen, was in den Daten steht; wenn dort steht, dass die Nachfrage während eines Lieferengpasses eingebrochen ist, lernt eine ausgefeiltere Architektur das Falsche nur schneller. Unser ELECTE-Leitfaden zur Integration mehrerer Datenquellen beschreibt die technische Grundlage, mit der Verkaufs-, Bestands- und Aktionsdaten in einer nutzbaren Tabelle zusammenkommen.
Prognosemethoden im Vergleich nach Handelssituation
Es gibt keine beste Methode, sondern nur die Methode, die zur Situation passt. Die folgende Tabelle ist der Vergleich, den ich mir über einem Planungsschreibtisch aufgehängt wünschen würde.
Methode | Beste Einsatzsituation im Einzelhandel | Benötigte Daten | Stärke | Worauf Sie achten sollten |
|---|---|---|---|---|
Gleitender Durchschnitt oder exponentielle Glättung | Stabile Artikel mit hohem Absatzvolumen | 1–2 Jahre wöchentliche Verkaufsdaten | Einfach, günstig und leicht zu erklären | Erfasst weder Aktionen noch saisonale Verschiebungen |
Saisonale Modelle wie SARIMA | Artikel mit klaren wöchentlichen oder jährlichen Zyklen | Historie über zwei oder mehr Saisons | Erfasst Trend und Saisonalität | Stößt bei Tausenden Zeitreihen gleichzeitig an Grenzen |
Methoden der Croston-Familie | Sporadisch verkaufte Langsamdreher-SKUs | Verkaufshistorie mit vielen Nullperioden | Trennt die Häufigkeit eines Verkaufs von seiner Größe | Falsche Wahl für Artikel mit gleichmäßigem Absatz |
Regression mit Aktions- und Preismerkmalen | Aktionsgetriebene Warengruppen | Aktionskalender und Preishistorie | Zeigt, wie jeder Einflussfaktor die Nachfrage bewegt | Versagt, wenn Aktionen selten sind |
Baum-Ensembles wie XGBoost oder LightGBM | Große Artikel-Filial-Portfolios | Verkäufe, Kalender, Aktionen und Preise | Lernt über viele verwandte Zeitreihen hinweg | Erfordert saubere Daten und laufendes Monitoring |
Hybride LSTM-XGBoost-Ensembles | Filialketten mit mehreren Warengruppen und umfangreichen Signalen | 36 Monate Kassen- und Aktionsdaten | Senkte den mittleren absoluten prozentualen Fehler bei einem Vierwochenhorizont im Durchschnitt um 28,6 % in einer Studie mit 14 Einzelhandelsunternehmen | Aufwendiger zu entwickeln und zu erklären |
Das Muster hinter den Zeilen ist wichtiger als jede einzelne Zeile. Ein peer-reviewter Übersichtsartikel zur Handelsprognose-Forschung berichtet, dass globale Machine-Learning-Modelle, darunter Feed-Forward- und rekurrente neuronale Netze, Gradient-Boosted-Regressionsbäume und Random Forests, separate Zeitreihen- und Regressionsmodelle oft übertreffen, wenn Händler große Mengen von Absatzreihen prognostizieren. Der Vorteil wächst mit dem Sortiment: Tausende Artikel-Filial-Kombinationen, bei denen die Nachfrage einzelner Produkte spärlich, sporadisch, saisonal oder aktionsabhängig ist.
Wie der Vergleich in einer echten Handelskette aussieht
Stellen Sie sich eine Regionalkette mit 40 Filialen vor. Basisartikel mit stabilen Wochenumsätzen werden mit exponentieller Glättung prognostiziert, weil ein Category Manager die Zahl lesen und hinterfragen kann. Saisonale Bekleidung mit acht Aktionen pro Jahr erhält ein Gradient-Boosted-Modell, das über alle Filialen hinweg gleichzeitig trainiert wird, weil die Historie einer einzelnen Filiale zu dünn ist, um daraus eine Rabattkurve zu lernen.
Der Übersichtsartikel macht ebenso klar, dass die älteren Methoden nicht überholt sind. Ihre Leistung bleibt konkurrenzfähig bei kleineren Datensätzen, stabilen Produkten und in Situationen, in denen Interpretierbarkeit und begrenzte Daten wichtiger sind als der letzte Prozentpunkt Genauigkeit.
Zurückhaltung zahlt sich aus. Eine Evaluation der US-Handelsnachfrage von 2026 auf dem M5-Datensatz, die 25.940 Artikel-Filial-Reihen in fünf rollierenden 28-Tage-Fenstern umfasst, senkte den mittleren gewichteten absoluten prozentualen Fehler von 0,9006 bei einem saisonal-naiven Benchmark auf 0,7022 mit einem LightGBM-Modell auf Basis historischer Nachfrage, eine Verbesserung von etwa 22 %. Das Hinzufügen von Handels- und Betriebsvariablen erreichte nur 0,6979, verzögerte makroökonomische Indikatoren erreichten 0,6978, ein Gewinn von rund 0,02 %.
Erstellen Sie zuerst die Baseline. Eine saisonal-naive oder exponentiell geglättete Zahl, die an einem Nachmittag entsteht, zeigt Ihnen, ob sich die Komplexität des Machine-Learning-Modells gelohnt hat. Lassen Sie beide auf denselben zurückgehaltenen Wochen laufen und behalten Sie den Gewinner.
Die Modellwahl sollte sich nach Umfang und Struktur des Sortiments richten, nicht danach, ob die Methode neuer ist. Dieser eine Grundsatz spart Ihnen mehr Geld als jede Hyperparameter-Suche.
Langsamdreher und spärliche Nachfrage brauchen ein eigenes Modell
Manche Produkte haben kein Nachfrageniveau. Sie haben ein Nachfrageereignis. Ein Ersatzteil, das viermal im Jahr verkauft wird, eine Long-Tail-Variante im E-Commerce, eine Filial-SKU-Kombination, die zwei Stück im Monat bewegt: Standardmäßige Saisonmodelle kommen damit schlecht zurecht, und der Grund ist strukturell.
Nullen und positive Verkäufe stammen aus zwei verschiedenen Prozessen. Ob überhaupt ein Verkauf stattfindet, ist eine Frage. Wie groß er ausfällt, wenn er stattfindet, ist eine andere. Methoden vom Croston-Typ schätzen beides getrennt, weshalb sie bei Handelsdaten mit vielen Nullen robust bleiben. Ein Benchmark zur Handelsprognose bei sporadischer Nachfrage nennt für Croston einen WAPE von 93,15 % und einen MASE von 0,9852, vor den getesteten naiven und SARIMAX-Alternativen. Lesen Sie diesen WAPE als relatives Ergebnis bei einer Reihe voller Nullen, nicht als gute Genauigkeit im absoluten Sinne.
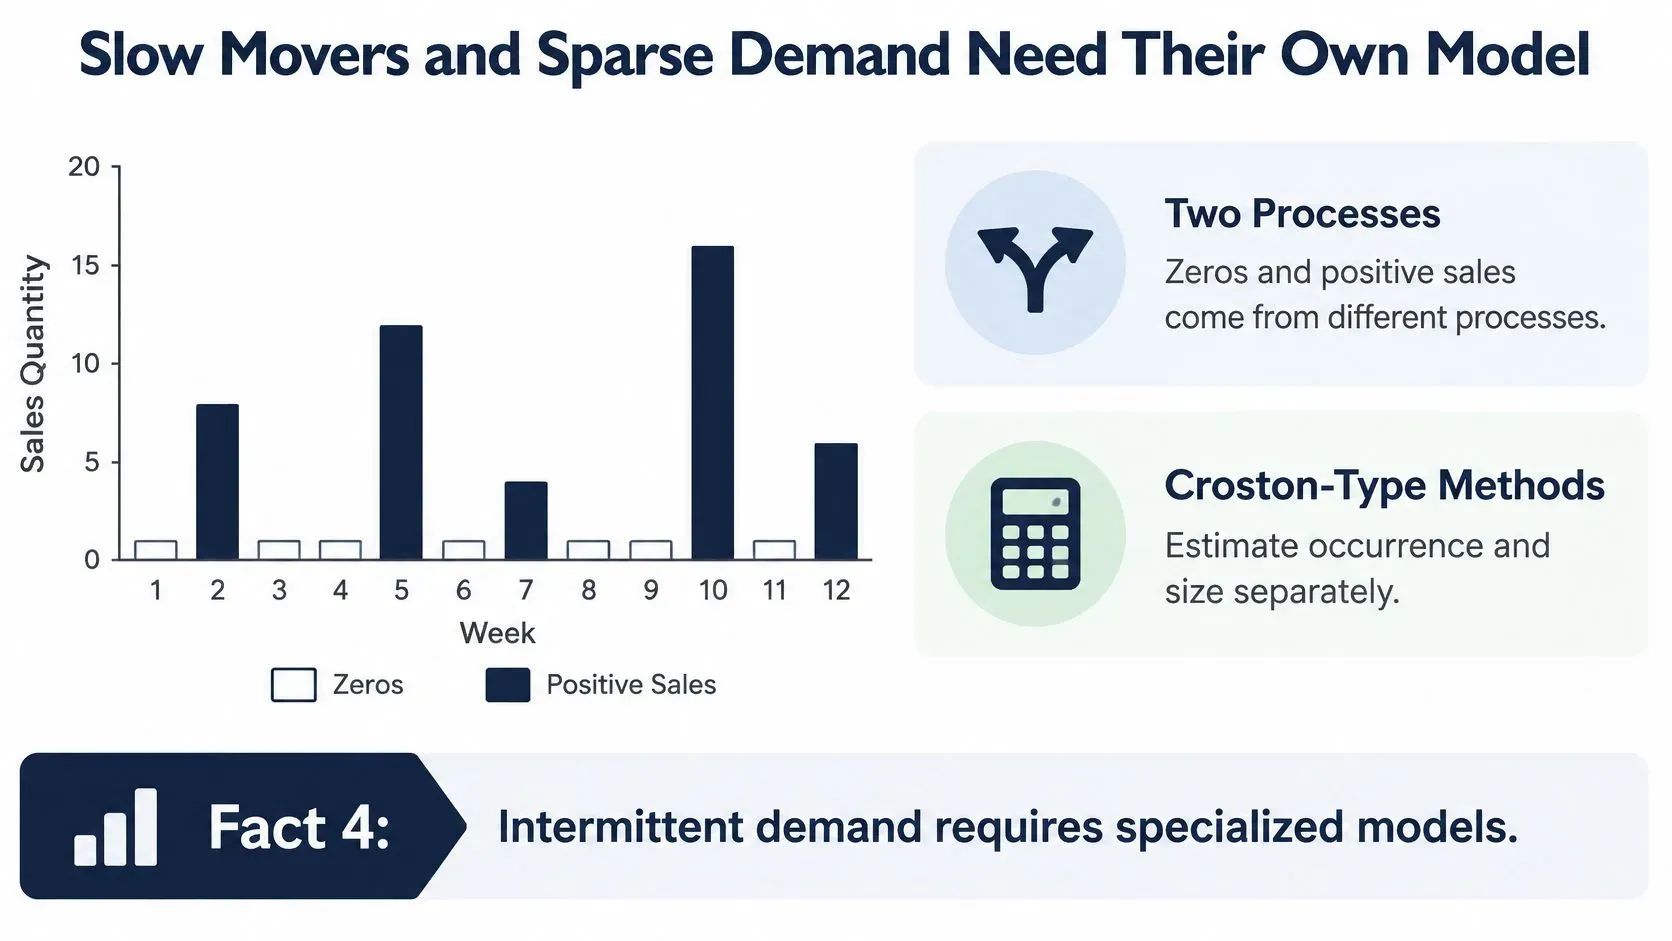
Das Fehlerbild ist spezifisch und teuer. Ein Standard-Regressions- oder Saisonmodell sieht eine Folge von Nullen und schließt auf niedrige, gleichmäßige Nachfrage, also setzt es den Sicherheitsbestand entsprechend an. Der Langsamdreher, der in unvorhersehbaren Schüben verkauft, ist dann leer, während der Ladenhüter drei Monate Reichweite bindet. Der eine Fehler kostet einen Verkauf, der andere kostet Liquidität und Regalfläche.
Im selben Themenfeld gibt es eine zweite Lehre. Ein Benchmark auf Verkaufsdaten mit sporadischer Nachfrage, fehlenden Beobachtungen und häufigem Sortimentswechsel ergab, dass lokalisierte baumbasierte Modelle unter den getesteten Ansätzen am besten abschnitten; XGBoost erzielte mit 4,833 den niedrigsten berichteten quadratischen Mittelwertfehler (RMSE). Die Erkenntnis lautet nicht „XGBoost überall einsetzen“. Sie lautet: Wenn Produkte schnell wechseln, können Modelle pro Produktfamilie ein einzelnes generalisiertes Modell schlagen, das über unvereinbare Muster mitteln muss.
So leiten Sie eine Reihe weiter
- Klassifizieren, bevor Sie modellieren. Berechnen Sie für jede Reihe das durchschnittliche Nachfrageintervall (ADI) und den quadrierten Variationskoeffizienten der Nachfrage ungleich null. Der erste Wert ist der typische Abstand in Perioden zwischen Verkäufen; der zweite misst, wie stark die Verkaufsmenge von Verkauf zu Verkauf schwankt.
- Leiten Sie sporadische Reihen an Modelle der Croston-Familie, Hurdle-Modelle oder Auftreten-und-Menge-Modelle weiter.
- Schicken Sie stabile Artikel mit hohem Volumen zu Saison- oder Machine-Learning-Modellen, wo sie hingehören.
- Prüfen Sie die Klassifizierung vierteljährlich neu. Artikel wechseln im Lauf der Zeit die Kategorie, werden ausgelistet oder schlagen ein, und eine Routing-Regel, die nie neu ausgeführt wird, verschlechtert sich.
Halten Sie die Klassifizierung in einer Tabelle, die sich einsehen lässt. Wenn ein Category Manager fragt, warum ein Produkt mit einer ungewöhnlichen Methode prognostiziert wird, sollte die Antwort aus zwei Zahlen bestehen, nicht aus einem Achselzucken.
Aktionen, Vorratskäufe und Kanalverschiebungen
Aktionswochen sind keine gewöhnlichen Wochen, und sie in eine Baseline einzurechnen verfälscht beides. Modellieren Sie die Basisnachfrage und die Aktionseffekte als getrennte Größen und addieren Sie sie anschließend.
Ein Vergleich von Prognoseansätzen im Handel ergab, dass Entscheidungsbaum-Ensembles die lineare Regression, die penalisierte lineare Regression und Regressionsbaum-Methoden bei der täglichen Nachfrage auf Kettenebene übertrafen, wenn SKUs mehr als fünf historische Aktionen hatten. Fünf ist in diesem Ergebnis die nützliche Schwelle. Darunter gibt es nicht genug Beispiele, damit ein Modell lernen kann, wie Rabatthöhe, Aktionszeitpunkt und Wechselwirkungen mit dem Produktkalender die Nachfrage beeinflussen. Stärkere Regularisierung oder ein einfacherer Benchmark richten dann weniger Schaden an als ein flexibles Modell, das Rauschen hinterherjagt.
Geben Sie dem Modell explizite Merkmale: Aktionsstatus, Rabattprozentsatz, Platzierung im Regal oder Display, Nähe zu Feiertagen und verzögerte Nachfrage nach der Aktion. Letzteres wird oft weggelassen, ist aber das Merkmal, das den Einbruch erfasst.
Der Einbruch, den niemand prognostiziert
Angenommen, ein Rabatt von 30 % auf Shampoo steigert eine Woche lang den Absatz, danach liegt der Absatz zwei Wochen lang unter dem Trend. Die Kunden haben Vorräte angelegt; über das Quartal haben sie nicht mehr gekauft. Behandeln Sie das gesamte Dreiwochenfenster als eine Analyseeinheit. Der Fehler im Aktionszeitraum zeigt, ob Sie genug bestellt haben. Der Fehler nach der Aktion zeigt, ob Sie für den Rest des Monats zu viel bestellt haben. Wenn Sie beide getrennt bewerten, werden beide Entscheidungen sichtbar. Wenn Sie sie gemeinsam bewerten, heben sich die beiden Fehler auf, und der Bericht sieht sauber aus, obwohl beide Entscheidungen falsch waren.
Forschung zum Aktionslebenszyklus weist darauf hin, dass frühere Arbeiten die Phase nach der Aktion oft übersehen, in der die Nachfrage sinkt, weil Kunden sich während der Aktion bevorratet haben. Sie berichtet zudem, dass Methoden des maschinellen Lernens die Prognosen über den gesamten Lebenszyklus verbessern können, nicht nur während der Aktion selbst.
Der Kanal fügt eine zweite Ebene der Täuschung hinzu. Eine Studie zu Multichannel-Aktionen bei einem regionalen brasilianischen Supermarkt schätzte die Nachfrageverlagerung auf 11,23 % von stationären Filialen zum Online-Kanal und auf 19,34 % in die umgekehrte Richtung, während koordinierte Aktionen die Kannibalisierung um 30,04 % senkten. Treueanreize erzielten mit 3,5 % den größten gemessenen Zuwachs. Wenn Sie jeden Kanal unabhängig prognostizieren, zählen Sie Nachfrage doppelt, die nur die Adresse gewechselt hat.
Legen Sie die Bewertung daher auf vier Regeln fest:
- Bewerten Sie Aktions- und Nicht-Aktionszeiträume getrennt, damit eine gute Woche einen schlechten Monat nicht verdeckt.
- Vergleichen Sie mit einer Base-Lift- oder ähnlichen kausalen Baseline, sonst messen Sie nur, wie gut das Modell das Volumen gelernt hat.
- Bewerten Sie nach SKU und nach Aktionshäufigkeit, denn die Schwelle von fünf Aktionen verändert, was Sie erwarten können.
- Behalten Sie ein verzögertes Post-Aktions-Merkmal bei, damit das Modell den Einbruch abbilden kann, statt von ihm überrascht zu werden.
Wenn Rabatte Ihre Marge auffressen, behandelt unser Leitfaden zum Schutz der Margen bei Rabattaktionen die Preisseite desselben Problems.
Genauigkeit messen und Prognosen in Bestellungen umsetzen
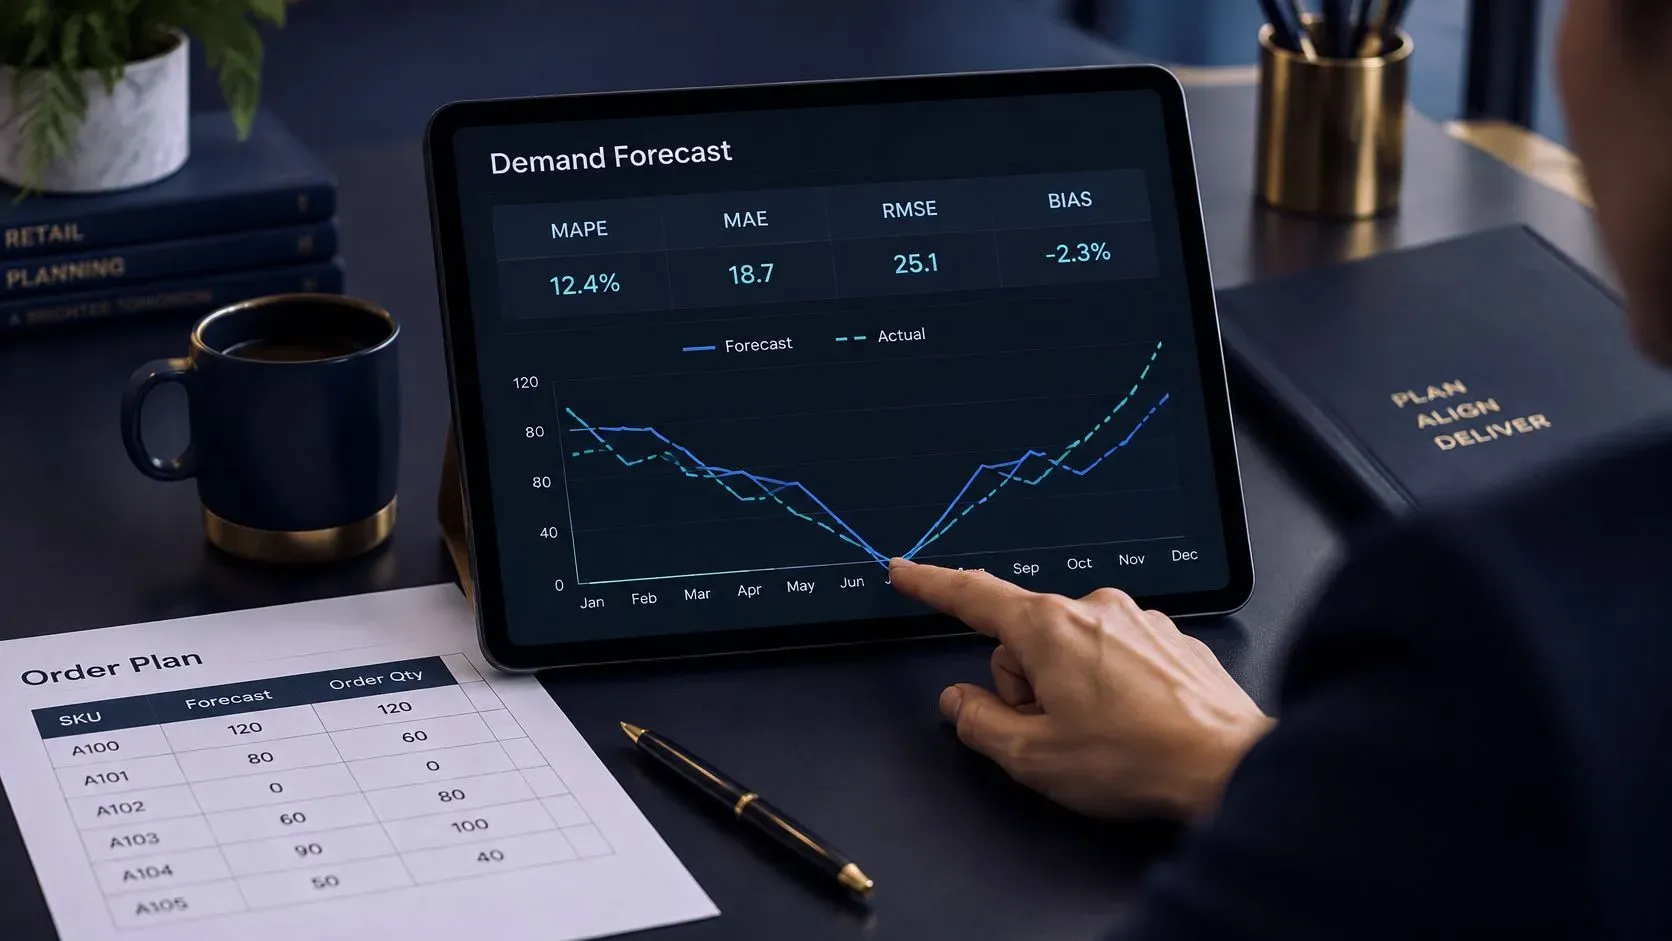
Wählen Sie die Kennzahl erst, nachdem Sie die Entscheidung gewählt haben. Jede Kennzahl beantwortet eine andere Frage und verbirgt etwas anderes.
Kennzahl | Einsatz, wenn | Worauf Sie achten müssen |
|---|---|---|
WAPE (gewichteter absoluter prozentualer Fehler) | Genauigkeit über Artikel unterschiedlicher Größe hinweg vergleichen | Gewichtet Artikel mit hohem Volumen am stärksten |
MASE (mittlerer absoluter skalierter Fehler) | Modelle bei sporadischen oder nulllastigen Zeitreihen vergleichen | Braucht einen naiven Benchmark, um richtig gelesen zu werden |
MAPE (mittlerer absoluter prozentualer Fehler) | Einfaches Reporting bei stabilen Artikeln mit hohem Volumen | Instabil oder nicht definiert, wenn die tatsächliche Nachfrage null ist |
Bias | Systematische Über- oder Unterprognosen erkennen | Sich ausgleichende Fehler können ihn verbergen, wenn man nicht nach Zeitraum liest |
Servicegrad | Prüfen, ob die Prognose die Regalverfügbarkeit sichert | Hängt von den Nachschubeinstellungen ab, nicht allein von der Prognose |
Prozentuale Fehler versagen bei Langsamdrehern. Ist die tatsächliche Nachfrage null, ist der Nenner null, und die Kennzahl explodiert oder wird aus dem Durchschnitt ausgeschlossen. Beides schmeichelt dem Modell. Berichten Sie WAPE oder einen skalierten Fehler zusammen mit Bias und Servicegrad, und lesen Sie sie nach Segmenten statt als eine einzige Zahl für das gesamte Sortiment.
Von einer Zahl zum Meldebestand
Eine Prognose wird über eine Rechnung zur Bestellung, die jeder im Team nachprüfen kann. Die erwartete Nachfrage über die Wiederbeschaffungszeit plus ein Sicherheitsbestand, der auf Ihren Ziel-Servicegrad ausgelegt ist, ergibt den Meldebestand.
Angenommen, ein Geschäft erwartet über eine Lieferzeit von fünf Tagen einen Absatz von 40 Stück und hält einen Puffer von 10 Stück. Der Meldebestand liegt dann bei 50 Stück. Sobald der Bestand inklusive offener Bestellungen auf 50 fällt, wird bestellt. Bestellt der Einkäufer bereits bei 40, weil der Puffer nie vereinbart wurde, ist das Regal am ersten Tag leer, an dem der Lkw sich verspätet.
Zwei Routinen halten das Ganze ehrlich. Richten Sie Ausnahme-Alarme ein, die auslösen, wenn der Prognosefehler eines Artikels Ihren Schwellenwert in zwei oder mehr aufeinanderfolgenden Perioden überschreitet. So schaut jemand auf den Artikel statt nur auf das Dashboard. Führen Sie außerdem monatlich eine Bias-Prüfung je Kategorie durch, um systematische Über- oder Unterprognosen zu erkennen, die sich in den Fehlern einzelner Artikel herausmitteln.
Eine statistisch genaue Prognose kann trotzdem zu Engpässen führen, wenn Bestellzeitpunkt, Überprüfungsintervall oder Sicherheitsbestand falsch kalibriert sind. Prüfen Sie Prognose und Nachschubregeln gemeinsam, sonst korrigieren Sie dauerhaft die falsche Stelle.
In unserem ELECTE-Leitfaden zur Analyse von Bestandsdaten erfahren Sie mehr darüber, wie Sie Lagerbestände mit den Zahlen verknüpfen, nach denen Einkäufer handeln.
Prüfen Sie Ihren Prognoseplan vor dem nächsten Einkaufszyklus
Bevor die nächste Bestellung rausgeht, sollten Sie bestätigen, dass der Prognoseprozess zu den Produkten und Entscheidungen passt, die er unterstützen soll. Fünf Prüfschritte machen den Plan praxistauglich:
- Sortiment priorisieren. Ermitteln Sie die Artikel, die den Großteil Ihres Umsatzes ausmachen, und ordnen Sie sie als stabil, aktionsgetrieben oder sporadisch ein. Für den Rest genügt möglicherweise eine einfachere Regel.
- Absatzhistorie prüfen. Ziehen Sie 12 bis 24 Monate Absatzdaten je Artikel, Filiale und Tag und markieren Sie Tage mit Fehlbestand. Stehen nur 12 Monate zur Verfügung, nutzen Sie diese, rechnen Sie aber mit größeren Fehlern.
- Gegen eine Baseline testen. Legen Sie eine saisonale Baseline fest und vergleichen Sie aufwendigere Modelle anhand zurückgehaltener Wochen. Das oben genannte M5-Ergebnis zeigt, warum sich ein komplexeres Modell seinen Platz verdienen muss.
- Messroutine festlegen. Wählen Sie für jede Entscheidung eine Kennzahl und halten Sie Schwellenwert und Prüfrhythmus über alle Zyklen hinweg konstant.
- Wiederholte Abweichungen prüfen. Kontrollieren Sie vor der Bestellung die Meldebestände von Artikeln mit wiederkehrenden Prognosefehlern.
ELECTE wendet sechs Prognosemethoden auf Ihre Daten an, vergleicht sie miteinander und wählt die genaueste aus. Mit dem kostenlosen Meldebestandsrechner lässt sich der Meldebestand einzelner Artikel berechnen.
Prognosen senken das Risiko, sie können aber nicht jede Veränderung berücksichtigen. Ein Modell übersieht möglicherweise eine Produkteinführung oder eine Aktion ohne vergleichbare Absatzhistorie. Behalten Sie neben der Prognose eine Prüfroutine bei, damit Einkäufer reagieren können, wenn die tatsächliche Nachfrage vom Plan abweicht.
ELECTE verbindet Absatz-, Bestands- und Aktionsdaten, vergleicht sechs Prognosemethoden anhand der verfügbaren Daten und stellt Prognosen, Genauigkeit und Ausnahmen in visuellen Dashboards dar, die Teams gemeinsam nutzen können. Wenn Sie als Händler Nachfrageprognosen anhand Ihrer eigenen Absatzdaten prüfen möchten, besuchen Sie ELECTE.
Kommentare
Noch keine Kommentare — starten Sie die Diskussion.