10 herramientas de detección de anomalías que valen la pena en 2026
Compara 10 herramientas de detección de anomalías para observabilidad, calidad de datos y analítica de negocio. Encuentra la más adecuada y descubre cómo ELECTE automatiza los insights.

¿Qué significa la detección de anomalías en tu día a día? Para un SRE, es una métrica de servidor que rompe su patrón a las 2 a.m. Para un equipo de datos, es una tabla del almacén que dejó de actualizarse. Para un responsable de finanzas, es un flujo de caja o un margen que se mueve de una forma que nadie sabe explicar.
Son tres problemas distintos y requieren tres tipos distintos de herramientas de detección de anomalías. La monitorización de nube e infraestructura vigila los sistemas. Las alertas de métricas dedicadas vigilan un conjunto de números más reducido. La calidad de datos y la observabilidad del almacén comprueban si los datos que hay detrás de tus informes son fiables. Comprar entre categorías es la forma en que los equipos acaban pagando una plataforma el doble de grande que su problema.
El contexto también importa. El tiempo de inactividad y los datos erróneos no son riesgos abstractos, y el impacto financiero de las interrupciones de TI es la razón por la que una alerta temprana vale más que un análisis posterior. El mercado en general refleja ese paso de las herramientas de seguridad especializadas a la analítica cotidiana: el informe de mercado de detección de anomalías de Fortune Business Insights valora el mercado en aproximadamente 6980 millones de USD en 2025 y prevé 28 150 millones de USD en 2034.
A continuación encontrarás una valoración práctica de 10 opciones, con los límites reales de cada una, seguida de un marco sencillo para ayudarte a elegir.
1. ELECTE AI Agents
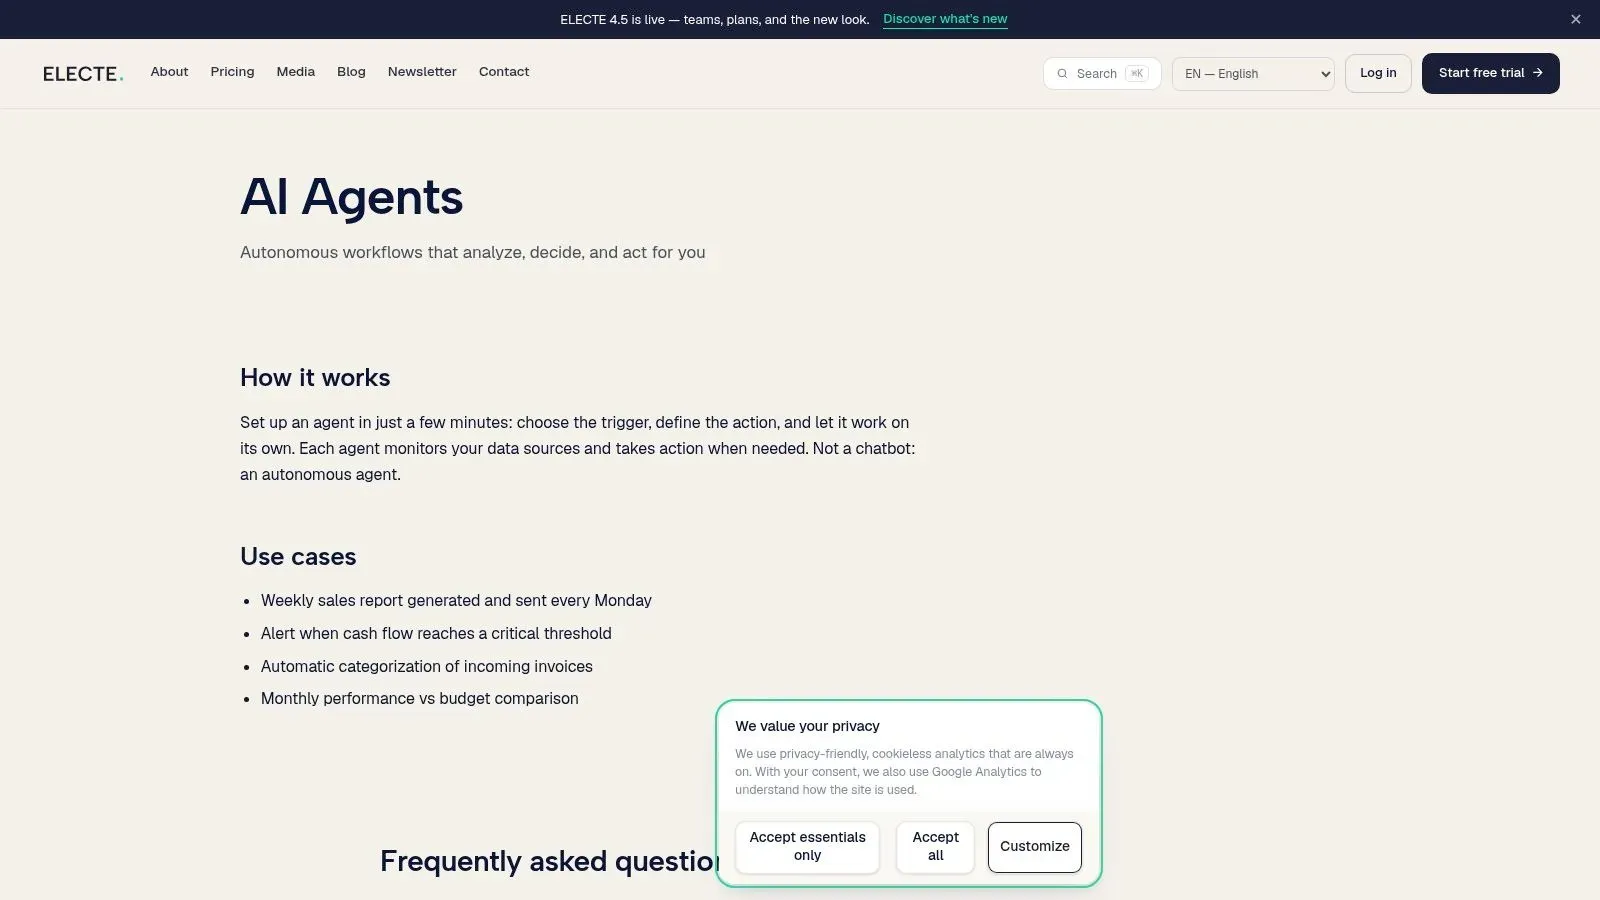
Las herramientas de detección de anomalías que aparecen más abajo en esta lista monitorizan sistemas, métricas y pipelines. Los AI Agents de ELECTE vigilan los datos de negocio, y esa distinción decide si esta opción te conviene. Los agentes monitorizan de forma continua los datos conectados, identifican anomalías y tendencias emergentes y presentan insights para que tu equipo no tenga que revisar informe tras informe buscando qué ha cambiado.
El agente funciona como un analista siempre activo, no como un chatbot que espera un prompt ingenioso. Lee tus datos, señala movimientos inusuales en ingresos, transacciones, inventario o indicadores de riesgo y presenta lo que requiere atención en un lenguaje que un responsable puede convertir en acción. Por eso es la opción de esta lista pensada para la detección de anomalías del responsable de finanzas, no para la del SRE.
Dónde ayuda más el modelo de agentes
- Monitorización continua: las anomalías y tendencias aparecen a medida que surgen, no a fin de mes cuando alguien por fin abre una hoja de cálculo.
- Análisis accionable: el resultado explica qué cambió y por qué importa, en lugar de quedarse en un intercambio de pregunta y respuesta.
- Contexto de plataforma más amplio: la detección convive con previsión, evaluación de riesgos e informes, de modo que una anomalía detectada puede pasar a una revisión de previsiones o a un informe listo para el consejo.
- Accesible por diseño: los equipos sin conocimientos técnicos especializados pueden trabajar directamente con los insights, algo clave para las pymes que no tienen un perfil de ciencia de datos.
Hay dos límites que conviene mirar con atención. La calidad de los insights depende de las fuentes que conectes: la incorporación se hace mediante conexiones con software de contabilidad o carga de archivos, así que confirma que la configuración cubre tus sistemas antes de comprometerte. La elección del plan también cuenta, ya que los precios escalan de Starter a Enterprise y funciones como los AI insights ilimitados y la previsión avanzada están en los niveles superiores.
Recomiendo esta vía cuando tus anomalías están en los KPI de negocio y no en los logs de infraestructura, y cuando quien debe actuar ante una alerta es un responsable de finanzas u operaciones, no un ingeniero.
2. Amazon CloudWatch
Si tus cargas de trabajo ya se ejecutan en AWS, Amazon CloudWatch es el camino de menor resistencia. Su detección de anomalías en métricas aprende los patrones esperados a partir de datos históricos, construye un rango esperado y te permite crear una alarma cuando una métrica sale de ese rango. El rango se adapta a las tendencias y a los patrones por hora, día y semana, lo que supera a un umbral estático en servicios con picos previsibles.
CloudWatch cubre tanto las métricas proporcionadas por AWS como las personalizadas, y las alarmas de anomalías pueden construirse a partir de datos de métricas y de expresiones matemáticas de métricas compatibles. En cuanto a los logs, CloudWatch Logs puede identificar patrones nuevos o cambiantes, y crear detectores de anomalías de Logs no genera por sí mismo ningún cargo.
- Encaje nativo: métricas, logs, paneles y alarmas ya conviven en un mismo entorno de AWS.
- Alarmas, no solo gráficos: las bandas de anomalías se integran con las alertas, de modo que la detección llega a un ingeniero de guardia.
La contrapartida es el alcance. Es telemetría operativa, no analítica de negocio general, y la configuración y la interpretación pueden resultar incómodas para usuarios no técnicos. Los modelos de anomalías en métricas y las alarmas también pueden sumar cargos de AWS, así que conviene vigilar el número de modelos a medida que escalas.
3. Datadog Watchdog
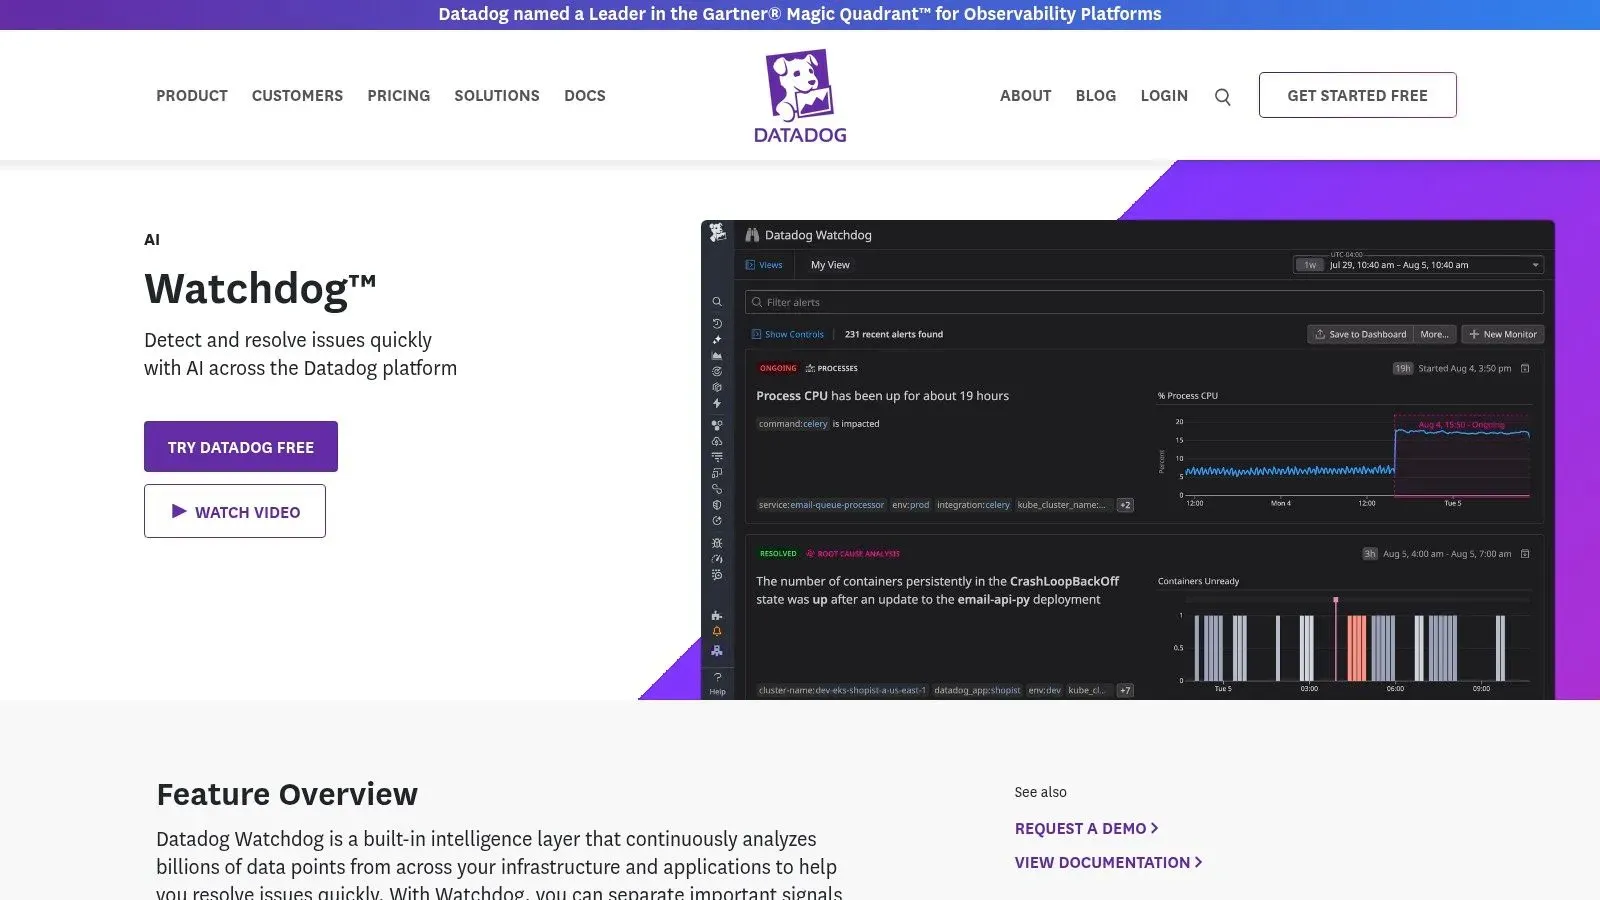
Datadog Watchdog es lo que obtienes cuando la detección de anomalías está integrada en una plataforma completa de observabilidad en lugar de añadirse después. Vigila la infraestructura, el rendimiento de las aplicaciones, los logs y la telemetría de experiencia de usuario, y luego destaca el comportamiento inusual y los posibles factores contribuyentes durante un incidente.
Watchdog detecta anomalías en métricas, valores atípicos y cruces de umbral basados en previsión. Su verdadera fortaleza es la correlación. Cuando la latencia se dispara, las señales relacionadas de los distintos productos de Datadog aparecen juntas, de modo que un ingeniero puede pasar del síntoma a la causa probable sin tener que unir consolas separadas. Una prueba gratuita de 14 días te permite probar ese flujo de trabajo con tu propia telemetría.
Una alerta sin contexto de investigación solo traslada el trabajo. La correlación es lo que convierte un pico en un diagnóstico.
El inconveniente son los costes. El precio crece con los hosts, los productos monitorizados, las métricas personalizadas y el volumen de datos, y algunas funciones avanzadas dependen de tu plan. Además, está pensado para la observabilidad técnica, no para el análisis de negocio. Si tu pregunta es sobre ventas o márgenes, empieza por los insights de detección de anomalías para 2026 y una herramienta orientada al negocio.
4. New Relic
New Relic se gana su lugar aquí por sus condiciones de evaluación. El plan gratuito incluye 100 GB de ingesta mensual de datos y un usuario con acceso a toda la plataforma, sin un reloj de prueba que caduque. Un equipo pequeño puede ejecutar cargas de trabajo reales, aprender el modelo de alertas y decidir con evidencia en lugar de con una presentación comercial.
La plataforma combina telemetría de aplicaciones, infraestructura y registros con consultas y paneles. Las condiciones de alerta pueden usar detección dinámica de anomalías que adapta los umbrales a medida que cambia el comportamiento de los datos, lo que reduce el ajuste manual que exigen los umbrales estáticos. New Relic ofrece una amplia biblioteca de integraciones listadas por el proveedor, de modo que muchos stacks habituales se conectan sin desarrollos a medida.
- Evaluación gratuita real: Los equipos pequeños pueden validar si encaja antes de cualquier conversación sobre presupuesto.
- Factor de coste visible: El precio publicado por ingesta hace predecible un gasto importante.
Predecible no significa barato. El precio escala con la ingesta de datos, el acceso de usuarios y, a veces, el cómputo avanzado, así que la factura sube a medida que conserva más telemetría. El equilibrio que conviene sopesar: si solo necesita detección de anomalías en un puñado de métricas, está pagando precios de plataforma por una sola función. Una herramienta de alertas específica suele cubrir esa tarea por menos. Igual que Datadog, habla el lenguaje de la telemetría técnica, no el de la analítica de negocio, así que un equipo financiero que busque desviaciones en los ingresos encontrará que no es la herramienta adecuada para esa pregunta.
5. Elastic
Elastic es adecuado para equipos que quieren control y cuentan con los especialistas para ejercerlo. Sus trabajos de aprendizaje automático modelan el comportamiento normal en series temporales y otros datos compatibles, y luego señalan desviaciones con una puntuación de anomalía. Las reglas de seguridad pueden alertar cuando las anomalías superan una puntuación que usted elija, lo que hace útil a Elastic tanto en flujos de observabilidad como de seguridad.
Este enfoque tiene raíces profundas. La detección basada en anomalías surgió en la seguridad informática durante la década de 1980, y un estudio sobre detección de intrusiones alojado en Princeton describe IDES, publicado en 1987, como uno de los primeros sistemas que perfilaba la actividad normal y generaba alertas en tiempo real. Elastic aplica el mismo principio a escala moderna. Primero se caracteriza lo normal y después se señala la desviación significativa.
Qué sopesar antes de comprometerse
- Flexibilidad: Usted controla el diseño de los trabajos, la puntuación y cómo los resultados alimentan la búsqueda y las alertas.
- Ventaja si ya usa Elastic: Si Elastic ya impulsa su búsqueda, añadir detección es un paso incremental.
Los costes son operativos. La configuración de los trabajos y la administración continua pueden requerir especialistas, las alertas de anomalías necesitan una suscripción o un nivel de proyecto compatible, y los modelos requieren suficiente histórico de datos antes de ser fiables.
6. Google Cloud Monitoring
Para equipos estandarizados en Google Cloud, Google Cloud Monitoring es la opción natural por defecto, igual que CloudWatch lo es para AWS. Monitoriza métricas en proyectos y recursos, admite métricas personalizadas y gestionadas, y usa ámbitos de métricas para vigilar varios proyectos desde un solo lugar.
Las reglas de alerta envían notificaciones por canales como correo electrónico, SMS, Slack y PagerDuty, lo que cubre la mayoría de configuraciones de guardia sin herramientas adicionales. El precio se basa en el uso, con cuotas mensuales gratuitas publicadas para algunos datos, de modo que puede estimar los costes antes de que el volumen de datos le sorprenda.
- Sensato para empresas en GCP: Sin un nuevo proveedor, sin una nueva estrategia de agentes, sin movimiento de datos entre nubes.
- Cuotas transparentes: Los niveles gratuitos para algunos datos hacen que la adopción inicial sea de bajo riesgo.
Aun así, conviene ser preciso sobre el encaje. Es monitorización de operaciones en la nube, no un vigilante de KPI de negocio como ventas o inventario. Los costes dependen de la ingesta y de otros usos, y la configuración y la interpretación pueden requerir conocimientos de nube que su equipo quizá no tenga internamente. Verifique los flujos de anomalías concretos frente a sus necesidades de alertas durante un piloto, porque la solidez general en monitorización no garantiza el comportamiento de detección que usted busca.
7. Anomaly.io
No todos los equipos necesitan una suite. Anomaly.io hace una sola tarea. Usted envía métricas, aprende patrones con el tiempo, detecta tendencias, correlaciones y otras desviaciones, y envía alertas con contexto en lenguaje sencillo por canales como correo electrónico, SMS y PagerDuty.
Dos detalles lo hacen práctico. La retroalimentación sobre alertas relevantes o irrelevantes ajusta la detección futura, lo que ataca directamente la fatiga de alertas. Además, el precio público indica los límites de métricas y las velocidades de detección, así que conoce los márgenes antes de integrarlo. Acepta métricas desde varios lenguajes de programación, lo que mantiene sencilla la instrumentación.
Regla práctica: Juzgue un detector por las alertas que su equipo puede revisar realmente cada día, no solo por sus resultados en pruebas comparativas.
Ese enfoque tiene dos caras. Es un servicio de métricas, no una plataforma completa de analítica de negocio o informes, y la detección depende de enviar datos adecuados y de dar tiempo para que se aprendan los patrones. Antes de comprometerse, compruebe las integraciones actuales, el encaje del servicio y las condiciones de soporte. Si aún está decidiendo el método, compare algoritmos de detección de anomalías en series temporales primero, porque el algoritmo debe ajustarse a su estacionalidad y a la forma de sus datos.
8. Anomalo
Imagine que sus paneles parecen correctos, pero nadie confía en las cifras. Ese es el problema para el que está creado Anomalo. Monitoriza tablas del almacén de datos, usa aprendizaje automático para detectar patrones inusuales y comprueba actualidad, volumen, datos faltantes y anomalías en las tablas antes de que los datos erróneos lleguen a un informe.
La combinación de detección aprendida y reglas explícitas es lo que lo diferencia. Las comprobaciones de validación sin código conviven con opciones de SQL personalizado y API, de modo que un analista puede codificar una regla de negocio mientras los modelos vigilan los cambios que nadie pensó en especificar. Las visualizaciones y las funciones de investigación de causa raíz ayudan después a rastrear una tabla señalada hasta lo que cambió.
- Dos capas de defensa: Cubre tanto los cambios inesperados como las reglas de negocio conocidas.
- Más allá de los ingenieros: Las verificaciones sin código permiten que los analistas se encarguen directamente de parte del monitoreo.
- Caso de referencia en retail: Un caso de estudio del sector retail describe el monitoreo de ventas, inventario y datos de producto.
El obstáculo es el acceso. Anomalo está orientado a grandes empresas y, por lo general, exige una demo en lugar de una compra self-service sencilla. La idoneidad también depende de las fuentes de datos compatibles y de la configuración de su data warehouse, así que conviene confirmar la compatibilidad desde el principio.
9. Bigeye
Bigeye trata la detección de anomalías como parte de la observabilidad de datos, no como un flujo de alertas aislado. Perfila los datos, detecta anomalías en su comportamiento y combina el monitoreo con linaje, validación, conciliación y gestión de incidentes. Cuando algo falla, el linaje muestra qué informes y usuarios posteriores se ven afectados.
La gestión de alertas está bien resuelta. Las alertas relacionadas se agrupan en incidencias, los flujos de investigación mantienen ordenado el triaje y los comentarios sobre las alertas pueden mejorar la relevancia de las futuras. Ese ciclo de retroalimentación importa porque la confianza decide si un equipo sigue usando un detector. Un estudio reciente de Nature sobre detección de anomalías en ERP reportó una precisión del 88,56 % incluso después de que la votación por conjunto redujera los falsos positivos, un recordatorio de que la gestión del ruido es una funcionalidad, no un añadido de última hora.
El despliegue ofrece enfoques con agente y sin agente, y la documentación de seguridad describe cifrado y AWS PrivateLink opcional para Enterprise. Los límites son el público objetivo y la transparencia. Bigeye está pensado para equipos de datos de grandes empresas, requiere configuración técnica y conexiones con los sistemas de datos, y no publica precios. Para conocer la disciplina de fondo, detectar datos erróneos antes de generar informes explica por qué las verificaciones en el warehouse protegen cada decisión posterior.
10. Monte Carlo
Monte Carlo cierra la lista en la categoría de observabilidad de datos, y su punto fuerte es el contexto de impacto. Detecta problemas de actualidad, volumen, esquema y distribución de datos y luego usa el linaje para mostrar qué depende del activo afectado. Un ingeniero que investiga una tabla desactualizada puede ver qué paneles alimenta antes de que lo noten las partes interesadas.
La cobertura se extiende a activos de datos, sistemas y cambios relacionados con el código, con gestión de incidentes e integraciones para canalizar los problemas hacia los flujos de trabajo existentes. Para organizaciones con pipelines consolidados y equipos de datos dedicados, esa vista de dependencias acorta el camino entre la detección y la resolución.
- Investigación conectada: Las anomalías llegan con el contexto de dependencias e impacto incluido.
- Amplia cobertura de fiabilidad: Las categorías habituales de fallo conviven en una sola plataforma.
Las limitaciones son similares a las de sus competidores. Está diseñada para la fiabilidad de la plataforma de datos, no para analítica de negocio sencilla para equipos no técnicos. Su valor también depende de la escala y la complejidad de su entorno de datos: un warehouse pequeño con tres pipelines obtiene menos beneficio del linaje que uno extenso. No publica precios y la evaluación la dirige el proveedor, por lo que averiguar el presupuesto exige una conversación con ventas.
Claves para elegir tu herramienta y sacarle partido
Empieza por la tarea, no por la lista de proveedores. Un equipo puede comprar monitorización de infraestructura para responder preguntas de negocio, o observabilidad de data warehouse cuando bastaría una simple alerta de métricas. Antes de comparar funciones, haz coincidir la categoría con la decisión que necesitas tomar.
Un marco de selección en cuatro pasos
- Adapta la herramienta a tus datos. Las métricas de infraestructura apuntan a CloudWatch, Datadog, New Relic, Elastic o Google Cloud Monitoring. Las tablas del data warehouse apuntan a Anomalo, Bigeye o Monte Carlo. Los KPI de negocio apuntan a una plataforma orientada al negocio.
- Verifica la integración con lo que ya usas. Un detector que no puede leer tus datos de nube, de warehouse o de contabilidad crea otro pipeline que mantener. Revisa los conectores y los requisitos de datos históricos durante un piloto con datos reales.
- Comprueba cómo escala el precio con el volumen. La ingesta, los hosts, las métricas personalizadas y las tablas monitorizadas crecen con el tiempo. Calcula tu coste con el doble del volumen actual antes de firmar.
- Confirma que los compañeros no técnicos pueden actuar ante las alertas. Una puntuación de anomalía por sí sola no le dice a un responsable de finanzas qué hacer. Busca explicaciones en lenguaje claro, causas probables y un siguiente paso definido.
La implantación no es la meta. Los cambios normales, como promociones, lanzamientos de producto y cambios en el comportamiento de los clientes, desplazan tu línea base. Una revisión de Future AGI sobre los modos de fallo de la detección de anomalías identifica la deriva de concepto y la escasez de anomalías etiquetadas como problemas que las comparativas suelen pasar por alto. Pregunta a cada proveedor quién aprueba los cambios de línea base, cómo se recoge el feedback y si puedes revertir una mala adaptación.
Un detector con un recall algo menor puede aportar más valor si reduce la fatiga de alertas y explica la acción necesaria.
Una empresa en crecimiento sin equipo de datos puede evitar la complejidad de la infraestructura y monitorizar directamente sus métricas de negocio. ELECTE, una plataforma de análisis de datos con IA, monitoriza los datos de negocio, identifica anomalías, detecta tendencias y genera informes. La mayoría de los usuarios está operativa en menos de 5 minutos tras conectar su software de contabilidad o subir un archivo.
Pon un analista siempre activo a trabajar sobre tus datos de negocio, en lugar de otro dashboard que nadie revisa. ELECTE monitoriza tus cifras, señala anomalías y tendencias en cuanto aparecen, y las convierte en análisis e informes claros sobre los que tu equipo puede actuar. Conecta tu software de contabilidad o sube un archivo para ver al instante tu primera previsión.
Comentarios
Aún no hay comentarios — inicia la conversación.