Integración de datos de múltiples fuentes: guía práctica para pymes
Descubre cómo funciona la integración de datos de múltiples fuentes, desde la elección entre ETL y ELT y el mapeo de campos hasta los controles de calidad. Guía práctica para pymes con ejemplos.

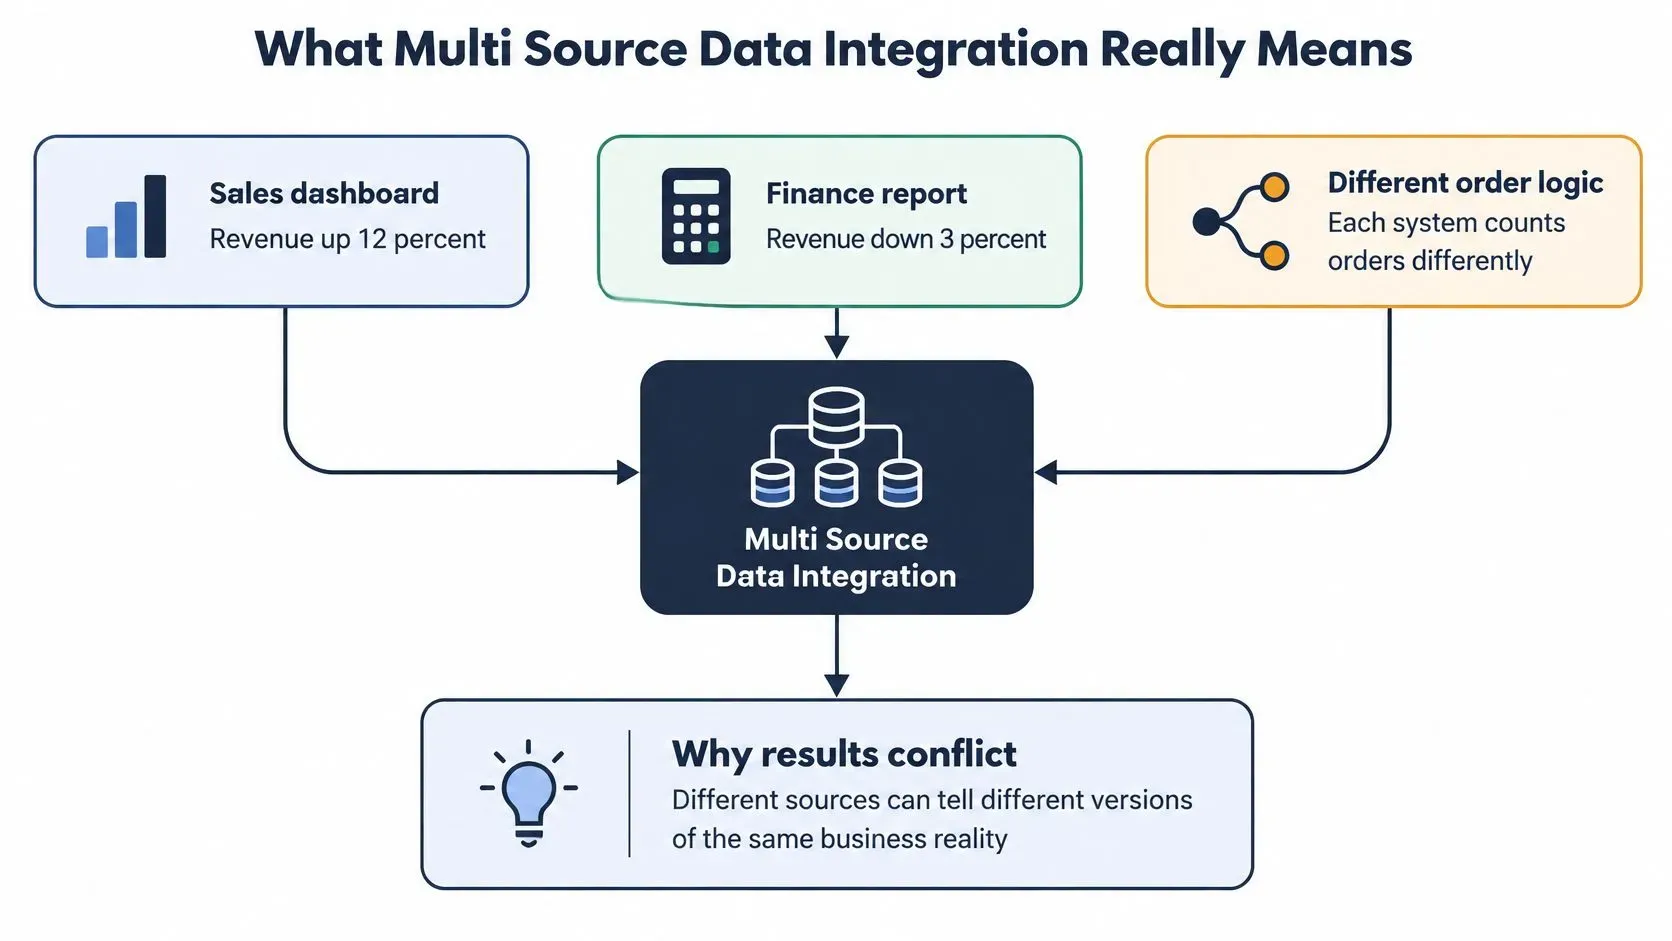
Abres el panel de ventas y los ingresos suben un 12 %. Finanzas, mirando la misma semana, muestra una caída del 3 %. Nadie ha modificado la contabilidad de la noche a la mañana. La tienda online contó todos los pedidos realizados. Finanzas contó el efectivo después de devoluciones y descuentos. Ambos informes son coherentes por sí mismos, y ambos son una base equivocada para un pedido de reposición si los tratas como la misma cifra.
Para resolver ese choque existe la integración de datos de múltiples fuentes. Combinas registros de varios sistemas, como un ERP, un CRM, una plataforma de comercio electrónico, feeds bancarios, API, bases de datos, flujos de eventos y hojas de cálculo, en un único modelo que puedas analizar. Mover filas es la parte fácil. Ponerse de acuerdo sobre qué significan esas filas es el verdadero trabajo.
Piensa en una cocina antes del servicio. Un proveedor envía la harina por sacos, otro la mantequilla por bloques y un tercero manda por correo una lista de precios por cajas. La receta solo funciona cuando todo se pesa en las mismas unidades y se prepara de la misma manera. Con los datos pasa lo mismo.
El NIST Big Data Interoperability Framework lo trata como algo más que un problema de transferencia. Los conjuntos de datos difieren en formato, escala, significado, calidad y temporalidad, y traducir conjuntos de datos diversos y de gran tamaño entre dominios y escalas es una brecha importante de interoperabilidad. El NIST también advierte de que aún hay que evaluar la fiabilidad de las estimaciones construidas a partir de fuentes «combinadas». Las verificaciones entre fuentes y una lectura honesta de la incertidumbre forman parte del trabajo, no de una nota al pie.
Somete cada decisión posterior a estos cuatro desajustes.
- Formato: CSV frente a JSON, códigos frente a nombres, fechas almacenadas como texto.
- Significado: el mismo nombre de campo, una regla de negocio distinta.
- Calidad: duplicados, campos vacíos y valores que no pueden ser ciertos.
- Temporalidad: un feed de esta mañana, otro del martes pasado.
Haz una auditoría de tres preguntas sobre las fuentes que ya tienes. ¿Qué sistema guarda el identificador del cliente? ¿Con qué frecuencia se actualiza cada feed? ¿Quién es responsable de cada cifra cuando los sistemas no coinciden?
Si en esa mezcla hay autorizaciones de tarjeta y archivos de liquidación, la guía de Spell para proveedores de pago de marca blanca es un buen complemento. Las reglas de orquestación deciden qué procesador, divisa y vía de liquidación siguió un pago, y esas reglas cambian incluso lo que significa «ingresos».
Los patrones que siguen mueven los datos. El mapeo los alinea. Las definiciones de métricas compartidas les dan significado. Los controles de calidad evitan que las cifras erróneas lleguen a las decisiones.
Comparativa rápida de patrones de integración
Para la mayoría de los equipos de pymes, empieza con ELT programado. Extrae datos en bruto de API, bases de datos y archivos a un data warehouse en la nube con una frecuencia diaria o por horas, y transfórmalos allí. Los informes cambian a menudo, y es preferible editar un modelo que reconstruir un pipeline.
Esboza los conectores antes de elegir un patrón.
- Conector de CRM o contabilidad: consulta según una programación. El primer día, revisa los límites de frecuencia de la API del proveedor para que la carga de todo el historial no se bloquee por exceso de peticiones.
- Conector de base de datos: lee el registro de cambios. El primer día, confirma los permisos de acceso al registro, porque un usuario de solo lectura para informes a menudo no puede verlo.
- Conector de vigilancia de archivos: recoge las exportaciones CSV o Excel que se depositan. El primer día, fija la regla de nomenclatura de archivos para que «stock_final_v3» no sobrescriba sin dejar rastro el archivo de la semana pasada.
Patrón | Ideal para | Latencia típica | Principal contrapartida |
|---|---|---|---|
ETL (transformar antes de cargar) | Fuentes estructuradas que requieren una limpieza profunda antes de generar informes | De horas a diaria | La lógica de transformación queda fuera del almacén de datos y es más lenta de modificar |
ELT (cargar en bruto, transformar en el almacén de datos) | Almacenes de datos en la nube con muchas fuentes e informes que cambian con frecuencia | De cada hora a diaria | Las copias en bruto requieren almacenamiento y gobernanza |
Streaming con captura de datos de cambios (CDC) | Bases de datos operativas donde los pedidos o el stock cambian durante todo el día | De segundos a minutos | Configuración más compleja y necesidad de monitorizar la carga sobre la fuente |
Consulta periódica de API (polling) | Herramientas SaaS como CRM, contabilidad y plataformas publicitarias | De minutos a cada hora | Límites de uso del proveedor y cambios de esquema |
Entrega programada de archivos (CSV, Excel) | Exportaciones financieras, listas de precios de proveedores y sistemas heredados | Diaria o semanal | Errores manuales y ausencia de historial de cambios si los archivos no se versionan |
Virtualización (consultar las fuentes in situ) | Preguntas ocasionales entre sistemas con poco volumen | Bajo demanda | Consultas lentas y dependencia de la disponibilidad de la fuente |
ETL limpia los datos antes de almacenarlos. Es la mejor opción cuando una fuente debe cumplir reglas de formato estrictas antes de que nadie pueda consultarla, como una exportación bancaria que debe respetar un diseño fijo. El coste es la rapidez de cambio: una columna nueva implica un despliegue fuera del almacén de datos.
ELT carga primero y transforma después. Es la mejor opción cuando las preguntas cambian constantemente, lo habitual en un catálogo en crecimiento o con un plan contable cambiante. Se paga en almacenamiento y en la disciplina de etiquetar las copias en bruto para que nadie elabore informes a partir de ellas por error.
La captura de datos de cambios (CDC) transmite en continuo las inserciones y actualizaciones de una base de datos operativa. Úsela cuando el stock o los pedidos se mueven a lo largo del día y una hora sin datos puede significar una rotura de stock que podría haber visto. Un proceso por lotes nocturno no detectará una promoción que se agota antes del mediodía. A cambio, asume trabajo de configuración y debe vigilar la carga que genera sobre la fuente.
La consulta periódica de API pregunta a una herramienta SaaS, con un temporizador, qué ha cambiado. Encaja con CRM, contabilidad y plataformas publicitarias que no ofrecen un registro de la base de datos. Respete los límites de uso y cuente con que una actualización del proveedor cambie el nombre de un campo sin previo aviso.
La entrega programada de archivos sigue sirviendo para exportaciones financieras, listas de precios de proveedores y todo lo que queda atrapado en un sistema heredado. Versione cada archivo. Sin eso, no se puede saber si el total del martes sustituyó al del lunes o simplemente se añadió junto a él.
La virtualización deja los datos donde están y consulta entre sistemas para una pregunta puntual. Es un mal hogar para un panel que la gente abre cada mañana, porque una fuente lenta o fuera de línea se convierte en la caída de tu informe.
Ajusta la latencia a la decisión, no a la ambición técnica. Un informe semanal para el consejo no necesita streaming.
Regla práctica: Una pyme con tres fuentes suele funcionar bien con sondeo de API para el CRM y el sistema contable, más cargas programadas de archivos para todo lo que solo llega como hoja de cálculo, actualizadas a diario en un almacén de datos donde ELT da forma a la información.
Cómo mapear campos y construir un modelo canónico
Un conector puede entregar todas las columnas y aun así unir a los clientes equivocados. El mapeo es el paso que lo evita.
Seis pasos para mantener un solo significado por campo
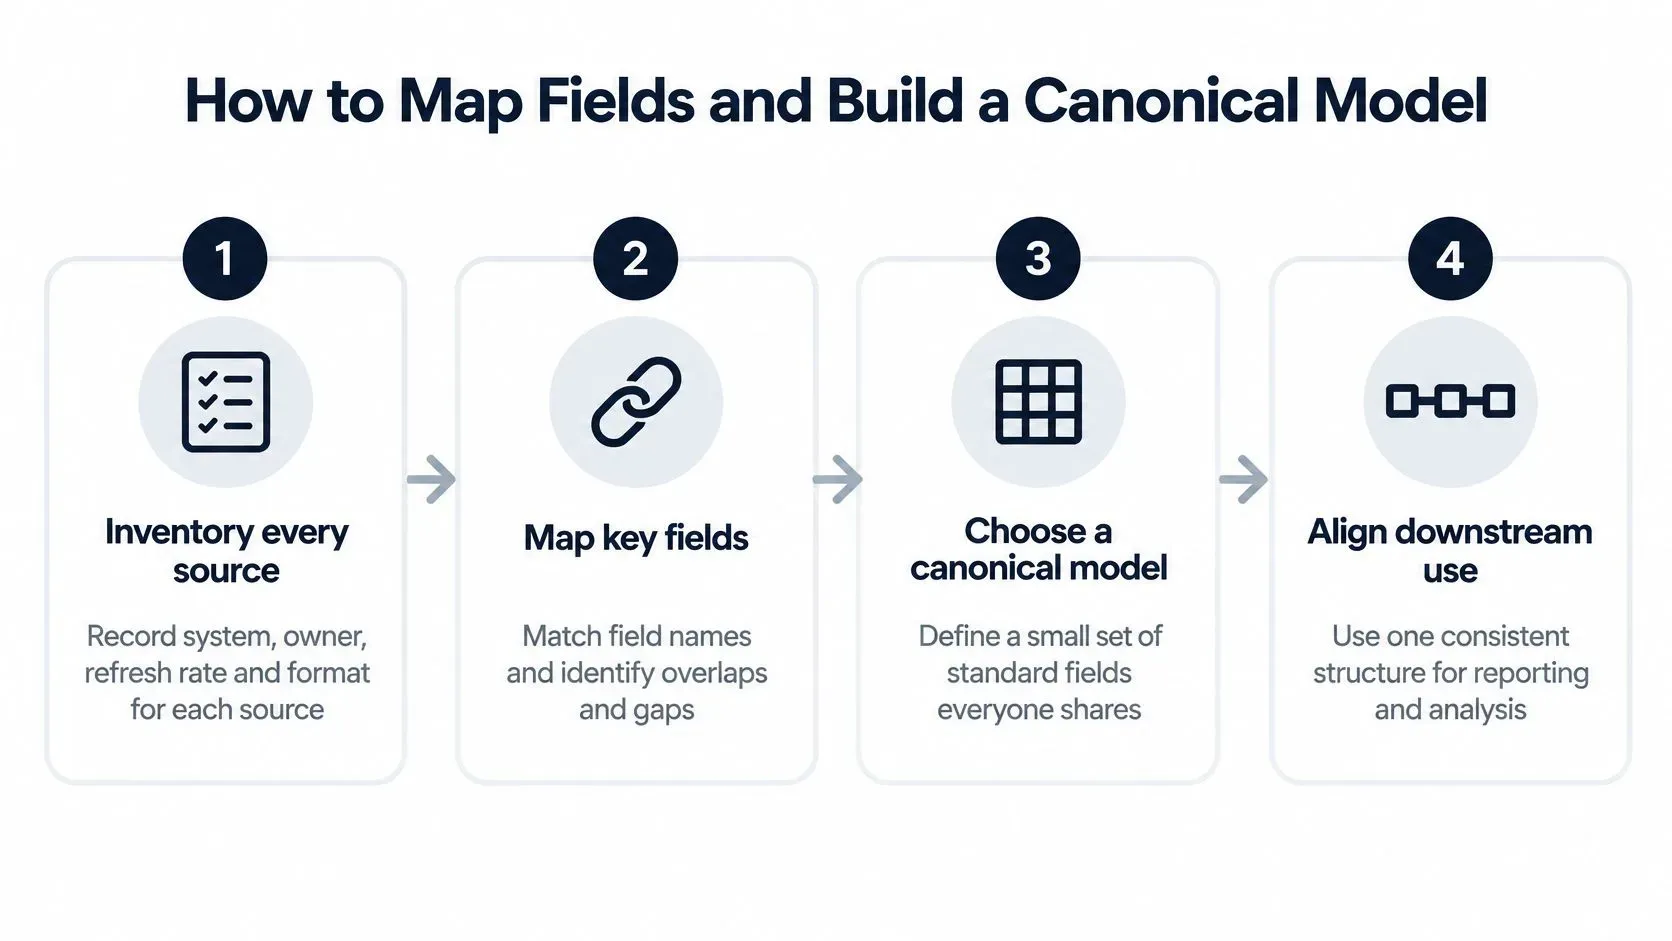
- Haz un inventario de cada fuente y sus campos clave. Registra el sistema, el responsable, la frecuencia de actualización y el formato. No puedes alinear lo que no has listado. El error habitual es omitir la hoja de cálculo que "alguien mantiene", que suele ser el único lugar donde vive el código de un proveedor.
- Elige un modelo canónico. Mantén corta la lista de entidades: cliente, producto, pedido, ubicación y fecha. Dale a cada entidad una única clave de negocio. Las entidades adicionales parecen rigurosas hasta que cada nueva fuente exige una tabla nueva y nadie recuerda cuál usa el reporting.
- Mapea cada campo de origen a un campo canónico. Anota la transformación en la misma fila: conversión de moneda, cambios de unidad, alineación de zona horaria. Un simple cambio de nombre oculta el cálculo. El "importe" de la tienda online y el "importe" del libro mayor no son la misma columna hasta que indicas en qué moneda está y si el impuesto está incluido en la cifra.
- Crea una tabla de equivalencias para los identificadores. Asocia el ID de cuenta del CRM, el código de cliente de contabilidad y el email de la tienda online a una única clave de cliente, y escribe la regla usada en cada coincidencia. El email es una clave débil por sí solo. Las diferencias de mayúsculas y las direcciones con signo más crean duplicados de personas que son un solo comprador.
- Define contratos de interfaz. Nombra cada campo, su tipo, sus valores permitidos y la versión del esquema. Así, una actualización del proveedor falla una prueba en lugar de cambiar lo que significa "estado". Los equipos se saltan este paso porque la primera carga funciona, y luego un campo renombrado alimenta las previsiones durante semanas.
- Carga una muestra y compruébala. Compara totales y uniones con el sistema de origen y corrige las discrepancias antes de cargar todo el histórico. Con el histórico completo, deshacer una unión errónea sale caro. Cien filas mostrarán una clave de producto ausente con la misma claridad.
Presta atención a tres errores en particular. Aparecen clientes duplicados cuando las direcciones de email solo difieren en mayúsculas. Las fechas se desplazan cuando un sistema guarda UTC y otro guarda la hora local sin zona. Las unidades divergen cuando compras cuenta cajas y la tienda vende unidades sueltas, de modo que el inventario parece sano mientras la estantería está vacía.
Cada campo canónico debe poder rastrearse hasta un campo de origen con nombre y una transformación con nombre.
El mismo hábito aparece cuando estás definiendo los ingresos de forma coherente entre departamentos. Un modelo compartido es una lista de decisiones, no un diagrama que se archiva y se olvida.
Acordar las métricas compartidas antes de conectarlo todo
Tres etiquetas originan la mayoría de las discusiones: cliente activo, ingresos netos e inventario disponible. Cada sistema de la tabla ya tiene su propia definición. Ninguno preguntó a los demás.
Métrica | CRM | Finanzas | Tienda online | Regla conciliada |
|---|---|---|---|---|
Cliente activo | Cualquier contacto con una oportunidad abierta | Clientes que pagan | Compradores de los últimos 90 días | Una ventana y una fuente de verdad definidas por el responsable de la métrica |
Ingresos netos | Valor de la oportunidad antes de reembolsos | Ventas brutas menos reembolsos y descuentos | Ventas brutas | Los reembolsos cuentan en la fecha del reembolso y los descuentos promocionales se descuentan |
Tomemos los ingresos netos. Finanzas resta reembolsos y descuentos. La tienda online cuenta las ventas brutas. El CRM suele conservar el valor de la oportunidad del día en que se cerró, antes de que nadie devolviera nada. La primera promoción abre una brecha que parece un error de datos y en realidad son dos fórmulas.
¿Quién es responsable de la definición cuando nadie tiene el cargo de data steward? Esa pregunta importa más que otro conector. Los datos de una encuesta sobre ingeniería de analítica, citados en un informe marco de NORC, muestran que la proporción de encuestados que señalan la integración de diversas fuentes de datos como uno de sus principales retos bajó del 35% en 2025 al 27% en 2026, mientras que la titularidad ambigua de los datos siguió siendo un reto para el 41% de los encuestados. La mala calidad de los datos continuó siendo el obstáculo más citado. Mover los datos se volvió más fácil. Ponerse de acuerdo sobre ellos, no.
Mejores conectores no producen un análisis fiable. El cuello de botella pasa de las tuberías a las definiciones.
Un método de trabajo que puede aplicar este mes
- Escriba una definición por métrica. Incluya la fórmula, qué se incluye, qué se excluye y el periodo de tiempo. "Ingresos netos" sin un periodo no es una definición.
- Designe una fuente de verdad para cada dato de entrada. Los reembolsos pueden provenir solo del libro mayor. Las ventas brutas pueden provenir solo de la tienda online. Dígalo en una frase.
- Designe un aprobador para cada cambio. Un código de descuento renombrado no debería llegar al informe del consejo porque una herramienta de marketing se actualizó durante la noche.
- Envíe los desacuerdos sin resolver a cuarentena. Cada excepción tiene un responsable con nombre. Dejarla en un hilo de chat significa que el panel seguirá publicando ambas versiones.
Una regla conciliada de ingresos netos puede ser así de directa. Los reembolsos cuentan en la fecha del reembolso. Los descuentos promocionales se restan. Todo lo que quede pendiente se convierte en una excepción con responsable, no en una cifra de ajuste silenciosa.
Las pymes rara vez contratan a un steward. Asigne la responsabilidad a quien más usa la cifra. El responsable de operaciones se encarga del inventario disponible. El responsable de finanzas, de los ingresos. Una revisión mensual breve resuelve las disputas antes de que se consoliden en dos paneles distintos.
Si dos personas pueden defender dos fórmulas, todavía no tiene una métrica. Tiene una reunión.
Controles de calidad y comprobaciones de conciliación que protegen los resultados
Las claves duplicadas causan el daño más silencioso. Un mismo cliente almacenado de tres formas infla los compradores activos, subestima el valor medio del pedido y desvía las métricas de riesgo o de inventario. Corrija la unicidad antes de ajustar cualquier otra cosa.
La calidad de los datos es el cuello de botella que aparece antes de elegir herramienta. Una encuesta de TDWI a 672 encuestados indicó que los problemas de calidad de datos eran el principal freno para el éxito de los proyectos de integración, y llevó a los equipos a perfilar los almacenes de origen antes de la implantación. En la misma investigación, un estudio de Forrester encargado por IBM a 518 responsables de decisión globales de TI, datos y negocio concluyó que el 58% señalaba los problemas de calidad como su principal reto de datos. Más de la mitad también tenía dificultades de integración tanto para plataformas de aprendizaje automático como de inteligencia de negocio.
Considere los umbrales siguientes como puntos de partida. Ajústelos por fuente cuando haya visto una semana real de datos.
Control | Qué detecta | Umbral de ejemplo | Acción ante un fallo |
|---|---|---|---|
Unicidad de claves | Identificadores duplicados de clientes o SKU | Cero duplicados en las claves primarias | Bloquear la publicación |
Completitud | Valores ausentes en campos clave | 98 % o más de los campos de ingresos y fechas completados | Poner los registros en cuarentena y bajar la puntuación de calidad |
Actualidad | Fuentes desactualizadas o detenidas | Fuente actualizada dentro del plazo acordado, por ejemplo 24 horas | Mostrar una advertencia de frescura y retener las previsiones |
Integridad referencial | Pedidos que apuntan a productos o clientes desconocidos | Cero filas huérfanas | Poner en cuarentena y abrir una excepción |
Conciliación con totales de control | Totales que difieren del libro mayor de origen o del informe del sistema | Dentro del 0,5 % o de la tolerancia acordada | Bloquear los informes posteriores |
Validez | Valores fuera de rango, como existencias negativas o fechas de factura futuras | Reglas definidas para cada campo | Poner en cuarentena y registrar para su revisión |
Qué bloquea y qué solo puntúa
Bloquea la publicación cuando falle la unicidad de las claves críticas o cuando falle la conciliación con los totales de control. Un panel con clientes duplicados o un total que no cuadra con el libro mayor es peor que no tener panel. Deja pasar los campos no críticos con una puntuación de calidad y su trazabilidad adjunta, para que un teléfono ausente no paralice el cierre.
La cuarentena es una zona de retención, no una papelera. Los registros que fallan llegan allí con un código de motivo. Un revisor los libera o los corrige. Las reglas de supervivencia deciden cuál de dos direcciones en conflicto prevalece, y el valor descartado sigue visible.
ELECTE sobre los controles de calidad de datos es un buen complemento si quieres convertir la supervisión en una rutina y no en una limpieza puntual.
Haz un perfilado de cada fuente en la primera semana. Define tres reglas críticas. Añade un total de control diario para cada fuente importante. Pon una etiqueta de frescura en cada panel para que quien lo lea sepa qué representan las cifras.
Un ejemplo práctico que combina ventas, inventario y promociones
Las cifras de esta escena son ilustrativas, no el resultado de un cliente. Supongamos que una tienda online de 40 personas vende a través de una plataforma de comercio electrónico, controla las existencias del almacén en una hoja de cálculo y gestiona las ofertas en una herramienta de marketing. El equipo de promociones informa de un aumento del 15 por ciento. Aun así, las líneas promocionadas se agotan tres días antes de que termine la campaña. El aumento y la estantería vacía cuentan historias distintas porque las fuentes nunca estuvieron pensadas para encontrarse.
Una encuesta de la OCDE a más de 2.000 pymes de 12 países reveló que el 61% utilizaba al menos una aplicación con IA, pero el 56,6% la usaba solo para tareas aisladas. Solo el 19% la aplicaba en varias funciones o en toda la empresa, y apenas el 3,6% había implantado IA agéntica. Otra encuesta de 2026 a pequeñas empresas, citada en ese artículo de Forbes, situó la falta de conocimientos en primer lugar entre las barreras de adopción, con un 32,1%, seguida del retorno de la inversión poco claro, con un 23,1%, y las dificultades de integración, con un 18,4%. La pregunta útil no es si una herramienta puede conectar sus datos, sino qué dos fuentes, combinadas con cuidado, se amortizan antes de añadir una tercera.
Un desajuste y su solución
Primera semana: cargue solo ventas y stock, una vez al día, con una tabla de equivalencias de SKU. No toque aún las promociones. Segunda semana: compare las unidades vendidas con las salidas del almacén. Si coinciden, las claves son lo bastante fiables como para incorporar una tercera fuente.
Tercera semana: añada el feed de promociones. El desajuste aparece de inmediato. La herramienta de marketing registra códigos de pack. La tienda online vende SKU individuales. Un "incremento por pack" cuenta un código promocional como si fuera un solo producto, así que la campaña parece más potente que los componentes que realmente salieron del almacén.
Tres soluciones cierran la brecha.
- Tabla de mapeo de packs: divida cada pack en sus SKU componentes antes de medir el incremento.
- Indicador de actualización del stock: muestre si la hoja de cálculo llegó hoy o hace tres días.
- Control total semanal: compare las unidades vendidas con las salidas del almacén y retenga el informe de promociones si difieren.
Mida los días de rotura de stock por SKU promocionado, el error de previsión en las líneas promocionadas, las horas dedicadas al informe mensual y los días necesarios para resolver excepciones. Esas cuatro cifras indican que el flujo de trabajo funciona. Un panel más vistoso, no.
Un comprador sigue aprobando los reaprovisionamientos que superan una cantidad determinada. Conserve la versión anterior del modelo para poder revertir un cambio de esquema en la herramienta de marketing en lugar de reescribirlo bajo presión. Conecte solo los campos que necesita este flujo de trabajo y mantenga los correos electrónicos de clientes fuera de la vista compartida de promociones.
Las uniones por etapas se amortizan más rápido que conectar todos los sistemas a la vez, porque cada nueva fuente llega contrastada con un total en el que ya confía. Otras tácticas prácticas de integración para pymes siguen el mismo patrón: una decisión, dos fuentes y una comprobación que pueda explicar.
Conclusiones clave y su primer flujo de trabajo
Una cifra combinada puede parecer precisa y ser errónea si sus fuentes usan definiciones distintas o se actualizan en momentos diferentes. Empiece por una decisión que el equipo deba tomar y construya un flujo de trabajo pequeño en torno a un número que ya genere dudas.
- Elija dos fuentes cuyo desacuerdo cuesta tiempo, como ventas y stock.
- Defina una métrica compartida registrando su fórmula, qué incluye y su ventana temporal.
- Establezca una regla de calidad y un control total. Retenga el informe si la regla falla.
- Ejecute el flujo de trabajo durante 30 días. Compare los días de rotura de stock o las horas de elaboración de informes con su punto de partida.
- Añada una tercera fuente cuando el primer flujo de trabajo sea estable.
Conecte solo los campos que ese flujo de trabajo necesita. Antes de vincular una fuente, confirme quién es el responsable de los datos y quién puede acceder a ellos. Enmascare los identificadores personales, como los correos electrónicos de clientes, en los informes compartidos.
ELECTE puede respaldar un primer flujo de trabajo: vincule cuentas y fuentes de datos o suba un archivo de Excel, sin proyecto de integración ni configuración técnica. La mayoría de los usuarios está operativa en menos de cinco minutos, con análisis de IA y primeras previsiones disponibles tras conectar el software de contabilidad o subir un archivo. El siguiente paso sensato es conectar sus propios archivos y comprobar una cifra sobre la que ya discuten.
Los conectores reúnen registros; no resuelven qué significa una métrica, qué fuente es la responsable ni si los totales cuadran. Acuerde primero esas decisiones y use después controles de calidad para decidir si una cifra combinada es segura para un reaprovisionamiento, una previsión o un informe de consejo.
ELECTE conecta datos de contabilidad, banca y hojas de cálculo en un panel central que se mantiene actualizado sin exportaciones, con el balance completo proyectado a futuro. Para empezar, elija dos fuentes y una métrica que el equipo discuta.
Comentarios
Aún no hay comentarios — inicia la conversación.