Intégration de données multi-sources : guide pratique pour les PME
Découvrez comment fonctionne l'intégration de données multi-sources : choix ETL ou ELT, mapping des champs, contrôles qualité. Guide pratique pour les PME, avec exemples.

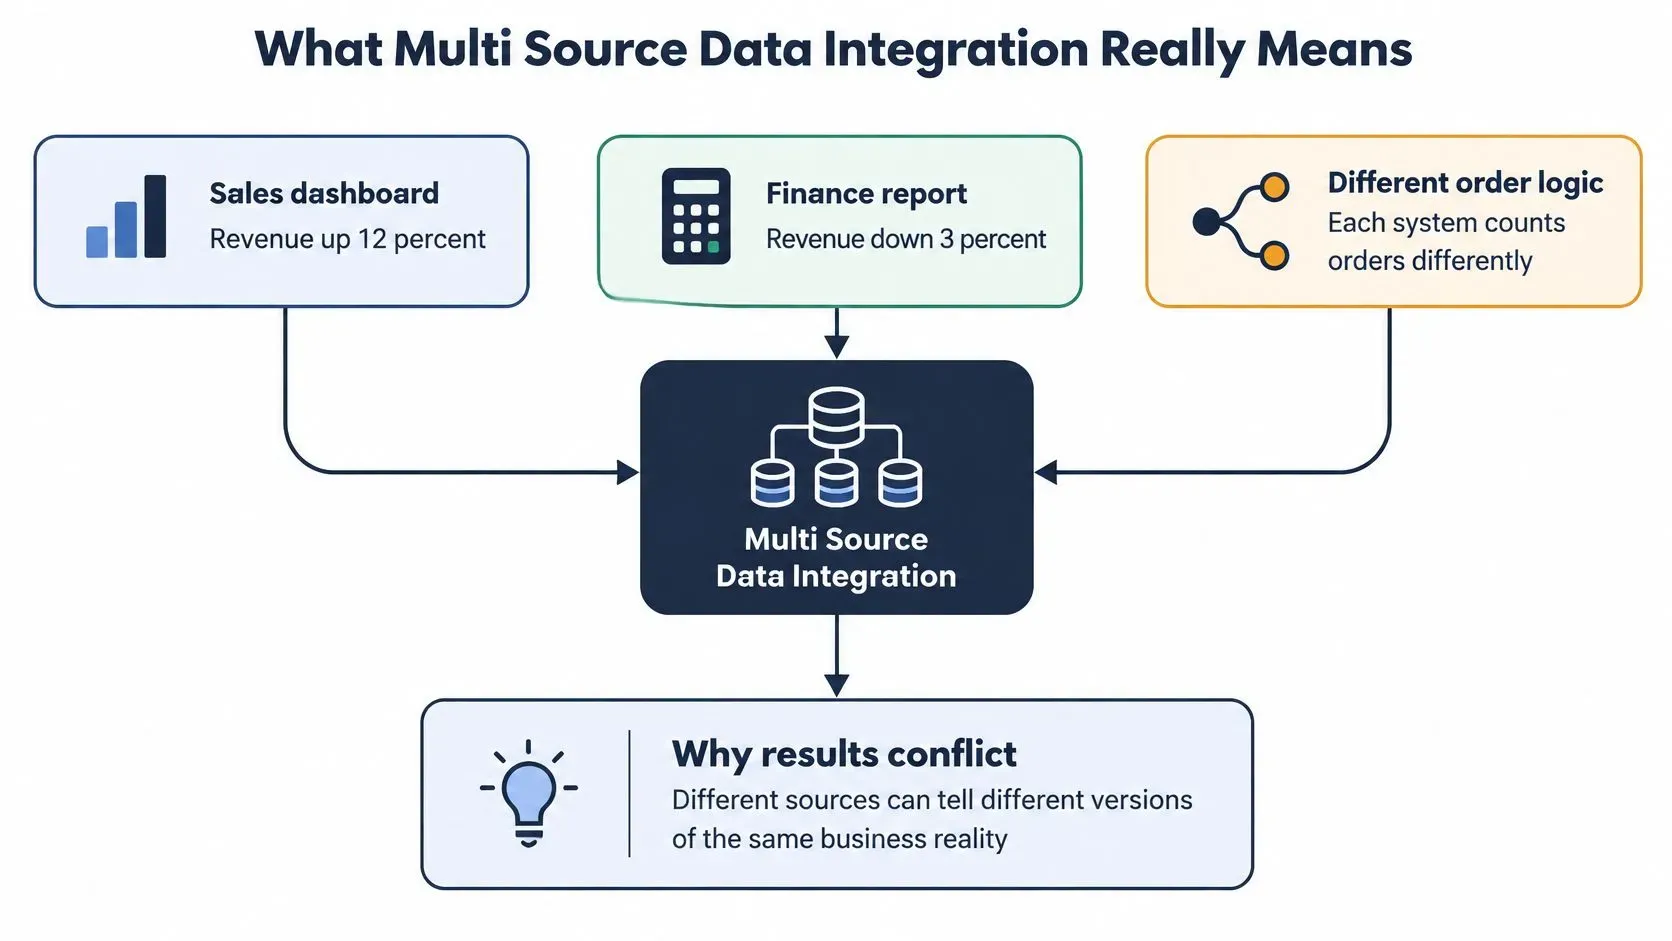
Vous ouvrez le tableau de bord des ventes : le chiffre d'affaires progresse de 12 %. La finance, qui regarde la même semaine, affiche une baisse de 3 %. Personne n'a modifié les comptes pendant la nuit. La boutique en ligne a compté chaque commande passée. La finance a compté l'argent encaissé, après remboursements et remises. Les deux rapports sont cohérents en interne, et aucun des deux ne permet de décider d'un réassort si vous les traitez comme un seul et même chiffre.
C'est exactement ce que résout l'intégration de données multi-sources. Vous rassemblez les données de plusieurs systèmes, comme un ERP, un CRM, une plateforme e-commerce, des flux bancaires, des API, des bases de données, des flux d'événements et des tableurs, dans un modèle unique que vous pouvez analyser. Déplacer les lignes est la partie facile. Se mettre d'accord sur ce qu'elles signifient, c'est là que se trouve le vrai travail.
Pensez à une cuisine avant le service. Un fournisseur livre la farine au sac, un autre le beurre au bloc, un troisième envoie par e-mail une liste de prix à la caisse. La recette ne fonctionne que si tout est pesé dans les mêmes unités et préparé de la même façon. Les données se comportent de la même manière.
Le NIST Big Data Interoperability Framework y voit plus qu'un problème de transfert. Les jeux de données diffèrent par leur format, leur échelle, leur sens, leur qualité et leur temporalité, et traduire des jeux de données variés et volumineux entre domaines et échelles constitue une lacune majeure d'interopérabilité. Le NIST rappelle aussi qu'il faut continuer d'évaluer la fiabilité des estimations construites à partir de sources « mélangées ». Les contrôles croisés entre sources et une lecture honnête de l'incertitude font partie du travail, pas d'une note de bas de page.
Gardez ces quatre écarts en tête pour chaque choix à venir.
- Format : CSV contre JSON, codes contre noms, dates stockées sous forme de texte.
- Sens : un même nom de champ, une règle métier différente.
- Qualité : doublons, champs vides et valeurs impossibles.
- Temporalité : un flux de ce matin, un autre de mardi dernier.
Faites un audit en trois questions sur les sources dont vous disposez déjà. Quel système détient l'identifiant client ? À quelle fréquence chaque flux est-il actualisé ? Qui est responsable de chaque chiffre quand les systèmes ne concordent pas ?
Si des autorisations de carte et des fichiers de versement font partie de ce mélange, le guide de Spell destiné aux prestataires de paiement en marque blanche est un complément utile. Les règles d'orchestration déterminent quel processeur, quelle devise et quel circuit de règlement un paiement a empruntés, et ces règles changent la définition même du « chiffre d'affaires ».
Les modèles ci-dessous déplacent les données. Le mapping les aligne. Des définitions de métriques partagées leur donnent du sens. Des contrôles qualité empêchent les mauvais chiffres d'influencer les décisions.
Comparatif rapide des modèles d'intégration
Pour la plupart des équipes de PME, commencez par un ELT planifié. Récupérez les données brutes des API, bases de données et fichiers dans un entrepôt de données cloud, chaque jour ou chaque heure, puis transformez-les sur place. Les rapports changent souvent, et il vaut mieux modifier un modèle que reconstruire un pipeline.
Esquissez les connecteurs avant de choisir un modèle.
- Connecteur CRM ou comptabilité : interroge la source à intervalles réguliers. Dès le premier jour, vérifiez les limites de débit de l'API du fournisseur pour qu'une récupération de tout l'historique ne soit pas bridée.
- Connecteur de base de données : lit le journal des modifications. Dès le premier jour, confirmez les droits d'accès au journal, car un utilisateur de reporting en lecture seule ne peut souvent pas le consulter.
- Connecteur de surveillance de fichiers : récupère les exports CSV ou Excel déposés. Dès le premier jour, figez la règle de nommage des fichiers pour que « stock_final_v3 » n'écrase pas sans trace le fichier de la semaine dernière.
Modèle | Idéal pour | Latence typique | Principal compromis |
|---|---|---|---|
ETL (transformation avant chargement) | Sources structurées nécessitant un nettoyage important avant le reporting | De quelques heures à un jour | La logique de transformation se situe hors de l'entrepôt et évolue plus lentement |
ELT (chargement brut, transformation dans l'entrepôt) | Entrepôts cloud avec de nombreuses sources et des rapports qui changent souvent | De toutes les heures à quotidien | Les copies brutes exigent du stockage et de la gouvernance |
Streaming par capture des changements de données (CDC) | Bases de données opérationnelles où commandes ou stocks changent toute la journée | De quelques secondes à quelques minutes | Mise en place plus complexe et suivi de la charge sur la source |
Interrogation d'API (polling) | Outils SaaS comme le CRM, la comptabilité et les plateformes publicitaires | De quelques minutes à toutes les heures | Limites de débit des éditeurs et changements de schéma |
Dépôts de fichiers planifiés (CSV, Excel) | Exports financiers, tarifs fournisseurs et systèmes hérités | Quotidien ou hebdomadaire | Erreurs manuelles et aucun historique des modifications sans versionnage des fichiers |
Virtualisation (interrogation des sources sur place) | Questions ponctuelles entre systèmes, à faible volume | À la demande | Requêtes lentes et dépendance à la disponibilité des sources |
L'ETL nettoie avant le stockage. Il s'impose lorsqu'une source doit respecter des règles de format strictes avant que quiconque puisse l'interroger, comme un export bancaire qui doit suivre une structure fixe. Le coût, c'est la vitesse d'évolution. Une nouvelle colonne implique une livraison en dehors de l'entrepôt.
L'ELT charge d'abord et transforme ensuite. Il s'impose quand les questions évoluent sans cesse, ce qui est l'état normal d'un catalogue en croissance ou d'un plan comptable qui change. Vous payez en stockage, et en rigueur pour étiqueter les copies brutes afin que personne ne produise de rapports à partir d'elles par erreur.
La capture des changements de données (CDC) diffuse en continu les insertions et les mises à jour d'une base de données opérationnelle. Utilisez-la lorsque les stocks ou les commandes bougent au fil de la journée et qu'une heure manquée signifie une rupture de stock que vous auriez pu anticiper. Un traitement par lots nocturne ne détectera pas une promotion écoulée avant midi. Vous héritez d'un travail de mise en place et vous devez surveiller la charge que vous imposez à la source.
L'interrogation d'API demande à un outil SaaS, à intervalle régulier, ce qui a changé. Elle convient aux CRM, aux outils de comptabilité et aux plateformes publicitaires qui ne vous donnent pas accès à un journal de base de données. Respectez les limites de débit, et attendez-vous à ce qu'une mise à jour de l'éditeur renomme un champ sans prévenir.
Les dépôts de fichiers planifiés véhiculent encore les exports financiers, les tarifs fournisseurs et tout ce qui est enfermé dans un système hérité. Versionnez chaque fichier. Sans cela, impossible de savoir si le total de mardi a remplacé celui de lundi ou s'il s'y est simplement ajouté.
La virtualisation laisse les données où elles sont et interroge plusieurs systèmes pour répondre à une question ponctuelle. Elle convient mal à un tableau de bord que l'on ouvre chaque matin, car une source lente ou hors ligne devient l'indisponibilité de votre rapport.
Adaptez la latence à la décision, pas à l'ambition technique. Un dossier hebdomadaire pour le conseil d'administration n'a pas besoin de streaming.
Règle pratique : une PME avec trois sources s'en sort généralement bien avec une interrogation d'API pour le CRM et le système comptable, plus des dépôts de fichiers planifiés pour tout ce qui n'arrive que sous forme de tableur, actualisés chaque jour dans un entrepôt de données où l'ELT se charge de la mise en forme.
Comment mapper les champs et construire un modèle canonique
Un connecteur peut livrer toutes les colonnes et pourtant rapprocher les mauvais clients. Le mapping est l'étape qui l'évite.
Six étapes pour garder un seul sens par champ
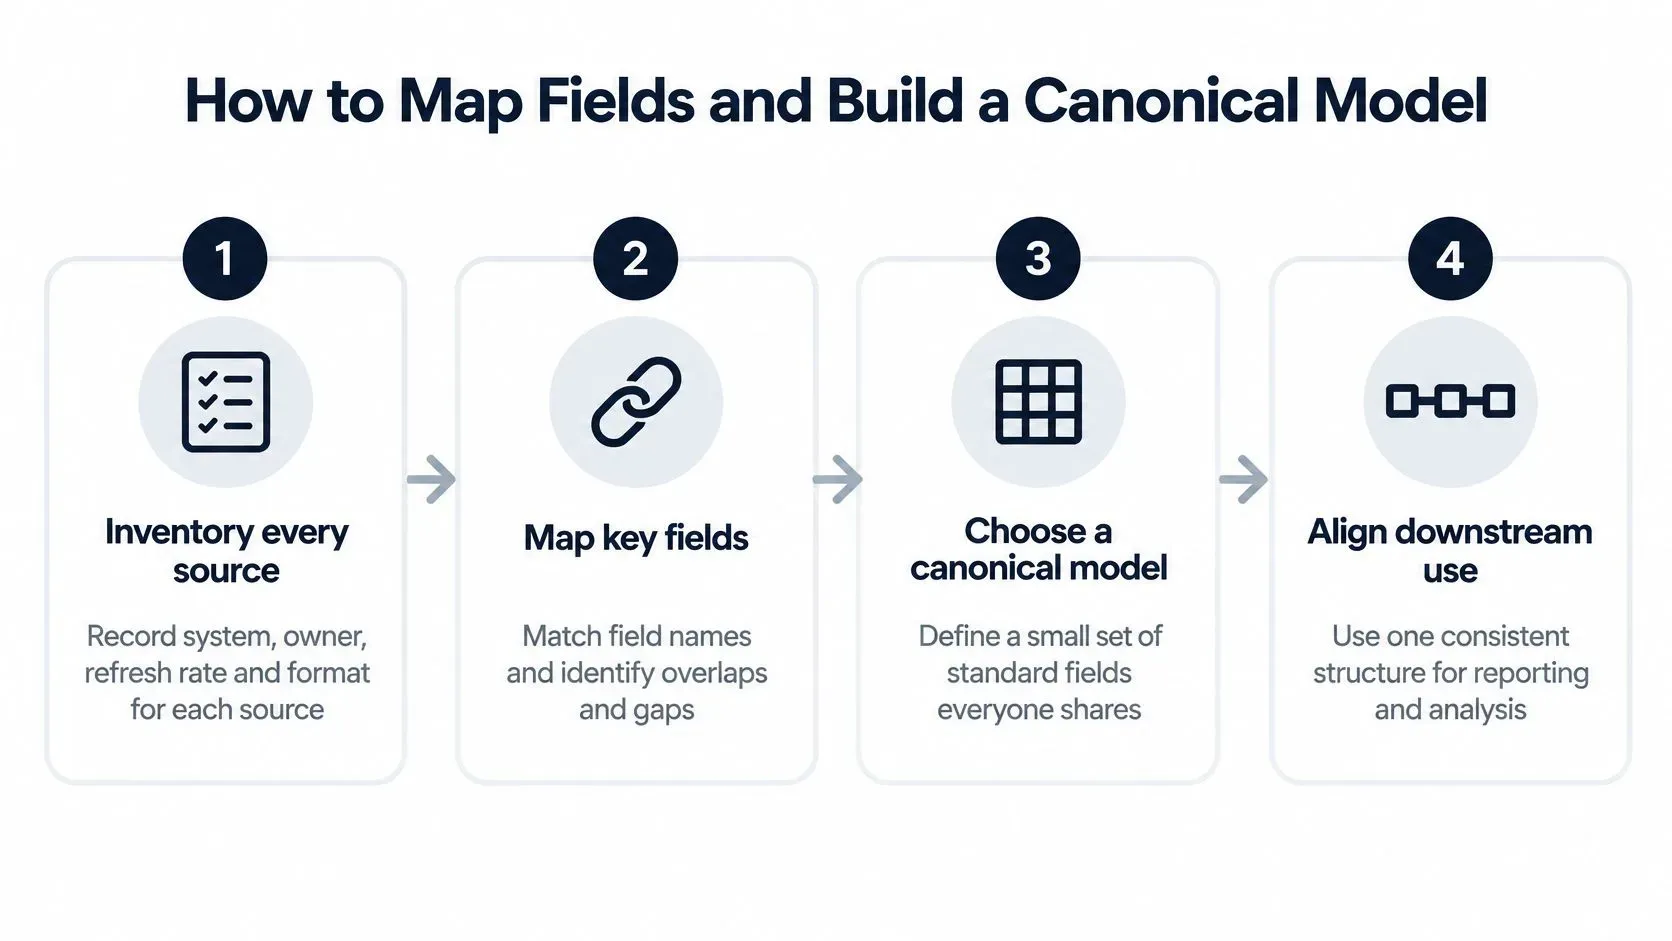
- Inventoriez chaque source et ses champs clés. Notez le système, le responsable, la fréquence d'actualisation et le format. Impossible d'aligner ce que l'on n'a pas listé. L'erreur classique consiste à oublier le tableur que « quelqu'un tient à jour », qui est souvent le seul endroit où figure un code fournisseur.
- Choisissez un modèle canonique. Gardez une liste d'entités courte : client, produit, commande, site et date. Donnez à chaque entité une seule clé métier. Multiplier les entités donne une impression de rigueur, jusqu'à ce que chaque nouvelle source exige une nouvelle table et que personne ne sache laquelle sert au reporting.
- Faites correspondre chaque champ source à un champ canonique. Indiquez la transformation sur la même ligne : conversion de devise, changement d'unité, alignement des fuseaux horaires. Un simple renommage masque le calcul. Le « montant » de la boutique en ligne et le « montant » du grand livre ne forment pas la même colonne tant que vous n'avez pas précisé la devise et si la taxe est incluse.
- Construisez une table de correspondance des identifiants. Rattachez l'ID de compte du CRM, le code client de la comptabilité et l'e-mail de la boutique à une même clé client, et consignez la règle appliquée pour chaque rapprochement. L'e-mail est une clé fragile à lui seul. Les différences de casse et les adresses avec « + » créent des doublons de personnes qui sont en réalité un seul acheteur.
- Définissez des contrats d'interface. Nommez chaque champ, son type, ses valeurs autorisées et la version du schéma. Une mise à jour d'éditeur fait alors échouer un test au lieu de modifier le sens de « statut ». Les équipes l'omettent parce que le premier chargement fonctionne, puis un champ renommé alimente les prévisions pendant des semaines.
- Chargez un échantillon et vérifiez-le. Comparez les totaux et les jointures avec le système source, et corrigez les écarts avant de charger tout l'historique. Avec tout l'historique, une mauvaise jointure coûte cher à défaire. Une centaine de lignes révélera aussi nettement une clé produit manquante.
Surveillez en particulier trois erreurs. Des clients en double apparaissent quand des adresses e-mail ne diffèrent que par la casse. Les dates se décalent quand un système stocke en UTC et un autre en heure locale sans fuseau. Les unités divergent quand les achats comptent des cartons et que la boutique vend à l'unité : le stock paraît sain alors que l'étagère est vide.
Chaque champ canonique doit pouvoir être relié à un champ source nommé et à une transformation nommée.
La même habitude vaut quand vous définissez le chiffre d'affaires de façon cohérente entre les départements. Un modèle partagé est une liste de décisions, pas un schéma que l'on archive et oublie.
S'accorder sur des indicateurs communs avant de tout connecter
Trois libellés déclenchent la plupart des désaccords : client actif, chiffre d'affaires net et stock disponible. Chacun des systèmes ci-dessous en a déjà une définition. Aucun n'a consulté les autres.
Indicateur | CRM | Finance | Boutique en ligne | Règle rapprochée |
|---|---|---|---|---|
Client actif | Tout contact avec une affaire ouverte | Clients payants | Acheteurs des 90 derniers jours | Une seule fenêtre et une seule source de vérité fixées par le responsable de l'indicateur |
Chiffre d'affaires net | Valeur de l'affaire avant remboursements | Ventes brutes moins remboursements et remises | Ventes brutes | Les remboursements comptent à leur date et les remises promotionnelles sont déduites |
Prenons le chiffre d'affaires net. La finance déduit les remboursements et les remises. La boutique compte les ventes brutes. Le CRM conserve souvent la valeur de l'affaire au jour de sa clôture, avant tout retour. La première promotion creuse un écart qui ressemble à un bug de données et qui tient en réalité à deux formules.
Qui est propriétaire de la définition quand personne n'a le titre de data steward ? Cette question compte plus qu'un connecteur de plus. Des données d'enquête sur l'analytics engineering, citées dans un rapport-cadre du NORC, montrent que la part des répondants citant l'intégration de sources de données variées parmi leurs principaux défis est passée de 35 % en 2025 à 27 % en 2026, tandis que la propriété ambiguë des données restait un défi pour 41 % des répondants. La mauvaise qualité des données est restée l'obstacle le plus souvent cité. Déplacer les données est devenu plus simple. S'accorder dessus, non.
De meilleurs connecteurs ne produisent pas une analyse fiable. Le goulot d'étranglement passe des tuyaux aux définitions.
Une méthode concrète à appliquer ce mois-ci
- Rédigez une seule définition par indicateur. Indiquez la formule, ce qui est inclus, ce qui est exclu et la fenêtre temporelle. Un « chiffre d'affaires net » sans fenêtre n'est pas une définition.
- Désignez une source de référence pour chaque donnée d'entrée. Les remboursements peuvent provenir uniquement du grand livre. Les ventes brutes peuvent provenir uniquement de la boutique en ligne. Dites-le en une phrase.
- Désignez un approbateur pour chaque modification. Un code de réduction renommé ne doit pas arriver dans le dossier du conseil parce qu'un outil marketing s'est mis à jour pendant la nuit.
- Placez les désaccords non résolus en quarantaine. Chaque exception a un responsable nommé. Si elle reste dans un fil de discussion, le tableau de bord continue de publier les deux versions.
Une règle de chiffre d'affaires net réconcilié peut être aussi directe que cela. Les remboursements comptent à la date du remboursement. Les remises promotionnelles sont déduites. Tout le reste devient une exception avec un responsable, et non un chiffre d'ajustement silencieux.
Les PME embauchent rarement un steward. Confiez la responsabilité à la personne qui utilise le plus le chiffre. Le responsable des opérations est propriétaire du stock disponible. Le responsable financier est propriétaire du chiffre d'affaires. Une courte revue mensuelle règle les désaccords avant qu'ils ne se figent en deux tableaux de bord.
Si deux personnes peuvent défendre deux formules, vous n'avez pas encore d'indicateur. Vous avez une réunion.
Contrôles qualité et de réconciliation qui protègent vos résultats
Les clés en double causent les dégâts les plus discrets. Un même client enregistré de trois façons gonfle le nombre d'acheteurs actifs, sous-estime le panier moyen et fausse les indicateurs de risque ou de stock. Corrigez l'unicité avant de régler quoi que ce soit d'autre.
La qualité des données est le goulot d'étranglement qui apparaît avant le choix des outils. Une enquête TDWI auprès de 672 répondants indiquait que les problèmes de qualité des données étaient le premier frein à la réussite des projets d'intégration, et poussait les équipes à profiler les sources avant la mise en œuvre. Dans la même étude, une enquête Forrester commandée par IBM auprès de 518 décideurs IT, data et métiers dans le monde a révélé que 58 % citaient les problèmes de qualité comme leur défi n° 1 en matière de données. Plus de la moitié peinaient aussi avec l'intégration, tant pour les plateformes de machine learning que pour celles de business intelligence.
Considérez les seuils ci-dessous comme des points de départ. Ajustez-les source par source après avoir observé une semaine de données réelles.
Contrôle | Ce qu'il détecte | Exemple de seuil | Action en cas d'échec |
|---|---|---|---|
Unicité des clés | Identifiants clients ou SKU en double | Zéro doublon sur les clés primaires | Bloquer la publication |
Complétude | Valeurs manquantes dans les champs clés | 98 % ou plus de champs renseignés pour le chiffre d'affaires et les dates | Mettre les enregistrements en quarantaine et abaisser le score de qualité |
Actualité | Flux obsolètes ou interrompus | Source mise à jour dans le délai convenu, par exemple 24 heures | Afficher un avertissement de fraîcheur et suspendre les prévisions |
Intégrité référentielle | Commandes pointant vers des produits ou clients inconnus | Zéro ligne orpheline | Mettre en quarantaine et ouvrir une exception |
Rapprochement avec les totaux de contrôle | Totaux qui diffèrent du grand livre source ou du rapport du système | Écart de 0,5 % maximum ou tolérance convenue | Bloquer les rapports en aval |
Validité | Valeurs hors plage, comme un stock négatif ou des dates de facture dans le futur | Règles définies par champ | Mettre en quarantaine et consigner pour revue |
Ce qui bloque, et ce qui ne fait que noter
Bloquez la publication lorsque l'unicité des clés critiques échoue ou lorsque le rapprochement avec les totaux de contrôle échoue. Un tableau de bord avec des clients en double ou un total qui ne correspond pas au grand livre est pire que l'absence de tableau de bord. Laissez passer les champs non critiques avec un score de qualité et leur traçabilité, afin qu'un numéro de téléphone manquant ne paralyse pas la clôture.
La quarantaine est une zone d'attente, pas un dossier de suppression. Les enregistrements en échec y arrivent avec un code motif. Un relecteur les libère ou les corrige. Des règles de survie déterminent laquelle de deux adresses en conflit l'emporte, et la valeur écartée reste visible.
ELECTE sur les contrôles de qualité des données est un complément pratique si vous voulez faire du suivi une routine plutôt qu'un nettoyage ponctuel.
Profilez chaque source dès la première semaine. Fixez trois règles critiques. Ajoutez un total de contrôle quotidien pour chaque source majeure. Placez une étiquette de fraîcheur sur chaque tableau de bord pour que le lecteur voie ce que représentent les chiffres.
Un exemple concret combinant ventes, stocks et promotions
Les chiffres de ce scénario sont illustratifs, et non le résultat d'un client. Prenons un e-commerçant de 40 personnes qui vend via une plateforme e-commerce, suit le stock de son entrepôt dans un tableur et gère ses offres dans un outil marketing. L'équipe promotions annonce une hausse de 15 %. Pourtant, les références en promotion sont toujours en rupture trois jours avant la fin de la campagne. La hausse et le rayon vide racontent deux histoires différentes, car ces sources n'ont jamais été conçues pour se rencontrer.
Une enquête de l'OCDE auprès de plus de 2 000 PME dans 12 pays montre que 61 % d'entre elles utilisaient au moins une application dotée d'IA, mais que 56,6 % ne s'en servaient que pour des tâches isolées. Seules 19 % l'appliquaient à plusieurs fonctions ou à l'échelle de l'entreprise, et 3,6 % seulement déployaient une IA agentique. Une autre enquête de 2026 auprès de petites entreprises, citée dans cet article de Forbes, place le manque d'expertise en tête des freins à l'adoption (32,1 %), devant le ROI incertain (23,1 %) et les difficultés d'intégration (18,4 %). La bonne question n'est pas de savoir si un outil peut connecter vos données. C'est de savoir quelles deux sources, jointes avec soin, deviennent rentables avant d'en ajouter une troisième.
Une incohérence, puis la correction
Semaine 1 : chargez uniquement les ventes et le stock, une fois par jour, avec une table de correspondance des SKU. Ne touchez pas encore aux promotions. Semaine 2 : comparez les unités vendues aux sorties d'entrepôt. Si les deux concordent, les clés sont assez fiables pour accueillir une troisième source.
Semaine 3 : ajoutez le flux des promotions. L'incohérence apparaît aussitôt. L'outil marketing enregistre des codes de lots. La boutique en ligne vend des SKU à l'unité. Un « effet de lot » compte un code promo comme s'il s'agissait d'un seul produit, si bien que la campagne paraît plus performante que les composants réellement sortis de l'entrepôt.
Trois correctifs comblent l'écart.
- Table de correspondance des lots : décomposez chaque lot en SKU composants avant de mesurer l'effet.
- Indicateur de fraîcheur du stock : indiquez si le tableur a été chargé aujourd'hui ou il y a trois jours.
- Total de contrôle hebdomadaire : comparez les unités vendues aux sorties d'entrepôt et suspendez le rapport promo si elles divergent.
Suivez les jours de rupture par SKU promu, l'erreur de prévision sur les références promues, les heures consacrées au rapport mensuel et le nombre de jours nécessaires pour résoudre les exceptions. Ces quatre indicateurs montrent que le workflow fonctionne. Un tableau de bord plus joli, non.
Un acheteur valide toujours les réapprovisionnements au-delà d'une quantité définie. Conservez la version précédente du modèle afin de pouvoir revenir en arrière en cas de changement de schéma dans l'outil marketing, plutôt que de tout réécrire dans l'urgence. Ne connectez que les champs dont ce workflow a besoin et gardez les e-mails des clients hors de la vue promo partagée.
Les jointures par étapes sont rentabilisées plus vite que la connexion de tous les systèmes d'un coup, car chaque nouvelle source s'ajoute à un total en lequel vous avez déjà confiance. D'autres tactiques d'intégration pratiques pour les PME suivent le même schéma : une décision, deux sources, un contrôle que vous savez expliquer.
À retenir et votre premier workflow
Un chiffre consolidé peut sembler précis et pourtant être faux si ses sources utilisent des définitions différentes ou s'actualisent à des moments différents. Commencez par une décision que l'équipe doit prendre, puis bâtissez un petit workflow autour d'un chiffre que chacun remet déjà en question.
- Choisissez deux sources dont le désaccord coûte du temps, par exemple les ventes et le stock.
- Définissez un indicateur commun en consignant sa formule, ce qu'il inclut et sa période.
- Fixez une règle de qualité et un total de contrôle. Suspendez le rapport si la règle n'est pas respectée.
- Faites tourner le workflow pendant 30 jours. Comparez les jours de rupture ou les heures de reporting à votre référence.
- Ajoutez une troisième source une fois le premier workflow stabilisé.
Ne connectez que les champs dont ce workflow a besoin. Avant de lier une source, vérifiez qui détient les données et qui peut y accéder. Masquez les identifiants personnels, comme les e-mails des clients, dans les rapports partagés.
ELECTE peut prendre en charge un premier workflow : reliez vos comptes et sources de données ou importez un fichier Excel, sans projet d'intégration ni configuration technique. La plupart des utilisateurs sont opérationnels en moins de cinq minutes, avec l'analyse par IA et les premières prévisions disponibles après la connexion d'un logiciel comptable ou l'import d'un fichier. La suite logique : connecter vos propres fichiers et vérifier un chiffre sur lequel vous débattez déjà.
Les connecteurs rassemblent les enregistrements ; ils ne tranchent pas ce que signifie un indicateur, quelle source en est responsable ni si les totaux concordent. Prenez d'abord ces décisions, puis utilisez des contrôles qualité pour juger si un chiffre consolidé est fiable pour un réapprovisionnement, une prévision ou un dossier de conseil d'administration.
ELECTE réunit comptabilité, données bancaires et tableurs dans un tableau de bord central, à jour sans exports, avec le bilan complet projeté dans le temps. Pour commencer, choisissez deux sources et un indicateur que l'équipe conteste.
Commentaires
Aucun commentaire pour l'instant — lancez la conversation.