KI-Agenten-Workflows erklärt: So arbeiten autonome Agenten
Erfahren Sie, wie agentische KI-Workflows überwachen, entscheiden und handeln, wie sie sich von Automatisierung unterscheiden und wie Sie sie sicher steuern.

Es ist Donnerstagnachmittag, und Sie starren auf einen Vertriebsreport, der Sie schon am Montag hätte erreichen sollen. Die Zahlen sind in Ordnung, aber sie kommen zu spät, und die Frage, die sie aufwerfen, braucht jetzt noch einmal drei Tage Recherche. Wenn Ihnen dieser Rhythmus bekannt vorkommt, fehlt es Ihnen nicht an Daten. Es fehlt ein System, das die Daten für Sie beobachtet, Veränderungen erkennt und Ihnen eine Entscheidung vorlegt, solange noch Zeit zum Handeln bleibt. Genau diese Lücke sollen agentische KI-Workflows schließen.
Was ein agentischer KI-Workflow ist und warum er jetzt wichtig wird
Ein agentischer KI-Workflow ist eine Abfolge von Schritten, in der ein KI-System Unternehmensdaten überwacht, entscheidet, was relevant ist, und innerhalb der von Ihnen gesetzten Grenzen eine Maßnahme ergreift oder vorschlägt. Es wartet nicht auf einen Prompt. Es beobachtet, durchdenkt eine Aufgabe und bringt Arbeit voran.
Angenommen, ein Vertriebsleiter erfährt am Donnerstag, dass eine Aktion seit Montag die Margen drückt. Ein Wochenreport bringt das Problem irgendwann ans Licht, doch drei Verkaufstage sind dann verloren. Ein agentischer Workflow, der die Marge je Aktion überwacht, würde die Abweichung schon am Montag melden, Rabatthöhe und Absatzmenge prüfen und einen kurzen Bericht senden, der fragt, ob das Angebot pausiert oder angepasst werden soll.
Denken Sie an den Unterschied zwischen einem Thermostat und einem guten Facility Manager. Das Thermostat folgt einer einzigen Regel. Der Manager beobachtet viele Sensoren, wägt Zielkonflikte ab und beauftragt den richtigen Dienstleister.
Warum die Einführung jetzt Fahrt aufnimmt
In der Global Survey on the State of AI von McKinsey, für die zwischen dem 25. Juni und dem 29. Juli 2025 1.993 Teilnehmende befragt wurden, gaben 62 % der Befragten an, dass ihre Organisationen KI-Agenten zumindest erproben. Innerhalb dieser Gruppe hatten 39 % mit dem Experimentieren begonnen und 23 % berichteten, ein agentisches KI-System in mindestens einem Unternehmensbereich zu skalieren.
Die Skalierung blieb begrenzt. In keinem einzelnen Unternehmensbereich gaben mehr als 10 % der Befragten an, Agenten zu skalieren, und die meisten Organisationen in dieser Phase taten dies nur in einem oder zwei Bereichen. Auch die Größe spielte eine Rolle. Fast die Hälfte der Befragten aus Organisationen mit mehr als 5 Mrd. $ Jahresumsatz hatte die Skalierungsphase erreicht, verglichen mit 29 % bei Organisationen mit weniger als 100 Mio. $ Umsatz.
Breites Experimentieren kam vor systematischer Skalierung. Für KMU liegt die Antwort nicht in einem großen KI-Team, sondern in schlanker Governance rund um einen wiederholbaren Workflow.
Sie erfahren, wie sich diese Workflows von älteren Tools unterscheiden, wie sie aufgebaut sind, wie Sie sie steuern und wo sie sich in der Analytik auszahlen. Der rote Faden ist einfach: Behandeln Sie einen Agenten als Betriebsmodell mit messbarer Zuverlässigkeit, nicht als clevere Chat-Funktion.
Wie sich agentische Workflows von Automatisierung und Chatbots unterscheiden
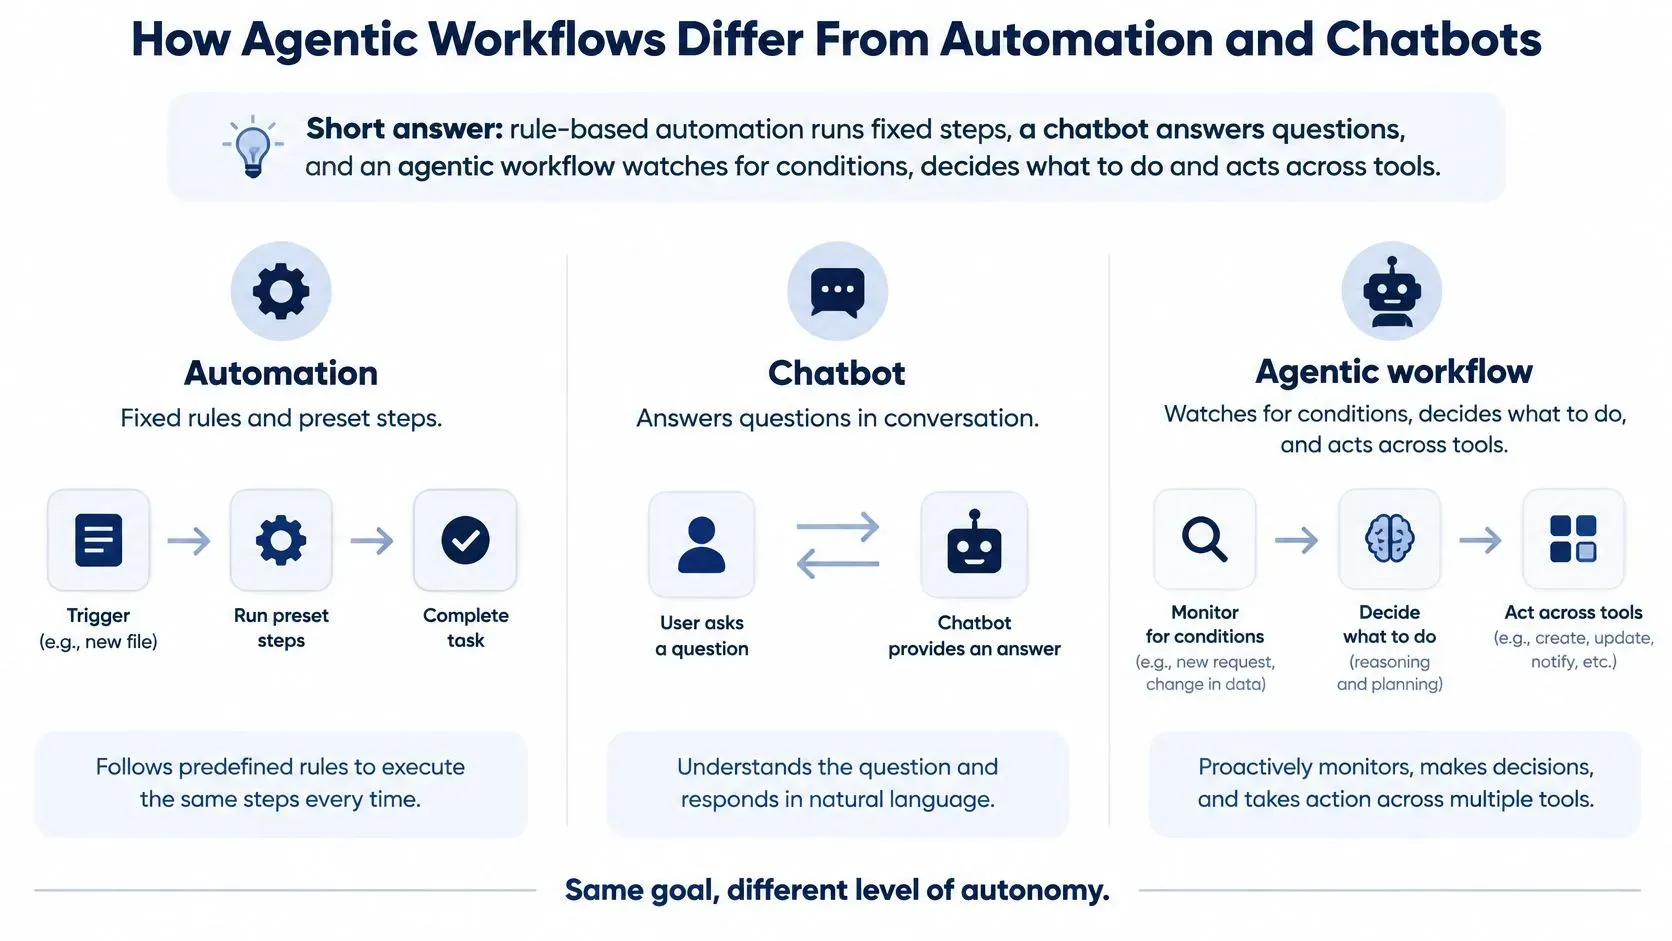
Die kurze Antwort: Regelbasierte Automatisierung führt feste Schritte aus, ein Chatbot beantwortet Fragen, und ein agentischer Workflow überwacht Bedingungen, entscheidet, was zu tun ist, und handelt über mehrere Tools hinweg.
Agentische Workflows im Vergleich zu Automatisierung und Chatbots
Dimension | Regelbasierte Automatisierung | Chatbot | Agentischer Workflow |
|---|---|---|---|
Auslöser | Festes Ereignis oder fester Zeitplan | Frage des Nutzers | Zeitplan, Ereignis oder Überschreiten eines Schwellenwerts |
Entscheidungsfindung | Keine; folgt Wenn-dann-Regeln | Antwortet innerhalb einer Rückmeldung | Plant Schritte und wählt Tools aus dem Kontext |
Aktionen | Nur vordefinierte Schritte | Überwiegend Textantworten | Ruft Tools auf, schreibt Berichte, markiert oder leitet Vorgänge weiter |
Zustand über mehrere Schritte | Keiner über die Regel hinaus | Auf die Chat-Sitzung beschränkt | Verfolgt den Fortschritt im gesamten Workflow |
Umgang mit Überraschungen | Hält an oder wirft einen Fehler | Fragt den Nutzer, was zu tun ist | Versucht es erneut, wechselt die Datenquelle oder eskaliert |
Rolle des Menschen | Erstellt und pflegt die Regeln | Stellt Fragen und prüft die Antworten | Legt Befugnisgrenzen fest und prüft Eskalationen |
Beispiel aus der Analytik | Kopiert jeden Montag eine Verkaufsdatei in eine Tabelle | Beantwortet auf Nachfrage, warum der Umsatz gesunken ist | Erkennt eine Umsatzabweichung, prüft Kanäle und Aktionen und entwirft den Bericht |
Zwei häufige Verwechslungen
Ein Agent ist kein Chatbot mit mehr Funktionen. Die Aufgabe eines Chatbots endet mit der Antwort, selbst wenn diese ausgezeichnet ist. Die Aufgabe eines Agenten endet, wenn eine Aufgabe abgeschlossen, korrekt eskaliert oder sicher gestoppt ist.
Ein Agent ist auch keine feste Automatisierung mit aufgesetztem Sprachmodell. Automatisierung ist ideal, wenn der Ablauf immer gleich bleibt, etwa beim Kopieren einer Datei jeden Montag oder bei einem automatisierten Repricing-Tool, das klare Preisregeln auf Wettbewerbsdaten anwendet. Der Workflow wird agentisch, wenn das System den nächsten Schritt danach wählen muss, was es vorfindet.
Praxistest: Handelt es ohne Aufforderung, erholt es sich, wenn ein Schritt fehlschlägt, und behält es den Kontext über den gesamten Prozess hinweg? Wenn es nicht alle drei Punkte erfüllt, nennen Sie es noch nicht agentisch.
Diese Unterscheidung schützt Ihr Budget. Für stabile, vorhersehbare Aufgaben brauchen Sie keine Agenten-Komplexität, und Sie sollten einer Chat-Oberfläche keinen mehrstufigen Prozess anvertrauen, den sie weder nachverfolgen noch nach Fehlern wieder aufnehmen kann.
Im Inneren der Schleife aus Überwachen, Entscheiden und Handeln
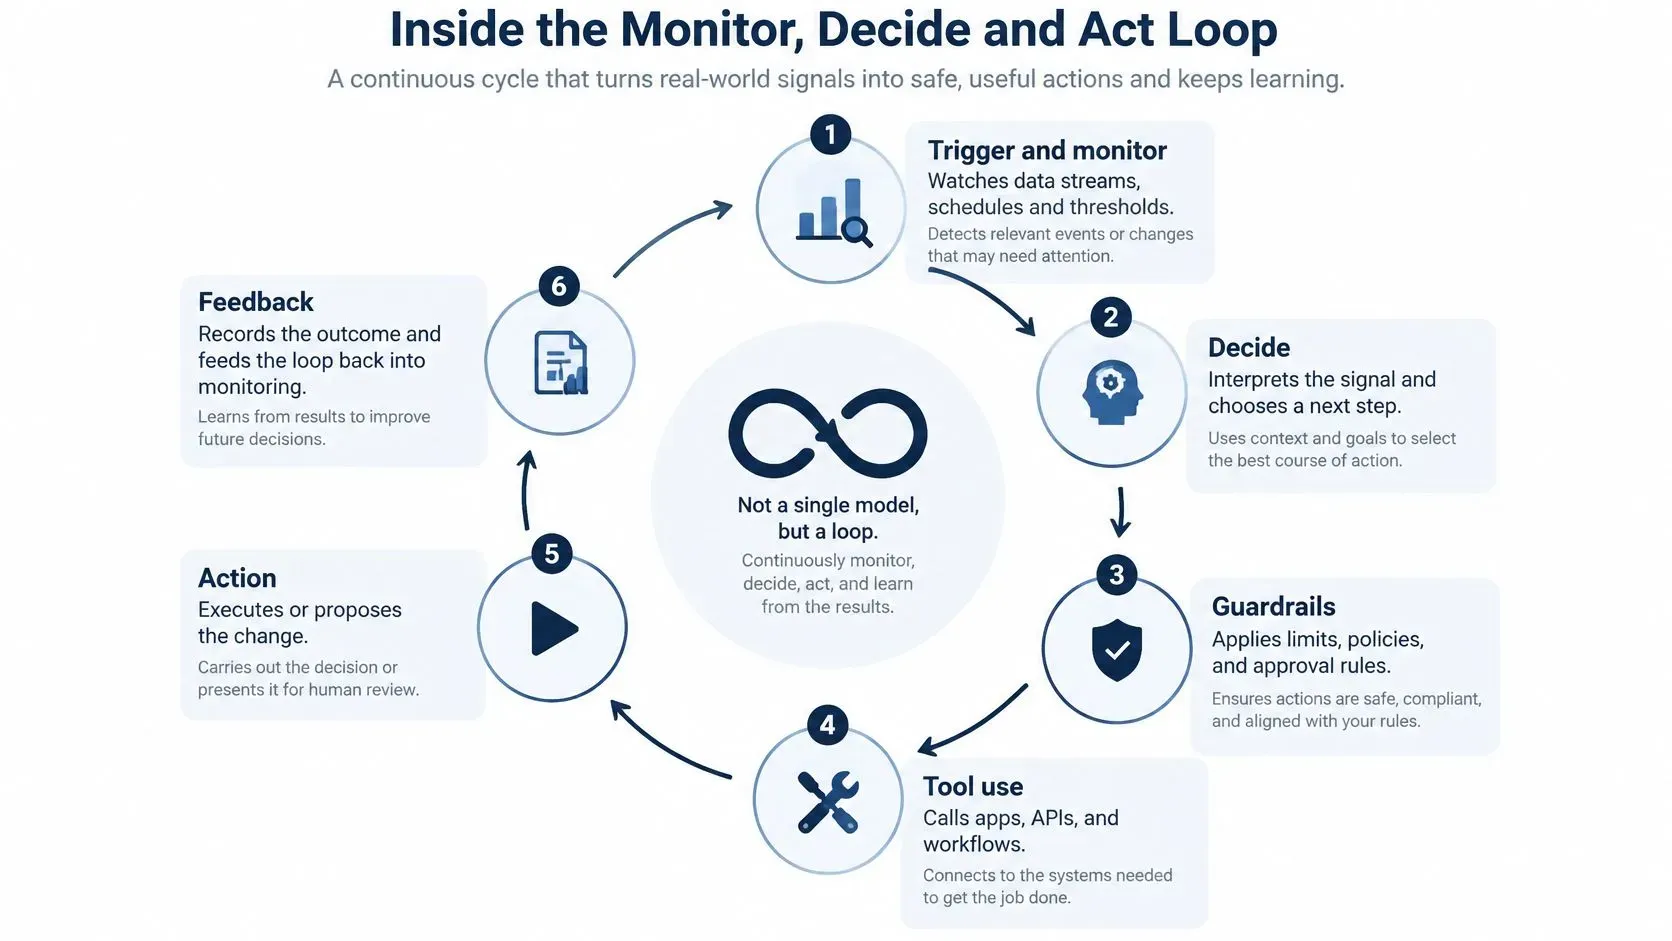
Ein agentischer Workflow ist kein einzelnes Modell. Er ist ein Kreislauf aus miteinander verbundenen Komponenten, und jede Komponente verhindert eine bestimmte Art von Fehler.
Die sechs Komponenten in der Reihenfolge
- Trigger und Monitoring: Überwacht Datenströme, Zeitpläne und Schwellenwerte, etwa den Tagesumsatz im Vergleich zur Prognose. Ohne diese Komponente reagiert der Agent nur, wenn jemand daran denkt, ihn zu fragen.
- Planer: Übersetzt ein Ziel in geordnete Schritte, zum Beispiel erst Bestellungen prüfen, dann Traffic, dann Lagerbestand. Ohne Planer improvisiert der Agent und überspringt möglicherweise genau den Schritt, der das Ergebnis erklärt.
- Tool-Schicht: Verbindet den Agenten mit Datenbanken, Tabellen und APIs, die er abfragen kann. Ohne echte Tools schätzt er eine Zahl womöglich, statt sie abzurufen.
- Zustand und Gedächtnis: Hält fest, was bereits gelaufen ist, was gefunden wurde und was noch offen ist. Ohne Zustand vergisst Schritt vier, was Schritt zwei herausgefunden hat.
- Validierung und Leitplanken: Prüft Quelle, Aktualität, Berechtigungen und Befugnisgrenzen, bevor der Agent handelt. Ohne Prüfungen können veraltete Daten als aktuelle Belege durchgehen.
- Wiederherstellung und Eskalation: Wiederholt Versuche in festgelegtem Rahmen, nutzt eine Ersatzquelle oder übergibt die Aufgabe an einen Menschen. Ohne sie können stille Fehler wie Erfolge aussehen.
Unter dem Kreislauf sollte ein Audit-Log liegen. Protokollieren Sie jeden Tool-Aufruf, jede Eingabe, jede Ausgabe und jede Entscheidung, damit ein Prüfer nachvollziehen kann, warum der Agent eine bestimmte Erkenntnis geliefert hat.
Was passiert, wenn Tools ausfallen
Wiederherstellung ist kein nettes Extra. Im PlanBench-XL-Benchmark bearbeiteten Agenten 327 Retail-Aufgaben in einem Ökosystem aus 1.665 Tools. Dafür waren iterative Tool-Suche, Beweissammlung und sequenzielle Ausführung nötig. Das stärkste getestete Modell erreichte bei vollständig verfügbaren Tools eine Genauigkeit von 51,90 %. Unter starken Blockaden durch fehlende, fehlerhafte oder ablenkende Tools sank sie auf 11,36 %.
Die größten Ausfälle traten auf, wenn Tool-Fehler nicht ausdrücklich signalisiert wurden oder wenn die Wiederherstellung längere alternative Handlungspfade erforderte. Daraus ergeben sich konkrete Designanforderungen für Analytics-Aufgaben:
- Typisierte Tool-Verträge: Legen Sie erwartete Ein- und Ausgaben fest, damit fehlerhafte Ergebnisse abgelehnt werden.
- Explizite Fehlerzustände: Verlangen Sie von Tools, einen Fehler zu melden, statt leere oder unvollständige Daten zurückzugeben.
- Begrenzte Wiederholungen und Fallbacks: Wiederholen Sie eine festgelegte Anzahl von Malen, dann wechseln Sie die Quelle oder eskalieren.
- Pläne mit Checkpoints: Speichern Sie den Fortschritt, damit die Wiederherstellung am fehlgeschlagenen Schritt ansetzt und nicht bei null.
- Eskalation nach Konfidenz: Veröffentlichen Sie keine Erkenntnis und lösen Sie keine Aktion aus, wenn die Beleglage schwach ist.
Überwachen Sie Planungsfehler, Fehler bei der Tool-Auswahl, Ausführungsfehler und Fehler bei der Beleg-Validierung getrennt. Jeder hat eine andere Lösung, und wer sie zusammenfasst, verdeckt, wo der Kreislauf bricht.
Governance-Stufen, die Befugnisse am Risiko ausrichten
Die Aufsicht sollte sich daran orientieren, was ein Agent tun kann und was passiert, wenn er falsch liegt. Eine pauschale Regel bremst entweder harmlose Arbeit oder lässt folgenreiche Arbeit unzureichend kontrolliert.
Eine Governance-Empfehlung im Zusammenhang mit dem AI Risk Management Framework des NIST beschreibt eine gestufte Autorisierung nach Autonomiegrad, Umfang der Befugnisse, Umkehrbarkeit der Aktionen und Einsatzkontext. Außerdem sollten Organisationen Prozesse für die menschliche Aufsicht definieren, bewerten und dokumentieren und dabei die Rollen und Verantwortlichkeiten von Mensch und KI voneinander abgrenzen.
Befugnisstufen für Agentenaktionen
Autorisierungsstufe | Beispielaktionen | Typische Kontrolle |
|---|---|---|
Reine Lesezugriffe (Insights) | Ein Dashboard aktualisieren, Trends zusammenfassen | Protokollierter Zugriff und zitierte Quellen |
Entwerfen und empfehlen | Einen Monatsbericht entwerfen, eine Anomalie markieren | Benannte Prüfperson, bevor etwas weitergegeben wird |
Reversibler interner Schreibzugriff | Einen Datensatz taggen, eine interne Prognose aktualisieren | Freigabefenster und Rollback-Pfad |
Folgenreiche Aktion | Preise ändern, Zahlungen freigeben, Konten schließen | Menschliche Freigabe vor der Ausführung und Ausgabenlimits |
Regulierte Entscheidung | Kreditentscheidungen, Compliance-Meldungen | Dokumentierte menschliche Entscheidung, Nachweisakte und Audit-Trail |
Freigaben wirksam gestalten
Eine Zahlung, eine Kontoschließung, eine Kreditentscheidung oder eine Compliance-Meldung sollte eine Freigabe oder eine stärkere Kontrolle auslösen, während die Kategorisierung risikoarmer Support-Tickets oder die Aktualisierung eines internen Berichts automatisch ablaufen kann. Eine Freigabe funktioniert nur, wenn die Prüfer die nötigen Nachweise erhalten, ein realistisches Zeitfenster zum Eingreifen haben und wissen, was passiert, wenn sie nicht reagieren. KI-Analyse für KMU hilft, die Rolle des Menschen praxisnah einzuordnen.
Ein nur formal vorhandener Not-Aus-Zugriff ist keine echte Kontrolle. Testen Sie Freigabeschranken, Rollback-Pfade und Eskalationswege, solange der Einsatz noch gering ist.
Die Beispiele zu Kredit, Geldwäscheprävention (AML) und Compliance dienen nur der allgemeinen Information und sind keine Rechts- oder Finanzberatung. Behandeln Sie Kunden- und Transaktionsdaten gemäß der Datenschutzrichtlinie Ihres Unternehmens und den geltenden Vorschriften.
Analytics-Anwendungsfälle, in denen sich Agenten auszahlen
Gute Anwendungsfälle folgen einem gemeinsamen Muster. Es gibt ein wiederkehrendes Signal, das jemand von Hand prüft, eine Entscheidung, die Kontext braucht, und eine Aktion, die eine Person prüfen kann, bevor die Folgen eintreten.
Analytics-Anwendungsfälle für agentische Workflows
Anwendungsfall | Was der Agent überwacht | Welche Aktion er ausführt | Entscheidung, die beim Menschen bleibt |
|---|---|---|---|
Warnung bei Umsatzanomalien | Tägliche Bestellungen nach Kanal und Region | Meldet einen Rückgang und prüft Aktionen und Lagerbestand | Ob die Kampagne angepasst wird |
Prüfung von Umsatzabweichungen | Umsatz im Vergleich zur Prognose in jeder Periode | Vergleicht Treiber und entwirft eine Erklärung | Welcher Hebel eingesetzt wird |
Bestand und Nachfrage | Lagerbestände und Abverkaufsquote | Schlägt Nachbestellmengen vor | Genehmigt Bestellungen ab einem festgelegten Wert |
Liquiditätsüberwachung | Forderungen, Verbindlichkeiten und Kontostände | Prognostiziert Engpässe und warnt das Finanzteam | Zeitpunkt von Zahlungen |
Risiko- und Geldwäscheüberwachung | Transaktionen im Abgleich mit Regeln und Mustern | Löst Warnungen aus und stellt eine Fallakte zusammen | Ob eine Meldung erstattet oder der Fall abgeschlossen wird |
Vorbereitung der Vorstandsunterlagen | Monatliche KPIs und Abweichungen | Entwirft die Unterlagen und die Kommentierung | Endgültige Darstellung und Freigabe |
Beispiele aus Handel und Finanzdienstleistungen
Angenommen, ein Händler führt eine Aktion durch, die einen Kanal ankurbelt, während der Lagerbestand in den zwei umsatzstärksten Regionen knapp wird. Der Agent verknüpft diese Signale, prüft die Abverkaufsquote und schlägt Nachbestellmengen zur Genehmigung vor. Müssen zuvor Seiten von Wettbewerbern oder Marktplätzen erfasst werden, kann Web Scraping für strukturierte Daten unübersichtliche externe Seiten in Felder umwandeln, die der Agent validieren und vergleichen kann.
Bei Finanzdienstleistern sieht es anders aus. Der Agent gruppiert zusammengehörige Warnungen, ruft die Transaktionshistorie ab und stellt eine Fallakte zusammen, doch ein Compliance-Beauftragter entscheidet, ob eine Meldung erstattet oder der Fall abgeschlossen wird. An diesem Punkt der Beurteilung kommt es besonders darauf an, wann Modellergebnisse abzulehnen sind.
Der Nutzen liegt in zurückgewonnener Zeit für Analysten und schnellerer Aufmerksamkeit für Anomalien. Sie schaffen das Urteilsvermögen nicht ab. Sie verlagern es nach vorn, wo es das Ergebnis noch verändern kann.
Zuverlässigkeit messen, bevor Sie einem Agenten vertrauen
Eine Demo kann perfekt aussehen, während der zugrunde liegende Prozess unsicher ist. Zeigt Ihr Dashboard nur die Abschlussquote, kann es stille Fehler, eine falsche Reihenfolge der Tools und einen Agenten verbergen, der nach ungültigen Daten einfach weitermacht.
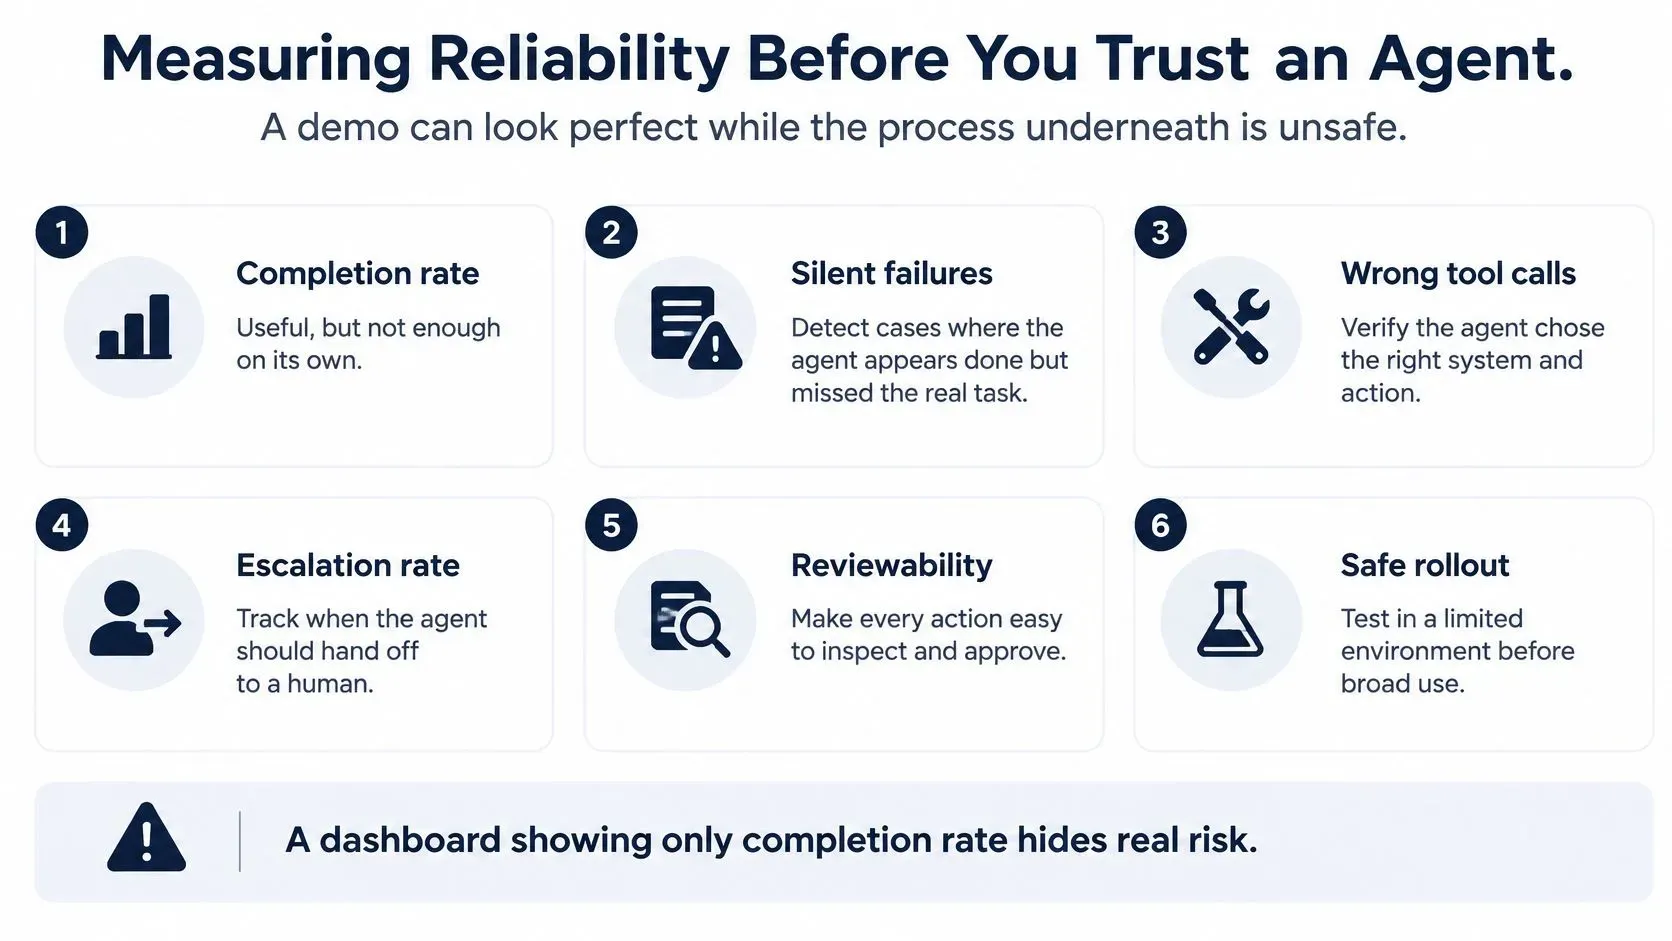
Sieben Kennzahlen und ihre blinden Flecken
- Aufgabenerfolg: Prüft das Endergebnis, übersieht aber eine korrekte Antwort, die über einen unsicheren Weg erreicht wurde.
- Genauigkeit der Tool-Auswahl: Erkennt plausible Zahlen, die aus dem falschen Tool oder der falschen Quelle stammen.
- Genauigkeit der Reihenfolge: Erkennt Schritte in falscher Reihenfolge, die spätere Berechnungen verfälschen.
- Anomalieerkennung: Prüft, ob ungültige, veraltete oder widersprüchliche Daten bemerkt wurden.
- Wiederherstellungsrate: Prüft, ob Fehler sinnvoll wiederholt, umgeleitet oder eskaliert wurden.
- Richtlinienkonformität: Prüft, ob Freigaben und Berechtigungen eingehalten wurden, gestützt durch die Überwachung der Vollständigkeit und Genauigkeit der Daten in den zugrunde liegenden Daten.
- Latenz und Kosten pro abgeschlossener Aufgabe: Zeigen den Mehraufwand, den eine polierte Demo verbirgt.
Der ToolBench-X-Benchmark nutzt ausführbare, mehrstufige Aufgaben in sequenziellen, parallelen und gemischten Workflows und kombiniert deterministische Tools mit einer kanonischen Endantwort. Die Vergleichstabelle nennt für ToolBench-X 1.106 Aufgaben und 4.956 Tool-Interaktionen. Das zentrale Ergebnis: Fehler hängen stärker von schwacher Anomalieerkennung und unwirksamer Fehlerbehebung ab als von der Anzahl der genutzten Tools oder dem Inferenzbudget.
Mehr Modellaufrufe reparieren keinen Agenten, der schlechte Daten nicht erkennt. Messen Sie den Prozess, nicht nur die Antwort.
Für eine Variante in KMU-Größe erstellen Sie repräsentative Aufgaben für eine Absatzprognose, eine Bestandsprüfung, einen Anomalie-Alarm und eine Finanzkontrolle. Legen Sie die richtigen Tools und die Reihenfolge der Aktionen fest, protokollieren Sie jeden Aufruf und jedes Ergebnis und führen Sie die Testreihe nach jeder Änderung an Modell, Prompt, Daten oder Workflow erneut aus. So wird die Agentenqualität zum Regressionstest statt zu einer subjektiven Demo.
Wann Sie Aufgaben an einen Agenten übergeben und wann nicht
Agenten sind nicht kostenlos. Sie verursachen Zeitaufwand, Kosten und zusätzliche Fehlerquellen, deshalb sollten Sie Aufgaben gezielt an sie weiterleiten.
In einem Benchmark, der One-Shot-Prompting mit Plan-Execute-Replan-Agenten vergleicht und in einem Benchmark für werkzeuggestützte Planung beschrieben ist, stieg die Genauigkeit von GPT-4o bei ereigniszentrierter Fragebeantwortung durch Tool-Unterstützung von 47,5 % auf 67,5 %. Gleichzeitig stieg die mittlere Latenz von etwa 8 Sekunden auf etwa 317 Sekunden pro Beispiel, also auf rund das 40-Fache. Bei einer zweiten Aufgabe, der überzeugenden Antwortgenerierung, brachten Planung und Suche zusätzliche Latenz ohne durchgängige Genauigkeitsgewinne.
Plan-Execute-Replan bedeutet: Der Agent entwirft einen Plan, führt die Tool-Schritte der Reihe nach aus und überarbeitet den verbleibenden Plan, sobald Ergebnisse vorliegen. Da sich diese Latenz- und Kostenwerte auf ein einzelnes Beispiel beziehen, sollten Sie sie vor dem Rollout einplanen und nicht erst, wenn Nutzer warten.
Anfragen an direkte Antworten oder Agenten-Workflows weiterleiten
Anfragetyp | Weiterleitung | Erforderliche Prüfung |
|---|---|---|
Einfache, klar definierte Kennzahlenabfrage | Direkt beantworten | Übliche Datenprüfungen |
Mehrdeutige Frage über mehrere Quellen | Planen und Tools einsetzen | Quellenübergreifende Prüfung |
Mehrstufige Berechnung oder unbekanntes Datenschema | Mit Tools planen und ausführen | Zentrale Werte neu berechnen |
Prognose, die ein Budget beeinflusst | Agent erstellt Entwurf mit mehreren Modellen | Menschliche Prüfung der Annahmen |
Aktion mit Auswirkungen auf Geld, Compliance oder Kunden | Agent schlägt vor, Mensch genehmigt | Freigabeschritt und Audit-Log |
Die Verifizierungsregel
Prüfen Sie genauer, wenn ein Ergebnis Prognosen, Compliance, finanzielle Entscheidungen oder automatisierte Aktionen beeinflusst. Verschwenden Sie diesen Aufwand nicht auf eine einfache Kennzahlenabfrage, die eine direkte Abfrage zuverlässig beantwortet.
Erfassen Sie Latenzbudget, Token-Kosten pro abgeschlossener Aufgabe und Genauigkeit als zentrale Kennzahlen Ihres Workflows. Wenn eine Agenten-Route weder bessere Belege noch eine sicherere Verarbeitung bringt, leiten Sie die Anfrage direkt weiter und sparen Sie sich den Mehraufwand.
Wählen Sie in diesem Quartal einen Workflow für den Piloten
Drei Gedanken tragen den gesamten Ansatz. Agenten überwachen, entscheiden und handeln in einer Schleife mit Zustand und Wiederherstellung. Befugnisse sollten sich an den Folgen orientieren. Zuverlässigkeit wird am Prozess gemessen, nicht an der Demo.
Beginnen Sie mit einem wiederkehrenden Workflow, etwa dem wöchentlichen Vertriebsreview oder der täglichen Liquiditätsprüfung. Legen Sie die Befugnisstufe fest, wählen Sie drei Kennzahlen, zum Beispiel Aufgabenerfolg, Anomalieerkennung und Richtlinienkonformität, und lassen Sie den Agenten mehrere Zyklen lang im Schattenmodus laufen und seine Ergebnisse mit denen Ihres Analysten vergleichen. Halten Sie Ergebnisse, Korrekturen und Eskalationen in einem gemeinsamen Protokoll fest und erweitern Sie die Befugnisse erst, wenn die Kennzahlen stabil bleiben. Wenn Sie vor der Auswahl mehr konkrete Muster sehen möchten, ist der praxisnahe Agenten-Leitfaden von AI Tool Seekers eine nützliche Ergänzung.
ELECTE, eine KI-gestützte Datenanalyseplattform für KMU, ist eine Möglichkeit, diesen Piloten zu starten. Der KI-Agent liest Daten, schreibt Berichte und recherchiert den Markt, nach Zeitplan oder auf Abruf, rund um die Uhr. ELECTE ist in 5 Minuten verbunden: Sie verknüpfen Konten und Datenquellen oder laden eine Excel-Datei hoch, ganz ohne Integrationsprojekt und ohne technische Einrichtung.
Stellen Sie in diesem Quartal einen wiederkehrenden Bericht auf einen beaufsichtigten agentischen Workflow um und prüfen Sie, ob Entscheidungen früher bei Ihnen ankommen, mit nachvollziehbaren Belegen. Besuchen Sie ELECTE und sehen Sie, wie die Plattform Ihren eigenen Bericht zu Umsatz, Cashflow oder Lagerbestand verarbeitet. Beginnen Sie mit dem Workflow, den Ihr Team heute jede Woche von Hand prüft.
Kommentare
Noch keine Kommentare — starten Sie die Diskussion.