Multi-Source-Datenintegration: Praxisleitfaden für KMU
Erfahren Sie, wie Multi-Source-Datenintegration funktioniert: von der Wahl zwischen ETL und ELT über das Field Mapping bis zu Qualitätsprüfungen. Praxisleitfaden für KMU mit Beispielen.

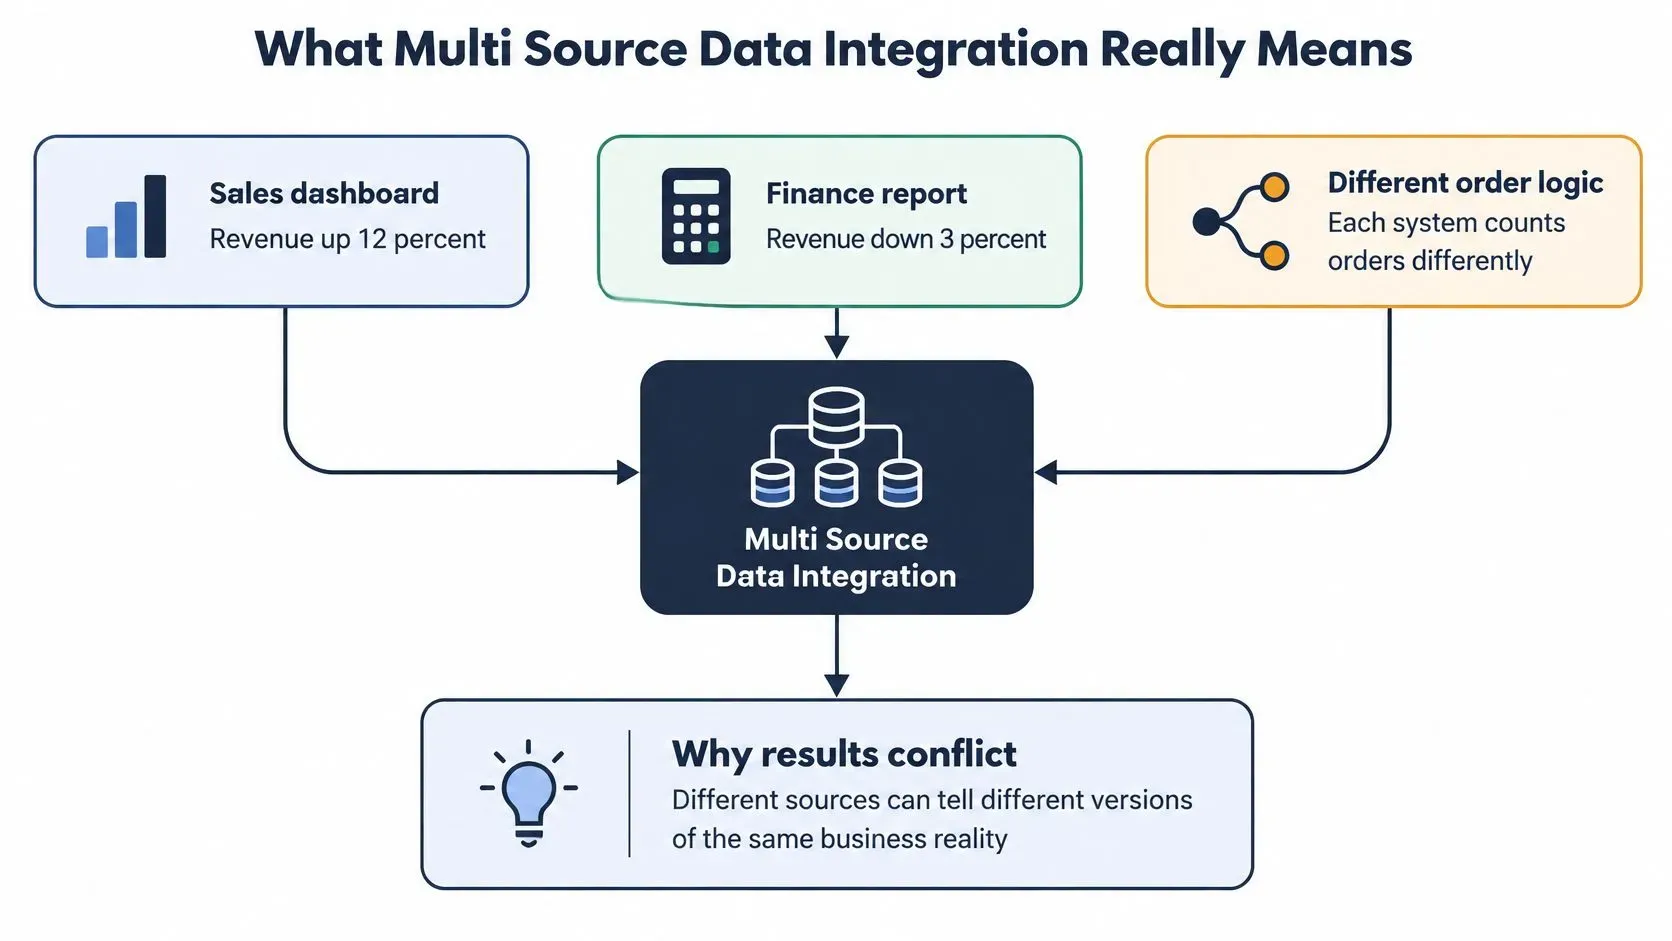
Sie öffnen das Vertriebs-Dashboard, und der Umsatz liegt 12 Prozent im Plus. Die Finanzabteilung zeigt für dieselbe Woche ein Minus von 3 Prozent. Niemand hat über Nacht die Bücher geändert. Der Onlineshop hat jede aufgegebene Bestellung gezählt. Die Finanzabteilung hat den Zahlungseingang nach Erstattungen und Rabatten gezählt. Beide Berichte sind in sich stimmig, doch beide sind die falsche Grundlage für eine Nachbestellung, wenn Sie sie als dieselbe Zahl behandeln.
Genau für diesen Widerspruch gibt es Multi-Source-Datenintegration. Sie führen Datensätze aus mehreren Systemen zusammen, etwa aus ERP, CRM, E-Commerce-Plattform, Bankfeeds, APIs, Datenbanken, Event-Streams und Tabellenkalkulationen, und bringen sie in ein Modell, das sich analysieren lässt. Die Zeilen zu verschieben ist der leichte Teil. Die Arbeit liegt darin, sich darüber zu einigen, was diese Zeilen bedeuten.
Denken Sie an eine Küche vor dem Service. Ein Lieferant schickt Mehl sackweise, ein anderer Butter in Blöcken, ein dritter mailt eine Preisliste in Kartons. Das Rezept funktioniert erst, wenn alles in denselben Einheiten abgewogen und gleich vorbereitet ist. Daten verhalten sich genauso.
Das NIST Big Data Interoperability Framework sieht darin mehr als ein Transferproblem. Datensätze unterscheiden sich in Format, Umfang, Bedeutung, Qualität und Aktualität, und die Übersetzung vielfältiger, großer Datensätze über Domänen und Größenordnungen hinweg ist eine große Interoperabilitätslücke. NIST warnt außerdem, dass die Verlässlichkeit von Schätzungen aus "zusammengewürfelten" Quellen weiterhin bewertet werden muss. Quellenübergreifende Prüfungen und ein ehrlicher Blick auf Unsicherheit gehören zur Aufgabe, nicht in eine Fußnote.
Messen Sie jede spätere Entscheidung an vier Abweichungen.
- Format: CSV versus JSON, Codes versus Namen, Datumsangaben als Text.
- Bedeutung: derselbe Feldname, eine andere Geschäftsregel.
- Qualität: Duplikate, Leerfelder und Werte, die unmöglich stimmen können.
- Aktualität: ein Feed von heute Morgen, ein anderer vom letzten Dienstag.
Führen Sie bei Ihren vorhandenen Quellen ein Audit mit drei Fragen durch. Welches System enthält die Kundenkennung? Wie oft wird jeder Feed aktualisiert? Wer verantwortet jede Zahl, wenn die Systeme sich widersprechen?
Wenn Kartenautorisierungen und Auszahlungsdateien zu Ihren Quellen gehören, ist der Leitfaden von Spell für White-Label-Zahlungsanbieter eine nützliche Ergänzung. Orchestrierungsregeln legen fest, welchen Zahlungsdienstleister, welche Währung und welchen Abwicklungsweg eine Zahlung genommen hat, und diese Regeln verändern, was "Umsatz" überhaupt bedeutet.
Die folgenden Muster bewegen die Daten. Das Mapping gleicht sie an. Gemeinsame Metrikdefinitionen geben ihnen Bedeutung. Qualitätsschranken halten fehlerhafte Zahlen aus Entscheidungen heraus.
Integrationsmuster im Überblick
Für die meisten KMU-Teams empfiehlt sich als Einstieg geplantes ELT. Sie laden rohe API-, Datenbank- und Dateidaten täglich oder stündlich in ein Cloud-Data-Warehouse und transformieren sie dort. Berichte ändern sich oft, und Sie bearbeiten lieber ein Modell, als eine Pipeline neu zu bauen.
Skizzieren Sie die Konnektoren, bevor Sie sich für ein Muster entscheiden.
- CRM- oder Buchhaltungskonnektor: fragt in festen Intervallen ab. Prüfen Sie am ersten Tag die API-Ratenlimits des Anbieters, damit ein Abruf der gesamten Historie nicht gedrosselt wird.
- Datenbankkonnektor: liest das Änderungsprotokoll. Bestätigen Sie am ersten Tag die Zugriffsrechte auf das Protokoll, denn ein schreibgeschützter Reporting-Benutzer kann es oft nicht einsehen.
- Dateiüberwachungskonnektor: übernimmt abgelegte CSV- oder Excel-Exporte. Legen Sie am ersten Tag die Dateibenennungsregel fest, damit "stock_final_v3" nicht spurlos die Datei der Vorwoche überschreibt.
Muster | Am besten geeignet für | Typische Latenz | Wichtigster Kompromiss |
|---|---|---|---|
ETL (Transformation vor dem Laden) | Strukturierte Quellen, die vor dem Reporting aufwendig bereinigt werden müssen | Stunden bis täglich | Die Transformationslogik liegt außerhalb des Data Warehouse und lässt sich langsamer ändern |
ELT (Rohdaten laden, im Data Warehouse transformieren) | Cloud-Data-Warehouses mit vielen Quellen und häufig wechselnden Berichten | Stündlich bis täglich | Rohdatenkopien brauchen Speicherplatz und Governance |
Change-Data-Capture-Streaming | Operative Datenbanken, in denen sich Bestellungen oder Bestände den ganzen Tag ändern | Sekunden bis Minuten | Aufwendigere Einrichtung und Überwachung der Last auf der Quelle |
API-Polling | SaaS-Tools wie CRM, Buchhaltung und Werbeplattformen | Minuten bis stündlich | Ratenlimits der Anbieter und Schemaänderungen |
Zeitgesteuerte Dateiablagen (CSV, Excel) | Finanzexporte, Preislisten von Lieferanten und Altsysteme | Täglich oder wöchentlich | Manuelle Fehler und keine Änderungshistorie, sofern Dateien nicht versioniert werden |
Virtualisierung (Quellen direkt abfragen) | Gelegentliche systemübergreifende Fragen bei geringem Volumen | Auf Abruf | Langsame Abfragen und Abhängigkeit von der Verfügbarkeit der Quelle |
ETL bereinigt die Daten vor der Speicherung. Es lohnt sich, wenn eine Quelle strenge Formatregeln erfüllen muss, bevor sie abgefragt werden darf, etwa ein Bankexport, der ein festes Layout einhalten muss. Der Preis ist die Änderungsgeschwindigkeit: Eine neue Spalte bedeutet ein Release außerhalb des Data Warehouse.
ELT lädt zuerst und transformiert später. Es lohnt sich, wenn sich die Fragestellungen ständig verschieben, was bei einem wachsenden Sortiment oder einem sich ändernden Kontenplan der Normalfall ist. Dafür zahlen Sie mit Speicherplatz und mit der Disziplin, Rohdatenkopien so zu kennzeichnen, dass niemand versehentlich daraus berichtet.
Change Data Capture streamt Einfügungen und Aktualisierungen aus einer operativen Datenbank. Setzen Sie es ein, wenn sich Bestände oder Bestellungen im Tagesverlauf bewegen und eine verpasste Stunde einen Lieferengpass bedeutet, den Sie hätten sehen können. Ein nächtlicher Batch erkennt keine Aktion, die bis zum Mittag ausverkauft ist. Sie nehmen dafür Einrichtungsaufwand in Kauf und müssen die Last im Blick behalten, die Sie auf der Quelle erzeugen.
API-Polling fragt ein SaaS-Tool per Timer, was sich geändert hat. Es passt zu CRM-, Buchhaltungs- und Werbeplattformen, die Ihnen kein Datenbankprotokoll bereitstellen. Beachten Sie die Ratenlimits und rechnen Sie damit, dass ein Release des Anbieters ein Feld ohne Vorwarnung umbenennt.
Zeitgesteuerte Dateiablagen transportieren weiterhin Finanzexporte, Preislisten von Lieferanten und alles, was in einem Altsystem feststeckt. Versionieren Sie jede Datei. Sonst lässt sich nicht erkennen, ob die Summe vom Dienstag die vom Montag ersetzt hat oder nur daneben liegt.
Virtualisierung lässt die Daten, wo sie sind, und fragt systemübergreifend ab – sinnvoll für eine einmalige Frage. Als Grundlage für ein Dashboard, das jeden Morgen geöffnet wird, eignet sie sich schlecht, denn eine langsame oder offline gegangene Quelle wird zum Ausfall Ihres Reports.
Richten Sie die Latenz an der Entscheidung aus, nicht am technischen Ehrgeiz. Ein wöchentlicher Board-Report braucht kein Streaming.
Praxisregel: Ein KMU mit drei Quellen kommt meist gut zurecht mit API-Polling für das CRM und das Buchhaltungssystem, dazu geplanten Datei-Ablagen für alles, was nur als Tabelle ankommt. Die Daten werden täglich in ein Data Warehouse geladen, in dem ELT sie aufbereitet.
So ordnen Sie Felder zu und bauen ein kanonisches Modell auf
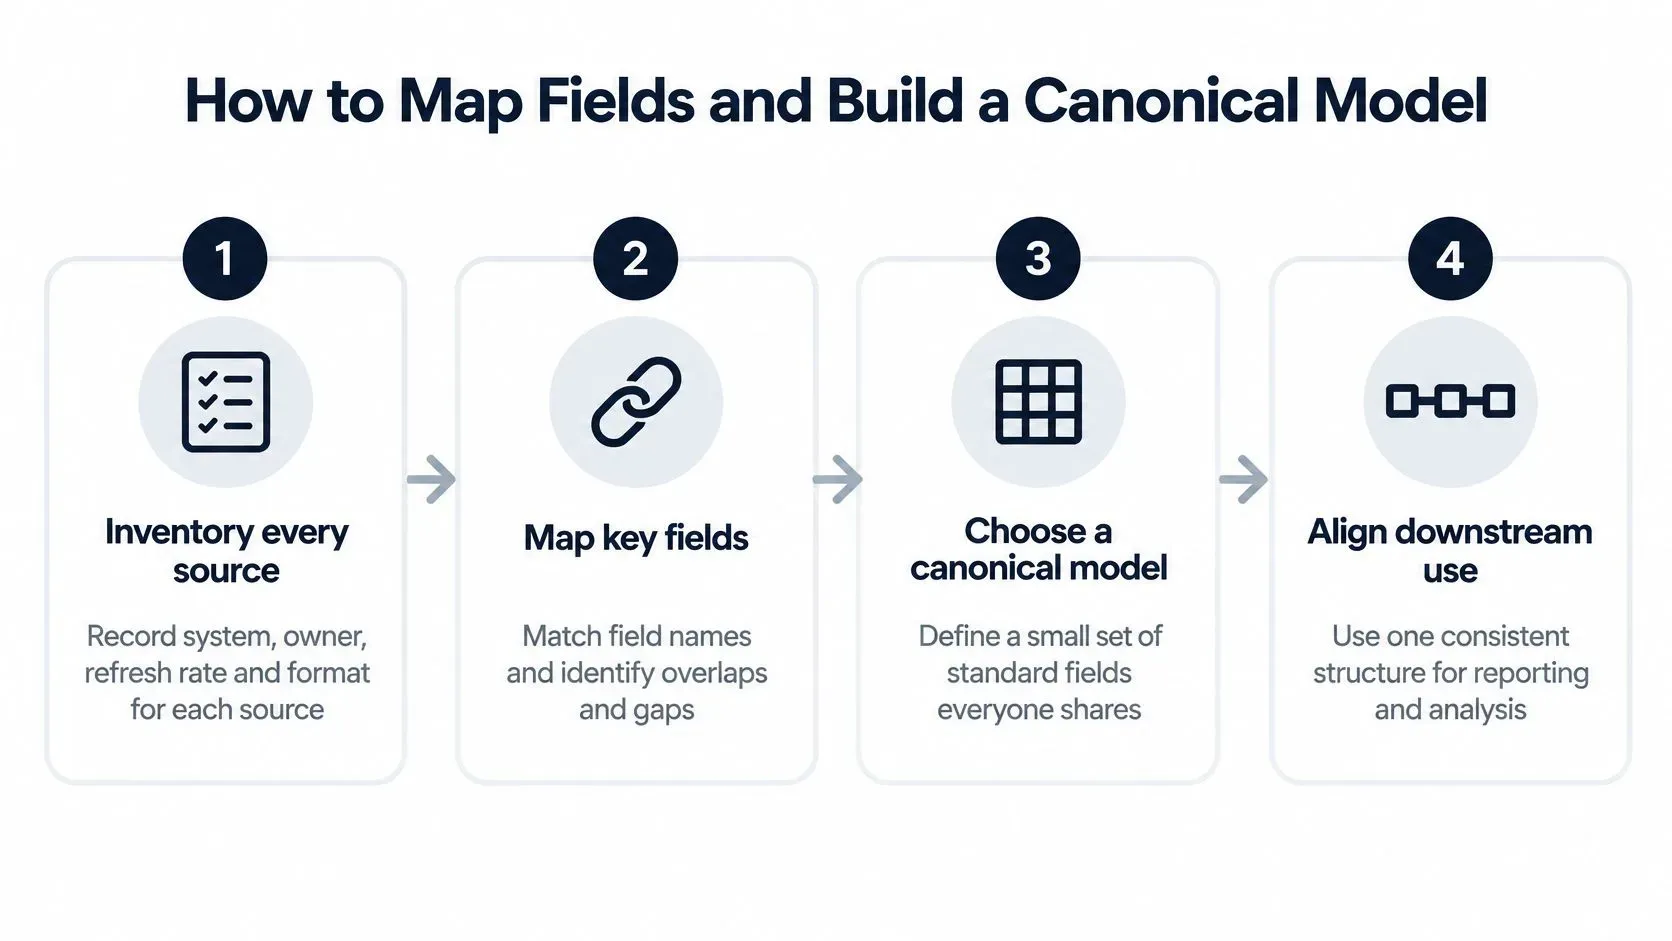
Ein Konnektor kann jede Spalte liefern und trotzdem die falschen Kunden verknüpfen. Die Zuordnung (Mapping) ist der Schritt, der das verhindert.
Sechs Schritte, die jedem Feld genau eine Bedeutung geben
- Alle Quellen und ihre Schlüsselfelder erfassen. Notieren Sie System, Verantwortlichen, Aktualisierungsrhythmus und Format. Was Sie nicht aufgelistet haben, können Sie nicht abgleichen. Der typische Fehler: die Tabelle auszulassen, die „jemand pflegt“ und die oft der einzige Ort ist, an dem ein Lieferantencode steht.
- Ein kanonisches Modell wählen. Halten Sie die Entitätenliste klein: Kunde, Produkt, Bestellung, Standort und Datum. Geben Sie jeder Entität einen Geschäftsschlüssel. Zusätzliche Entitäten wirken gründlich, bis jede neue Quelle eine neue Tabelle braucht und niemand mehr weiß, welche das Reporting nutzt.
- Jedes Quellfeld einem kanonischen Feld zuordnen. Vermerken Sie die Transformation in derselben Zeile: Währungsumrechnung, Einheitenwechsel, Zeitzonenabgleich. Eine bloße Umbenennung verbirgt die Rechnung. „Amount“ aus dem Shop und „amount“ aus der Buchhaltung sind nicht dieselbe Spalte, solange nicht feststeht, in welcher Währung und ob die Steuer im Betrag enthalten ist.
- Eine Crosswalk-Tabelle für Kennungen erstellen. Ordnen Sie die CRM-Konto-ID, den Debitorencode der Buchhaltung und die Shop-E-Mail einem einzigen Kundenschlüssel zu, und halten Sie die Regel für jeden Abgleich schriftlich fest. Die E-Mail allein ist ein schwacher Schlüssel. Unterschiede in der Groß- und Kleinschreibung sowie Plus-Adressierung erzeugen doppelte Personen, die ein und derselbe Käufer sind.
- Schnittstellenverträge festlegen. Benennen Sie jedes Feld, seinen Typ, die zulässigen Werte und die Schemaversion. Ein Update des Anbieters lässt dann einen Test scheitern, statt die Bedeutung von „status“ zu verändern. Teams überspringen das, weil der erste Ladevorgang funktioniert – und dann fließt ein umbenanntes Feld wochenlang in die Prognosen ein.
- Eine Stichprobe laden und prüfen. Vergleichen Sie Summen und Verknüpfungen mit dem Quellsystem, und beheben Sie Abweichungen, bevor Sie die gesamte Historie laden. Mit voller Historie ist eine fehlerhafte Verknüpfung teuer zu korrigieren. Hundert Zeilen zeigen einen fehlenden Produktschlüssel genauso deutlich.
Achten Sie besonders auf drei Fehler. Doppelte Kunden entstehen, wenn sich E-Mail-Adressen nur in der Groß- und Kleinschreibung unterscheiden. Datumsangaben verschieben sich, wenn ein System UTC speichert und ein anderes Ortszeit ohne Zonenangabe. Einheiten laufen auseinander, wenn der Einkauf Kartons zählt und der Shop Einzelstücke verkauft – dann sieht der Bestand gesund aus, während das Regal leer ist.
Jedes kanonische Feld sollte sich auf ein benanntes Quellfeld und eine benannte Transformation zurückführen lassen.
Dieselbe Gewohnheit zeigt sich, wenn Sie den Umsatz abteilungsübergreifend einheitlich definieren. Ein gemeinsames Modell ist eine Liste von Entscheidungen, kein Diagramm, das man ablegt und vergisst.
Gemeinsame Kennzahlen vereinbaren, bevor Sie alles verbinden
Drei Begriffe lösen die meisten Streitigkeiten aus: aktiver Kunde, Nettoumsatz und verfügbarer Bestand. Jedes der folgenden Systeme hat dafür bereits eine Definition. Keines hat die anderen gefragt.
Kennzahl | CRM | Finanzen | E-Commerce-Shop | Abgestimmte Regel |
|---|---|---|---|---|
Aktiver Kunde | Jeder Kontakt mit einem offenen Deal | Zahlende Kunden | Käufer der letzten 90 Tage | Ein Zeitfenster und eine maßgebliche Quelle, festgelegt vom Verantwortlichen der Kennzahl |
Nettoumsatz | Dealwert vor Erstattungen | Bruttoumsatz abzüglich Erstattungen und Rabatten | Bruttoumsatz | Erstattungen zählen zum Erstattungsdatum, Aktionsrabatte werden verrechnet |
Nehmen Sie den Nettoumsatz. Die Finanzabteilung zieht Erstattungen und Rabatte ab. Der Shop zählt den Bruttoumsatz. Das CRM führt oft den Dealwert vom Tag des Abschlusses, bevor irgendjemand etwas zurückgeschickt hat. Die erste Aktion öffnet eine Lücke, die wie ein Datenfehler aussieht und in Wahrheit zwei verschiedene Formeln sind.
Wer verantwortet die Definition, wenn niemand den Titel Data Steward trägt? Diese Frage ist wichtiger als ein weiterer Konnektor. Daten aus einer Umfrage unter Analytics Engineers, zitiert in einem NORC-Rahmenbericht, zeigen: Der Anteil der Befragten, die die Integration verschiedener Datenquellen als größte Herausforderung nennen, sank von 35 % im Jahr 2025 auf 27 % im Jahr 2026. Unklare Datenverantwortung blieb dagegen für 41 % der Befragten eine Herausforderung. Mangelhafte Datenqualität blieb das am häufigsten genannte Hindernis. Daten zu bewegen ist einfacher geworden. Sich auf sie zu einigen nicht.
Bessere Konnektoren liefern keine verlässlichen Analysen. Der Engpass verlagert sich von den Datenleitungen zu den Definitionen.
Eine Methode, die Sie diesen Monat umsetzen können
- Schreiben Sie pro Kennzahl eine Definition. Nennen Sie die Formel, was enthalten ist, was nicht, und den Zeitraum. „Nettoumsatz“ ohne Zeitraum ist keine Definition.
- Benennen Sie für jede Eingangsgröße eine maßgebliche Quelle. Erstattungen kommen vielleicht nur aus dem Hauptbuch. Bruttoumsätze vielleicht nur aus dem Shop. Halten Sie das in einem Satz fest.
- Benennen Sie für jede Änderung eine freigebende Person. Ein umbenannter Rabattcode sollte nicht im Board-Bericht landen, nur weil sich ein Marketing-Tool über Nacht aktualisiert hat.
- Leiten Sie ungeklärte Meinungsverschiedenheiten in die Quarantäne. Jede Ausnahme hat einen benannten Verantwortlichen. Bleibt sie in einem Chatverlauf liegen, veröffentlicht das Dashboard weiterhin beide Versionen.
Eine abgestimmte Regel für den Nettoumsatz kann so schlicht sein: Erstattungen zählen zum Erstattungsdatum. Rabattaktionen werden abgezogen. Alles, was übrig bleibt, wird zur Ausnahme mit Verantwortlichem, nicht zu einem stillen Ausgleichsbetrag.
KMU stellen selten einen Data Steward ein. Übertragen Sie die Verantwortung auf diejenige Person, die die Zahl am häufigsten nutzt. Die Betriebsleitung verantwortet den verfügbaren Bestand. Die Finanzleitung verantwortet den Umsatz. Ein kurzer monatlicher Abgleich klärt Streitfälle, bevor daraus zwei getrennte Dashboards werden.
Wenn zwei Personen zwei Formeln verteidigen können, haben Sie noch keine Kennzahl. Sie haben ein Meeting.
Qualitätsprüfungen und Abgleiche, die Ergebnisse absichern
Doppelte Schlüssel richten den leisesten Schaden an. Ein Kunde, der dreifach gespeichert ist, bläht die Zahl aktiver Käufer auf, drückt den durchschnittlichen Bestellwert und lässt Risiko- oder Bestandskennzahlen in die falsche Richtung ausschlagen. Beheben Sie die Eindeutigkeit, bevor Sie irgendetwas anderes feinjustieren.
Datenqualität ist der Engpass, der sich schon vor der Tool-Auswahl zeigt. Eine TDWI-Umfrage unter 672 Befragten ergab, dass Datenqualitätsprobleme das größte Hindernis für erfolgreiche Integrationsprojekte waren, und sie legte Teams nahe, Quellsysteme vor der Implementierung zu profilieren. In derselben Untersuchung stellte eine von IBM beauftragte Forrester-Studie unter 518 IT-, Daten- und Business-Entscheidern weltweit fest, dass 58 % Qualitätsprobleme als ihre größte Datenherausforderung nannten. Mehr als die Hälfte hatte zudem Schwierigkeiten bei der Integration für Machine-Learning- wie auch Business-Intelligence-Plattformen.
Verstehen Sie die folgenden Schwellenwerte als Ausgangspunkte. Passen Sie sie pro Quelle an, sobald Sie eine reale Woche an Daten gesehen haben.
Prüfung | Was sie erkennt | Beispiel-Schwellenwert | Maßnahme bei Fehlschlag |
|---|---|---|---|
Eindeutigkeit der Schlüssel | Doppelte Kunden- oder SKU-Kennungen | Keine Duplikate bei Primärschlüsseln | Veröffentlichung blockieren |
Vollständigkeit | Fehlende Werte in Schlüsselfeldern | Mindestens 98 % befüllt bei Umsatz und Datumsangaben | Datensätze in Quarantäne verschieben und Qualitätswert senken |
Aktualität | Veraltete oder ausgefallene Datenfeeds | Quelle innerhalb des vereinbarten Zeitfensters aktualisiert, z. B. 24 Stunden | Aktualitätswarnung anzeigen und Prognosen anhalten |
Referenzielle Integrität | Bestellungen, die auf unbekannte Produkte oder Kunden verweisen | Keine verwaisten Zeilen | In Quarantäne verschieben und Ausnahmefall eröffnen |
Abstimmung mit Kontrollsummen | Summen, die vom Quell-Hauptbuch oder Systembericht abweichen | Innerhalb von 0,5 % oder der vereinbarten Toleranz | Nachgelagerte Berichte blockieren |
Gültigkeit | Werte außerhalb des zulässigen Bereichs, etwa negative Bestände oder Rechnungsdaten in der Zukunft | Regeln pro Feld festgelegt | In Quarantäne verschieben und zur Prüfung protokollieren |
Was blockiert und was nur bewertet wird
Blockieren Sie die Veröffentlichung, wenn die Eindeutigkeit kritischer Schlüssel oder die Abstimmung mit Kontrollsummen fehlschlägt. Ein Dashboard mit doppelten Kunden oder einer Summe, die nicht zum Hauptbuch passt, ist schlimmer als gar kein Dashboard. Lassen Sie unkritische Felder mit Qualitätswert und Datenherkunft durch, damit eine fehlende Telefonnummer den Abschluss nicht aufhält.
Die Quarantäne ist ein Wartebereich, kein Papierkorb. Fehlerhafte Datensätze landen dort mit einem Fehlercode. Ein Prüfer gibt sie frei oder korrigiert sie. Survivorship-Regeln entscheiden, welche von zwei widersprüchlichen Adressen gilt; der unterlegene Wert bleibt sichtbar.
ELECTE zu Datenqualitätsprüfungen ist eine praxisnahe Ergänzung, wenn Sie die Überwachung als feste Routine statt als einmalige Bereinigung verankern möchten.
Erstellen Sie in Woche eins ein Profil jeder Quelle. Legen Sie drei kritische Regeln fest. Ergänzen Sie für jede wichtige Quelle eine tägliche Kontrollsumme. Versehen Sie jedes Dashboard mit einem Aktualitätshinweis, damit der Leser erkennt, was die Zahlen darstellen.
Ein Praxisbeispiel mit Vertrieb, Bestand und Aktionen
Die Zahlen in diesem Szenario sind illustrativ und kein Kundenergebnis. Angenommen, ein Online-Händler mit 40 Mitarbeitenden verkauft über eine E-Commerce-Plattform, führt den Lagerbestand in einer Tabelle und steuert Angebote in einem Marketing-Tool. Das Aktionsteam meldet einen Anstieg von 15 Prozent. Beworbene Artikel sind trotzdem drei Tage vor Kampagnenende ausverkauft. Der Anstieg und das leere Regal erzählen unterschiedliche Geschichten, weil die Quellen nie dafür gedacht waren, zusammenzuspielen.
Eine OECD-Umfrage unter mehr als 2.000 KMU in 12 Ländern ergab, dass 61 % mindestens eine KI-gestützte Anwendung nutzten, aber 56,6 % KI nur für einzelne, isolierte Aufgaben einsetzten. Nur 19 % wendeten sie funktionsübergreifend oder unternehmensweit an, und lediglich 3,6 % setzten agentische KI ein. Eine separate Umfrage unter kleinen Unternehmen aus dem Jahr 2026, die in diesem Forbes-Beitrag zitiert wird, nannte als größte Hürde bei der Einführung fehlendes Fachwissen mit 32,1 %, danach unklaren ROI mit 23,1 % und Integrationsschwierigkeiten mit 18,4 %. Die entscheidende Frage ist nicht, ob ein Tool Ihre Daten anbinden kann. Sondern: Welche zwei Quellen zahlen sich bei sorgfältiger Verknüpfung aus, bevor Sie eine dritte hinzunehmen?
Eine Unstimmigkeit, dann die Lösung
In Woche eins laden Sie nur Verkäufe und Lagerbestand, einmal täglich, mit einer SKU-Zuordnungstabelle. Fassen Sie Aktionen noch nicht an. In Woche zwei vergleichen Sie die verkauften Stückzahlen mit dem Warenausgang des Lagers. Stimmen beide überein, sind die Schlüssel verlässlich genug, um eine dritte Quelle hinzuzunehmen.
In Woche drei fügen Sie den Aktions-Feed hinzu. Die Unstimmigkeit zeigt sich sofort. Das Marketing-Tool erfasst Bundle-Codes. Der Onlineshop verkauft einzelne SKUs. Ein „Bundle-Lift“ zählt einen Aktionscode, als wäre er ein Produkt, sodass die Kampagne stärker aussieht als die Komponenten, die tatsächlich das Haus verlassen haben.
Drei Maßnahmen schließen die Lücke.
- Bundle-Zuordnungstabelle: Zerlegen Sie jedes Bundle in seine Komponenten-SKUs, bevor Sie den Lift messen.
- Aktualitätskennzeichen für den Bestand: Zeigen Sie an, ob die Tabelle heute oder vor drei Tagen eingegangen ist.
- Wöchentliche Kontrollsumme: Vergleichen Sie verkaufte Stückzahlen mit dem Warenausgang und halten Sie den Aktionsbericht zurück, wenn sie abweichen.
Verfolgen Sie Out-of-Stock-Tage pro beworbener SKU, den Prognosefehler bei beworbenen Artikeln, die Stunden für den Monatsbericht und die Tage bis zur Klärung von Ausnahmen. Diese vier Kennzahlen zeigen, dass der Workflow funktioniert. Ein schickeres Dashboard tut das nicht.
Ein Einkäufer genehmigt weiterhin Nachbestellungen ab einer festgelegten Menge. Bewahren Sie die vorherige Modellversion auf, damit eine Schemaänderung im Marketing-Tool zurückgerollt werden kann, statt unter Druck umgeschrieben zu werden. Verbinden Sie nur die Felder, die dieser Workflow braucht, und halten Sie Kunden-E-Mail-Adressen aus der gemeinsamen Aktionsansicht heraus.
Gestufte Verknüpfungen zahlen sich schneller aus, als alle Systeme auf einmal anzubinden, weil jede neue Quelle gegen eine Summe geprüft wird, der Sie bereits vertrauen. Weitere praktische Integrationstaktiken für KMU folgen demselben Muster: eine Entscheidung, zwei Quellen, eine Prüfung, die Sie erklären können.
Die wichtigsten Erkenntnisse und Ihr erster Workflow
Eine zusammengeführte Zahl kann präzise wirken und trotzdem falsch sein, wenn ihre Quellen unterschiedliche Definitionen verwenden oder zu verschiedenen Zeitpunkten aktualisiert werden. Beginnen Sie mit einer Entscheidung, die das Team treffen muss, und bauen Sie dann einen kleinen Workflow um eine Zahl, die bereits angezweifelt wird.
- Wählen Sie zwei Quellen, bei denen eine Abweichung Zeit kostet, etwa Verkäufe und Lagerbestand.
- Definieren Sie eine gemeinsame Kennzahl, indem Sie Formel, Einschlüsse und Zeitfenster festhalten.
- Legen Sie eine Qualitätsregel und eine Kontrollsumme fest. Halten Sie den Bericht zurück, wenn die Regel verletzt wird.
- Führen Sie den Workflow 30 Tage lang aus. Vergleichen Sie Out-of-Stock-Tage oder Berichtsstunden mit Ihrem Ausgangswert.
- Fügen Sie eine dritte Quelle hinzu, sobald der erste Workflow stabil läuft.
Verbinden Sie nur die Felder, die dieser Workflow braucht. Klären Sie vor dem Anbinden einer Quelle, wem die Daten gehören und wer darauf zugreifen darf. Maskieren Sie personenbezogene Kennungen wie Kunden-E-Mail-Adressen in gemeinsamen Berichten.
ELECTE kann einen ersten Workflow unterstützen: Verknüpfen Sie Konten und Datenquellen oder laden Sie eine Excel-Datei hoch, ohne Integrationsprojekt und ohne technische Einrichtung. Die meisten Nutzer sind in weniger als fünf Minuten einsatzbereit; KI-Analyse und erste Prognosen stehen nach der Anbindung der Buchhaltungssoftware oder dem Hochladen einer Datei bereit. Der sinnvolle nächste Schritt: Verbinden Sie Ihre eigenen Dateien und prüfen Sie eine Zahl, über die Sie ohnehin streiten.
Konnektoren führen Datensätze zusammen; sie klären nicht, was eine Kennzahl bedeutet, welche Quelle sie verantwortet oder ob die Summen abgestimmt sind. Einigen Sie sich zuerst auf diese Punkte und nutzen Sie dann Qualitätsprüfungen, um zu entscheiden, ob eine zusammengeführte Zahl für eine Nachbestellung, eine Prognose oder die Board-Unterlagen verlässlich genug ist.
ELECTE verbindet Buchhaltungs-, Bank- und Tabellendaten in einem zentralen Dashboard, das ohne Exporte aktuell bleibt, und schreibt die gesamte Bilanz in die Zukunft fort. Wählen Sie zum Einstieg zwei Quellen und eine Kennzahl, über die im Team Uneinigkeit herrscht.
Kommentare
Noch keine Kommentare — starten Sie die Diskussion.