Integrazione di dati da più fonti: guida pratica per le PMI
Scopri come funziona l'integrazione di dati da più fonti: scelta tra ETL ed ELT, mappatura dei campi e controlli di qualità. Guida pratica per le PMI con esempi.

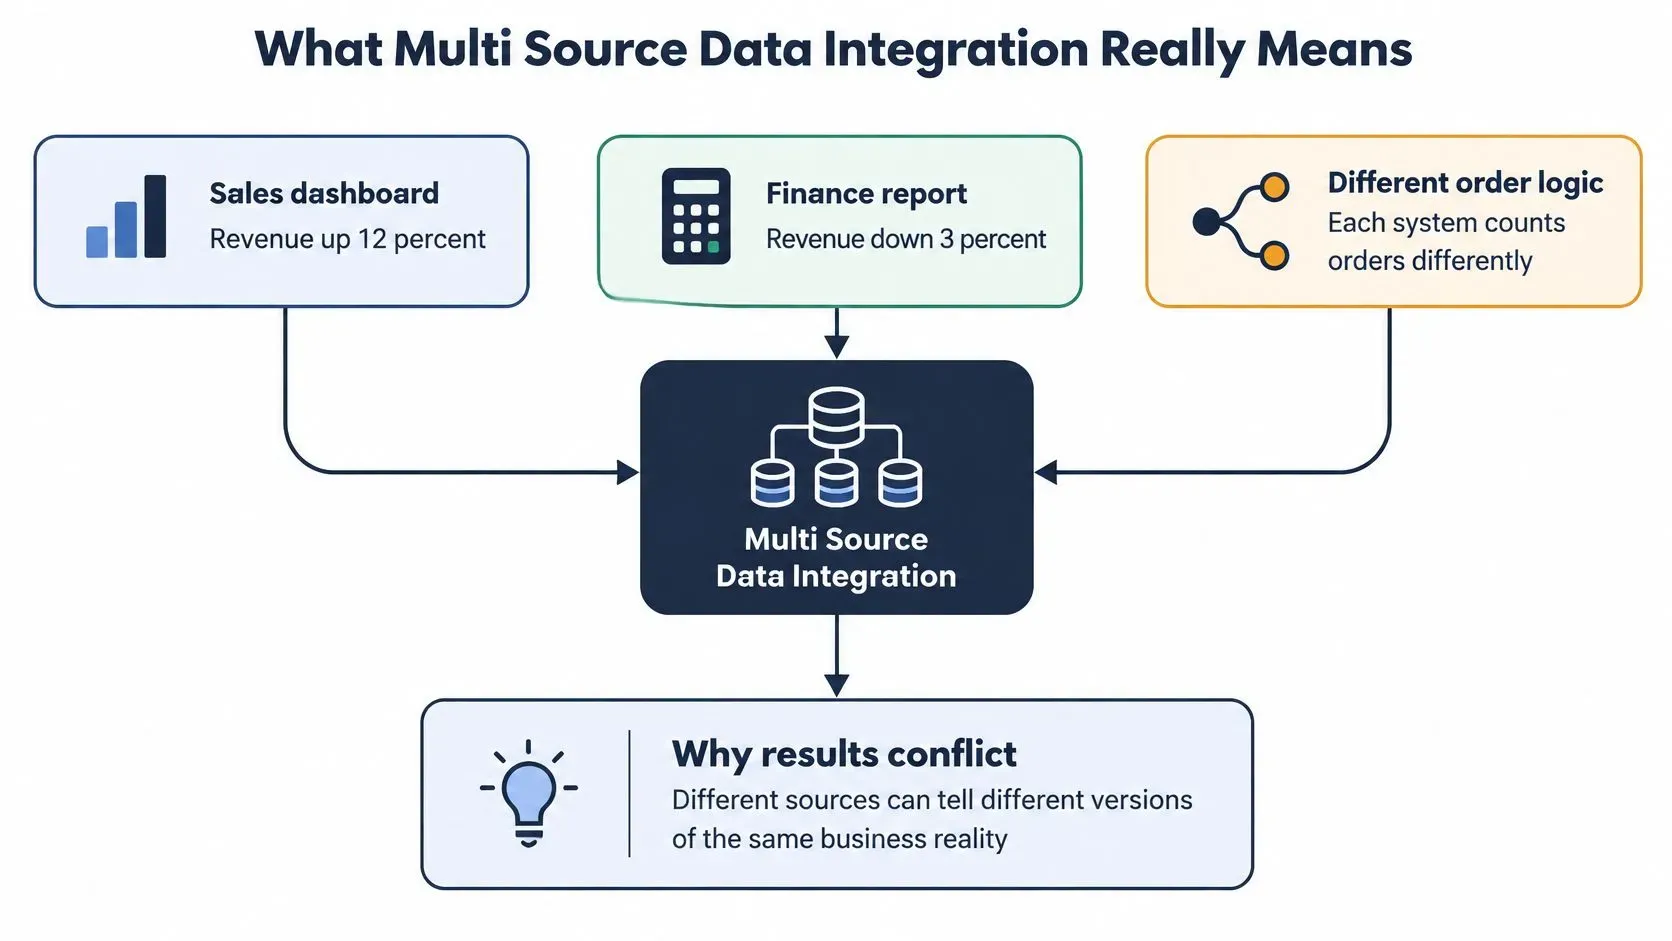
Apri la dashboard delle vendite e il fatturato è su del 12 percento. L'amministrazione, guardando la stessa settimana, mostra un calo del 3 percento. Nessuno ha toccato i conti durante la notte. Il negozio online ha contato ogni ordine effettuato. L'amministrazione ha contato gli incassi al netto di rimborsi e sconti. Entrambi i report sono coerenti al loro interno, ed entrambi sono la base sbagliata per un riordino se li tratti come lo stesso numero.
È proprio questo scontro che l'integrazione di dati da più fonti serve a risolvere. Si combinano i record di più sistemi, come ERP, CRM, piattaforma e-commerce, flussi bancari, API, database, stream di eventi e fogli di calcolo, in un unico modello analizzabile. Spostare le righe è la parte facile. Il lavoro vero è mettersi d'accordo su cosa significhino quelle righe.
Pensa a una cucina prima del servizio. Un fornitore manda la farina a sacchi, un altro il burro a panetti e un terzo invia via email un listino in casse. La ricetta funziona solo quando tutto è pesato con le stesse unità e preparato allo stesso modo. Con i dati succede lo stesso.
Il NIST Big Data Interoperability Framework lo considera qualcosa di più di un problema di trasferimento. I dataset differiscono per formato, scala, significato, qualità e tempistica, e tradurre dataset diversi e di grandi dimensioni tra domini e scale è una lacuna importante di interoperabilità. Il NIST avverte inoltre che l'affidabilità delle stime costruite su fonti "mescolate" va comunque valutata. I controlli incrociati tra fonti e una lettura onesta dell'incertezza fanno parte del lavoro, non di una nota a piè di pagina.
Valuta ogni scelta successiva alla luce di quattro disallineamenti.
- Formato: CSV contro JSON, codici contro nomi, date salvate come testo.
- Significato: lo stesso nome di campo, una regola di business diversa.
- Qualità: duplicati, campi vuoti e valori impossibili.
- Tempistica: un flusso di questa mattina, un altro di martedì scorso.
Esegui un audit in tre domande sulle fonti che hai già. Quale sistema contiene l'identificativo del cliente? Con quale frequenza si aggiorna ciascun flusso? Chi è responsabile di ciascun numero quando i sistemi non concordano?
Se in questo insieme ci sono autorizzazioni di carte e file di pagamento, la guida di Spell per i provider di pagamento white-label è un utile complemento. Le regole di orchestrazione stabiliscono quale processore, valuta e percorso di regolamento ha seguito un pagamento, e queste regole cambiano persino il significato di "fatturato".
I pattern qui sotto spostano i dati. La mappatura li allinea. Le definizioni condivise delle metriche danno loro significato. I controlli di qualità tengono i numeri sbagliati fuori dalle decisioni.
Confronto dei pattern di integrazione in sintesi
Per la maggior parte dei team delle PMI, conviene partire da un ELT pianificato. Si estraggono dati grezzi da API, database e file in un data warehouse cloud con cadenza giornaliera o oraria, poi li si trasforma lì. I report cambiano spesso, e conviene modificare un modello piuttosto che ricostruire una pipeline.
Abbozza i connettori prima di scegliere un pattern.
- Connettore CRM o contabilità: interroga a intervalli pianificati. Il primo giorno, controlla i limiti di frequenza delle API del fornitore, così che l'estrazione dell'intero storico non venga bloccata.
- Connettore database: legge il log delle modifiche. Il primo giorno, verifica i permessi di accesso al log, perché un utente di sola lettura per il reporting spesso non può vederlo.
- Connettore di controllo file: rileva gli export CSV o Excel depositati in una cartella. Il primo giorno, fissa la regola di denominazione dei file, così che "stock_final_v3" non sovrascriva senza lasciare traccia il file della settimana scorsa.
Modello | Ideale per | Latenza tipica | Compromesso principale |
|---|---|---|---|
ETL (trasformazione prima del caricamento) | Fonti strutturate che richiedono una pulizia intensa prima del reporting | Da ore a giornaliera | La logica di trasformazione resta fuori dal data warehouse ed è più lenta da modificare |
ELT (caricamento dei dati grezzi, trasformazione nel data warehouse) | Data warehouse cloud con molte fonti e report che cambiano di frequente | Da oraria a giornaliera | Le copie grezze richiedono spazio di archiviazione e governance |
Streaming con change data capture | Database operativi in cui ordini o scorte cambiano tutto il giorno | Da secondi a minuti | Configurazione più complessa e necessità di monitorare il carico sulla fonte |
Polling delle API | Strumenti SaaS come CRM, contabilità e piattaforme pubblicitarie | Da minuti a oraria | Limiti di frequenza del fornitore e modifiche allo schema |
Deposito programmato di file (CSV, Excel) | Esportazioni contabili, listini dei fornitori e sistemi legacy | Giornaliera o settimanale | Errori manuali e nessuno storico delle modifiche se i file non sono versionati |
Virtualizzazione (interrogazione diretta delle fonti) | Domande occasionali tra sistemi diversi, con volumi bassi | On demand | Query lente e dipendenza dalla disponibilità della fonte |
ETL pulisce i dati prima dell'archiviazione. Funziona meglio quando una fonte deve rispettare regole di formato rigide prima di poter essere interrogata, come un'esportazione bancaria che deve seguire un tracciato fisso. Il costo è la velocità di modifica: una nuova colonna richiede un rilascio fuori dal data warehouse.
ELT carica prima e trasforma dopo. Funziona meglio quando le domande cambiano di continuo, che è la condizione normale di un catalogo in crescita o di un piano dei conti in evoluzione. Il prezzo da pagare è lo spazio di archiviazione e la disciplina necessaria per etichettare le copie grezze, in modo che nessuno le usi per errore nei report.
Il change data capture trasmette in streaming inserimenti e aggiornamenti da un database operativo. Usalo quando scorte o ordini si muovono durante la giornata e un'ora persa significa una rottura di stock che avresti potuto vedere. Un batch notturno non intercetta una promozione che si esaurisce entro pranzo. In cambio serve un lavoro di configurazione e va tenuto sotto controllo il carico che si genera sulla fonte.
Il polling delle API chiede a uno strumento SaaS, a intervalli regolari, che cosa è cambiato. Si adatta a CRM, contabilità e piattaforme pubblicitarie che non danno accesso a un log del database. Rispetta i limiti di frequenza e metti in conto che un rilascio del fornitore possa rinominare un campo senza preavviso.
I depositi programmati di file trasportano ancora le esportazioni contabili, i listini dei fornitori e tutto ciò che è intrappolato in un sistema legacy. Versiona ogni file. Altrimenti non puoi sapere se il totale di martedì ha sostituito quello di lunedì o gli si è semplicemente affiancato.
La virtualizzazione lascia i dati dove sono e interroga più sistemi per una domanda occasionale. Non è la soluzione giusta per una dashboard che le persone aprono ogni mattina, perché una fonte lenta o offline diventa il fermo del vostro report.
Adattate la latenza alla decisione, non all'ambizione tecnica. Un report settimanale per il consiglio di amministrazione non richiede lo streaming.
Regola pratica: una PMI con tre fonti di solito si trova bene con il polling delle API per il CRM e il sistema contabile, più caricamenti pianificati di file per tutto ciò che arriva solo come foglio di calcolo, aggiornati ogni giorno in un data warehouse dove l'ELT si occupa di dare forma ai dati.
Come mappare i campi e costruire un modello canonico
Un connettore può consegnare ogni colonna e unire comunque i clienti sbagliati. La mappatura è il passaggio che lo impedisce.
Sei passaggi per mantenere un solo significato per campo
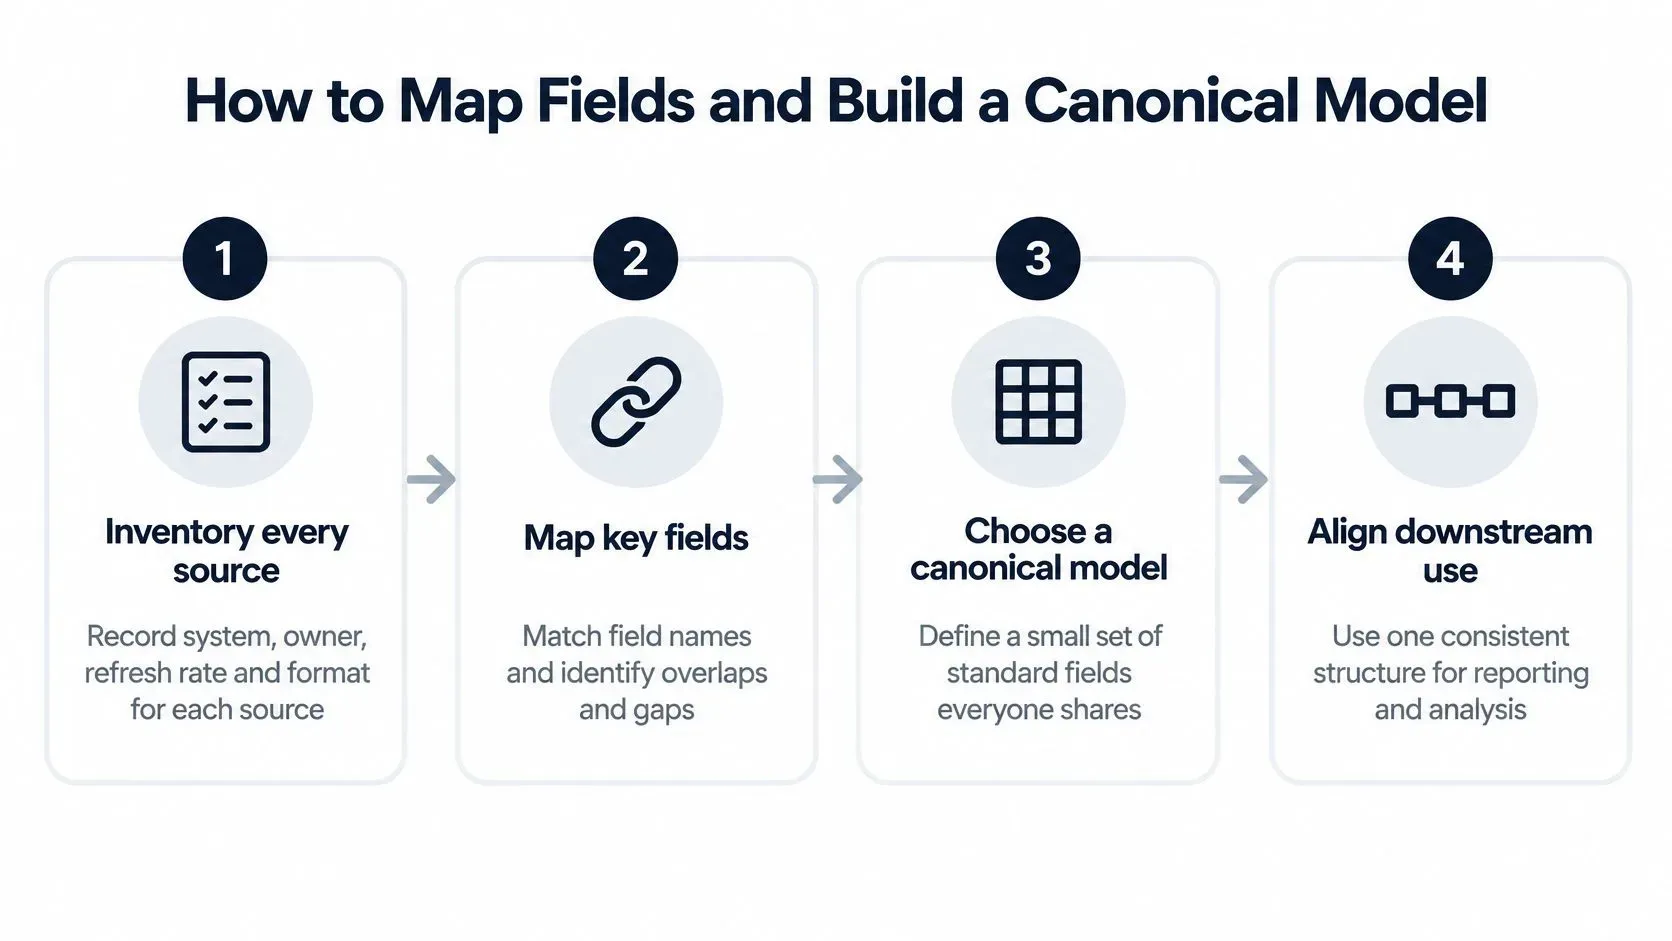
- Fate l'inventario di ogni fonte e dei suoi campi chiave. Annotate il sistema, il responsabile, la frequenza di aggiornamento e il formato. Non si può allineare ciò che non è stato elencato. L'errore più comune è saltare il foglio di calcolo "che qualcuno mantiene", spesso l'unico posto in cui compare il codice di un fornitore.
- Scegliete un modello canonico. Mantenete corto l'elenco delle entità: cliente, prodotto, ordine, sede e data. Date a ogni entità una sola chiave di business. Entità in più sembrano un segno di accuratezza, finché ogni nuova fonte richiede una nuova tabella e nessuno ricorda quale usi il reporting.
- Mappate ogni campo di origine su un campo canonico. Indicate la trasformazione nella stessa riga: conversione di valuta, cambio di unità di misura, allineamento dei fusi orari. Una semplice rinomina nasconde il calcolo. "Amount" dello storefront e "amount" del libro mastro non sono la stessa colonna finché non si precisa quale valuta e se l'imposta è inclusa nella cifra.
- Costruite una tabella di corrispondenza per gli identificativi. Associate l'ID account del CRM, il codice cliente della contabilità e l'email dello storefront a un'unica chiave cliente, e scrivete la regola usata per ogni associazione. L'email da sola è una chiave debole. Differenze tra maiuscole e minuscole e indirizzi con il segno più creano persone duplicate che sono lo stesso acquirente.
- Definite contratti di interfaccia. Indicate per ogni campo nome, tipo, valori ammessi e versione dello schema. In questo modo l'aggiornamento di un fornitore fa fallire un test invece di cambiare il significato di "status". I team lo saltano perché il primo caricamento funziona, poi un campo rinominato finisce nelle previsioni per settimane.
- Caricate un campione e verificatelo. Confrontate totali e join con il sistema di origine e correggete le discrepanze prima di caricare l'intero storico. Con lo storico completo un join errato è costoso da correggere. Cento righe mostrano una chiave prodotto mancante con la stessa chiarezza.
Fate attenzione a tre errori in particolare. I clienti duplicati compaiono quando gli indirizzi email differiscono solo per maiuscole e minuscole. Le date si spostano quando un sistema memorizza l'UTC e un altro l'ora locale senza fuso. Le unità divergono quando gli acquisti contano le casse e lo storefront vende pezzi singoli, così l'inventario sembra in salute mentre lo scaffale è vuoto.
Ogni campo canonico dovrebbe essere riconducibile a un campo di origine con nome e a una trasformazione con nome.
La stessa abitudine vale quando si tratta di definire il fatturato in modo coerente tra i reparti. Un modello condiviso è un elenco di decisioni, non un diagramma da archiviare e dimenticare.
Concordare le metriche condivise prima di collegare tutto
Tre etichette fanno nascere la maggior parte delle discussioni: cliente attivo, ricavi netti e inventario disponibile. Ogni sistema qui sotto ha già una propria definizione. Nessuno ha consultato gli altri.
Metrica | CRM | Finanza | Storefront e-commerce | Regola riconciliata |
|---|---|---|---|---|
Cliente attivo | Qualsiasi contatto con una trattativa aperta | Clienti paganti | Acquirenti degli ultimi 90 giorni | Una sola finestra temporale e una sola fonte di verità, stabilite dal responsabile della metrica |
Ricavi netti | Valore della trattativa prima dei rimborsi | Vendite lorde meno rimborsi e sconti | Vendite lorde | I rimborsi contano alla data del rimborso e gli sconti promozionali vengono detratti |
Prendiamo i ricavi netti. La finanza sottrae rimborsi e sconti. Lo storefront conta le vendite lorde. Il CRM conserva spesso il valore della trattativa dal giorno in cui l'opportunità è stata chiusa, prima che qualcuno restituisse alcunché. La prima promozione apre uno scarto che sembra un errore nei dati ed è in realtà il risultato di due formule diverse.
Chi è responsabile della definizione quando nessuno ha il titolo di data steward? Questa domanda conta più di un altro connettore. I dati di un sondaggio sull'analytics engineering, citati in un report del framework NORC, mostrano che la quota di intervistati che indica l'integrazione di diverse fonti di dati come una delle principali sfide è scesa dal 35% nel 2025 al 27% nel 2026, mentre la titolarità ambigua dei dati è rimasta una sfida per il 41% degli intervistati. La scarsa qualità dei dati è rimasta l'ostacolo segnalato più di frequente. Spostare i dati è diventato più facile. Metterli d'accordo no.
Connettori migliori non producono analisi affidabili. Il collo di bottiglia si sposta dalle pipeline alle definizioni.
Un metodo pratico da applicare questo mese
- Scrivi una sola definizione per ogni metrica. Includi la formula, cosa è incluso, cosa è escluso e la finestra temporale. "Ricavi netti" senza una finestra temporale non è una definizione.
- Indica una fonte di verità per ogni input. I rimborsi possono provenire solo dal libro mastro. Le vendite lorde possono provenire solo dal negozio online. Dillo in una frase.
- Indica un approvatore per ogni modifica. Un codice sconto rinominato non dovrebbe arrivare nel report per il consiglio di amministrazione perché uno strumento di marketing si è aggiornato durante la notte.
- Porta i disaccordi irrisolti in quarantena. Ogni eccezione ha un responsabile indicato per nome. Lasciarla in una chat significa che la dashboard continua a pubblicare entrambe le versioni.
Una regola di riconciliazione dei ricavi netti può essere molto netta. I rimborsi contano alla data del rimborso. Gli sconti promozionali vengono dedotti. Tutto ciò che resta diventa un'eccezione con un responsabile, non una cifra di compensazione nascosta.
Le PMI raramente assumono uno steward. Assegna la titolarità a chi usa di più quel numero. Il responsabile operativo possiede le scorte disponibili. Il responsabile finanziario possiede i ricavi. Una breve revisione mensile risolve le dispute prima che si consolidino in due dashboard.
Se due persone possono difendere due formule, non hai ancora una metrica. Hai una riunione.
Controlli di qualità e di riconciliazione che proteggono i risultati
Le chiavi duplicate fanno i danni più silenziosi. Un cliente registrato in tre modi gonfia gli acquirenti attivi, sottostima il valore medio dell'ordine e spinge le metriche di rischio o di magazzino nella direzione sbagliata. Risolvi l'unicità prima di mettere a punto qualsiasi altra cosa.
La qualità dei dati è il collo di bottiglia che emerge prima della scelta degli strumenti. Un sondaggio TDWI su 672 intervistati ha rilevato che i problemi di qualità dei dati sono il principale freno al successo dei progetti di integrazione, e ha spinto i team a profilare le fonti prima dell'implementazione. Nella stessa ricerca, uno studio Forrester commissionato da IBM su 518 decisori globali IT, dati e business ha rilevato che il 58% indicava i problemi di qualità come la sfida numero uno sui dati. Più della metà faticava inoltre con l'integrazione sia per le piattaforme di machine learning sia per quelle di business intelligence.
Considera le soglie qui sotto come punti di partenza. Calibrale per ogni fonte dopo aver visto una settimana reale di dati.
Controllo | Cosa intercetta | Soglia di esempio | Azione in caso di errore |
|---|---|---|---|
Unicità delle chiavi | Identificativi duplicati di clienti o SKU | Zero duplicati sulle chiavi primarie | Bloccare la pubblicazione |
Completezza | Valori mancanti nei campi chiave | 98% o più di campi compilati per ricavi e date | Mettere in quarantena i record e abbassare il punteggio di qualità |
Tempestività | Flussi obsoleti o interrotti | Fonte aggiornata entro la finestra concordata, ad esempio 24 ore | Mostrare un avviso di aggiornamento e sospendere le previsioni |
Integrità referenziale | Ordini che puntano a prodotti o clienti sconosciuti | Zero righe orfane | Mettere in quarantena e aprire un'eccezione |
Riconciliazione con i totali di controllo | Totali che differiscono dal libro contabile o dal report del sistema di origine | Entro lo 0,5% o la tolleranza concordata | Bloccare i report a valle |
Validità | Valori fuori intervallo, come giacenze negative o date di fattura nel futuro | Regole definite per ogni campo | Mettere in quarantena e registrare per la revisione |
Cosa blocca e cosa assegna solo un punteggio
Blocca la pubblicazione quando fallisce l'unicità delle chiavi critiche o la riconciliazione con i totali di controllo. Una dashboard con clienti duplicati o con un totale che non torna con il libro contabile è peggio di nessuna dashboard. Lascia passare i campi non critici con un punteggio di qualità e la provenienza associata, così un numero di telefono mancante non blocca la chiusura.
La quarantena è un'area di attesa, non una cartella di eliminazione. I record che falliscono vi finiscono con un codice motivo. Un revisore li rilascia o li corregge. Le regole di sopravvivenza decidono quale tra due indirizzi in conflitto prevale, e il valore scartato resta visibile.
ELECTE sui controlli di qualità dei dati è un utile approfondimento se vuoi trasformare il monitoraggio in una routine, anziché in una pulizia una tantum.
Analizza il profilo di ogni fonte nella prima settimana. Definisci tre regole critiche. Aggiungi un totale di controllo giornaliero per ogni fonte principale. Inserisci un'etichetta di aggiornamento su ogni dashboard, così chi legge vede cosa rappresentano i numeri.
Un esempio pratico che combina vendite, magazzino e promozioni
Le cifre di questo scenario sono illustrative, non il risultato di un cliente. Immagina un rivenditore online di 40 persone che vende tramite una piattaforma e-commerce, tiene traccia delle scorte di magazzino in un foglio di calcolo e gestisce le offerte in uno strumento di marketing. Il team promozioni riporta un incremento del 15 percento. Le linee in promozione continuano però a esaurirsi tre giorni prima della fine della campagna. L'incremento e lo scaffale vuoto raccontano storie diverse perché le fonti non sono mai state pensate per incontrarsi.
Un sondaggio OCSE su oltre 2.000 PMI in 12 paesi ha rilevato che il 61% utilizzava almeno un'applicazione basata sull'IA, ma il 56,6% la usava solo per attività isolate. Solo il 19% l'applicava a più funzioni o all'intera azienda, e appena il 3,6% aveva adottato l'IA agentica. Un altro sondaggio del 2026 sulle piccole imprese, citato nello stesso articolo di Forbes, indicava al primo posto tra le barriere all'adozione la mancanza di competenze (32,1%), seguita dal ritorno sull'investimento poco chiaro (23,1%) e dalle difficoltà di integrazione (18,4%). La domanda utile non è se uno strumento riesca a collegare i vostri dati. È quali due fonti, unite con cura, si ripagano prima di aggiungerne una terza.
Un disallineamento, poi la soluzione
Prima settimana: caricate solo vendite e giacenze, una volta al giorno, con una tabella di corrispondenza degli SKU. Non toccate ancora le promozioni. Seconda settimana: confrontate le unità vendute con le uscite di magazzino. Se i due dati coincidono, le chiavi sono abbastanza affidabili da far entrare una terza fonte.
Terza settimana: aggiungete il feed delle promozioni. Il disallineamento emerge subito. Lo strumento di marketing registra codici bundle. Il negozio online vende singoli SKU. Un "incremento da bundle" conta un codice promozionale come se fosse un solo prodotto, quindi la campagna sembra più forte dei componenti effettivamente usciti dal magazzino.
Tre correzioni colmano il divario.
- Tabella di mappatura dei bundle: suddividete ogni bundle negli SKU componenti prima di misurare l'incremento.
- Indicatore di aggiornamento delle giacenze: mostrate se il foglio di calcolo è arrivato oggi o tre giorni fa.
- Totale di controllo settimanale: confrontate le unità vendute con le uscite di magazzino e bloccate il report promozioni se divergono.
Monitorate i giorni di rottura di stock per SKU in promozione, l'errore di previsione sulle linee promosse, le ore impiegate per il report mensile e i giorni necessari per risolvere le eccezioni. Questi quattro indicatori vi dicono che il flusso di lavoro funziona. Una dashboard più bella no.
Un buyer continua ad approvare i riordini oltre una certa quantità. Conservate la versione precedente del modello, così una modifica di schema nello strumento di marketing può essere annullata invece di essere riscritta sotto pressione. Collegate solo i campi necessari a questo flusso di lavoro e tenete le email dei clienti fuori dalla vista promozioni condivisa.
I collegamenti a tappe si ripagano più in fretta rispetto al collegare tutti i sistemi in una volta, perché ogni nuova fonte viene confrontata con un totale di cui vi fidate già. Altre tattiche pratiche di integrazione per le PMI seguono lo stesso schema: una decisione, due fonti, un controllo che sapete spiegare.
Punti chiave e il vostro primo flusso di lavoro
Un dato combinato può sembrare preciso ed essere comunque sbagliato se le fonti usano definizioni diverse o si aggiornano in momenti diversi. Partite da una decisione che il team deve prendere, poi costruite un piccolo flusso di lavoro attorno a un numero che le persone già mettono in dubbio.
- Scegliete due fonti il cui disaccordo costa tempo, come vendite e giacenze.
- Definite una metrica condivisa registrandone formula, voci incluse e finestra temporale.
- Fissate una regola di qualità e un totale di controllo. Se la regola non è rispettata, bloccate il report.
- Eseguite il flusso di lavoro per 30 giorni. Confrontate i giorni di rottura di stock o le ore di reporting con il vostro punto di partenza.
- Aggiungete una terza fonte quando il primo flusso di lavoro è stabile.
Collegate solo i campi che servono a quel flusso di lavoro. Prima di collegare una fonte, verificate chi è il titolare dei dati e chi può accedervi. Mascherate gli identificativi personali, come le email dei clienti, nei report condivisi.
ELECTE può supportare un flusso di lavoro iniziale: collegate account e fonti di dati oppure caricate un file Excel, senza progetto di integrazione né configurazione tecnica. La maggior parte degli utenti è operativa in meno di cinque minuti, con analisi IA e prime previsioni disponibili dopo aver collegato il software di contabilità o caricato un file. Il passo successivo sensato è collegare i vostri file e verificare un dato su cui già discutete.
I connettori riuniscono i record; non stabiliscono che cosa significhi una metrica, quale fonte ne sia titolare o se i totali quadrino. Concordate prima queste decisioni, poi usate i controlli di qualità per stabilire se un numero combinato è sicuro per un riordino, una previsione o un documento per il consiglio di amministrazione.
ELECTE collega dati di contabilità, banca e fogli di calcolo in una dashboard centrale che resta aggiornata senza esportazioni, con lo stato patrimoniale completo proiettato nel futuro. Per iniziare, scegliete due fonti e una metrica che il team contesta.
Commenti
Ancora nessun commento — inizia tu la conversazione.