マルチソースデータ統合の実践ガイド:中小企業向け
マルチソースデータ統合の仕組みを解説。ETLとELTの選び方、フィールドマッピング、品質チェックまで、事例を交えた中小企業向けの実践ガイドです。

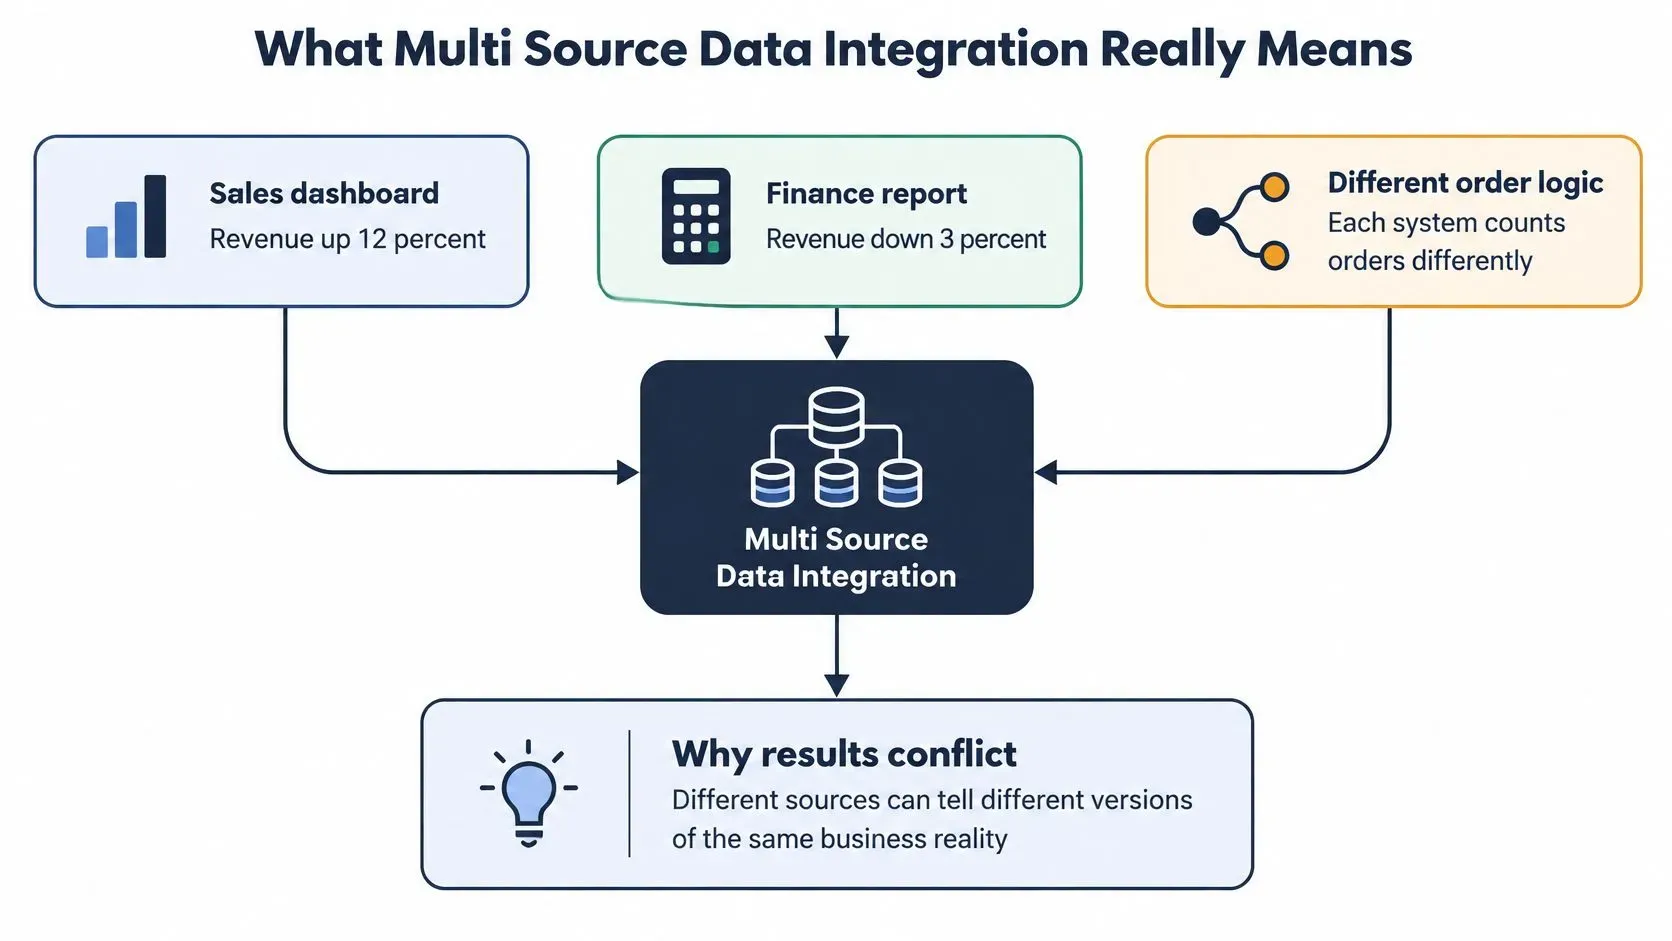
営業ダッシュボードを開くと、売上は12%増。ところが同じ週の経理の数字は3%減です。一夜のうちに帳簿が書き換えられたわけではありません。ストアフロントは受注したすべての注文を数え、経理は返金と値引きを差し引いた後の入金額を数えています。どちらのレポートもそれ自体は整合していますが、同じ数字として扱って発注判断の基準にすれば、どちらも誤った根拠になります。
こうした食い違いを解消するのが、マルチソースデータ統合です。ERP、CRM、ECプラットフォーム、銀行のフィード、API、データベース、イベントストリーム、スプレッドシートなど、複数のシステムにある記録を、分析できるひとつのモデルにまとめます。行を移動させるのは簡単な部分です。その行が何を意味するのかをそろえることが、本当の作業です。
営業前の厨房を思い浮かべてください。ある仕入先は小麦粉を袋単位で、別の仕入先はバターをブロック単位で届け、3社目はケース単位の価格表をメールで送ってきます。すべてを同じ単位で計量し、同じように下ごしらえして、初めてレシピが成り立ちます。データもまったく同じです。
NIST Big Data Interoperability Frameworkは、これを単なる転送の問題以上のものとして扱っています。データセットは形式、規模、意味、品質、タイミングが異なり、多様で大規模なデータセットを領域や規模をまたいで変換することは、相互運用性における大きな課題とされています。NISTはまた、「寄せ集め」のソースから作った推計の信頼性は、やはり評価する必要があると警告しています。ソース間のクロスチェックと、不確実性の率直な見極めは、注釈ではなく作業そのものに含めるべきものです。
以降の判断はすべて、次の4つの不一致に照らして考えてください。
- 形式:CSVとJSON、コードと名称、文字列で保存された日付。
- 意味:フィールド名は同じでも、業務ルールが異なる。
- 品質:重複、空白、あり得ない値。
- タイミング:今朝のフィードと、先週火曜日のフィード。
すでにお持ちのソースに対して、3つの質問で監査してみましょう。顧客識別子を持っているのはどのシステムか。各フィードはどれくらいの頻度で更新されるか。システム間で数字が食い違った場合、各数字の責任者は誰か。
カードのオーソリゼーションや入金ファイルがその中に含まれる場合は、Spellのホワイトラベル決済事業者向けガイドが役立ちます。オーケストレーションのルールによって、決済がどのプロセッサ、通貨、精算経路を通ったかが決まり、そのルールが「売上」の定義そのものを左右します。
以下のパターンはデータを移動させます。マッピングはデータをそろえます。共通の指標定義はデータに意味を与えます。品質ゲートは、誤った数字が意思決定に入り込むのを防ぎます。
統合パターンの比較一覧
多くの中小企業のチームには、まずスケジュール実行のELTをおすすめします。API、データベース、ファイルの生データを日次または時間単位のスケジュールでクラウドウェアハウスに取り込み、その中で変換します。レポートは頻繁に変わるため、パイプラインを作り直すよりモデルを編集するほうが現実的です。
パターンを選ぶ前に、コネクタの構成を描いてみましょう。
- CRM・会計コネクタ: スケジュールに沿ってポーリングします。初日にベンダーのAPIレート制限を確認し、全履歴の取得がスロットリングされないようにしてください。
- データベースコネクタ: 変更ログを読み取ります。初日にログへのアクセス権限を確認してください。読み取り専用のレポート用ユーザーでは、ログを参照できないことがよくあります。
- ファイル監視コネクタ: 配置されたCSVやExcelのエクスポートファイルを取り込みます。初日にファイル命名ルールを固定し、「stock_final_v3」が先週のファイルを痕跡なく上書きしないようにしてください。
パターン | 適したケース | 一般的なレイテンシ | 主なトレードオフ |
|---|---|---|---|
ETL(ロード前に変換) | レポート作成前に大規模なクレンジングが必要な構造化データソース | 数時間~日次 | 変換ロジックがウェアハウスの外にあり、変更に時間がかかる |
ELT(生データをロードし、ウェアハウス内で変換) | ソースが多く、レポートが頻繁に変わるクラウドウェアハウス | 1時間ごと~日次 | 生データのコピーに保存領域とガバナンスが必要 |
変更データキャプチャ(CDC)によるストリーミング | 受注や在庫が一日中変動する基幹データベース | 数秒~数分 | 設定が複雑になり、ソースへの負荷の監視も必要 |
APIポーリング | CRM、会計、広告プラットフォームなどのSaaSツール | 数分~1時間ごと | ベンダーのレート制限とスキーマ変更 |
ファイルの定期配置(CSV、Excel) | 経理のエクスポート、仕入先の価格表、レガシーシステム | 日次または週次 | 手作業によるミスが起こりやすく、ファイルをバージョン管理しない限り変更履歴が残らない |
仮想化(ソースをその場でクエリ) | データ量が少なく、システムをまたぐ問い合わせがたまに発生する場合 | オンデマンド | クエリが遅く、ソースの稼働状況に左右される |
ETLは、保存する前にデータをクリーニングします。クエリを実行する前に、ソースが厳格なフォーマット規則を満たしている必要がある場合に有効です。たとえば、決められたレイアウトに合格しなければならない銀行のエクスポートがこれにあたります。代償は変更のスピードです。列を1つ追加するだけでも、ウェアハウスの外でリリース作業が必要になります。
ELTは、先にロードして後から変換します。商品カタログが拡大したり勘定科目表が変わったりと、問いが次々に変わっていく状況では、この方式が有効です。その代わり、ストレージのコストがかかります。また、誤って元データからレポートが作られないよう、未加工のコピーにラベルを付けて管理する規律も必要です。
変更データキャプチャは、業務データベースへの挿入や更新をストリームとして取り込みます。在庫や注文が日中に動き、1時間の見逃しが、本来なら防げた欠品につながる場合に使います。夜間バッチでは、昼までに売り切れてしまうプロモーションを捉えられません。導入にはセットアップ作業が必要で、ソースにかかる負荷も監視しなければなりません。
API ポーリングは、SaaSツールに対して、何が変わったかをタイマーで定期的に問い合わせる方式です。データベースログを提供しないCRM、会計、広告プラットフォームに適しています。レート制限を守ってください。また、ベンダーのリリースによって、予告なくフィールド名が変更されることも想定しておきましょう。
スケジュール実行のファイル受け渡しは、いまも経理のエクスポート、仕入先の価格表、レガシーシステムに閉じ込められたデータの受け渡しを担っています。ファイルは必ずバージョン管理してください。そうしないと、火曜日の合計が月曜日の合計を置き換えたのか、単に並んで存在しているだけなのか、判別できなくなります。
仮想化は、データをその場所に置いたまま、システムをまたいでクエリを実行します。単発の問いに向いた方式です。毎朝開くダッシュボードの基盤には向きません。ソースが遅い、あるいはオフラインになると、そのままレポートの停止につながるためです。
レイテンシは、技術的な野心ではなく、意思決定に合わせて選びましょう。週次の取締役会向け資料に、ストリーミングは必要ありません。
実践のルール: ソースが3つ程度の中小企業なら、CRMと会計システムにはAPIポーリングを使い、スプレッドシートでしか届かないものにはスケジュール実行のファイル受け渡しを使う構成でたいていうまくいきます。データは毎日ウェアハウスに更新し、整形はELTで行います。
フィールドをマッピングして標準モデルを構築する方法
コネクタがすべての列を届けても、顧客を誤って結合してしまうことがあります。マッピングは、それを防ぐためのステップです。
1つのフィールドに1つの意味を持たせる6つのステップ
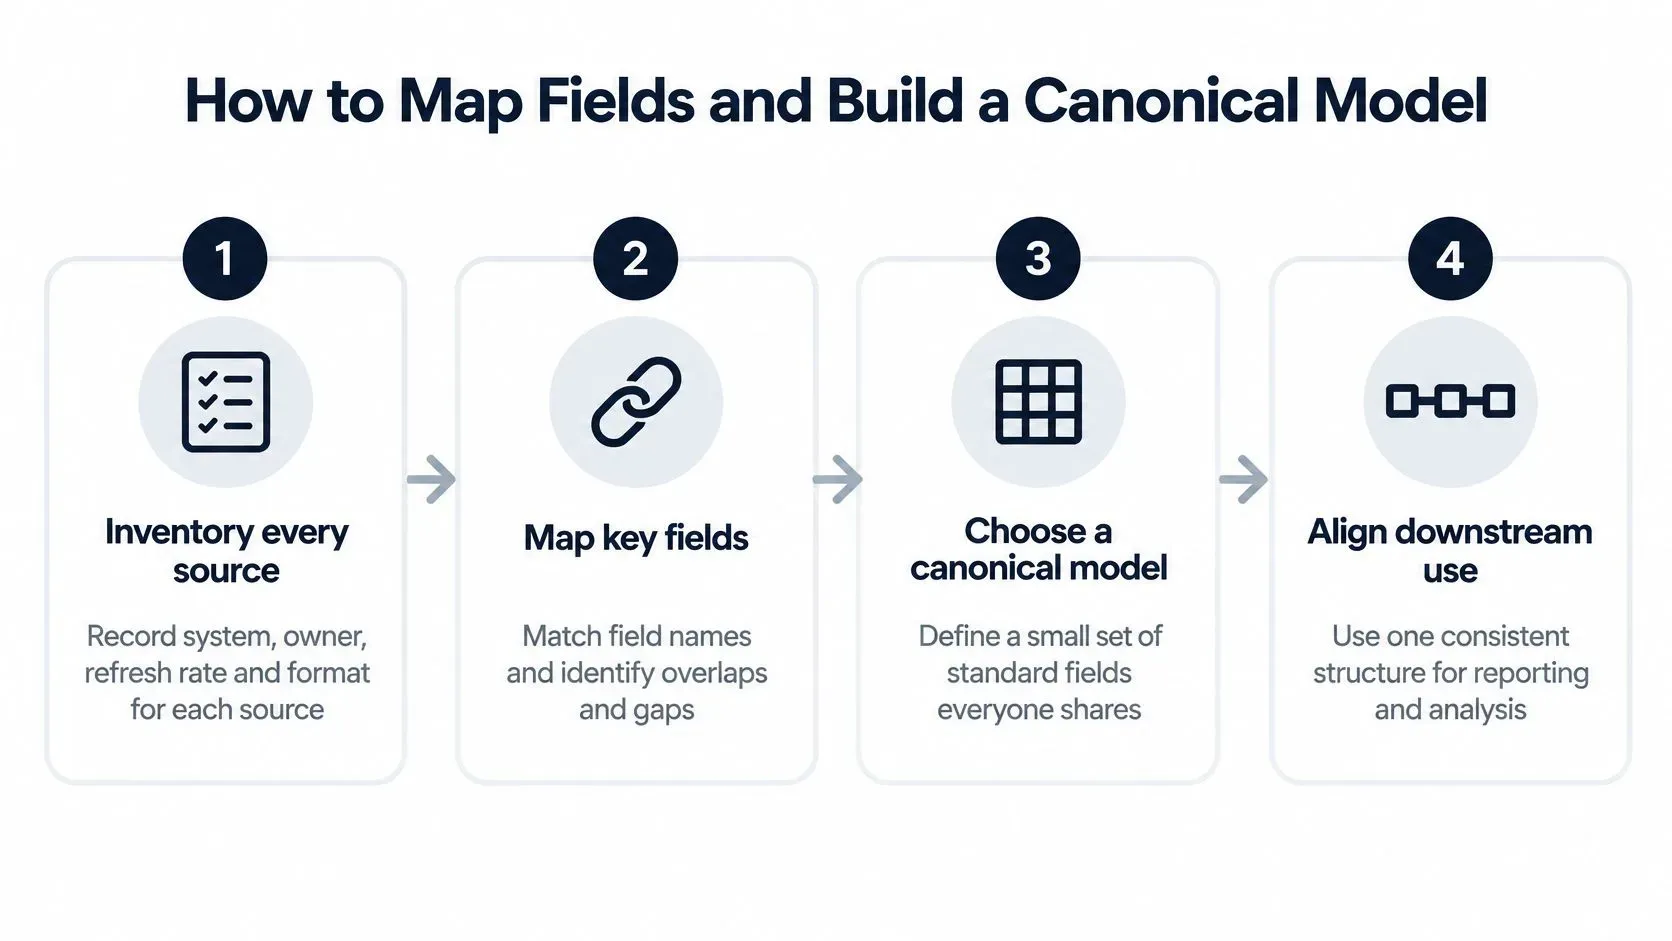
- すべてのソースと主要フィールドを棚卸しする。システム、担当者、更新頻度、形式を記録します。一覧にないものは揃えられません。よくある見落としは、「誰かが管理している」スプレッドシートを飛ばしてしまうことです。仕入先コードがそこにしかない場合が少なくありません。
- 標準モデルを決める。エンティティは顧客、商品、注文、拠点、日付に絞ります。各エンティティにビジネスキーを1つ持たせます。エンティティを増やすと網羅的に見えますが、新しいソースのたびにテーブルが増え、レポートがどれを使っているのか誰も分からなくなります。
- 各ソースのフィールドを標準フィールドに対応付ける。変換内容も同じ行に書きます。通貨換算、単位変更、タイムゾーンの調整などです。名前を置き換えるだけでは計算が見えなくなります。ストアフロントの「Amount」と元帳の「amount」は、通貨と税込かどうかを明示するまで同じ列ではありません。
- 識別子のクロスウォークを作る。CRMのアカウントID、会計システムの顧客コード、ストアフロントのメールアドレスを1つの顧客キーに対応付け、各対応付けに使ったルールを書き残します。メールアドレスだけでは弱いキーです。大文字小文字の違いやプラスアドレスのせいで、1人の購入者が重複して登録されます。
- インターフェース契約を定める。各フィールドの名前、型、許容値、スキーマのバージョンを明記します。そうすれば、ベンダーの更新で「status」の意味が変わる代わりに、テストが失敗します。最初のロードが成功するからと省略すると、名称変更されたフィールドが何週間も予測に流れ込みます。
- サンプルをロードして検証する。合計値と結合結果をソースシステムと比較し、不一致は全履歴をロードする前に修正します。全履歴をロードしてからでは、誤った結合の巻き戻しに手間がかかります。商品キーの欠落は、100行あれば十分に確認できます。
特に注意したい見落としが3つあります。メールアドレスが大文字小文字だけ異なると、顧客が重複します。一方のシステムがUTCで、もう一方がタイムゾーンなしの現地時間で保存していると、日付がずれます。購買部門がケース単位で数え、ストアフロントがバラで販売していると単位が食い違い、棚は空なのに在庫は十分に見えます。
標準フィールドはすべて、名前のあるソースフィールドと名前のある変換に遡れるようにしてください。
同じ習慣は、部門をまたいで売上を一貫して定義するときにも役立ちます。共有モデルとは決定事項の一覧であり、一度描いてしまい込む図ではありません。
すべてをつなぐ前に共通指標を合意する
議論のきっかけになりやすい用語は3つあります。アクティブ顧客、純売上、利用可能在庫です。下記のシステムにはどれも、すでに独自の定義があります。他のシステムに確認した定義は1つもありません。
指標 | CRM | 財務 | ECストアフロント | 統一ルール |
|---|---|---|---|---|
アクティブ顧客 | 進行中の案件を持つすべてのコンタクト | 支払いのある顧客 | 過去90日以内の購入者 | 指標のオーナーが定める、単一の集計期間と単一の信頼できる情報源 |
純売上 | 返金前の案件金額 | 総売上から返金と値引きを差し引いた額 | 総売上 | 返金は返金日に計上し、プロモーション値引きは差し引く |
純売上を例にとります。財務部門は返金と値引きを差し引きます。ストアフロントは総売上を数えます。CRMには、商談が成立した日の案件金額が、返品が発生する前のまま残っていることがよくあります。最初のプロモーションで生じる差異は、データのバグに見えますが、実際には2つの計算式の違いです。
データスチュワードという肩書きの担当者がいない場合、指標の定義は誰が管理するのでしょうか。この問いは、コネクタを1つ増やすことよりも重要です。NORCのフレームワークレポートで引用されているアナリティクスエンジニアリング調査のデータによると、「多様なデータソースの統合」を最大の課題の1つに挙げた回答者の割合は、2025年の35%から2026年は27%に低下しました。一方、データの所有者が曖昧であることを課題とした回答者は41%のままでした。データ品質の低さは、引き続き最も多く挙げられた障害です。データの移動は容易になりましたが、その内容について合意することは容易になっていません。
コネクタが改善されても、信頼できる分析が得られるわけではありません。ボトルネックはパイプラインから定義へと移っています。
今月から実行できる実践的な方法
- 指標ごとに定義を1つ書く。計算式、含めるもの、除外するもの、対象期間を明記します。期間のない「純売上」は定義とは言えません。
- 入力ごとに信頼できる情報源を決める。たとえば、返金は元帳のみ、総売上はストアフロントのみとします。これを1文で明記してください。
- 変更ごとに承認者を決める。マーケティングツールが夜間に更新されたせいで、名称変更された割引コードが取締役会資料にそのまま反映されるようなことがあってはなりません。
- 解決していない相違は隔離に回す。各例外には担当者を明記します。チャットのスレッドに放置すると、ダッシュボードは両方のバージョンを公開し続けます。
調整済みの純売上ルールは、これくらい単純で構いません。返金は返金日に計上します。販促割引は差し引きます。それでも残った差異は、黙って埋める調整値にせず、担当者付きの例外として扱います。
中小企業がスチュワードを採用することはまずありません。その数字を最もよく使う人に所有権を割り当ててください。利用可能在庫は業務マネージャー、売上は財務責任者が管理します。短い月次レビューを行えば、意見の対立が2つのダッシュボードとして固定化する前に解消できます。
2人がそれぞれ別の計算式を主張できるなら、それはまだ指標ではありません。ただの会議の議題です。
結果を守る品質ゲートと突合チェック
重複キーは、最も気づきにくい被害をもたらします。1人の顧客が3通りで保存されていると、アクティブな購入者数は水増しされ、平均注文額は過小評価され、リスクや在庫の指標は誤った方向に振れます。他の調整をする前に、一意性を修正してください。
ツール選定よりも前に表面化するボトルネックが、データ品質です。672人の回答者によるTDWIの調査では、データ品質の問題が統合プロジェクト成功の最大の阻害要因として報告され、導入前にソースストアをプロファイリングするようチームに促していました。同じ調査内で、IBMが委託したForresterによる、世界のIT・データ・ビジネスの意思決定者518人への調査では、58%が品質の問題を最大のデータ課題に挙げました。また、半数以上が、機械学習とビジネスインテリジェンスの両プラットフォームで統合にも苦労していました。
以下のしきい値は出発点として扱ってください。実際のデータを1週間分確認したら、ソースごとに調整します。
チェック項目 | 検出できる問題 | しきい値の例 | 不合格時の対応 |
|---|---|---|---|
キーの一意性 | 顧客IDやSKUの重複 | 主キーの重複ゼロ | 公開をブロック |
完全性 | 主要フィールドの欠損値 | 売上と日付の入力率98%以上 | レコードを隔離し、品質スコアを下げる |
適時性 | 古くなったデータや停止したフィード | ソースが合意した期間内(例:24時間以内)に更新されていること | 鮮度の警告を表示し、予測を保留 |
参照整合性 | 存在しない商品や顧客を参照する注文 | 孤立行ゼロ | 隔離し、例外対応を起票 |
統制合計との突合 | 元帳やシステムレポートと一致しない合計値 | 0.5%以内、または合意した許容範囲内 | 下流のレポートをブロック |
妥当性 | マイナスの在庫や未来の請求日など、範囲外の値 | フィールドごとにルールを設定 | 隔離し、レビュー用に記録 |
公開を止めるチェックと、スコア付けだけにするチェック
重要キーの一意性が崩れた場合、またはコントロールトータルとの突合に失敗した場合は、公開を止めます。顧客が二重にカウントされたダッシュボードや、総勘定元帳と合わない合計値は、ダッシュボードがないよりも悪い結果を招きます。重要度の低い項目は、品質スコアとリネージ(データの来歴)を付けたうえで通します。電話番号が欠けているだけで月次決算が止まる、という事態を避けるためです。
隔離は保留場所であり、削除用のフォルダではありません。チェックに失敗したレコードは、理由コードを付けて隔離先に置かれます。レビュー担当者が、それらを解放するか修正します。2つの住所が食い違う場合にどちらを採用するかは、サバイバーシップルールで決めます。採用されなかった値も、確認できる状態で残ります。
ELECTEのデータ品質チェックに関する記事は、一度きりのクレンジングではなく、モニタリングを日々の定型業務として定着させたい場合に役立ちます。
最初の週に、各ソースをプロファイリングします。重要ルールを3つ設定します。主要なソースごとに、日次のコントロールトータルを追加します。あわせて、すべてのダッシュボードに鮮度ラベルを付け、数値が何を表しているのかを閲覧者が確認できるようにします。
売上・在庫・プロモーションを組み合わせた実例
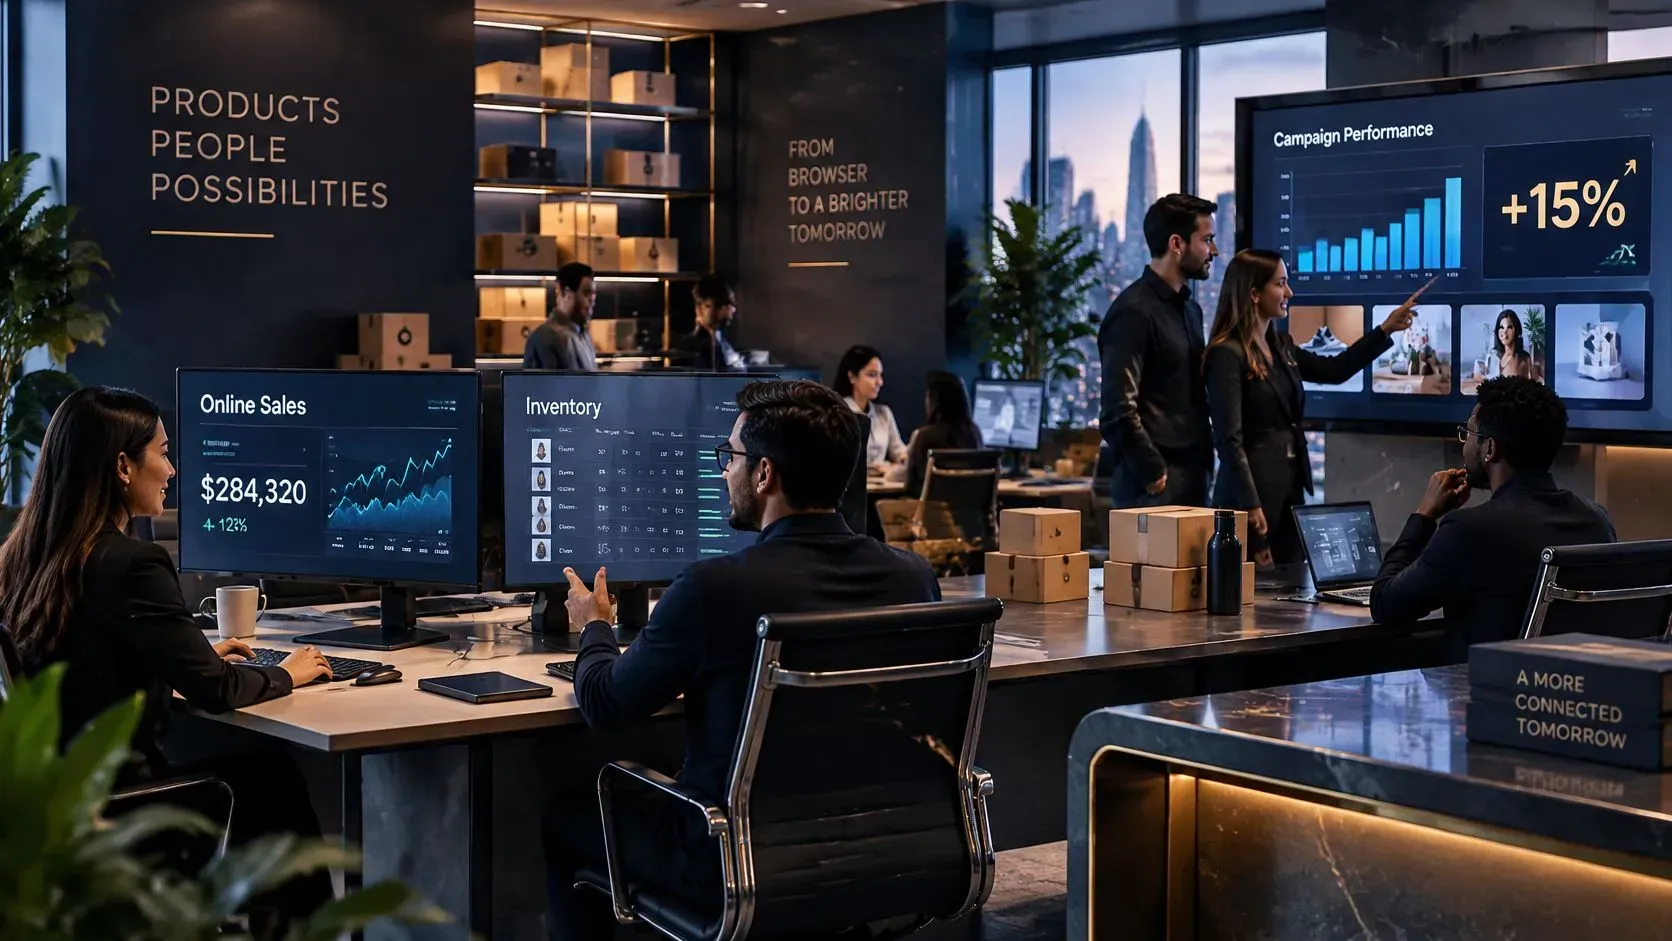
このシーンの数値は説明用の例であり、お客様の実績ではありません。従業員40名のオンライン小売業者を想定します。販売はECプラットフォーム、倉庫の在庫管理はスプレッドシート、販促はマーケティングツールで行っています。プロモーション担当は15%の押し上げ効果を報告しています。ところが、販促対象の商品はキャンペーン終了の3日前に在庫切れになります。押し上げ効果と空の棚が食い違うのは、各ソースがもともと突き合わせることを想定していなかったためです。
12か国・2,000社超の中小企業を対象としたOECDの調査によると、61%が少なくとも1つのAI対応アプリケーションを利用していましたが、56.6%は個別の作業にしかAIを使っていませんでした。複数の機能や全社でAIを活用していたのは19%にとどまり、エージェント型AIを導入していたのはわずか3.6%でした。同記事で紹介されている2026年の別の小規模事業者調査では、導入の障壁として専門知識の不足が32.1%で最も多く、次いで投資対効果が不明確であること(23.1%)、連携の難しさ(18.4%)が挙がりました。問うべきは、ツールがデータをつなげるかどうかではありません。3つ目のソースを足す前に、どの2つのソースを丁寧に結合すれば投資を回収できるか、という点です。
ずれの発見と、その解消
1週目は、売上と在庫だけを1日1回読み込み、SKUの対応表を使って結び付けます。プロモーションにはまだ手を付けません。2週目は、販売数量と倉庫からの出庫数を比較します。この2つが一致すれば、キーは3つ目のソースを加えられるだけ信頼できると言えます。
3週目に、プロモーションのフィードを追加します。すると、すぐにずれが現れます。マーケティングツールはバンドルコードを記録しますが、ストアフロントは単品SKUで販売しています。「バンドルの押し上げ効果」は、1つのプロモコードを1つの商品として数えるため、実際に出荷された構成品の数より、キャンペーンが強く見えてしまいます。
次の3つの対策で、このずれを解消します。
- バンドルのマッピングテーブル:押し上げ効果を測定する前に、各バンドルを構成SKUに分解します。
- 在庫の鮮度フラグ:スプレッドシートが今日取り込まれたものか、3日前のものかを表示します。
- 週次のコントロールトータル:販売数量と倉庫からの出庫数を比較し、乖離がある場合はプロモーションレポートを保留します。
販促対象SKUごとの欠品日数、販促商品の予測誤差、月次レポートにかかる時間、例外対応の解決に要する日数。この4つを見れば、ワークフローが機能しているかどうかが分かります。ダッシュボードの見た目を整えても、それは分かりません。
一定数量を超える発注は、引き続きバイヤーが承認します。以前のモデルバージョンは保管しておきましょう。マーケティングツールでスキーマが変更されても、慌てて作り直すのではなく、元に戻せます。接続するのはこのワークフローに必要なフィールドだけにし、共有の販促ビューには顧客のメールアドレスを含めないでください。
段階的な結合は、すべてのシステムを一度に接続するよりも早く成果につながります。新しいデータソースを追加するたびに、すでに信頼できる合計値と照合できるためです。中小企業向けの実践的なデータ統合の手法も、同じパターンに沿っています。判断は1つ、データソースは2つ、説明できるチェックを1つ用意します。
重要ポイントと最初のワークフロー
統合した数値は、一見正確に見えても、元データの定義が異なっていたり更新タイミングがずれていたりすれば誤りになりえます。まず、チームが下すべき判断を1つ決め、社内で疑問視されている数値を対象に、小さなワークフローを作りましょう。
- 2つのデータソースを選びます。食い違いが時間の損失につながるもの、たとえば売上と在庫です。
- 共通の指標を1つ定義します。計算式、含めるもの、対象期間を記録します。
- 品質ルールとコントロールトータルを設定します。ルールを満たさない場合は、レポートを保留します。
- ワークフローを30日間運用します。欠品日数やレポート作成時間を、導入前の基準値と比較します。
- 最初のワークフローが安定してから、3つ目のデータソースを追加します。
接続するのは、そのワークフローに必要なフィールドだけにします。データソースをリンクする前に、データの所有者とアクセス権を持つ人を確認してください。共有レポートでは、顧客のメールアドレスなどの個人識別情報をマスクします。
ELECTEは最初のワークフローを支援できます。アカウントやデータソースをリンクするか、Excelファイルをアップロードするだけで、連携プロジェクトや技術的なセットアップは不要です。ほとんどのユーザーは5分以内に利用を開始でき、会計ソフトを接続するかファイルをアップロードすると、AI分析と最初の予測が利用できます。次の一歩としては、自社のファイルを接続し、いつも議論になっている数値を1つ確認してみてください。
コネクタはレコードを集約しますが、指標の意味、どのデータソースが正とするか、合計が一致するかまでは決めてくれません。まずこれらを取り決め、そのうえで品質チェックによって、統合した数値が発注、予測、取締役会資料に使えるかどうかを判断してください。
ELECTEは、会計、銀行、スプレッドシートのデータを1つのダッシュボードに集約します。エクスポート作業なしで常に最新の状態が保たれ、貸借対照表全体の将来予測も表示されます。まずは、2つのデータソースと、チームで意見が分かれている指標を1つ選んでください。
コメント
まだコメントはありません — 会話を始めましょう。