小売の需要予測:手法、必要なデータ、導入効果
小売の需要予測の仕組み、使うべき手法、必要なデータを解説します。精度の高い在庫計画で、欠品と過剰在庫を減らす方法がわかります。

欠品の原因は仕入先のせいにされがちです。しかし実際には、もっと身近なところから始まっていることがほとんどです。IEOM Societyの2025年バングラデシュ会議で発表された小売在庫に関する研究によると、スーパーマーケットの欠品の51%~73%は小売業者の社内に原因があり、主な要因として、(需要の過小評価を含む)予測の不正確さと発注ミスが挙げられています。
この結果は、取り組むべき課題の捉え方を変えます。小売の需要予測は、最先端のアルゴリズムを選ぶ競争ではありません。欠品やプロモーションですでに歪んだデータから、実態に即した需要の信号を取り出し、商品ごとの売れ方に合う手法を選び、その結果を月曜の朝にバイヤーが実際に使う発注点へ組み込む。これが運用上の規律です。
本ガイドでは、この一連の流れ全体を扱います。予測が出すべきアウトプット、重みのある入力データ、小売の状況別に比較する代表的な6つの手法、低回転商品に別の設計が必要な理由、買いだめやチャネル移動がプロモーション効果をどのように実際より大きく見せるか、判断ごとに信頼すべき誤差指標、そして次の仕入れサイクルの前に行う5ステップの点検までを紹介します。
売場における需要予測とは
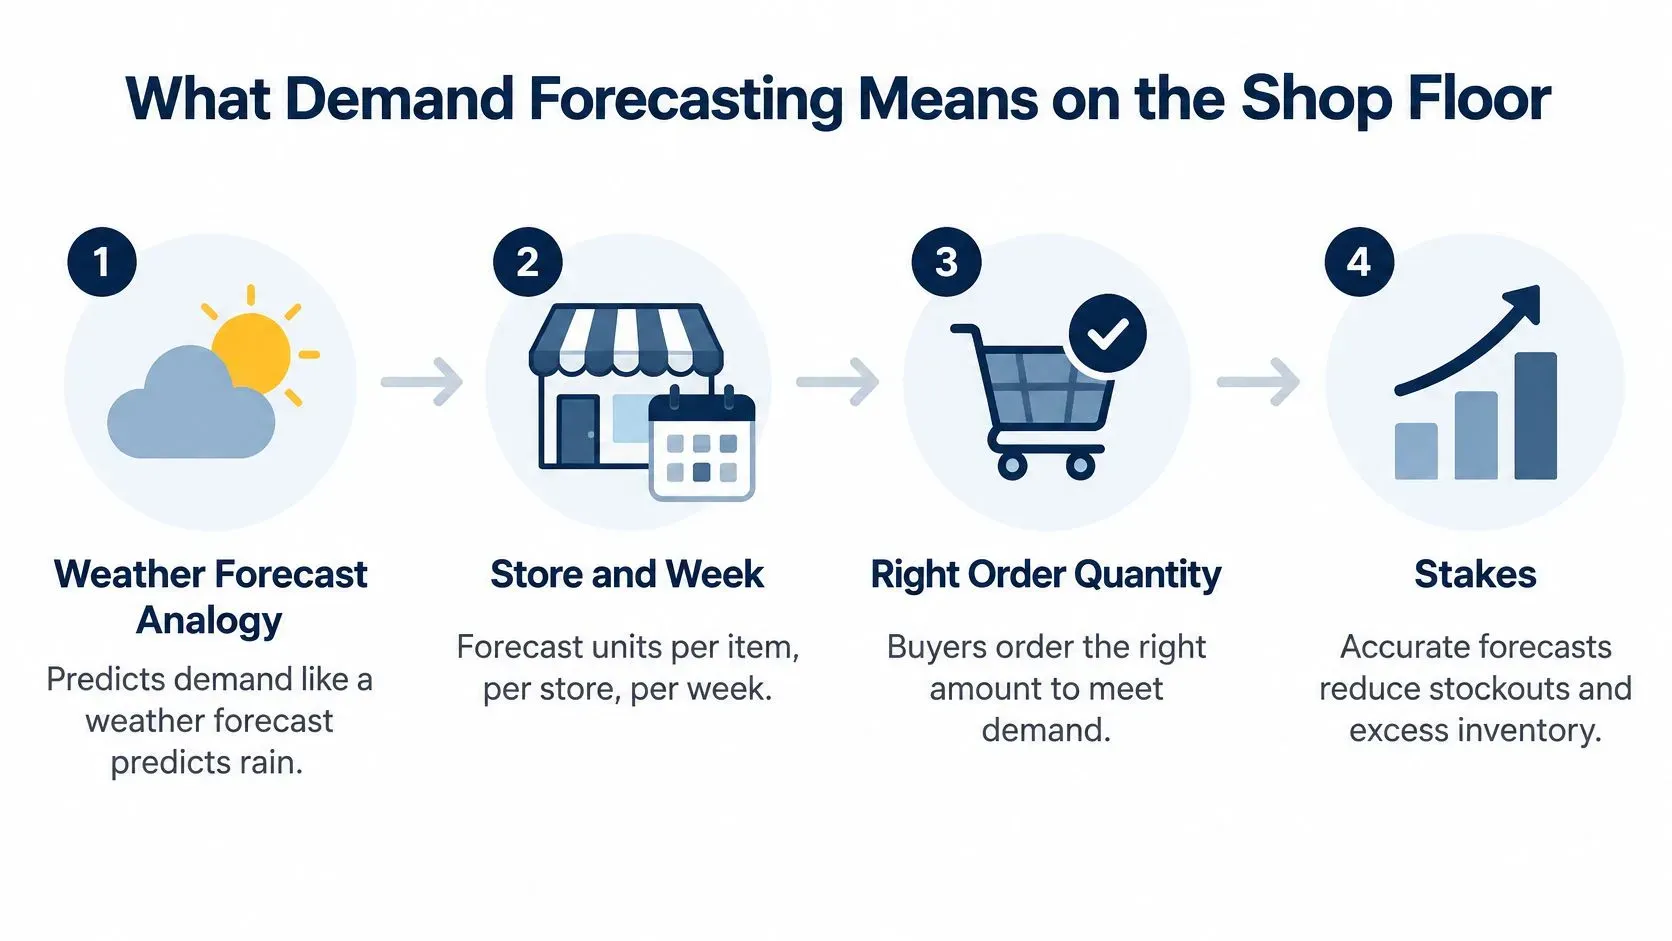
天気予報が信頼されるのは、地域と時間が具体的だからです。火曜の午後にあなたの街で雨が降る確率がわかれば、傘を持つかどうか決められます。需要予測も在庫に対して同じ役割を果たします。特定の店舗で、特定の週に、特定の商品が何個売れるかを見積もることで、バイヤーはもっともらしい数量ではなく、適切な数量を発注できます。
以下の5ステップは、予測から、それを受けて出すべき発注までを、要点だけにまとめたものです。
予測の対象は需要であり、レジにたまたま記録された販売数ではありません。シャンプーの棚が空だった間に記録された0は、打ち切られた(欠品で観測できなかった)需要です。プロモーションによる急増は、翌2週間分の前倒しだったり、近隣店舗から奪った分だったりすることがあります。カテゴリ平均や月次レポートでは、こうした商品・店舗単位の問題が見えなくなるため、データは細かい粒度のまま保ち、頻繁に更新する必要があります。
実際の運用の流れは次のとおりです。
- 収集:商品・店舗・日別の販売実績と在庫履歴を集めます。棚が空だった日も含めます。
- 整備と統一:単位とカレンダーを統一し、店舗システムが週次データを修正再送したときの重複行も取り除きます。
- モデル化と予測:発注判断に必要な粒度で、商品・店舗ごとの需要を予測します。
- 予測を発注量と安全在庫に変換:リードタイムと、約束しているサービスレベルを使います。
- 誤差を測定して調整:年に一度の予算時期ではなく、商品ごとに行います。
各ステップは、3つのコストのいずれかを防ぐためのものです。需要を少なく見積もると、買い物客が代替品を買うか店を離れてしまい、取り戻せない売上を失います。多く見積もると、現金が在庫として滞留し、値下げ処分が必要になります。数量はおおむね合っていてもタイミングがずれると、両方のコストが発生します。急ぎの発注には割増運賃がかかり、余剰分には保管費がかかります。
最もコストを節約できるルール:予測が役に立つのは、補充ルールがそれを実行に移したときだけです。レポートに載っているだけの完璧な数字では、売り場は何も変わりません。
データ入力と、欠品がデータを歪める理由
モデルを比較する前に、何を入力するかを確認しましょう。小売の予測精度を最も大きく左右する入力項目は、ありふれた地味なものばかりですが、多くのチームはそのうち2〜3項目が欠けています。
- 商品別・店舗別・日別の販売履歴。これより粗い粒度では、シグナルを担うプロモーション週や週末の急増が見えなくなります。
- 手持ち在庫と欠品期間。これがないと、売れなかった週と棚が空だった週を区別できません。
- 価格と値引き率。10%引きと30%引きでは反応曲線が異なるため、定価ではなく、買い物客が実際に支払う棚価格を記録してください。
- プロモーションカレンダー(陳列位置やチラシ掲載を含む)。
- 祝日と地域イベント。2本先の通りで開かれる学校の催しのほうが、国民の祝日よりもボトル入り飲料水の売れ行きを動かすことがあります。
- 天候。特に生鮮、季節商品、園芸カテゴリで重要です。
- 競合の価格(一貫して把握できる範囲で)。
- 仕入先のリードタイムと納品遅延。必要なカバー量を左右します。
空の棚が「偽のゼロ」を記録する理由
たとえば、シャンプーが週平均40個売れているのに、棚が3日間空だったとします。その3日間の販売数はゼロと記録されます。この履歴で学習したモデルは、在庫が切れると需要が落ちると学んでしまいますが、実際はその逆です。商品が見つからなかった買い物客は気が変わったのではなく、別の店へ行ったのです。
仕入先の遅延、補充の遅れ、自社の発注判断も、まったく同じ形で販売データを打ち切ります。モデルには、失われた販売と失われた関心を区別する手段がなく、最も早く売り切れる商品を過少発注し続けます。
この問題は十分に報告されています。小売予測における機械学習の2026年のレビューは、不完全なデータセット、分断されたデータパイプライン、顧客行動の変化、プロモーション、競合の反応、季節性が、偏りのある脆いモデルの原因になると指摘しています。同レビューは、在庫の専門家661人を対象とした調査も引用しています。それによると、51%が、信頼できないと考えていた予測をときには採用していました。ほかに現実的な選択肢がなかったためです。また、最大の混乱要因には、関税や貿易政策の変更(19%)、インフレや商品価格の変動(17%)が挙がっています。
4ステップの対処法(実施順)
- 欠品日をすべてフラグ付けする:販売履歴に、商品が購入できなかった時間数または日数を記録します。
- 機会損失の売上を推定する:同じ店舗・同じ週の類似商品をもとに、該当日の売上を見積もります。
- 各期間にタグを付ける:学習を始める前に、販売可能な期間か制約のあった期間かを区別します。
- 補正後の履歴で学習し、除外した週で結果を比較する:補正を加えた週では比較しないでください。
多くの中小企業にとって、この作業はアルゴリズムを変えるよりも精度を大きく改善します。モデルが学べるのは記録に残っている内容だけです。欠品中に需要が落ち込んだと記録されていれば、高度なアーキテクチャを使っても、誤った内容をより速く学習するだけです。ELECTE のマルチソース統合ガイドでは、販売・在庫・プロモーションのデータを1つの使いやすいテーブルにまとめる仕組みを解説しています。
小売の状況別に見る予測手法の比較
万能な手法はなく、状況に合う手法があるだけです。以下の表は、需要計画の担当者のデスクに貼っておきたい比較表です。
手法 | 小売で最適な場面 | 必要なデータ | 強み | 注意点 |
|---|---|---|---|---|
移動平均法・指数平滑法 | 需要が安定した高販売量の商品 | 1~2年分の週次販売データ | シンプルで低コスト、説明しやすい | 販促や季節変動の変化を捉えられない |
SARIMAなどの季節モデル | 週単位または年単位の明確な周期がある商品 | 2シーズン以上の履歴 | トレンドと季節性を捉えられる | 数千の系列を同時に扱うのが苦手 |
クロストン系の手法 | 需要が断続的で動きの遅いSKU | 販売ゼロの期間が多い販売履歴 | 販売の発生頻度と販売量を切り分けられる | 安定して売れる商品には不向き |
販促・価格の特徴量を用いた回帰 | 販促で需要が動くカテゴリ | 販促カレンダーと価格履歴 | 各要因が需要をどう動かすかが分かる | 販促の実績が少ないと精度が崩れる |
XGBoostやLightGBMなどの決定木アンサンブル | 商品×店舗の大規模なポートフォリオ | 販売実績、カレンダー、販促、価格 | 関連する多数の系列から横断的に学習できる | クリーンなデータと継続的なモニタリングが必要 |
LSTMとXGBoostのハイブリッドアンサンブル | 豊富なシグナルを持つ複数カテゴリのチェーン | 36か月分のPOSデータと販促データ | 小売14社を対象としたある研究では、4週間先の予測で平均絶対パーセント誤差を平均28.6%削減 | 構築も説明も負担が大きい |
個々の行よりも、その背後にあるパターンのほうが重要です。小売業の需要予測研究に関する査読付きレビューによると、フィードフォワード型やリカレント型のニューラルネットワーク、勾配ブースティング回帰木、ランダムフォレストなどのグローバル機械学習モデルは、小売企業が大量の販売時系列を予測する場面で、個別の時系列モデルや回帰モデルを上回ることが多いと報告されています。その優位性は、ポートフォリオが大きいほど広がります。対象となるのは、数千にのぼる商品×店舗の組み合わせで、個々の商品の需要が疎で、断続的、季節的、あるいはプロモーションに左右されやすいケースです。
実際のチェーン店での比較イメージ
40店舗を展開する地域チェーンを考えてみましょう。毎週安定して売れる定番商品には、指数平滑法を使います。カテゴリーマネージャーが数値を読み取り、根拠を議論できるためです。年8回のプロモーションがある季節アパレルには、全店舗を一括で学習させた勾配ブースティングモデルを使います。1店舗の履歴だけでは、値引きの効果曲線を学習するにはデータが少なすぎるからです。
同じレビューは、従来手法が時代遅れではないことも明確に述べています。データ量が少ない場合、安定した商品、そして精度の最後の1ポイントよりも解釈しやすさや限られたデータへの対応が重視される場面では、従来手法も十分に競争力を保ちます。
抑制には見返りがあります。M5データセットを用いた2026年の米国小売需要の評価では、5つのローリング28日ウィンドウにわたる25,940の商品×店舗の時系列を対象に、平均加重絶対パーセント誤差が、季節ナイーブのベンチマークの0.9006から、過去の需要を使ったLightGBMモデルでは0.7022へと下がりました。改善幅は約22%です。小売・オペレーション変数を加えても0.6979にとどまり、ラグ付きのマクロ経済指標を加えた場合は0.6978で、改善は約0.02%でした。
まずベースラインを作りましょう。季節ナイーブや指数平滑法による数値は、半日あれば作れます。これを基準にすれば、機械学習モデルがその複雑さに見合う成果を出したかどうかが分かります。同じホールドアウト期間の週で両方を実行し、優れたほうを採用してください。
モデルの選択は、手法が新しいかどうかではなく、ポートフォリオの規模と構造に基づくべきです。この原則だけで、どんなハイパーパラメータ探索よりも多くのコストを節約できます。
低回転品と疎な需要には専用のモデルが必要
商品によっては、需要の「水準」がなく、需要の「イベント」だけがあります。年に4回しか売れない補修部品、ECのロングテールのバリエーション、月に2個しか動かない店舗×SKUの組み合わせなどです。標準的な季節モデルはこうした商品の扱いが苦手で、その理由は構造的なものです。
ゼロの販売と正の販売は、2つの異なるプロセスから生じます。販売が発生するかどうかは1つの問いであり、発生したときの規模はまた別の問いです。Croston型の手法はこの2つを別々に推定するため、ゼロの多い小売データでも安定した性能を発揮します。断続的需要に関する小売予測ベンチマークでは、CrostonがWAPE 93.15%、MASE 0.9852を記録し、比較対象のナイーブ法やSARIMAXを上回ったと報告されています。このWAPEは、ゼロだらけの時系列における相対的な結果として読んでください。絶対的に見て良い精度という意味ではありません。
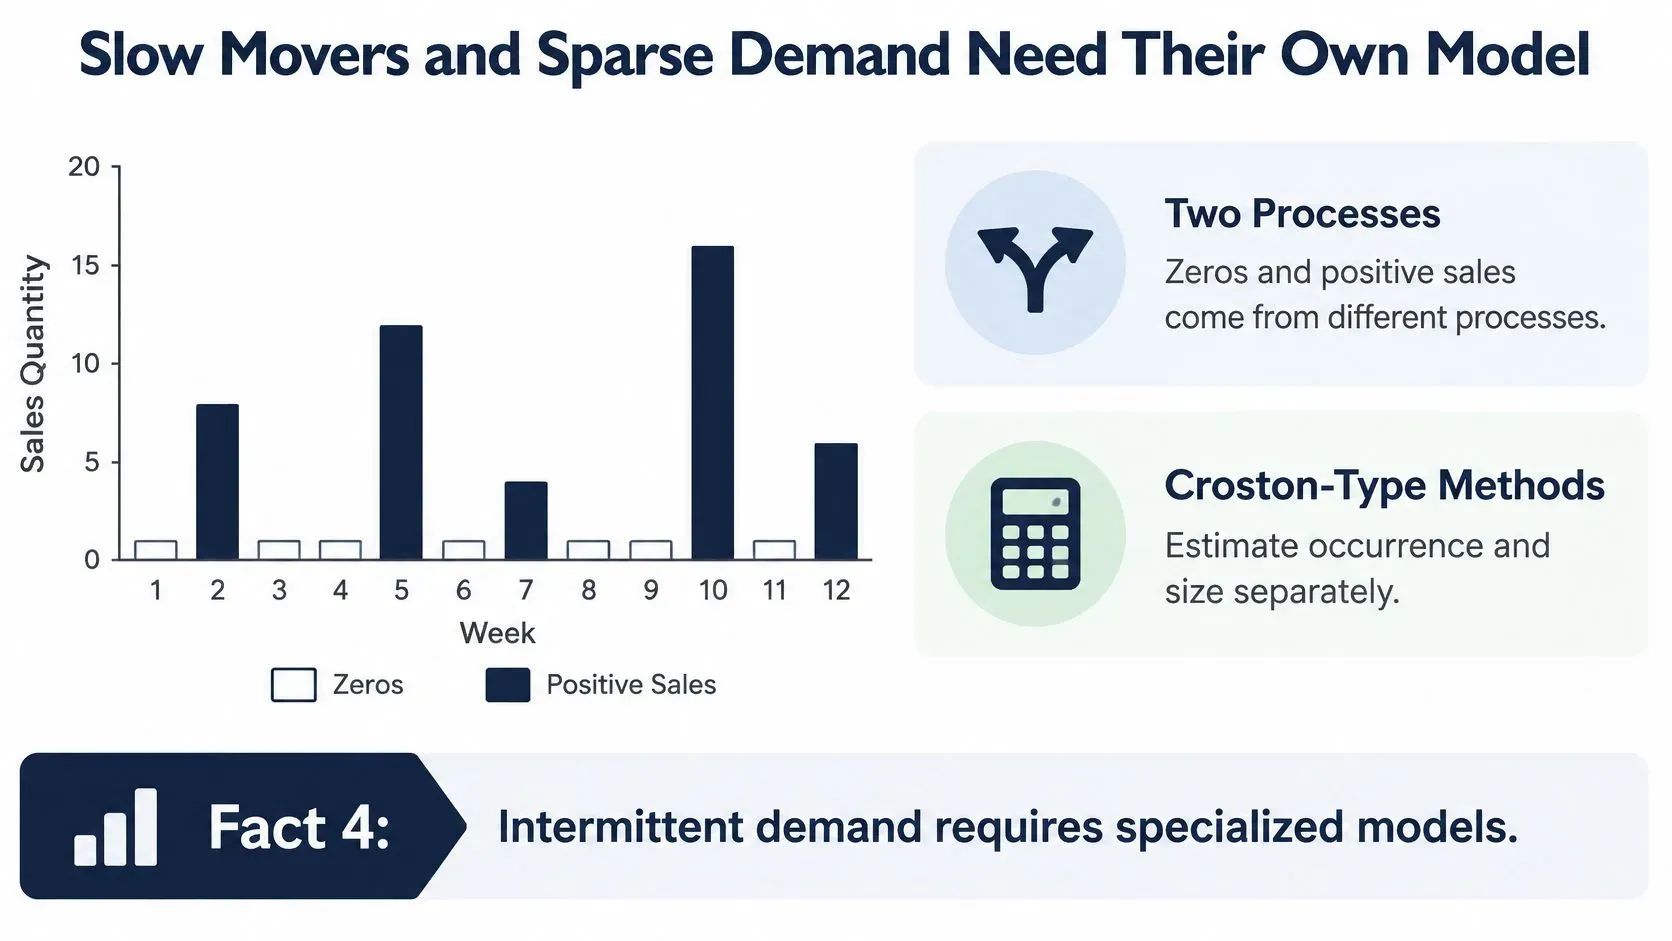
この失敗パターンは具体的で、コストも大きなものです。標準的な回帰モデルや季節モデルは、ゼロが続く系列を見て「需要は低位で安定している」と判断し、それに合わせて安全在庫を設定します。その結果、不規則にまとまって売れる低回転商品は欠品し、動かない商品が3か月分の在庫を抱え込みます。前者の誤差は販売機会の損失を招き、後者はキャッシュと棚スペースを失わせます。
同じ領域には、もう一つ教訓があります。間欠需要、欠測値、頻繁な品揃え入れ替えを含む販売データを対象としたベンチマークでは、検証したアプローチの中でローカライズされた木ベースのモデルが最も良い成績を示し、XGBoostが報告された中で最小の二乗平均平方根誤差4.833を達成しました。ここから得られる結論は「どこでもXGBoostを使え」ではありません。商品の入れ替わりが速い場合、商品ファミリーごとに構築したモデルのほうが、相容れないパターンを平均化せざるを得ない単一の汎用モデルを上回りうる、ということです。
系列の振り分け方
- モデル化の前に分類する。すべての系列について、平均需要間隔と、非ゼロ需要の変動係数の二乗を算出します。前者は販売と販売の間の典型的な間隔(期間数)、後者は販売ごとの数量がどれだけ大きくぶれるかを示します。
- 間欠需要の系列は、Croston系、ハードル型、または発生・数量分離型のモデルに振り分けます。
- 安定した高販売量の商品は、本来適している季節モデルや機械学習モデルに回します。
- 分類は四半期ごとに見直す。商品は、ライフサイクルの進行、販売終了、ヒットなどによってカテゴリ間を移動します。振り分けルールを再実行しなければ、精度は劣化します。
分類結果は、確認できるテーブルに保存してください。カテゴリマネージャーから、なぜこの商品には特殊な手法で予測しているのかと聞かれたとき、答えは曖昧な返事ではなく、二つの数値であるべきです。
プロモーション、買いだめ、チャネルシフト
プロモーション週は通常の週とは異なります。ベースラインに混ぜてしまうと、両方が歪みます。ベースライン需要とプロモーション効果は別々にモデル化し、その後で足し合わせてください。
小売の予測手法を比較した研究では、SKUの過去のプロモーション実績が5回を超える場合、チェーン単位の日次需要予測において、決定木のアンサンブルが線形回帰、正則化付き線形回帰、回帰木の手法を上回りました。この結果で実用的な目安となるのが5回という閾値です。それを下回ると、割引率、プロモーションの時期、商品とカレンダーの相互作用が需要をどう動かすかをモデルが学習するための事例が足りません。その場合は、ノイズを追いかける柔軟なモデルよりも、強めの正則化や単純なベンチマークのほうが被害は小さく済みます。
モデルには、プロモーションの有無、割引率、陳列位置、祝日との近さ、プロモーション後の需要のラグ値といった特徴量を明示的に与えてください。最後の特徴量は省かれがちですが、需要の落ち込みを捉えるのはこの特徴量です。
誰も予測しない落ち込み
たとえば、シャンプーの30%割引で1週間だけ売上が伸び、その後2週間はトレンドを下回ったとします。買い手はまとめ買いをしただけで、四半期全体では購入量は増えていません。この3週間の期間全体を1つの分析単位として扱ってください。販促期間の誤差は、発注量が足りていたかを示します。販促後の誤差は、その月の残りの期間に過剰発注していなかったかを示します。別々に評価すれば、両方の判断が見えてきます。まとめて評価すると、2つの誤差が相殺され、レポート上は問題なく見えても、実際には両方の判断を誤っていることになります。
販促ライフサイクルに関する研究では、従来の研究は販促後のフェーズを見落としがちだと指摘しています。このフェーズでは、顧客がイベント中にまとめ買いをしたため需要が落ち込みます。また、機械学習の手法を使えば、販促期間中だけでなくライフサイクル全体で予測を改善できると報告しています。
チャネルは、もう1つの錯覚を生みます。ブラジルの地域スーパーにおけるマルチチャネル販促の調査では、需要の移動が実店舗からオンラインへ11.23%、その逆方向で19.34%と推定されました。一方、連携した販促により、カニバリゼーションは30.04%減少しました。ロイヤルティ施策は、測定された上昇幅が最大で3.5%でした。チャネルごとに個別に予測すると、場所が変わっただけの需要を二重に数えることになります。
そのうえで、評価では次の4つのルールを守ってください。
- 販促期間と非販促期間を別々に評価する。好調な1週間が、不調な1か月を隠さないようにするためです。
- ベースリフトなどの因果的ベースラインと比較する。そうしないと、モデルが販売量をどれだけ学習したかを測っているだけになります。
- SKU別、販促回数別に評価する。5回という販促回数のしきい値によって、期待できる精度が変わるためです。
- 販促後のラグ特徴量を残しておく。そうすればモデルは需要の落ち込みを表現でき、不意を突かれずに済みます。
値引きで利益率が削られているなら、同じ課題の価格面を扱ったガイド割引キャンペーンで利益率を守る方法をご覧ください。
精度の測定と、予測の発注への落とし込み
指標は、判断の内容を決めてから選んでください。指標ごとに答えられる問いは異なり、隠れてしまうものも異なります。
指標 | 使う場面 | 注意点 |
|---|---|---|
WAPE(加重絶対パーセント誤差) | 規模の異なる品目間で精度を比較するとき | 販売数量の多い品目の影響が最も大きくなる |
MASE(平均絶対スケール誤差) | 需要が断続的な系列や、ゼロの多い系列でモデルを比較するとき | 正しく読み取るには、ナイーブ予測という基準が必要 |
MAPE(平均絶対パーセント誤差) | 需要が安定していて販売数量の多い品目を、シンプルに報告するとき | 実績需要がゼロの場合、不安定になるか定義できなくなる |
バイアス | 予測が一貫して過大または過小になっていないかを見つけるとき | 誤差が相殺されて見えなくなることがあるため、期間別に確認する |
サービスレベル | 予測が棚の在庫確保に役立っているかを確認するとき | 予測だけでなく、補充設定にも左右される |
パーセンテージ誤差は、動きの遅い商品では成り立ちません。実際の需要がゼロのとき、分母もゼロになり、指標は極端な値になるか、平均から除外されます。どちらの場合も、モデルの精度が実際より良く見えてしまいます。WAPEまたはスケール調整済み誤差を、バイアスやサービスレベルとあわせて報告し、カタログ全体の1つの数値ではなくセグメント別に読み取ってください。
数値から発注点へ
予測は、チームの誰でも検算できる計算を経て発注になります。リードタイム中の想定需要に、目標サービスレベルに応じた安全在庫を加えたものが発注点です。
たとえば、ある店舗がサプライヤーのリードタイム5日間で40個の需要を見込み、10個のバッファを持つとします。発注点は50個です。手持ち在庫と発注済み数量の合計が50個まで下がった時点で発注します。バッファが合意されていないために担当者が40個で発注すると、トラックが遅れた初日に棚が空になります。
次の2つの運用ルールが、この精度を保ちます。1つ目は、商品の予測誤差が閾値を2期間以上連続で超えた場合に例外アラートを設定することです。これにより、担当者はダッシュボードではなく商品そのものを確認できます。2つ目は、カテゴリ別に毎月バイアスチェックを行うことです。個々の商品の誤差では平均化されて見えなくなる、系統的な過大予測や過小予測を検出できます。
統計的に精度の高い予測でも、発注タイミング、見直し頻度、安全在庫の設定が適切でなければ、欠品を引き起こすことがあります。予測と補充ルールはあわせて見直してください。そうしないと、見当違いの対象を修正し続けることになります。
ELECTE在庫データ分析ガイドでは、在庫状況を、バイヤーが判断に使う数値へ結び付ける方法をさらに詳しく解説しています。
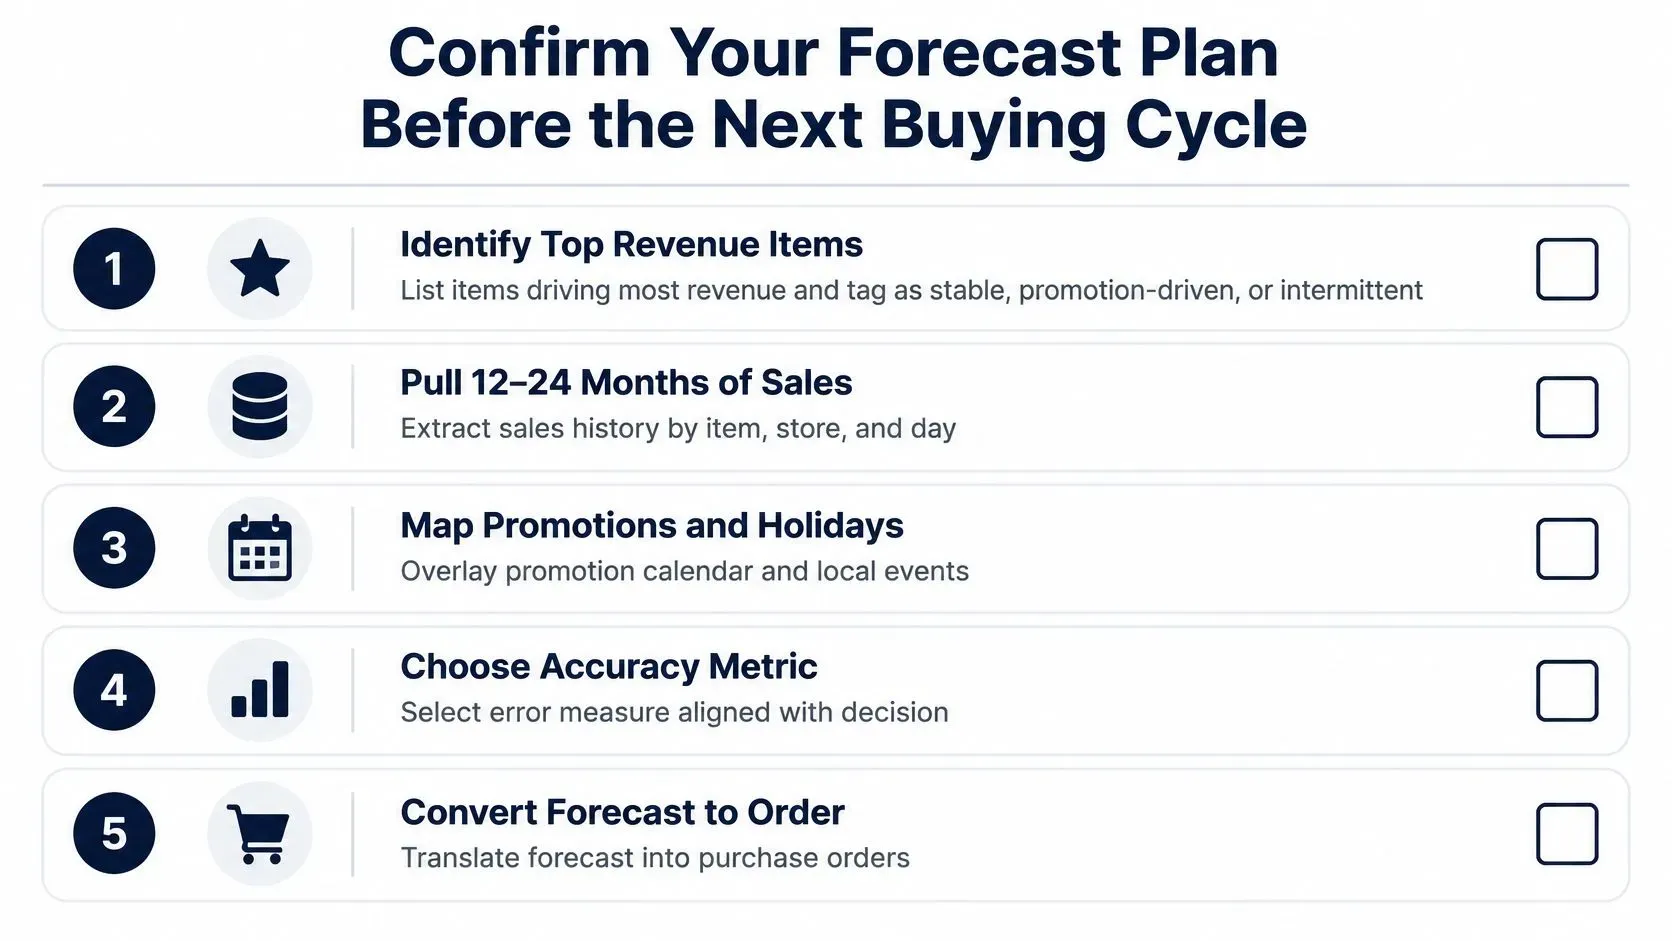
次の仕入れサイクルの前に予測計画を確認する
次の発注を行う前に、予測プロセスが対象の商品と意思決定に適しているかを確認してください。次の5つのチェックで、計画を実務に即したものにできます。
- 品揃えを仕分けする。売上の大半を生む商品を特定し、安定型、プロモーション型、間欠需要型に分類します。それ以外の商品には、より単純なルールで十分な場合があります。
- 販売履歴を確認する。商品別・店舗別・日別に12〜24か月分の販売データを取得し、欠品日にフラグを付けます。12か月分しかない場合はそのデータを使いますが、誤差が大きくなることを見込んでください。
- ベースラインと比較する。季節性のベースラインを設定し、ホールドアウトした週でより高度なモデルと比較します。上記のM5の結果は、複雑なモデルが採用に値することを示す必要がある理由を表しています。
- 測定ルーチンを決める。意思決定ごとに指標を選び、その閾値と見直しの頻度をサイクルをまたいで一定に保ちます。
- 繰り返す外れを見直す。予測誤差が繰り返し発生する商品は、発注前に発注点を再確認します。
ELECTEは、ユーザーのデータに対して6つの予測手法を実行し、手法同士を比較評価して、最も精度の高いものを選択します。無料の発注点計算ツールを使えば、個々の商品の発注点を計算できます。
予測はリスクを減らしますが、あらゆる変化を織り込めるわけではありません。新商品の発売や、比較できる販売履歴のないプロモーションは、モデルが捉えられない場合があります。実際の需要が計画と異なった際にバイヤーが対応できるよう、予測とあわせて見直しのルーチンを維持してください。
ELECTEは、販売・在庫・プロモーションのデータを連携し、利用可能なデータに対して6つの予測手法を比較します。予測結果、精度、例外事項は、チームで共有できるビジュアルダッシュボードに表示されます。自社の販売データとあわせて需要予測を検討している小売事業者の方は、ELECTEをご覧ください。
コメント
まだコメントはありません — 会話を始めましょう。