レポート自動生成の仕組み:中小企業向けガイド
レポート自動生成が、生データをスケジュール通りに届く意思決定向けのレポートへ変える仕組みを解説します。ワークフロー、メリット、中小企業向けの導入手順もご紹介します。

MIT Technology Review Insightsのレポートによると、CIOの98%が、データとAIに単一の組み込み型ガバナンスモデルを適用することが極めて重要だと回答しています(Databricksのデータガバナンスガイドより引用)。これは、レポートに対する見方を変えるものです。見栄えのよい資料をつくるだけでは不十分で、数値の出どころ、閲覧できる人、結論を確認した人まで把握しておく必要があります。
中小企業にとって、目の前の課題はもっと身近なものでしょう。担当者が取引データをエクスポートし、スプレッドシートの数式を直し、グラフを作り直して、経営向けの資料をメールで送る。経営陣が議論するころには、その担当者はもう次のバージョンの準備を始めているかもしれません。
レポート自動生成は、こうした繰り返しの組み立て作業を、定義されたプロセスに置き換えます。ただし、実用的な導入は単にレポートを速く送るだけではありません。根拠となる記録を残し、例外を目立たせ、意思決定に対する責任を明確にします。
データサイエンティストになる必要はありません。レポートを料理にたとえてみましょう。業務記録が食材、計算がレシピ、レビューが最後の味見にあたります。それぞれの役割を理解すれば、何を自動化するかを選び、効果を測定し、見栄えはよくても誰も説明できないレポートを信用してしまう事態を避けられます。
レポート自動生成の仕組み:5つのステージ
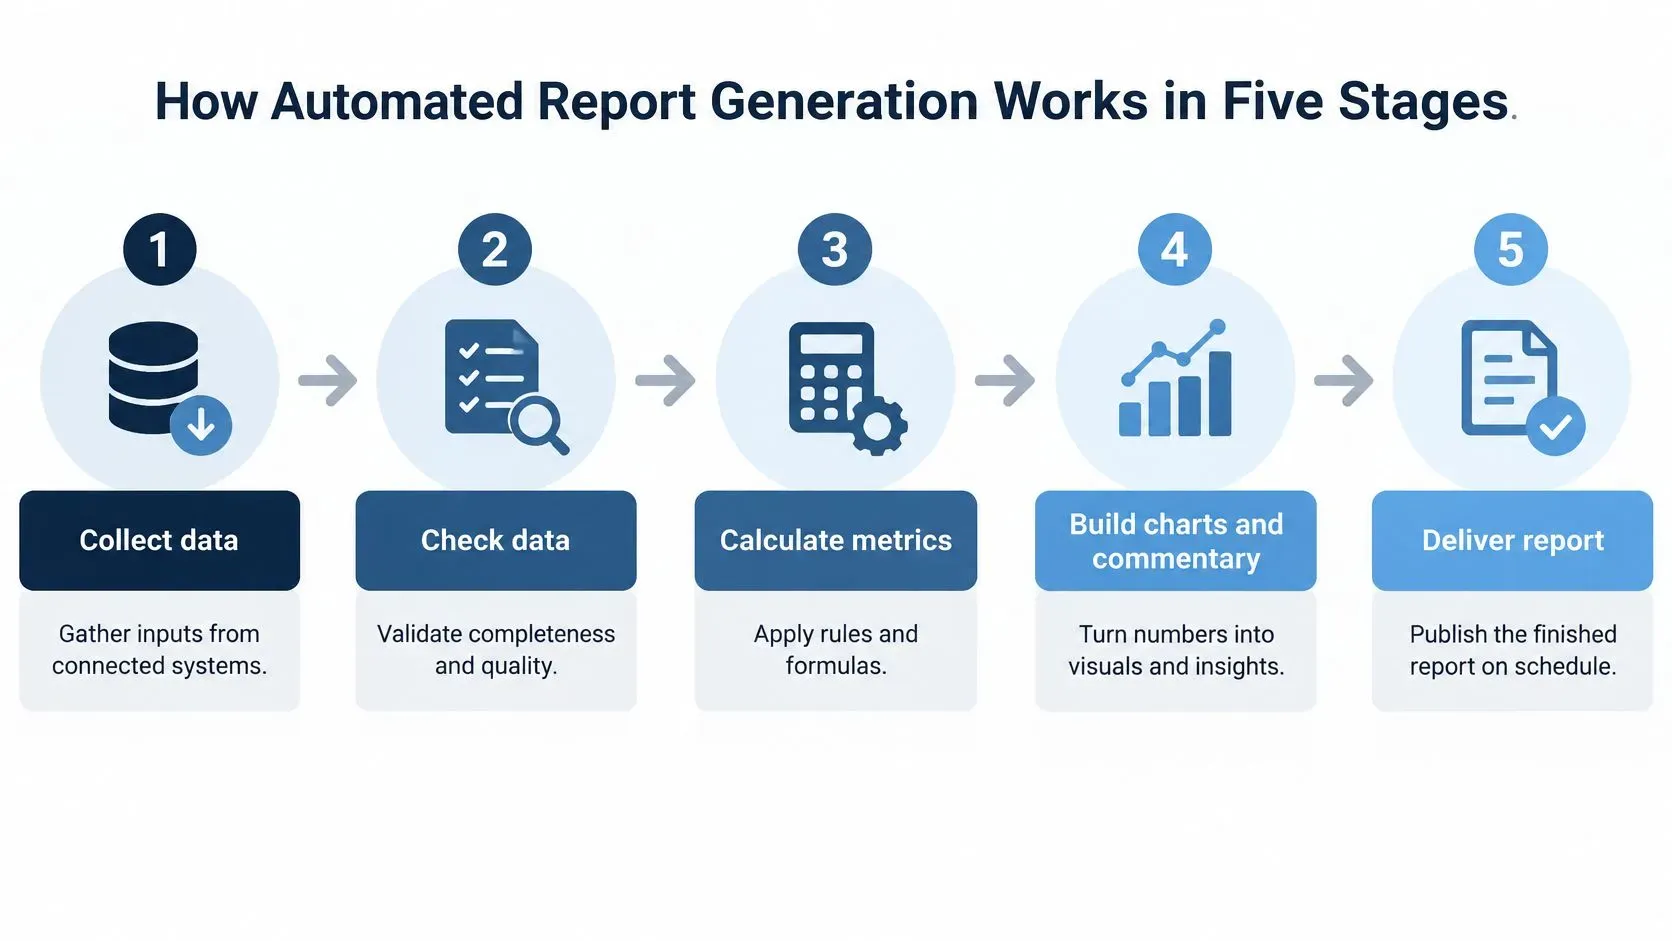
レポート自動生成とは、データの収集、チェック、指標の計算、グラフとコメントの作成を行い、完成したレポートをスケジュールどおりに配信する、繰り返し実行可能なパイプラインです。サイクルのたびにレポート全体を一から作り直す必要はありません。
業務用厨房がわかりやすいたとえになります。食材は複数の仕入れ先から届き、料理人は決められたレシピに従い、完成した料理は適切なタイミングで提供されます。それでも、提供前に味を確かめるのは料理長です。レポート自動化も同じで、入力とルールを一貫させたうえで、重要な解釈には人が責任を持ち続ける必要があります。
自動レポートの5つのステージ
ステージ | 処理内容 | 出力例 |
|---|---|---|
1. データソースを接続 | 会計システム、銀行、CRM、スプレッドシートからデータを取得します | すべてのシステムからのリアルタイムな売上フィード |
2. クレンジングと検証 | 重複を削除し、合計を確認し、欠落しているフィールドを指摘します | 照合できなかった請求書の例外リスト |
3. 指標を計算 | KPI、期間比較、差異を算出します | 前月と比較した売上と増減率 |
4. ビジュアルと解説を作成 | 算出した指標をもとに、グラフとコメントを作成します | 棒グラフと、主な要因を2文でまとめたメモ |
5. 配信と記録 | スケジュールどおりにレポートを送信し、使用したデータを記録します | データソースへのリンクを添えた、経営陣向けの月曜日のメール |
月次の売上レポートが、会計、銀行、CRM、Eコマース、調整用スプレッドシートという5つのシステムのデータを基にしている場合を考えてみましょう。接続すればレコードは1か所に集まりますが、すべてのレコードが自動的に比較可能になるわけではありません。たとえば、会計システムには認識済みの売上が記録され、銀行には受領済みの現金が記録されている、ということがあります。
合計を計算する前に、こうした違いを定義してください。営業部門と経理部門の数字が食い違う場合は、まず日付、識別子、指標の定義をそろえて、営業レポートと財務レポートの不一致を解消しましょう。
レコードから経営陣向けメールまで
パイプラインは請求書の識別子を照合し、取引日が欠けているものにフラグを立て、承認済みの売上定義を適用します。続いて期間比較を計算してグラフを作成し、計算結果に基づいて解説文の下書きを作ります。経営陣向けメールには、出力結果と、その根拠をたどれる導線が含まれます。
このようなエンドツーエンドの自動化は、まだ一般的ではありません。McKinseyの分析では、調査対象のデータ・分析リーダーの50%超が、主要なデータ管理プロセスの自動化は「多くてもある程度」にとどまると回答しました。別の自動化調査では、複数の事業領域にまたがって自動化を拡大できている企業は20%未満と報告されています。
実践的なテスト: 同じテンプレートで毎回のレポートを作成でき、システムが検証できなかった項目は例外リストとして出力されますか?
納品のたびに誰かが出力を修正しなければならないなら、自動化できているのは準備作業の一部だけです。
手作業のレポート作成がチームの足かせになり続ける理由
中小企業でよくある例を挙げます。小売店の店長が複数のシステムからデータをエクスポートし、作成者本人しか完全には理解できないスプレッドシートに統合しています。売上、在庫、販促の結果では、商品名や集計日が異なります。毎週の資料づくりが、そのたびに突合作業になります。
個々の作業だけを見れば、この流れは問題なくこなせそうに見えます。
- POSシステムから売上をエクスポートする。
- 倉庫管理アプリから在庫数をダウンロードする。
- 共有スプレッドシートから販促結果をコピーする。
- 合計を突合し、壊れた数式を直す。
- グラフを整え、解説を書く。
- 月曜の会議に向けて金曜に資料をメールで送る。
店長は販促の抜けに気づき、修正版の添付ファイルを送ります。ところが会議では、別の誰かが古いバージョンを開いています。もはや議論の焦点は事業の業績ではなく、どのファイルを信頼すべきかになってしまいます。
この運用が続いてしまう理由
エクスポート1つひとつは小さな作業に見えるため、プロセスを見直すほどのことではないと思われがちです。数式を理解している人が自然とトラブル対応の担当になり、ほかのメンバーは自信を持って直せないブックには手を加えません。リリース履歴がなければ、どのバージョンが承認されたのかを簡単には確認できません。
自動化の根底にある考え方は、新しいものではありません。CIOのビジネスインテリジェンスの歴史では、ハンス・ピーター・ルーン(Hans Peter Luhn)が1958年に発表した論文A Business Intelligence Systemが紹介されています。この論文は、機械を使ってビジネス情報を収集・整理・配信する構想を示しました。
実務上の障壁は、情報がデジタル化されているかどうかだけではありません。それを、合意されたレポートに変えるための再現可能なプロセスがチームにあるかどうかが問題です。
チームに次の点を確認してください。レポート作成1サイクルにかかる時間は何時間か。送信までにファイルに触れる人は何人か。何かを変更する前に、その答えを記録しておきましょう。
手作業のレポートと自動化されたレポート:タスク別の比較
スプレッドシート全体とプラットフォーム全体を比べるのではなく、タスクごとに比較しましょう。作業の中には決まったルールに従うものもあれば、販促施策、サプライヤーの供給障害、特殊な顧客契約を理解している人が必要なものもあります。
データ収集、突合、書式設定は、毎回担当者が繰り返す作業なので、自動化に適しています。コメントの作成は別のアプローチが必要です。システムが説明の下書きを作成することはできますが、その根拠が証拠で裏付けられているかどうかは、アナリストが検証すべきです。
タスク別に見る手作業のレポートと自動化されたレポートの比較
レポート業務 | 手作業の場合 | 自動化した場合 |
|---|---|---|
データ収集 | 各システムからファイルをエクスポート | スケジュール設定した接続でデータを自動取得 |
クレンジングとチェック | スプレッドシートで手作業により突合 | ルールに基づく検証を行い、例外のみをフラグ表示 |
グラフと書式設定 | サイクルごとに手作業で作り直し | 実行のたびに1つのテンプレートから生成 |
コメント | 毎回ゼロから作成 | 指標から下書きを作成し、アナリストがレビュー |
配信 | ファイルを添付して手動でメール送信 | アクセス制御付きでスケジュールどおりに送信 |
1サイクルあたりの所要時間 | 毎サイクル、担当者の作業時間が発生 | 安定稼働後は主にレビュー時間のみ。削減効果は組織によって異なる |
2025年の学位論文で引用されたある調査によると、AIを活用している典型的な中小企業オーナーは、個人の作業時間で週あたり約13時間、さらに従業員の作業時間に換算して13時間、合計で約26時間を節約していました。この結果は、調査対象のユーザーによるAI活用全般を対象としたものであり、レポート作成だけを対象としたものではありません。また、御社での削減を保証するものでもありません。
レポート作成で現実的に見込める改善は具体的です。エクスポートの回数、同じ内容の繰り返し検索、グラフの作り直しを減らせます。ただし、接続の保守、例外処理、レビューにかかる時間も差し引いたうえでなければ、これらを削減できた時間として計上しないでください。
時間以外のメリット
共有テンプレートを使えば、報告期間が変わっても経営陣は一貫した定義で数字を見られます。計算ロジックを特定の担当者のワークブックの外に文書化しておけば、担当者が変わったときの引き継ぎも楽になります。
例外リストを使えば、経営会議の前に、欠けているレコードを適切な担当者へ知らせることができます。不審なグラフに誰かが気づくのを待つのではなく、アラートは業務上のニーズに合わせて設定してください。
プラットフォームが資料を作る速さだけでなく、実際に生まれた有効な余力を測定してください。
ベースラインを把握するには、直近3回分のレポートを用意し、表の各行に対する作業時間を記録します。毎回変わらず繰り返されている作業に印を付け、そのうえで、業務上の判断が必要だった作業を洗い出します。
まずは繰り返し作業から着手しましょう。準備時間、レビュー時間、修正の件数、納期遅れを記録しておけば、リターンが保証されているとは想定せずに成果を評価できます。
最新の自動レポートに含まれるもの
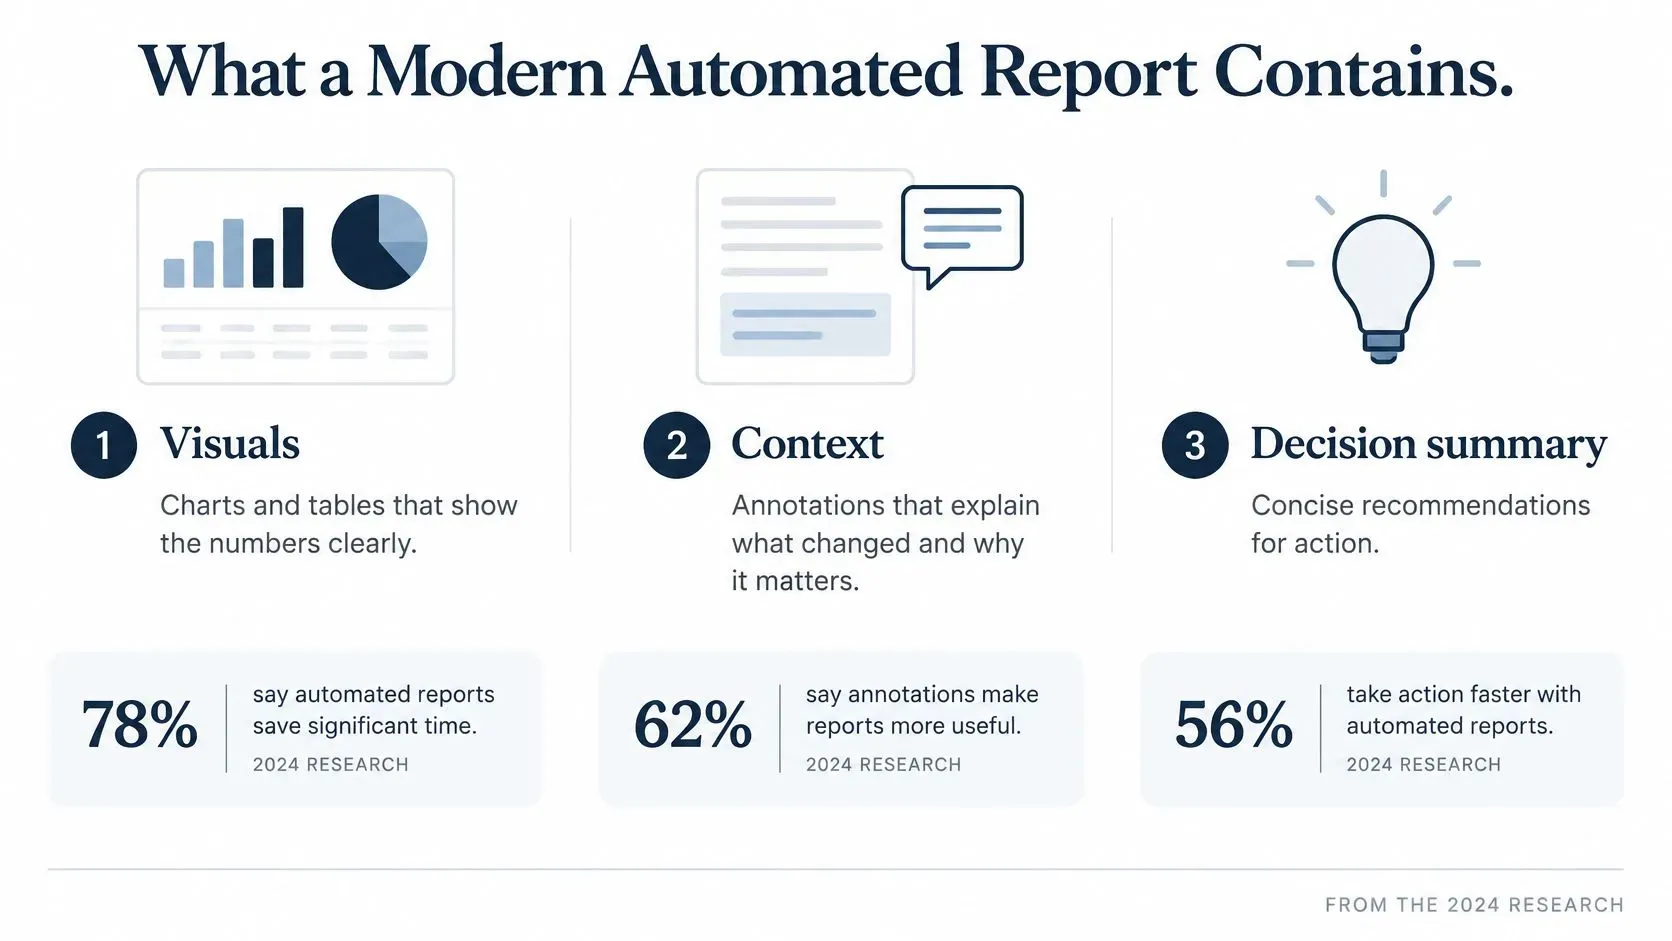
最新のレポートには、はっきり異なる役割があります。数字を示す、その背景を説明する、そして意思決定を支えることです。ダッシュボードは最初の役割を果たせても、ほかの役割までは果たせない場合があります。
AI Press Roomがまとめた2024年のTechTarget調査(北米のデータ・IT担当者375人が対象)では、回答者が挙げた導入率は、可視化とダッシュボードの自動作成が40%、文脈に沿った提案と意思決定サマリーが39%、AIによるレポート生成が38%でした。これらは関連する機能ですが、同じ意味の言い換えではありません。
有用な背景情報とは
たとえば、売上が予測を下回りつつあることを営業レポートが示しているとします。有用なレポートは、差の要因となっている商品ラインを特定し、受注数の減少と値引きの拡大を区別し、予測の前提条件を明記します。
相関を根拠のない因果に変えてはいけません。販促期間中に売上が落ちたのであれば、レポートでそのタイミングを説明することはできますが、販促が減少の原因だと主張するには、追加の裏付けが必要です。
テンプレートを見直すときは、次の構成要素チェックリストを使ってください。
- 主要KPI: 定義済みの指標を、単位と報告期間とともに記載します。
- 期間比較: 営業日数など取引条件が比較可能な期間を考慮し、適切なベースラインを示します。
- 異常値の説明: 確認済みの説明と、調査が必要な疑問点を分けて示します。
- 予測の前提: 需要、価格、支払時期について、予測が何を前提としているかを明記します。
- 前回からの変更点: 修正した入力値、変更した前提、重要な変動を示します。
- 対応責任者: 漠然とした提案で終わらせず、調査または対応を行う担当者を明記します。
詳細度は、読み手が下す判断に合わせて選びます。運用上の問題を確認するサービスマネージャーと、アカウントの収益性を評価する経営幹部とでは、必要なレポートが異なります。VightによるMSPの月次レポートと週次レポートの比較は、報告頻度を管理上のニーズに合わせるうえで、サービス業の視点から参考になります。
グラフの数が増えても、レポートが役に立つようになるわけではありません。読み手が何を調査し、承認し、変更すべきかを判断できる指標だけを残しましょう。
営業・経理・在庫レポートの実践的なワークフロー
以下のシナリオは、実現可能な設計例であり、導入成果を約束するものではありません。それぞれに、トリガー、自動化されるタスク、人が担う責任を割り当てています。
小売チェーンの日次売上ダッシュボード
トリガーは、夜間のレポート締め時刻です。営業終了後、POSとEコマースの注文がレポート用パイプラインに取り込まれます。システムは取引を店舗別・商品別に集計し、異常な落ち込みを調査対象としてフラグ付けします。
朝の会議の前に、地域マネージャーは売れ筋商品とフラグが付いた店舗を抜き取りで確認します。店舗の休業やアップロードの遅延と、実際の需要減少とでは対応が異なるため、マネージャーは運用上の状況を確認してから対応を割り当てます。
経理チームの月次決算パック
トリガーは、合意済みの決算スケジュールです。仮想的な設計例では、元帳、銀行フィード、給与の記録が自動で照合され、第1営業日に暫定版のパックが作成されます。
暫定版は承認済みという意味ではありません。コントローラーは、未処理の調整事項を確認し、差異を承認してから公開します。必要な仕訳が揃っていない場合、パックは帳簿が締まっているかのように見せず、暫定版であることを明示すべきです。
上流の請求業務もこのワークフローに影響します。学習指導ビジネス向けには、請求書の準備が全体のレポート業務にどう組み込まれるかを検討する際、Tutorbaseの個別指導の請求書を自動化する方法のガイドが参考になります。
在庫発注レポート
週次の締め時刻をトリガーに、在庫水準、予想需要、サプライヤーのリードタイムを比較します。システムは発注点を下回っている品目を一覧にし、合意済みの補充ルールに基づいて数量を提案します。
バイヤーは、発注書を送る前に、サプライヤーの制約、代替商品、今後のプロモーションを考慮して数量を確認します。補充提案を発注指示に変える前に、倉庫の補充指標と在庫指標を定義しておきましょう。
定期レポート:頻度・データソース・人による確認別
レポート | 更新頻度 | 主なデータソース | 公開前の人による確認 |
|---|---|---|---|
日次売上ダッシュボード | 毎日 | POSおよびEコマースの注文 | 売れ筋商品とアラート対象店舗の抜き取り確認 |
週次の在庫・発注レポート | 毎週 | 在庫システムと仕入先のリードタイム | バイヤーが発注数量を確認 |
月次決算パック | 毎月 | 総勘定元帳、銀行データ連携、給与 | コントローラーが差異を承認 |
週次キャッシュフロー予測 | 毎週 | 銀行残高、売掛金、買掛金 | 財務責任者が前提条件をレビュー |
四半期取締役会資料 | 四半期ごと | 上記すべて、および合意済みのKPI | 経営陣によるレビューと承認 |
これらの実行頻度は、あくまで設計の出発点として扱ってください。トリガーは、入力データが揃い、出力を受けて担当者が動ける時点に合わせて設定します。
どのワークフローでも、責任の分担は共通です。イベントが実行を開始し、自動化が定義された作業を行い、指名された担当者が該当するチェックを行います。
自動レポートの正確性と監査可能性を保つ
レポートは読みやすく仕上がっていても、内容が誤っていることがあります。重要な例外が抜けている、報告期間が誤っている、根拠のない説明が自信満々に書かれている、といったケースです。
NISTによる機械生成レポートの評価では、網羅性、正確性、検証可能性を区別しています。文章がプロらしく聞こえるかどうかを問うよりも、実用的な品質テストになります。
文章ではなく、回答をテストする
必須の質問と回答のペアを用意します。売上レポートであれば、予測に対する売上実績はどうだったか、差異の要因となった製品ラインはどれか、取引の欠落が結論を変えうるか、といった質問です。
生成されたレポートを、想定される回答と照らし合わせます。網羅性とは必要な情報が含まれていること、正確性とは回答が正しいこと、検証可能性とはレビュアーが裏付けとなる証拠を見つけられることを指します。
メトリクス・リネージとは、報告された数値から、その計算過程をさかのぼり、元のレコードまでたどる経路のことです。これがあれば、レビュアーはソースデータの問題と、計算や生成の誤りを切り分けられます。裏付けのない主張は、公開せずに保留するかフラグを付けてください。
監査に対応できるチェックリスト
- メトリクス・リネージ: ソースの識別子と、各指標の元になったクエリを保存します。
- タイムスタンプ付きの入力スナップショット: 公開版に使用したデータを保持します。
- 変換履歴: 結合、除外、計算式、手動での調整を記録します。
- モデルとバージョンの識別子: 予測モデルとレポート設定を特定できるようにします。
- 不確実性の範囲: 手法が対応している場合は、予測の不確実性を示します。
- 例外ログ: 失敗したチェック、未解決のギャップ、その担当者を記録します。
- 承認の記録: 誰がレビューし、公開を承認したかを残します。
- アクセス制御: 役割に応じて閲覧権限と編集権限を制限します。
- 訂正手順: 差し替え済みのレポートに印を付け、影響を受ける受信者に通知します。
- エスカレーションルール: データが不完全な場合に公開を止めるかどうかを、誰が判断するかを定めます。
たとえば、取引先が在庫残高に異議を唱えたとします。スナップショットとクエリが保存されていれば、アナリストは、レポートが輸送中の商品を除外していたのか、古い倉庫フィードを使っていたのかを追跡できます。作業は、メールの添付ファイルを探し回ることではなく、計算を再現することになります。
公開ルール: 入力が欠けている場合は、もっともらしい説明を作らず、目に見える例外として表示します。
鮮度は独立してチェックすべき項目です。データの適時性を監視する方法を確立し、一見最新に見えるレポートが古いソースフィードを隠していないようにしましょう。
プライバシーに関する注意:顧客・従業員の記録には、ロールベースのアクセス制御と、共有する出力での個人情報フィールドのマスキングが必要です。ソースを接続する前に、適用される各地域のデータ保護規則を確認し、保持するのは必要最小限にとどめてください。レポートの管理策は財務・コンプライアンス業務を支援するものであり、専門家の助言に代わるものでも、貴社の法的義務を決定するものでもありません。
最初に自動化するレポートを選ぶ
読み手が信頼するのは、中身を確認できる自動生成の成果物です。機械が作成したと示すラベルは、読み手が本当に知りたいこと、つまり何が検証され、誰が責任を負い続けるのかという問いには答えていません。この説明責任は、最後にレビュー工程を付け足すのではなく、グラフやコメントと同じように、自動化の仕組みそのものに組み込みましょう。
レビューの労力は影響の大きさに合わせる
レビューの労力は、生産ラインの検査に似ています。通常の部品はサンプリング検査で済ませ、安全に関わる部品は毎回検査します。レポートにも同じ考え方を当てはめ、数値が誤っていた場合の影響の大きさに応じてレビューの強度を決め、そのうえで自社の義務や入力データの信頼性に合わせてポリシーを調整してください。
レポートの種類別レビューレベル
レポートの種類 | 公開ルール | レビュー担当 |
|---|---|---|
売上合計や在庫数など、変動の少ない記述的な指標 | チェックに合格後、自動で公開 | 例外のみ |
異常値の説明とトレンドに関するコメント | 配信前にアナリストがレビュー | アナリスト |
予測およびシナリオの前提条件 | アナリストが前提条件をレビュー | 財務責任者 |
与信、雇用、コンプライアンス、顧客の適格性に影響するレポート | 監査証跡を伴う承認が必須 | 責任を負うマネージャー |
自動公開は、実証された信頼性があって初めて認められます。パイロット期間中は、出力を承認済みのベースラインと比較し、相違点をすべて調査してから、レビューを緩和してください。
候補となるレポートを、頻度、担当者の作業時間、ミスのコスト、顧客や規制当局が依拠しているかの4つの観点で順位付けします。定義が安定している週次の社内営業ダッシュボードは、最初の対象として適切です。頻繁に作成されるため実際の工数を削減でき、ミスがあっても目に見えやすく、修正のコストも小さいからです。一方、与信審査レポートは対極に位置します。その結果が顧客に直接影響するため、最初から承認を必須とする必要があります。
主なポイント
- 範囲を絞ったパイロットを選ぶ:入力データと定義が把握できている、定期的な社内レポートから始めます。
- 現在の作業量を測定する:自動化の前に、作成、レビュー、修正にかかる時間を記録します。
- リリース条件を定める:どのチェックに失敗したら配信を止めるのか、誰が解決するのかを定義します。
- 根拠を参照しやすくする:レビュー担当者が、別途調査を依頼しなくても裏付けとなる記録を確認できるようにします。
中小企業向けのAI搭載データ分析プラットフォームであるELECTEは、このアプローチを実践するための選択肢の一つです。データの最新の状態から、週次、月次、または取締役会サイクルに合わせたレポートを自動生成します。グラフ、コメント、前回からの変更点も含まれます。
ELECTEのほとんどのユーザーは5分以内に利用を開始でき、会計ソフトを接続するかファイルをアップロードすると、分析と初期予測が始まります。ただし、セットアップが速いからといって、レポートの定義を検証する必要がなくなるわけではありません。2025年の事例では、あるフィンテック企業がELECTEを使って財務レポートを自動化し、リアルタイムの規制順守を確保したと紹介されています。それでも、必要なレビューの範囲は、レポートが支える意思決定によって変わります。
まずは、自信を持って確認できるレポートから始めましょう。適切に行えば、レポートの自動生成によって、繰り返しの組み立て作業が減り、例外が明確になり、責任者が説明できる根拠が残ります。
ELECTEは、接続したビジネスデータを、レビュー担当者が確認・共有できる定期レポートに変えます。ELECTEにアクセスして、グラフ、コメント、前期からの変更点を含む定期レポートが、お客様のデータでどのように機能するかをご確認ください。
コメント
まだコメントはありません — 会話を始めましょう。