AI 與數據分析:成長型企業的實用指南
了解 AI 與數據分析如何自動化報表、發現規律並預測需求,另附一套實用的成效衡量方法。

整體採用率在短短一年內從 55% 升至 78%,而至少在一項業務職能中使用生成式 AI 的比例,也從 33% 升至 71%(Stanford AI Index)。回報的成長則慢得多。同一份指數報告發現,多數企業回報的成本節省仍低於 10%,營收增幅則多半低於 5%。
這個落差之所以重要,是因為數據分析就像一個指南針,能幫助管理者看清企業過去走到哪裡,以及目前的數字透露了什麼。AI 則多加了一層:在兩次會議之間持續觀察、比對、摘要與預測。真正有用的成果,並不是一個為了炫技而存在的模型,而是讓某個決策更容易做出,也更容易向他人說明。
採購一個平台是最容易的部分。更難的是改變週一的進貨訂單、現金計畫或價目表的內容,而價值正是在這裡顯現。如果沒有人用預測結果來決定補貨,那它仍然只是一張圖表。若警示在發薪作業之後才送達,雖然有意思,卻已經太遲。
請把 AI 數據分析視為一項受到管控的營運投資。選定一個可衡量的工作流程,記錄基準值,再依該流程是否改善來評斷工具。輸出結果必須可稽核,讓財務主管、營運經理或董事會成員都能看出用了哪些數字,以及結論是如何得出的。模型有多精密並不是重點,可重複執行的決策流程才是。
接下來的內容將說明:AI 加入數據分析後有什麼改變、哪些功能值得付費、它們在零售、金融與中小企業中如何帶來回報、如何在單一工作流程上證明投資報酬,以及在最初的熱度消退後,如何讓洞察持續保持可稽核。
為什麼企業現在要結合 AI 與數據分析
採用只是比較容易的那一半。工具買了、試點專案有了預算、儀表板也有了登入帳號。更難的問題是:當某人在週二下午必須決定要補多少貨時,究竟有什麼改變?
Stanford 的 AI Index 讓我們得以客觀看待這些回報。報告指出,服務營運、供應鏈管理、行銷、銷售與軟體工程都出現了成效,但最常見的成本節省仍低於 10%,最常見的營收增幅則低於 5%(Stanford AI Index)。使用範圍廣,回報卻很薄。這個現象正說明了為什麼應把數據分析視為受管控的投資,而不是一次性採購。
實際差異很直接。傳統數據分析回答的是發生了什麼事、為什麼會發生,通常要等有人提問才會進行。AI 則多了一層:不必有人詢問,它也會持續觀察,從成千上萬列資料中找出規律、向前推估,並在數字偏離正常範圍時發出警示。資料相同,節奏不同。
只有當輸出結果送到由某個人負責的決策上時,價值才會出現。沒有人用來調整進貨訂單的預測,只是一張圖表,而不是收益。不妨把這個工作流程想成一條生產線:原始數據投入後,唯有當有人負責下一步行動、執行時機,以及確認數字依然合理的檢查,價值才會產出。
各行業的採用程度差異很大,因此在拿自己的位置與頭條數字比較之前,請先比較各行業的 AI 採用率。成長型企業可以從一個可衡量的工作流程著手,設定基準,並讓成果保持可稽核。ELECTE 這類平台(一個能自動分析數據並為成長型企業製作視覺化報告的 AI 財務預測平台),正適合這種做法:目標是改善現金流、薪資、需求或董事會報告,而不是追求模型的精密程度。
AI 如何逐項改變數據分析能力
傳統儀表板就像後視鏡。它能準確而詳細地告訴你過去發生了什麼,但前提是你主動去看。AI 分析則更像煙霧偵測器:持續監控,不需要你開口詢問,一有變化就發出警報。
實用的思考模型:儀表板負責報告,受監控的系統會主動打斷你。多數團隊兩者都需要,但只有後者能在還來得及採取行動時發現問題。
每個 AI 分析平台內的三個層次
現代平台結合了三個不同的層次。統計建模負責衡量與推估,為預測加上信賴區間。機器學習同時掃描多個變數,依行為而非人工撰寫的規則將紀錄分組。自動化代理則接手這些輸出,將其轉化為定期報告、警示與白話回答。
這種組合並非憑空出現。NIST 對此領域的梳理,從 1950 年代的符號邏輯,經過專家系統與統計式機器學習,一直延伸到今日的深度學習,這也是為什麼一個可用的平台會融合統計、機器學習與自動化,而不是只選其中一種(NIST)。
傳統分析與 AI 強化分析並列比較
功能 | 傳統分析 | AI 增強分析 | 對您的改變 |
|---|---|---|---|
報表 | 分析師手動製作月報 | 報表按排程自動產生並更新 | 團隊每月都能省回數小時 |
異常偵測 | 事後才有人發現數據激增 | 模型依據學習到的基準線標示偏差 | 問題當天就能浮現 |
預測 | 試算表趨勢線或憑直覺 | 以歷史數據、季節性與驅動因素訓練多個模型並相互比較 | 新數據一到,預測隨即更新 |
模式發掘 | 分析師一次只能驗證一個假設 | 演算法同時掃描大量變數與組合 | 過去沒人想到要測試的關聯得以顯現 |
回答問題 | 排隊等候數據申請 | 以白話提問,直接從數據中得到答案 | 主管無需等待分析師即可獲得答案 |
監控 | 定期檢視關鍵數字 | 持續監看,並在達到設定門檻時發出警示 | 對庫存、現金與風險提前預警 |
這張表反映的是時機與規模的轉變,而非決策權的轉移。分析工作從定期、手動,轉為持續、自動。決策權則維持原狀,仍掌握在了解客戶、供應商與利潤的經理人手中。
關於這點,有兩項實務提醒。不想自行搭建底層資料管線的團隊,往往會在選定平台之前先了解 Ekipa 的數據顧問服務,因為真正困難的通常是資料串接,而不是模型選擇。另外,當輸出結果是圖表時,主要的限制就變成選擇合適的圖表格式,因為預測曲線與分布圖對同一位經理人傳達的是不同的訊息。
四大能力及其各自的限制
- 自動化。輸入是來自 POS、ERP、銀行資料串流或試算表的原始匯出檔;輸出是按時產生、已清理、已比對、已更新的報表。其限制毫不留情:輸入品質差,輸出品質仍然差,而且自動清理步驟可能會漏掉資料列。假設一家零售商的每日銷售檔案以三種不同的日期格式送達,自動化會將其統一,讓週一的庫存報表在下訂單前就緒;但如果某間門市的檔案被截斷,報表看起來正常,內容卻是錯的。
- 模式偵測。輸入是交易或客戶歷史紀錄;輸出是相似客戶或產品的分群,以及針對異常退款、發票或交易的異常標記。限制在於基準線,也就是該指標在每年同一時期近期的正常範圍。當正常範圍本身發生移動,就是出現了漂移。在基準線學會區分十二月與三月之前,季節性高峰看起來會像異常。試想一家零售商突然發現某條產品線的退貨量增加到三倍:模型會發出標記,而由人來判斷這是批次瑕疵,還是尺寸表的問題。
- 預測。輸入是歷史資料,加上季節性與已知驅動因素,例如價格調整或促銷活動;輸出是帶有區間的預測值,透過比較多種方法並保留表現穩定者而得出。限制在於穩定性。預測的可靠度取決於它所學習的條件,因此新的供應商條款或隔壁新開的競爭對手,都會使預測失效。
- 代理式分析。輸入是已連接的資料與排程;輸出是擬好的摘要、對本週的文字說明,或是對「哪個地區放緩了」這類白話問題的回答。限制在於驗證:結論在進入董事會文件之前,仍須對照原始資料核實。
這四項能力以循環方式運作的效果,比當作選單更好。自動化讓資料保持最新,模式偵測與預測產生候選訊號,代理負責解釋,監控則確認後續採取的行動是否成功。
零售、金融與中小企業的商業應用
在經濟合作暨發展組織(OECD)會員國中,11.9% 的小型企業和 20.4% 的中型企業使用 AI,大型企業則為 40.1%(OECD)。差距不在於認知,而在於預算、技術人員,以及把模型接入既有工作流程的能力。
成長動能確實存在。OECD 2025 年 D4SME 調查發現,39% 的受訪中小企業在核心業務活動或產品中使用 AI 應用,高於 2024 年的 26%,不過該樣本並不代表參與國家的所有中小企業(D4SME 政策重點)。
下方的對照表顯示這些系統在哪些場景能發揮價值,以及各系統需要先具備哪些條件。
功能 | 回答的問題 | 所需資料 | 典型產出 | 注意事項 |
|---|---|---|---|---|
零售庫存 | 哪些產品會在未來四週內缺貨? | 銷售紀錄、庫存水準、供應商交貨前置時間 | 附預測區間的補貨清單 | 歷史資料很少的新品線 |
促銷活動 | 上個月的折扣是提升了利潤,還是只提升了銷量? | 交易紀錄、促銷日曆、價格 | 各項促銷的預估成效提升幅度 | 促銷檔期重疊會模糊成效 |
現金流 | 現金何時會跌破安全水位? | 應收帳款、應付帳款、發薪日期 | 每週現金預測 | 延遲付款會影響每一個項目 |
財務風險與法遵 | 哪些交易應優先審查? | 交易紀錄、客戶檔案、監控名單 | 依優先順序排列的警示佇列 | 誤報需要調校 |
銷售與需求 | 哪些地區或通路的銷售正在放緩? | CRM 銷售管道、訂單紀錄 | 依客群區分的趨勢警示與預測 | 銷售管道資料輸入不一致 |
行銷成效 | 哪些內容或通路能帶來合格潛在客戶? | 行銷活動與網站分析數據 | 各通路成效排名 | 不同歸因模型的結論不一致 |
營運與成本 | 哪個成本項目的成長速度超過營收? | 發票、薪資、營運費用 | 成本趨勢與異常警示 | 季節性成本可能被誤判為異常 |
如果您想進一步了解其他團隊在正式環境中實際運行哪些應用,可以瀏覽即時數據分析應用,看看類似的問題如何透過串流數據找到答案。
兩個說明性情境
假設一家區域零售商透過八間門市和一個倉庫銷售商品。系統每週依據現有庫存和供應商交貨期,更新一次為期四週的需求預測,結果顯示兩款暢銷品項將出現缺貨,比空貨架提醒任何人整整早了三週。這就是價值所在:同樣的資訊,更早送達。這只是一個情境,並非保證的成果,而且完全取決於庫存記錄是否準確無誤。
再假設一家服務公司的帳款期限為 45 天,並在每月 28 日發放薪資。每週現金預測會結合應收帳款帳齡、應付帳款和發薪日期,標出餘額跌破安全線的那一週,讓負責人有兩週時間去催收兩筆最大的逾期發票,或延後一項採購。洞察本身並不驚人,但時機的價值很大。
請從單一錯誤決策代價最高的地方著手,無論是在淡季前庫存過剩,還是太晚才發現未付款的發票。對財務團隊而言,在選定起點之前,值得先了解財務分析如何改善預測的運作機制。
如何衡量 AI 分析是否物有所值
價值衡量在導入軟體之前就已開始。英國政府研究發現,71% 尚未採用 AI 的企業,並未找到合適的應用情境,另有 60% 表示 AI 技能或專業知識有限(英國 AI 採用研究)。如果說不出是哪個工作流程,也就說不出要看哪個指標。2025 年一項全球調查從另一個角度印證了這一點:超過 97% 的機構表示難以證明生成式 AI 的商業價值(Deloitte)。
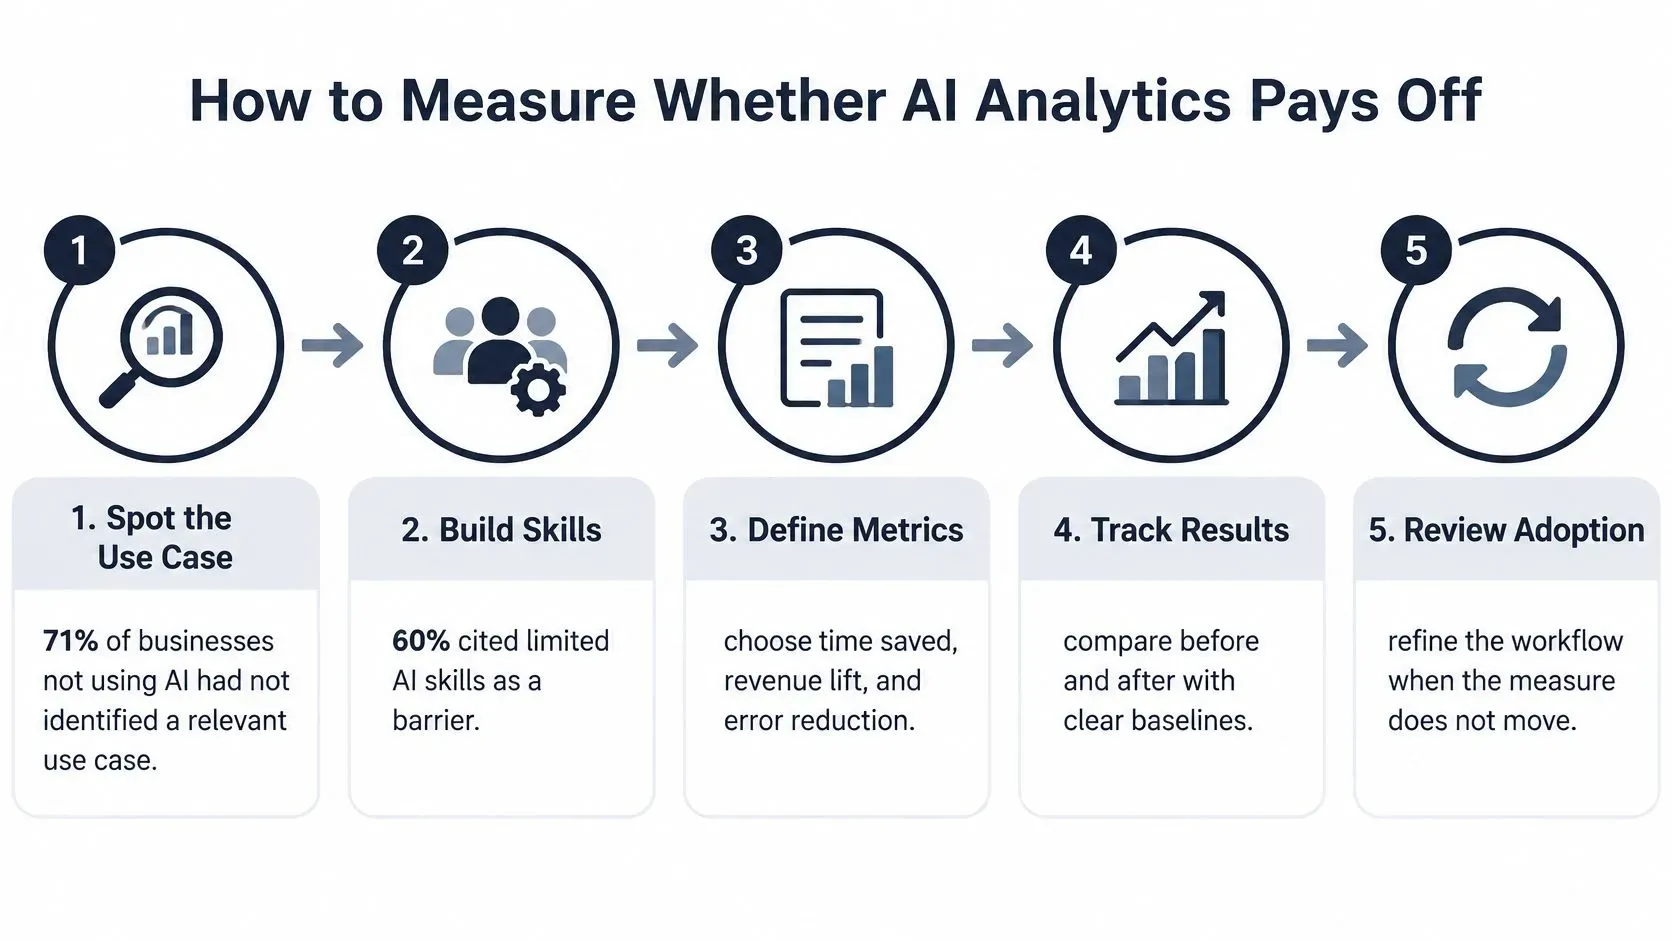
請將 AI 分析視為受到管控的營運投資。重點不在於模型聽起來是否令人印象深刻,而在於某一個可衡量的工作流程是否相較基準有所改善,以及這些洞察日後能否被檢驗。不妨想像開闢一條新的配送路線:您需要舊的配送時間、新的配送時間,以及能解釋為何其中一條路線更快的依據。
以下步驟可以幫助您得出站得住腳的答案。
- 選一個成本清楚可見的工作流程。庫存補貨、發票審核、促銷分析或異常分流都適合。原因在於範圍:流程聚焦,幾週就能完成一輪完整的衡量,而不是幾個季度。
- 先記錄數週的基準數據。投入工時、預測誤差、庫存天數、報廢損失和逾期發票都是不錯的起點。沒有起始數字,表現好的一個月會被當成大獲全勝,表現差的一季又會被當成徹底失敗,兩者都說明不了任何事。
- 訂出兩到三項管理者願意接受為證明的成果指標。常見的例子包括節省時間、降低錯誤率、釋放營運資金和避免損失。挑出在會議上足以平息爭論的兩三項,其餘儀表板數據可以不理會。
- 設定對照組。可以針對不同品類,讓新舊流程並行運作;也可以與去年同期及類似團隊作比較。這是大家最常跳過的一步,卻是區分工具本身成效與外部環境影響的唯一方法。
- 把 AI 的效果與季節性因素區分開來。檢查改善是否能在數個週期內持續,以及在你沒有調校的區段是否同樣出現。如果變化只出現一次、只在十二月、只在你手動調整過的那個品類,就不能算證據。
- 計算回收期。將節省的時間與避免的損失相加,再減去新流程所需的覆核時間和平台成本。覆核時間是多數商業案例漏掉的一項,卻可能成為最大的隱藏成本。
無法拿來對照的試點,只是時間線拉得更長的示範而已。
要知道什麼時候不該自動化。凡是涉及重度法規要求、歷史數據不足或後果無法挽回的決策,仍需由指定的負責人簽核。把這一點明說出來,反而能保護專案:承諾了卻無法自圓其說的回報,比一個保守但站得住腳的數字更損害信譽。想了解各團隊在實務中如何設定這些基準,可參考十個 AI 數據分析的真實案例,拿來對照自己的數字會很有幫助。
讓 AI 洞察保持準確且可稽核
AI 分析系統是正式上線的生產系統,不是建好之後只供欣賞的模型。NIST 將可靠性定義為在特定條件下、於規定期間內無故障地達到要求的能力;對已部署的 AI,則將有效性與可靠性視為必須透過持續測試與監控來評估的事項(NIST)。
這會讓準確度成為一項日常營運工作。請持續追蹤預測誤差、誤報與漏報、解釋品質、延遲、故障頻率和恢復時間。這些指標就像送貨車上的儀表:單次順利出車說明不了什麼,但若出現一再延誤、油耗上升或漏跑路線的規律,就能看出系統哪裡需要關注。輸入模式改變,模型的有效性隨之減弱,監控發現下滑後,再透過重新訓練、調整閾值、人工審核或安全備援方案來恢復表現。檢視頻率應與風險高低相符。庫存補貨預測可以每週檢查一次,合規警示佇列則需要更嚴密的監督。
決定信任的界線
AI 輔助的工作在系統經過驗證的任務範圍內表現良好,超出範圍則明顯變差。在一項針對 700 多名顧問的對照研究中,參與者在 AI 能力邊界之外使用 AI 時,表現平均低了 19 個百分點(MIT Sloan)。
這項結果之所以重要,是因為能力邊界很容易被模糊。根據明確定義的營收、預測和競爭對手資料來準備董事會簡報的工具,與被要求判斷歷史資料稀少的全新市場的工具,做的是不同的工作。前者有清楚的輸入軌跡和可重複的輸出;後者則需要更多判斷、更多背景脈絡,以及能夠質疑結論的人。
設計上的啟示很簡單:將低信心的預測、異常紀錄,以及超出已驗證範圍的建議交給人來處理,並把證據和不確定性直接顯示在洞察旁邊,而不是藏在點擊之後。治理在這個交接環節中才真正落地。如果主管看不到建議是依據哪些資料、資料何時更新、系統有多大把握,那麼這項建議只是要求信任,卻沒有給讀者任何可供檢驗的依據。
症狀 | 可能原因 | 解決方法 |
|---|---|---|
價格調整後,預測出現嚴重偏差 | 輸入模式已改變,模型從未見過新的情境 | 以近期資料重新訓練,並將該變動標記為已知的斷點 |
每逢星期一警示數量暴增 | 正常的每週規律被當成異常 | 在基準中加入季節性因素,並檢視門檻設定 |
儀表板總數與財務報表不一致 | 來源資料表或指標定義不同 | 每項指標指定一位負責人,並記錄其定義 |
主管不信任某項建議 | 洞察結果缺乏佐證依據 | 在每項洞察旁顯示來源資料、更新時間與信賴度 |
在某個地區準確,在另一個地區表現不佳 | 歷史資料不足,或購買模式不同 | 依區隔測試表現,並將表現較弱的區隔轉交人工審核 |
警示數量讓團隊疲於應付 | 門檻設得太低 | 追蹤誤報率,並每月調整門檻 |
這張表點出一個更普遍的規律:準確度問題通常有很平常的成因。價格調整、每週的銷售節奏、不一致的指標定義,或是稀疏的區域數據,都可能讓系統看起來不可靠。請把每個症狀都當作診斷訊號。在改動其他任何地方之前,先判斷問題出在數據、定義、閾值還是模型。
一句話說明治理:每個指標一位負責人、一份有文件記錄的定義、一個可見的數據來源。
再加上能避免大多數爭議的基本做法:依權限控管存取,讓財務、零售和營運各自只看到其角色允許的內容;記錄每項建議及採取行動的人員;並在每份報告上顯示數據來源的更新時間。自動化警示是為財務與合規決策中的專業判斷提供支援,而不是取代判斷。
有治理的架構也能讓稽核軌跡保持易讀。當預測發生變化時,團隊應能回答:什麼變了、誰審閱過、後續做了什麼決策。當輸出會用於月結、董事會資料、現金規劃或競爭對手簡報時,這種紀律比模型的複雜程度更重要。只要一個可衡量的工作流程具備基準線、指定負責人,以及管理者可以查閱的紀錄,這項投資就會開始產生回報。
重點整理與本季度的第一個工作流程
麥肯錫2025年全球調查發現,88%的受訪者表示其組織至少在一項業務職能中經常使用AI,高於前一年的78%,但只有39%表示對企業整體EBIT有影響;另有23%正在擴展代理型(agentic)系統,39%已開始試驗(McKinsey)。
使用普及,但對企業整體的影響有限。零星的成功本身不會累積成成果。請把AI分析視為一項受治理的營運投資,更像是建立可靠的報告流程,而不是買一個更漂亮的儀表板。當一個可衡量的工作流程有了基準線、負責人和可重複的審閱步驟,價值才會顯現。
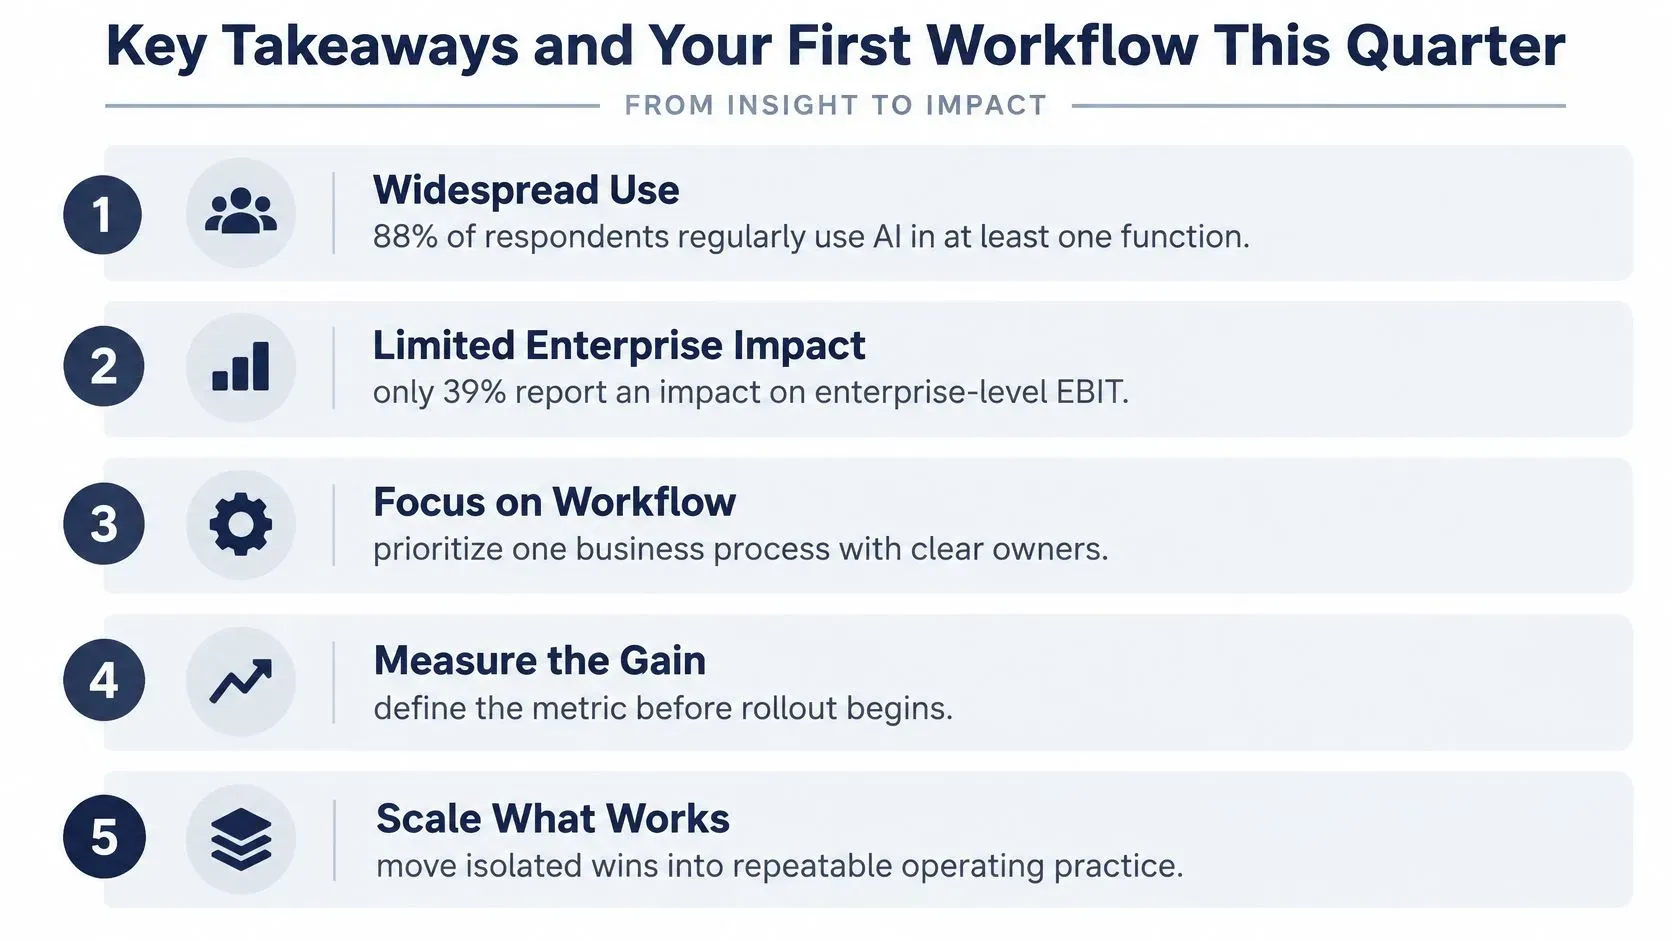
縮小落差的檢查清單:
- 一個職能,一個問題。選擇一個能回答你們早已在爭論的問題的工作流程,例如現金預測為何變動,或哪個KPI在月結前出現變化。
- 先建立基準線,再做改變。在工具動到任何東西之前,先把起始數字寫下來。基準線就像門框上的身高刻痕:沒有它,成長只能靠猜。
- 管理者認可的指標。選兩到三個,依其能否促成決策來決定。例如,規劃用預測準確度,財務審閱用差異說明,儀表板的可信度則看數據來源的更新時間。
- 高影響決策由人工審閱。定價、信貸和合規都應有指定負責人。AI可以準備證據,由負責人決定哪些行動可以接受。
- 定義與監控。記錄指標定義,並定期檢查準確度。一個KPI若有兩種定義,就會產生兩個版本的現實,因此定義應該放在數字旁邊。
Stanford 的 AI Index、OECD 和 NIST 都指向同一個方向:工具已經隨處可得,稀缺的是紀律。ELECTE 是一個 AI 財務預測平台,能自動分析數據,並為成長中的企業製作視覺化報告。它的 AI Agent 可依排程或按需求讀取數據、撰寫報告、研究市場,全天候運作。因此,它很適合用於第一個受管控的工作流程,前提是團隊要讓基準線和審核步驟保持清晰可見。
第一季度一個實用的選擇是月結作業。ELECTE 可串接銷售、財務和營運數據,並支援自動化報告與董事會資料包、現金流、薪資和需求預測、KPI 儀表板,以及在需要有來源依據的市場簡報時提供競爭對手分析。其 Business 方案包含用於自動化報告和競爭對手分析的 AI Agent、AI 驅動的預測、無限數據歷史記錄、進階整合,以及現金流預測。這讓工作流程有了清楚的界線:選定一項決策,記錄起始狀態,執行報告,與基準線比較,並將證據與結果一併保存。
從小處著手,小到答案可以被檢驗。如果團隊需要的是一個更準確的預測、一份更快完成的董事會資料包,或一個更清晰的 KPI 視圖,就能證明價值,而無須顛覆整個分析架構。請前往 ELECTE 比較 Starter 和 Business 方案,並在本季度從單一工作流程開始。
留言
尚無留言——開始討論吧。