庫存預測方法:預測需求的 5 種方式
探索 5 種經實證有效的庫存預測方法,了解各自的運作原理與適用時機。比較不同做法,為您的業務選出最合適的一種。

訂貨過多,現金就會流失;訂貨過少,客人就會轉向有貨可賣的對手。每一家持有庫存的企業,都夾在這兩種失誤之間,而兩者的差距,取決於一個決定:您的採購訂單背後,用的是哪一種庫存預測方法。
如果問一屋子的營運人員用哪種方法,得到的答案多半是產品名稱:一份試算表、一個 ERP 模組、財務部門買來的某個附加工具,卻沒有人說得出背後的算法。這正是值得補上的缺口。預測工具只是方法的載體,而方法決定了您的安全庫存,究竟是依現實設定,還是出於一廂情願。
以下五種庫存預測方法,是以階梯式的決策思路來呈現,而不是彼此對立的陣營。每一種方法,都是下一種必須超越的基準。針對每一種,您會了解它需要什麼條件、在哪裡會失效,以及它在什麼確切情況下最能發揮價值。
1. 移動平均預測
移動平均是常見的起點,也當之無愧。您選定一個時間窗口(3、6 或 12 個週期),把窗口內的實際需求取平均,作為下一期的預測值。每當一個新的週期結束,窗口就向前滑動,數字也隨之自動更新。
阿肯色大學的一項供應鏈研究指出,時間序列預測是大多數補貨系統的基礎,目的是在銷售雜訊之下找出趨勢與季節性。移動平均做的是這項工作的最簡單版本:不需要建立模型,就能濾除一次性的突發高峰。
簡單窗口與加權窗口
簡單移動平均對每個週期給予相同權重。加權移動平均則讓近期週期的影響更大,當需求正在上升或下降、而非維持平穩時,這一點特別重要。如果上個月比上一季更能反映下個月的情況,就選用加權方式。
舉例來說,一家網上文具店取最近三個月的筆記本銷量平均值,為穩定銷售的產品線設定補貨點;一家麵包店則在每週一取過去四週的麵包銷量平均值,來決定麵粉的訂購量。方法相同,窗口不同,兩者都容易向採購人員解釋清楚。
在選定窗口長度之前,先用過去十二個月的數據測試三種不同長度。表現最好的窗口,通常比直覺判斷的更短。
- 與簡單基準比較:如果直接用上一期銷量作預測,效果與您的平均值相當,那麼平均法就不值得多出的複雜度。
- 搭配安全庫存:平滑處理只是把高峰從預測中去除,並沒有從需求中消失。
- 區分產品系列:筆記本與季節性手帳不應共用同一個窗口。
適用情境:商品銷售穩定、至少有六個完整的乾淨期間歷史資料,而且你需要一個任何利害關係人都看得懂的基準值。這也是之後每一種方法都必須超越的數字。零售業者的 30 天庫存試點顯示,這類基準值能多快找出哪些 SKU 需要比平均值更精細的預測。
2. 指數平滑法(Holt-Winters 方法)
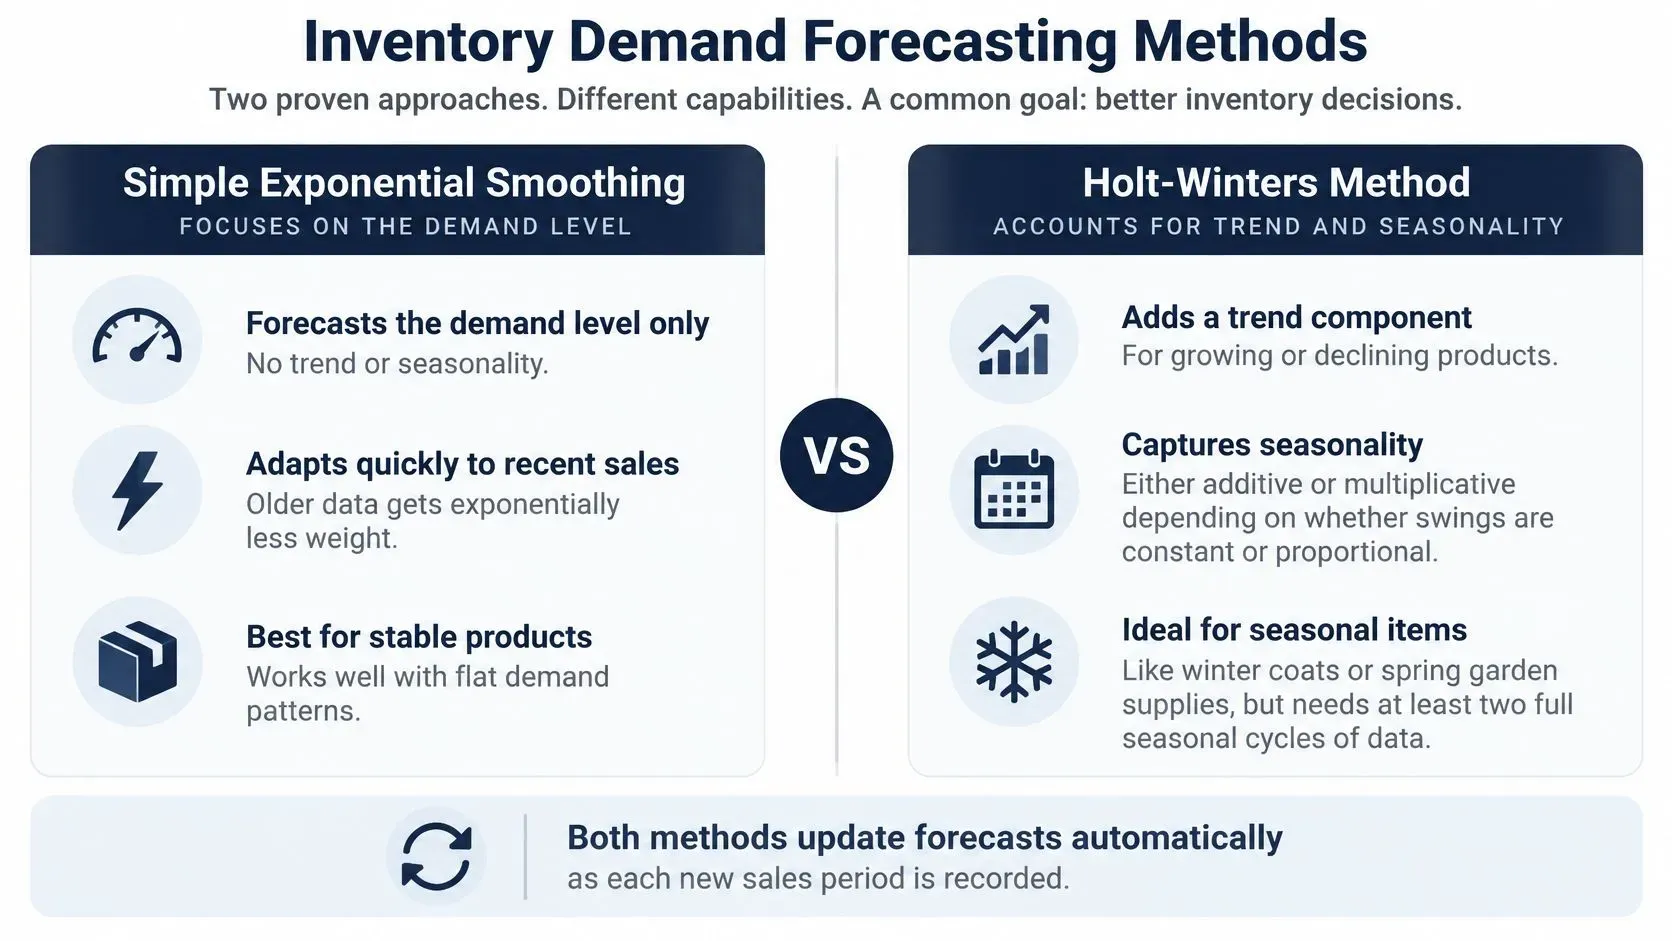
指數平滑法保留了平均的做法,但不再把新舊資料一視同仁。每筆觀測值的權重會隨時間以指數方式遞減,因此預測會朝向當下的趨勢調整,又不會因為某一週的異常而反應過度。
Holt-Winters 增加了兩個成分:趨勢項和季節項,並依季節性波動是否隨銷量放大,採用加法或乘法形式。這也是季節性零售商品目錄多半採用此方法的原因。
為什麼準確度的影響更大
加重近期資料的權重可以提升反應速度,但反應速度也有代價。一項批發與庫存控制研究的綜述引述 Syntetos 等人的發現:在維持相近服務水準的前提下,預測準確度每下降 1%,庫存成本可能增加 10-15%。參數設得太慢,需求轉變時你會庫存過多;設得太快,又會把雜訊當成訊號,引發長鞭效應。
以下三個習慣能讓模型保持可靠:
- 至少兩年資料:至少提供兩個完整的季節週期,否則季節成分只是在猜測。
- 檢查最佳化結果:讓軟體求解平滑常數,再確認季節形態是否符合你實際經歷的那一年。
- 將促銷標記為事件:如果讓為期三週的活動混入歷史資料,基準值會被扭曲好幾個月。
適用情境:需求具有重複出現的季節形態,而且你能提供兩個乾淨的週期。想了解平滑模型在實務上如何執行與比較,請閱讀以平滑模型預測違約率。
3. ARIMA 與 SARIMA 時間序列模型
平滑法把歷史視為加權平均。ARIMA 則對同樣的資料提出更難的問題:今天的需求是否取決於昨天、去年同一週,以及模型先前犯下的誤差?差分步驟會對序列逐次取差,直到趨勢趨於穩定;SARIMA 則加入季節項,處理每週與每年的週期。Holt-Winters 給你的是一條更平滑的曲線,ARIMA 給你的則是需求過程本身的模型。
預測值周圍的區間,才是真正有價值的輸出。
區間勝過單一數字
一項補貨優化研究將 SKU 需求、退貨前置時間與補貨前置時間視為隨機變數,採用分位數預測而非單一估計值,並提出「預測不確定性比率」(Ratio of Forecast Uncertainty),用來追蹤不確定性如何在供應鏈各階段之間傳遞。這個區別在下採購單時至關重要。預測 1,000 件,合理區間是 850 至 1,150 件,與區間是 500 至 1,700 件,意義截然不同。
兩位採購人員看同一份預測,可能做出相反的決定。一家區域性連鎖超市同時以每週與每年的季節性為每週乳製品需求建模,讓節慶旺季反映在訂單中,而不是事後才補上。一家電子產品經銷商則依服務水準目標,以預測區間的第 90 百分位數設定零組件安全庫存,而不是固定備足兩週用量。使用相同的工具,面對的是不同的政策問題。
要用好這個方法,需要紀律:
- 檢驗平穩性:先看圖,再做正式檢定,然後只在必要範圍內進行差分。過度差分會引入雜訊,模型還得再去解釋這些雜訊。
- 保留最近三個月作為驗證資料,在採信模型之前先在這段期間評分。
- 將區間轉化為政策:依據利潤、現金狀況與服務承諾,選擇合適的百分位數。
- 大型商品目錄應自動選擇模型。400 個 SKU 的訂購參數,靠人工調整行不通。
代價是投入的心力。ARIMA 需要平穩的資料、謹慎的階數選擇,以及足夠的歷史資料來估計季節項,而且它仍然只讀取數列自身的過去。這使它成為因果方法必須超越的基準:價格或促銷等驅動因素,只有在預測表現優於需求自身歷史時,才值得納入模型。
當您的數列帶有平滑法無法捕捉的自相關,且需要一個可靠的區間,依服務水準目標來設定安全庫存時,就適合使用此方法。
4. 因果迴歸預測
到目前為止,每種方法都是從需求自身的歷史推導需求。因果迴歸問的是另一個問題:什麼在推動需求,影響程度有多大?您輸入團隊已在追蹤的驅動因素,例如價格、折扣幅度、促銷、假日、天氣與競爭對手動態,模型會估算每項因素帶來的提升幅度。
輸出的是一個可以拿來討論的係數,這正是重點。折扣不只是拉高預測值,而是以明確的幅度拉高,而這個幅度正是採購單所需要的。
將促銷日曆納入模型
假設一家家居用品零售商想知道,八折優惠加上週末電子郵件行銷活動,會如何影響廚房家電的銷量。迴歸模型會估算兩者的合併效果,讓採購人員針對規劃中的活動下單,而不是依據去年的月平均值。一家飲料經銷商若納入氣溫預報,就能在熱浪來臨前先行備貨,而不是事後被動應對。
實務原則:在驗證期間一次只測試一個驅動因素。若某個因素無法提升模型對未見資料的準確度,那只是一個說法,而不是訊號。
- 從已記錄的資料著手:促銷標記、價格變動和假日日曆。許多團隊手上可用的驅動因素,比自己以為的還要多。
- 更新係數:價格調整或新競爭者進場後,客戶的反應會改變,而過時的係數可能導致庫存過剩。
- 區分計畫內與計畫外因素:行銷活動作為輸入變數;爆紅貼文或缺貨後的補貨回補則作為事件標記。
當促銷與定價帶動了大部分銷量,且你需要在活動開跑前而非結束後就為活動備貨時,適合採用這種方法。
5. 機器學習需求預測
機器學習改變了建模的單位。你不再為每項產品各自建立一個模型,而是跨數千個 SKU 與門市的組合訓練單一模型,讓它學習共通的規律:哪些商品受天氣影響、哪些受發薪週期影響、哪些受兩週前促銷的影響。
梯度提升(gradient boosting)處理表格型銷售資料的表現很好。當商品目錄龐大、訊號之間的交互作用又無法靠人工定義時,神經網路才能發揮價值。
準確度之爭變得複雜的地方
一項評估 7,500 條需求序列與 13 種預測方法的研究發現,預測精準度的價值取決於產品特性、庫存策略、持有成本、缺貨損失成本、盤點週期與前置時間。該研究也指出,即使有大量間歇性訂單,製藥業的中小企業仍常依賴判斷式預測,原因包括歷史資料不準確、專業人員有限,以及技術採用率偏低。
對於追逐排行榜的人來說,這個結論並不好受。當持有成本低、缺貨代價高時,在誤差指標上勝出的模型,可能在成本上反而落敗。而在間歇性商品上看似表現優異的方法,也可能只是因為大多數期間的需求為零,才得到高分。
- 先打敗基準線:移動平均或 Holt-Winters 就是你的對照組。如果機器學習在保留資料上無法勝過它,就不要上線。
- 依時間驗證,而非隨機抽樣:用較早的期間訓練,用較新的期間測試。
- 按分群評分:前 50 大 SKU 的誤差,比長尾商品的誤差更重要。
- 單獨處理間歇性需求:零值偏多的商品需要自己的評估規則。
ELECTE 是專為中小企業打造的 AI 數據分析平台,會在你的資料上執行六種預測方法,彼此比較評分,並選出最準確的一種,取代人工逐一比拼的流程。若你的商品目錄以促銷為主,請參閱如何應對限時搶購的需求高峰。
當你擁有涵蓋多項產品的完整詳細歷史資料,並有證據顯示它在成本與服務水準上(而不只是紙面數字)勝過你的基準線時,適合採用這種方法。
5 種庫存預測方法一覽
方法 | 最適用情境 | 所需資料 | 能否處理季節性 | 難度 |
|---|---|---|---|---|
移動平均預測 | 需求穩定及簡單的基準預測 | 少量近期銷售紀錄 | 否 | 容易 |
指數平滑法(Holt-Winters 方法) | 具趨勢與季節性規律的需求 | 至少兩個季節週期的銷售資料 | 是 | 中等 |
ARIMA 與 SARIMA 時間序列模型 | 具自相關性及時間規律的需求 | 長期且乾淨的歷史時間序列 | 使用 SARIMA 可處理 | 進階 |
因果迴歸預測 | 預測促銷、價格及其他驅動因素的影響 | 銷售紀錄及可靠的驅動因素資料 | 加入季節變數後可處理 | 中等 |
機器學習需求預測 | 需求驅動因素複雜的大型商品目錄 | 大量且乾淨的銷售紀錄及相關輸入資料 | 是,需加入日曆或季節特徵 | 進階 |
重點摘要:依據數據條件選擇預測方法
把每一個層級都視為下一個層級必須超越的基準。移動平均法成本低、過程透明,因此它設定了後續每個模型都必須改進的數字。當相同的季節性模式反覆出現時,加入 Holt-Winters;需要為服務水準提供站得住腳的預測區間時,使用 ARIMA 或 SARIMA;當促銷與價格變動帶動銷量時,改用因果迴歸;只有在機器學習於保留測試集上勝出後,才引入它。
每個週期都以相同方式執行這套階梯流程:
- 審查銷售歷史:計算乾淨的期數,以及出現長段零銷量的 SKU。
- 選擇最符合需求模式的最簡單方法。
- 以最近三個月的數據驗證,不使用隨機切分。
- 將比較流程自動化,讓勝出的基準隨條件變化而更新。
ELECTE 可串接會計、銀行與試算表數據來源並保持更新,在即時數據上執行六種預測方法,相互評分並選出最準確的一種。您可獲得需求、現金與薪資預測,儀表板可一鍵匯出或分享。立即造訪 ELECTE,幾分鐘內即可看到您自己的銷售歷史預測結果。
留言
尚無留言——開始討論吧。