在庫予測の手法:需要を予測する5つの方法
実績のある5つの在庫予測手法について、それぞれの仕組みと適した場面を解説します。各手法を比較し、自社に合った方法を選びましょう。

発注しすぎれば資金が流出し、発注が足りなければ、棚に在庫のある競合に売上を奪われます。在庫を持つ事業はみな、この2つの失敗の間にあります。その分かれ目は、発注の裏でどの在庫予測手法を使っているかという一点に尽きます。
現場の担当者に「どの手法を使っていますか」と尋ねると、返ってくるのは製品名です。スプレッドシート、ERPのモジュール、経理部門が買ったアドオンなど。計算の中身を挙げる人はいません。埋めるべき溝はそこにあります。予測ツールは手法を届けるための手段にすぎず、安全在庫が現実に即した水準になるか、希望的観測に基づく水準になるかは、手法によって決まります。
ここでは5つの在庫予測手法を、対立する流派ではなく、段階的に選ぶための「はしご」として整理します。各手法は、次の手法が超えるべき基準線です。それぞれについて、必要なデータ、うまくいかない場面、そして力を発揮する条件を具体的に示します。
1. 移動平均法
移動平均法は一般的な出発点であり、その位置づけにふさわしい手法です。期間(3期、6期、12期など)を決め、その間の実際の需要を平均し、次期の予測値とします。新しい期が終わると期間が1つ先へずれ、数値は自動的に更新されます。
アーカンソー大学のサプライチェーン研究は、時系列予測を多くの補充システムの基盤と位置づけ、販売のばらつきの下にあるトレンドと季節性を見極めることが目的だと述べています。移動平均法は、その役割を最も単純な形で果たします。モデルを必要とせずに、一時的なスパイクを取り除けるのです。
単純移動平均と加重移動平均
単純移動平均は、すべての期を同じ重みで扱います。加重移動平均は直近の期により大きな影響を与えるため、需要が横ばいではなく増減している局面で有効です。先月の動向が先四半期よりも来月をよく示しているなら、加重を選びましょう。
たとえば、あるオンライン文具店は、定番商品のノートの発注点を決めるために直近3か月の販売数を平均します。一方、パン店は毎週月曜に過去4週間のパンの販売数を平均し、小麦粉の発注量を決めます。手法は同じでも期間は異なり、どちらも仕入担当者に説明しやすい方法です。
1つの期間に決める前に、直近12か月のデータで3通りの期間を試してください。最適な期間は、直感より短くなることが多いものです。
- ナイーブ法と比較する:前期の販売実績をそのまま予測にしても平均と同程度の精度が出るなら、平均を使う複雑さに見合う価値はありません。
- 安全在庫と組み合わせる:平滑化で消えるのは予測上のスパイクであり、実際の需要のスパイクではありません。
- 商品ファミリーを分ける:ノートと季節限定の手帳が、同じ期間を共有すべきではありません。
商品が安定して売れていて、欠損のないデータが少なくとも6期間分あり、どの関係者にも理解できるベースラインが必要な場合に使います。これは、以降のあらゆる手法が上回るべき基準値でもあります。小売業向けの30日間在庫パイロットを見れば、このようなベースラインによって、平均値だけでは足りないSKUがいかに早く浮かび上がるかが分かります。
2. 指数平滑法(ホルト・ウィンタース法)
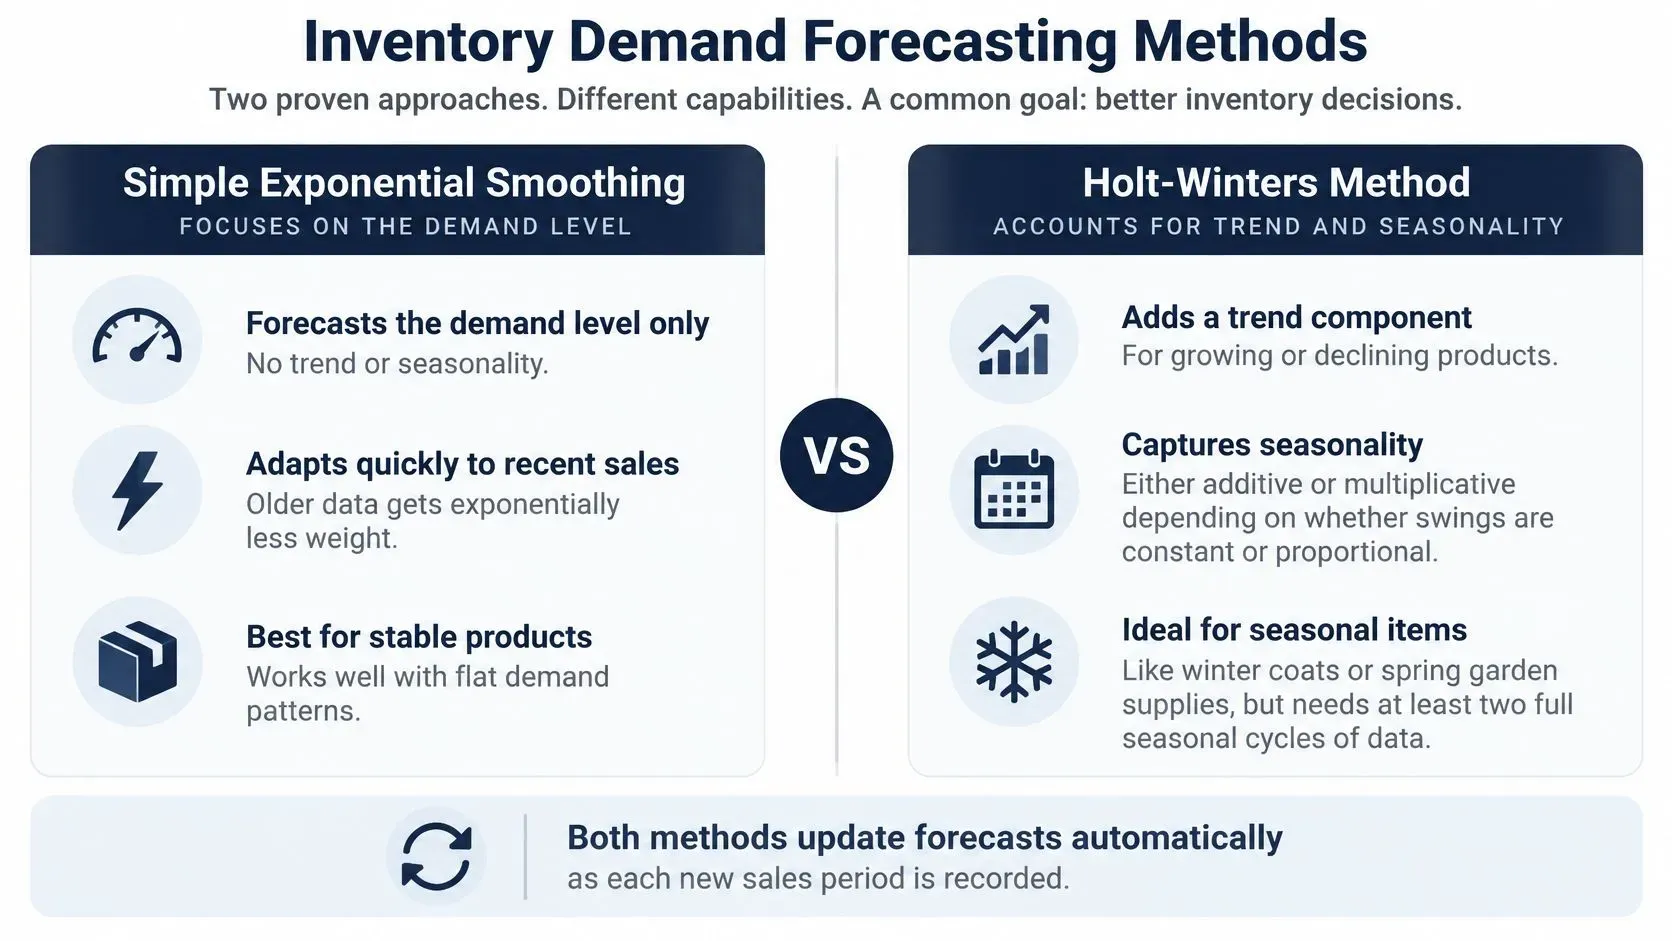
指数平滑法は平均を取るという考え方を保ちつつ、古いデータと新しいデータを同じ重みで扱うことをやめます。各観測値の重みは古くなるほど指数的に小さくなるため、ある週の異常値に過剰反応することなく、予測を現在の動きに寄せられます。
ホルト・ウィンタース法は、トレンド項と季節項という2つの要素を加えます。季節変動が販売量とともに大きくなるかどうかに応じて、加法型か乗法型を使い分けます。季節性のある小売の商品群が、この手法を最も多く使うのはそのためです。
精度が重要になる理由
直近のデータに重みを置くと反応は速くなりますが、その代償もあります。卸売と在庫管理に関する研究のレビューは、Syntetosらの知見として、同程度のサービスレベルを維持する場合、予測精度が1%低下すると在庫コストが10〜15%増加しうると報告しています。パラメータが遅すぎれば需要の変化に対して在庫過多となり、速すぎればノイズを追いかけてブルウィップ効果を招きます。
モデルを正しく保つための習慣は3つあります。
- 最低2年分:少なくとも2回分の完全な季節サイクルを与えてください。そうしないと、季節成分は推測になります。
- 最適化結果を確認する:平滑化定数はソフトウェアに求めさせたうえで、季節パターンが実際の1年の動きと合っているか確認します。
- 販促はイベントとして記録する:3週間のキャンペーンが履歴に混ざると、ベースラインが数か月にわたって歪みます。
需要に繰り返される季節パターンがあり、欠損のない2サイクル分のデータを用意できる場合に使います。平滑化モデルの実際の運用と比較方法については、平滑化モデルによるデフォルト率の予測をご覧ください。
3. ARIMAおよびSARIMA時系列モデル
平滑化は履歴を加重平均として扱います。ARIMAは同じデータに対し、より踏み込んだ問いを立てます。今日の需要は、昨日の需要、昨年の同じ週、そしてモデルが過去に出した誤差に左右されるのか、という問いです。和分の段階では、トレンドが安定するまで系列の差分を取り、SARIMAは週次や年次のサイクルに対応する季節項を加えます。ホルト・ウィンタース法がより滑らかな線を返すのに対し、ARIMAは需要の生成過程そのもののモデルを返します。
価値を生むのは、予測値の周囲に示される区間です。
単一の数値より範囲が役に立つ
補充最適化に関する研究では、SKUごとの需要、返品リードタイム、補充リードタイムを確率変数としてモデル化しています。単一の推定値ではなく分位点予測を用い、サプライチェーンの各段階で不確実性がどのように伝播するかを追跡するために「予測不確実性比(Ratio of Forecast Uncertainty)」を提案しています。この違いは発注の場面で重要になります。予測が1,000個であっても、想定範囲が850〜1,150個の場合と、500〜1,700個の場合とでは、意味がまったく異なります。
同じ予測を見ても、2人のバイヤーが正反対の判断を下すことがあります。ある地域の食料品チェーンは、週次の乳製品需要を週単位と年単位の両方の季節性でモデル化し、ホリデーシーズンの増加を発注後ではなく発注に反映させます。ある電子部品ディストリビューターは、一律2週間分の在庫ではなく、サービス目標に基づいて、予測区間の90パーセンタイルで部品の安全在庫を設定します。仕組みは同じでも、問われている方針は異なります。
うまく運用するには、規律が必要です。
- 定常性を検定する:グラフと正式な検定の両方を使い、差分は必要な分だけにとどめます。差分を取りすぎると、モデルが説明しなければならないノイズを持ち込むことになります。
- 直近3か月をホールドアウトする:モデルを信頼する前に、その期間で精度を評価します。
- 区間を方針に落とし込む:利益率、キャッシュポジション、サービス上の約束に見合うパーセンタイルを選びます。
- 大規模なカタログではモデル選択を自動化する:400SKUにもなると、手作業での次数調整は成り立ちません。
代償は手間です。ARIMAは定常なデータ、慎重な次数選択、季節項を推定するのに十分な履歴を必要とし、それでも参照するのは系列自身の過去だけです。だからこそ、因果的手法が超えるべき基準となります。価格やプロモーションといった要因は、需要自身の履歴よりも予測精度を高める場合に限り、モデルに加える価値があります。
平滑化では捉えきれない自己相関が系列にあり、サービスレベル目標に照らして安全在庫を決めるための現実的な範囲が必要な場合に、この手法を使います。
4. 因果回帰による予測
ここまでの手法はいずれも、需要自身の履歴から需要を読み取るものでした。因果回帰は別の問いを立てます。何が需要を動かし、どれだけ動かすのか。チームがすでに追跡している要因、たとえば価格、値引き幅、プロモーション、祝日、天候、競合の動きを入力すると、それぞれがもたらす上乗せ効果を推定します。
出力は議論の余地のある係数であり、そこに意味があります。値引きは単に予測を押し上げるだけでなく、明示された量だけ押し上げます。発注に必要なのは、その量です。
プロモーションカレンダーをモデルに組み込む
たとえば、ある家庭用品小売業者が、20%の値引きと週末のメールキャンペーンを組み合わせると、キッチン家電の売上がどう動くかを知りたいとします。回帰は両者を合わせた効果を推定するため、バイヤーは前年の月平均ではなく、計画されたイベントに基づいて発注できます。気温予報を取り込む飲料ディストリビューターは、猛暑に後手で対応するのではなく、事前に在庫を積むことができます。
実践のルール:要因は、ホールドアウト期間で1つずつ検証します。モデルが見ていないデータで精度を改善しない要因は、シグナルではなく作り話です。
- まずは記録しているデータから始める:販促フラグ、価格変更、祝日カレンダーなどです。想定以上に使える要因を持っているチームは少なくありません。
- 係数を更新する:価格変更や新規参入者の登場後は顧客の反応が変わります。係数が古いままだと、過剰在庫につながるおそれがあります。
- 計画的な要因と突発的な要因を分ける:キャンペーンは入力変数として扱い、SNSでの拡散や欠品からの回復はイベントフラグとして扱います。
販促や価格が販売数量の大部分を左右する場合や、キャンペーンの実施後ではなく実施前に在庫量を見積もる必要がある場合に適しています。
5. 機械学習による需要予測
機械学習は、モデリングの単位を変えます。商品ごとにモデルを1つずつ当てはめる代わりに、数千のSKU×店舗の組み合わせを1つのモデルで学習させ、共通のパターンを捉えさせます。天候に反応する商品、給料日のサイクルに反応する商品、2週間前の販促に反応する商品などです。
表形式の販売データでは、勾配ブースティングが高い性能を発揮します。ニューラルネットワークは、カタログが非常に大きく、手作業では定義できない形で要因同士が影響し合う場合に真価を発揮します。
精度の議論が複雑になるところ
7,500件の需要系列と13種類の予測手法を評価した研究では、予測精度の価値は、商品特性、在庫方針、保管コスト、機会損失コスト、発注間隔、リードタイムによって変わることが示されました。同研究は、医薬品分野の中小企業では、断続的な注文が相当数あっても判断に基づく予測に頼ることが多いとも指摘しています。その背景として、過去データの不正確さ、専門人材の不足、技術導入の遅れを挙げています。
ランキングを追い求める人にとっては、厄介な示唆です。誤差指標で勝つモデルでも、保管コストが低く欠品コストが高い場合は、コスト面で負けることがあります。また、間欠需要の商品で優秀に見える手法も、大半の期間で需要がゼロであるために高スコアになっているだけかもしれません。
- ベースラインを超える:移動平均やホルト・ウィンターズ法が比較対象(コントロール)です。ホールドアウトデータで機械学習がこれを上回らないなら、導入しないでください。
- ランダムではなく時間で検証する:古い期間で学習し、新しい期間でテストします。
- セグメント別に評価する:ロングテールの誤差よりも、上位50SKUの誤差のほうが重要です。
- 間欠需要は別枠で扱う:ゼロが多い商品には、専用の評価ルールが必要です。
中小企業向けのAI搭載データ分析プラットフォームであるELECTEは、お客様のデータに対して6つの予測手法を実行し、互いにスコアを比較して最も精度の高い手法を選択します。手作業での比較検証が不要になります。販促が多いカタログについては、フラッシュセールでの需要急増への対応をご覧ください。
多くの商品にわたって詳細な履歴データが豊富にあり、ベースラインよりもコストとサービスの両面で優れていることが、机上の数値だけでなく実証されている場合に適しています。
在庫予測の5つの手法一覧
手法 | 最適な用途 | 必要なデータ | 季節性への対応 | 難易度 |
|---|---|---|---|---|
移動平均法による予測 | 安定した需要、シンプルなベースライン | 直近の少量の販売履歴 | 非対応 | 易しい |
指数平滑法(ホルト・ウィンタース法) | トレンドや季節パターンのある需要 | 少なくとも2季節サイクル分の販売データ | 対応 | 中程度 |
ARIMA・SARIMA時系列モデル | 時間的パターンを持つ自己相関のある需要 | 長期でクリーンな過去の時系列データ | SARIMAなら対応 | 高度 |
因果回帰による予測 | プロモーション、価格、その他の要因の影響の予測 | 販売履歴と信頼できる要因データ | 季節変数を加えれば対応可能 | 中程度 |
機械学習による需要予測 | 需要要因が複雑な大規模カタログ | 大量でクリーンな販売履歴と関連する入力データ | カレンダーや季節の特徴量を加えれば対応 | 高度 |
要点:データが支えられる手法を選ぶ
各段階を、次の段階が上回るべきベースラインとして扱います。移動平均はコストが低く仕組みも分かりやすいため、以降のどのモデルにも超えるべき基準値を与えてくれます。同じ季節パターンが繰り返し現れるならHolt-Winters法を追加し、サービスレベルの根拠となる予測区間が必要ならARIMAまたはSARIMAを使います。販促や価格変更が販売数量を左右する場合は因果回帰に切り替え、機械学習はホールドアウト検証で優位性を示せた場合にのみ導入します。
この段階的な手順を、毎回同じ方法で実行します。
- 販売履歴を監査する:問題のない期間の数と、ゼロが長く続くSKUを数えます。
- 需要パターンに合う最もシンプルな手法を選びます。
- 直近3か月のデータで検証します。ランダム分割は行いません。
- 比較を自動化し、状況の変化に応じて最良のベースラインが入れ替わるようにします。
ELECTEは、会計、銀行、スプレッドシートの各データソースを接続して常に最新の状態に保ち、最新の数値に対して6種類の予測手法を実行し、互いに比較してスコアを付け、最も精度の高いものを選びます。需要、キャッシュ、給与の予測を、ワンクリックでエクスポートや共有ができるダッシュボードで確認できます。ELECTEをご利用いただければ、ご自身の販売履歴の予測を数分で確認できます。
コメント
まだコメントはありません — 会話を始めましょう。