Методи прогнозування запасів: 5 способів передбачити попит
Дізнайтеся про 5 перевірених методів прогнозування запасів: як працює кожен із них і коли його застосовувати. Порівняйте підходи та оберіть той, що підходить вашому бізнесу.

Замовите забагато — і гроші заморожені в товарі. Замовите замало — і продаж піде до того, у кого товар є на полиці. Кожен бізнес, що тримає запаси, балансує між цими двома збоями, а різниця між ними зводиться до одного рішення: який метод прогнозування запасів стоїть за вашими замовленнями постачальникам.
Запитайте в залі операційних керівників, яким методом вони користуються, і у відповідь почуєте назви продуктів. Електронна таблиця. Модуль ERP. Надбудова, яку купили у фінансовому відділі. Ніхто не називає саму математику. Саме цю прогалину варто закрити. Інструмент прогнозування — лише спосіб доставки методу, а метод визначає, чи ваш страховий запас розрахований на реальність, чи на бажане за дійсне.
Ось п'ять методів прогнозування запасів, представлені як сходи рішень, а не як суперницькі табори. Кожен із них — базова лінія, яку має перевершити наступний. Для кожного ви дізнаєтеся, які дані він потребує, де дає збій і за яких саме умов виправдовує себе.
1. Прогнозування за ковзною середньою
Ковзна середня — поширена відправна точка, і вона заслуговує на це місце. Ви обираєте вікно (3, 6 або 12 періодів), усереднюєте фактичний попит за ним і використовуєте результат як прогноз на наступний період. Коли закривається новий період, вікно зсувається вперед, а значення оновлюється саме.
Дослідження ланцюга постачання Університету Арканзасу описує прогнозування часових рядів як основу більшості систем поповнення запасів, мета якого — виявити тренд і сезонність під шумом продажів. Ковзна середня виконує найпростішу версію цього завдання: вона прибирає разові сплески, не потребуючи моделі.
Прості та зважені вікна
Прості ковзні середні надають усім періодам однакову вагу. Зважені ковзні середні дають більший вплив останнім періодам, що важливо, коли попит зростає або падає, а не тримається на одному рівні. Обирайте зважену, коли минулий місяць більше говорить про наступний, ніж минулий квартал.
Скажімо, інтернет-магазин канцтоварів усереднює продажі блокнотів за останні три місяці, щоб задати точки перезамовлення для стабільної лінійки, а пекарня щопонеділка усереднює продажі хліба за чотири тижні, щоб розрахувати замовлення борошна. Той самий метод, різні вікна, і обидва легко пояснити закупівельнику.
Перш ніж зупинитися на одній довжині вікна, перевірте три варіанти на даних за останні дванадцять місяців. Найкраще вікно зазвичай коротше, ніж підказує інтуїція.
- Порівнюйте з наївним прогнозом: якщо продажі минулого періоду прогнозують так само добре, як ваша середня, то середня не виправдовує своєї складності.
- Поєднуйте зі страховим запасом: згладжування прибирає сплеск із прогнозу, але не з попиту.
- Розділяйте товарні групи: блокнот і сезонний планер не повинні ділити одне вікно.
Використовуйте цей метод, коли товари продаються стабільно, у вас є щонайменше шість чистих періодів історії, а базовий прогноз має бути зрозумілим для будь-якого стейкхолдера. Це також показник, який мають перевершити всі наступні методи. 30-денний пілот з управління запасами для рітейлерів показує, як швидко такий базовий прогноз виявляє SKU, яким потрібно більше, ніж просте середнє.
2. Експоненційне згладжування (метод Холта—Вінтерса)
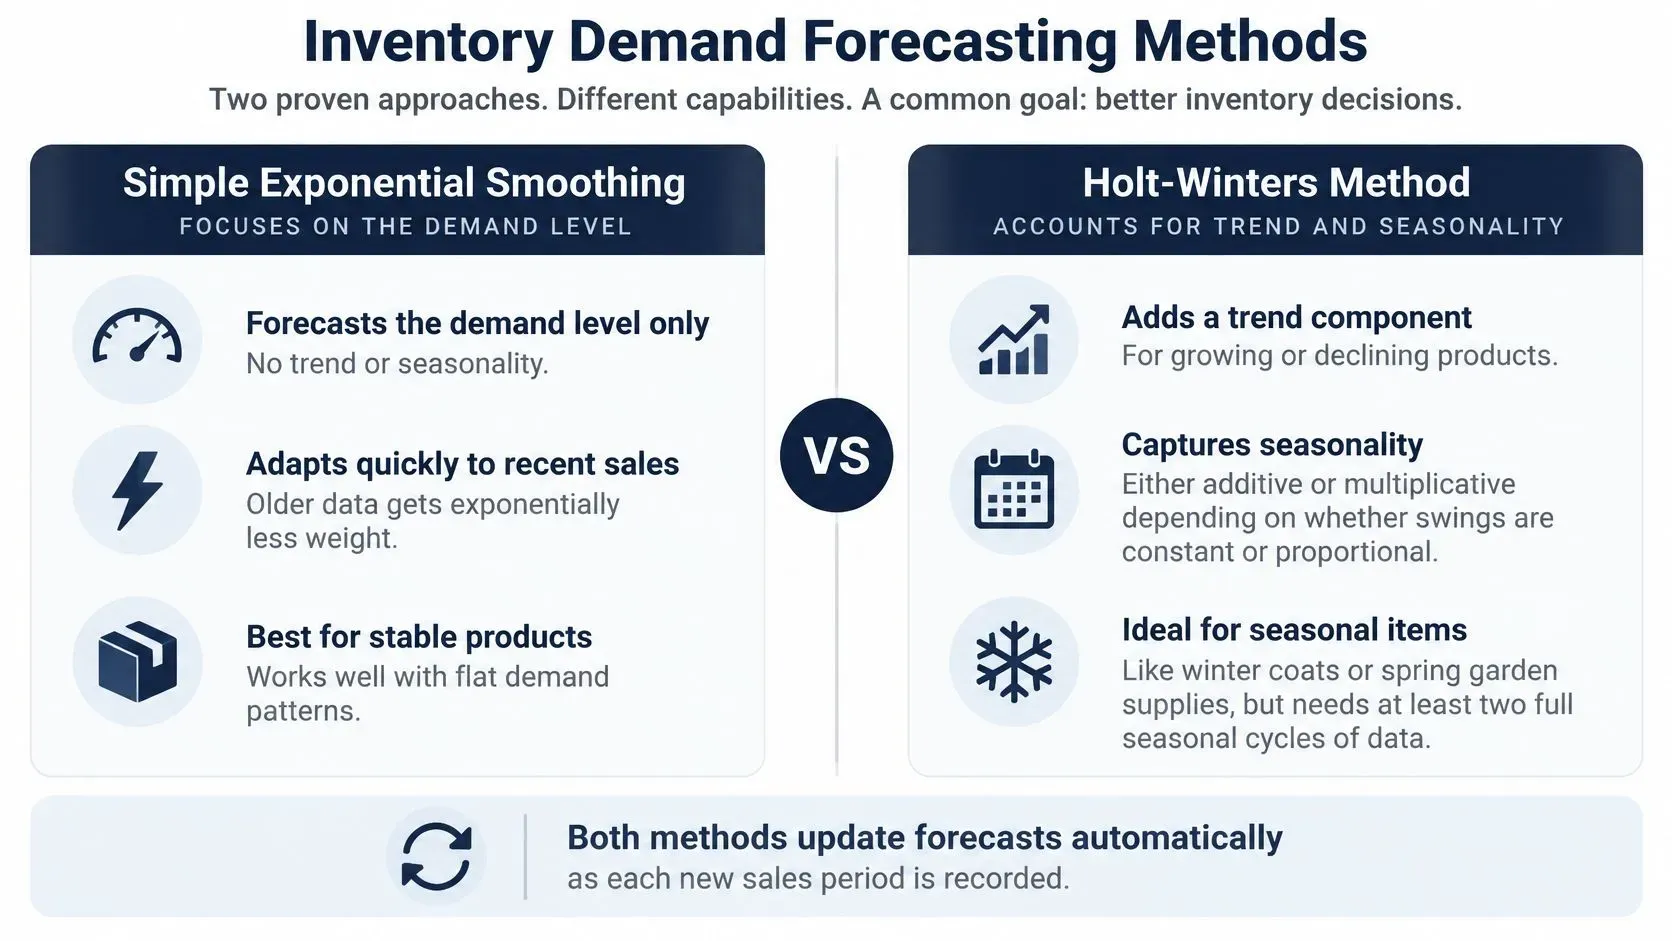
Експоненційне згладжування зберігає принцип усереднення, але перестає ставитися до старих і нових даних однаково. Вага кожного спостереження експоненційно зменшується з віком, тому прогноз орієнтується на поточну ситуацію і не надто реагує на один нетиповий тиждень.
Метод Холта—Вінтерса додає два компоненти: трендовий і сезонний, адитивні або мультиплікативні залежно від того, чи зростають сезонні коливання разом з обсягом. Саме тому сезонні роздрібні каталоги здебільшого працюють із цим методом.
Чому ціна помилки вища
Більша вага свіжих даних дає чутливість, але вона коштує. Дослідження з оптової торгівлі та керування запасами наводить висновок Синтетоса та його колег: зниження точності прогнозу на 1% може відповідати зростанню витрат на запаси на 10–15% за збереження порівнянного рівня сервісу. Якщо параметри задано надто повільними, ви матимете надлишок під час зсуву попиту; якщо надто швидкими, ви женетеся за шумом і отримуєте ефект «батога».
Три звички допомагають зберегти модель чесною:
- Мінімум два роки: подавайте щонайменше два повні сезонні цикли, інакше сезонний компонент просто вгадує.
- Перевіряйте оптимізатор: нехай програма підбере константи згладжування, а потім переконайтеся, що сезонна форма відповідає минулому року.
- Позначайте промоакції як події: тритижнева кампанія спотворює базу на місяці, якщо дозволити їй потрапити в історію.
Використовуйте цей метод, коли попит має сезонну форму, що повторюється, і ви можете надати два чистих цикли. Як моделі згладжування застосовують і порівнюють на практиці, читайте в матеріалі прогнозування рівня дефолтів за допомогою моделей згладжування.
3. Моделі часових рядів ARIMA і SARIMA
Згладжування розглядає історію як зважене середнє. ARIMA ставить до тих самих даних складніше питання: чи залежить сьогоднішній попит від учорашнього, від того самого тижня минулого року та від помилок, яких модель припускалася раніше? Інтегрований крок диференціює ряд, доки тренд не стабілізується, а SARIMA додає сезонні складові для тижневих і річних циклів. Якщо Холт—Вінтерс дає вам гладкішу лінію, то ARIMA дає модель самого процесу попиту.
Найкорисніший результат — інтервал навколо прогнозу.
Діапазони кращі за окремі числа
У дослідженні з оптимізації поповнення запасів попит на SKU, терміни повернення та терміни поповнення моделюються як випадкові величини. Замість однієї оцінки автори працюють із квантильними прогнозами та пропонують показник Ratio of Forecast Uncertainty, щоб відстежувати, як невизначеність передається між ланками ланцюга постачання. Для замовлення постачальнику ця різниця принципова. Прогноз у 1 000 одиниць означає одне, коли правдоподібний діапазон становить від 850 до 1 150, і зовсім інше, коли він сягає від 500 до 1 700.
Двоє закупівельників можуть прочитати той самий прогноз і ухвалити протилежні рішення. Регіональна мережа продуктових магазинів моделює тижневий попит на молочні продукти з урахуванням тижневої та річної сезонності, щоб святковий сплеск потрапляв у замовлення, а не з’являвся після нього. Дистриб’ютор електроніки визначає страховий запас компонентів за 90-м перцентилем інтервалу, орієнтуючись на цільовий рівень сервісу, а не на фіксовані два тижні покриття. Інструмент той самий, а питання політики запасів різні.
Щоб метод працював добре, потрібна дисципліна:
- Перевіряйте стаціонарність за допомогою графіка та формального тесту, а потім беріть різниці лише в потрібному обсязі. Надмірне диференціювання вносить шум, який модель потім змушена пояснювати.
- Відкладіть останні три місяці і оцініть модель на них, перш ніж їй довіряти.
- Перетворюйте інтервали на політику: обирайте перцентиль, який виправдовують ваша маржа, грошовий потік і зобов’язання щодо рівня сервісу.
- Автоматизуйте вибір моделі для великих каталогів. Ручне налаштування порядків не масштабується на 400 SKU.
Платити доводиться зусиллями. ARIMA вимагає стаціонарних даних, ретельного вибору порядків і достатньої історії для оцінки сезонних складників, а при цьому враховує лише минуле самого ряду. Тому цей метод є планкою для причинних методів: фактор, як-от ціна чи промоакція, заслуговує місця в моделі, лише якщо дає кращий прогноз, ніж власна історія попиту.
Застосовуйте його, коли у вашому ряді є автокореляція, яку згладжування не вловлює, і вам потрібен чесний діапазон для розрахунку страхового запасу під цільовий рівень сервісу.
4. Причинне регресійне прогнозування
Усі методи досі виводили попит з його власної історії. Причинна регресія ставить інше запитання: що рухає попит і наскільки? Ви подаєте їй фактори, які ваша команда вже відстежує: ціну, глибину знижки, промоакції, свята, погоду, дії конкурентів, а вона оцінює приріст, який дає кожен із них.
Результат — коефіцієнт, який можна обговорювати, і в цьому сенс. Знижка не просто збільшує прогноз, а збільшує його на певну величину, і саме ця величина потрібна для вашого замовлення постачальнику.
Додайте календар промоакцій у модель
Припустімо, роздрібний продавець товарів для дому хоче дізнатися, як знижка 20 відсотків разом з email-кампанією на вихідних вплине на продажі кухонної техніки. Регресія оцінює сукупний ефект, тож закупівельник замовляє під заплановану подію, а не під минулорічне середнє за місяць. Дистриб’ютор напоїв, який враховує прогноз температури, може наповнити склад заздалегідь перед спекою, а не реагувати постфактум.
Практичне правило: перевіряйте один фактор за раз на відкладеному періоді. Фактор, який не підвищує точність на даних, яких модель не бачила, — це історія, а не сигнал.
- Почніть з того, що ви вже фіксуєте: позначки промоакцій, зміни цін і календарі свят. У багатьох команд є більше придатних до використання чинників, ніж вони вважають.
- Оновлюйте коефіцієнти: реакція клієнтів змінюється після цінових змін або появи нового гравця на ринку, а застарілі коефіцієнти можуть призвести до надлишків запасів.
- Розділяйте заплановане й незаплановане: кампанії вводяться як вхідні дані; вірусний допис або відновлення після дефіциту товару вводяться як позначка події.
Використовуйте цей метод, коли промоакції та ціни формують значну частину ваших обсягів і коли потрібно розрахувати запас під кампанію до її старту, а не після.
5. Прогнозування попиту за допомогою машинного навчання
Машинне навчання змінює одиницю моделювання. Замість окремої моделі для кожного товару ви навчаєте одну модель на тисячах комбінацій SKU і магазинів, і вона вчиться спільним закономірностям: які товари реагують на погоду, які — на цикли виплат зарплати, а які — на промоакцію, що відбулася двома тижнями раніше.
Градієнтний бустинг добре працює з табличними даними про продажі. Нейронні мережі виправдовують себе, коли каталог величезний, а сигнали взаємодіють так, що задати це вручну неможливо.
Де аргумент про точність ускладнюється
Дослідження, що оцінило 7 500 рядів попиту та 13 методів прогнозування, показало, що цінність точності прогнозу залежить від характеристик товару, політики управління запасами, витрат на зберігання, втрат від втрачених продажів, інтервалів перегляду та термінів поставки. У цій самій роботі зазначено, що фармацевтичні МСП часто покладаються на експертні прогнози навіть за значної кількості нерегулярних замовлень, а причинами називають неточні історичні дані, обмежену кількість фахівців і низький рівень впровадження технологій.
Для тих, хто женеться за місцем у рейтингу, висновок неприємний. Модель, яка виграє за метриками похибки, може програти за витратами, коли витрати на зберігання низькі, а дефіцит коштує дорого. А метод, який виглядає сильним на товарах з нерегулярним попитом, може отримувати високі оцінки лише тому, що в більшості періодів попит нульовий.
- Перевершіть базовий рівень: ковзне середнє або модель Хольта—Вінтерса — це ваш контроль. Якщо машинне навчання не перевершує її на відкладених даних, не впроваджуйте його.
- Перевіряйте за часом, а не випадково: навчайте на старших періодах, тестуйте на новіших.
- Оцінюйте за сегментами: похибка на ваших топ-50 SKU важливіша за похибку на «довгому хвості».
- Розглядайте нерегулярність окремо: для товарів із великою кількістю нулів потрібні власні правила оцінювання.
ELECTE, платформа аналітики даних на основі ШІ для МСП, застосовує до ваших даних шість методів прогнозування, порівнює їх між собою та обирає найточніший, замінюючи ручне змагання моделей. Щодо каталогів із великою кількістю промоакцій дивіться як враховувати стрибки попиту під час флеш-розпродажів.
Використовуйте цей метод, коли у вас є щільна детальна історія по багатьох товарах і підтвердження, що він перевершує ваш базовий рівень за витратами та рівнем сервісу, а не лише на папері.
5 методів прогнозування запасів: огляд
Метод | Найкраще підходить для | Необхідні дані | Враховує сезонність | Складність |
|---|---|---|---|---|
Прогнозування за ковзним середнім | Стабільний попит і прості базові прогнози | Невеликий обсяг недавньої історії продажів | Ні | Легко |
Експоненціальне згладжування (метод Холта–Вінтерса) | Попит із трендами та сезонними закономірностями | Дані про продажі щонайменше за два сезонні цикли | Так | Середня |
Моделі часових рядів ARIMA та SARIMA | Автокорельований попит із часовими закономірностями | Довгі, чисті історичні часові ряди | Так, у SARIMA | Висока |
Причинно-наслідкове регресійне прогнозування | Прогноз впливу промоакцій, цін та інших чинників | Історія продажів і надійні дані про чинники | Може, із сезонними змінними | Середня |
Прогнозування попиту за допомогою машинного навчання | Великі каталоги зі складними чинниками попиту | Великий, чистий масив історії продажів і релевантні вхідні дані | Так, із календарними або сезонними ознаками | Висока |
Головні висновки: обирайте метод, який підтримують ваші дані
Розглядайте кожен щабель як базовий рівень, який має перевершити наступний. Ковзне середнє дешеве й прозоре, тому воно задає показник, який кожна наступна модель повинна покращити. Додайте Хольта-Вінтерса, коли однакова сезонна форма повторюється; використовуйте ARIMA або SARIMA, коли потрібен обґрунтований інтервал для рівнів сервісу; переходьте до причинної регресії, коли обсяги визначають промоакції та зміни цін; залучайте машинне навчання лише після того, як воно переможе на відкладеній вибірці.
Проходьте цю драбину однаково в кожному циклі:
- Проведіть аудит історії продажів: порахуйте «чисті» періоди та SKU з довгими серіями нулів.
- Оберіть найпростіший метод, що відповідає моделі попиту.
- Перевіряйте на останніх трьох місяцях, без випадкового розподілу вибірки.
- Автоматизуйте порівняння, щоб базовий метод-переможець змінювався разом з умовами.
ELECTE підключає бухгалтерські, банківські джерела та електронні таблиці, підтримує їх актуальними, застосовує шість методів прогнозування до актуальних даних, порівнює їх між собою й обирає найточніший. Ви отримуєте прогнози попиту, грошових коштів і фонду оплати праці з дашбордами, які можна експортувати або поширити одним кліком. Відвідайте ELECTE, щоб за кілька хвилин побачити прогноз на основі власної історії продажів.
Коментарі
Коментарів поки немає — почніть обговорення.