Etapas de pré-processamento de dados: como limpar dados empresariais
Conheça as etapas de pré-processamento de dados que transformam registos empresariais desorganizados em insights fiáveis, com exemplos para PME. Veja como o ELECTE as automatiza.
Você extraiu uma exportação de vendas que parece concluída. Pedidos, custos e datas preenchem a folha. Depois, uma previsão chega à mesa do responsável financeiro e o valor médio dos pedidos disparou, embora nada tenha mudado no catálogo.
Esse salto costuma ser um erro de pré-processamento, não uma mudança no comportamento de compra. Preencher preços em branco enquanto ainda há faturas duplicadas no ficheiro, ou normalizar toda a extração antes de reservar linhas, ensina ao modelo factos que ele ainda não deveria ver. A maioria dos artigos apresenta as etapas de pré-processamento de dados como técnicas isoladas, aplicáveis em qualquer ordem. A ordem é justamente o que infla os resultados.
A seguir está a sequência que recomendo quando um analista é responsável por um ficheiro de negócio em uso. Você vai encontrar uma ordem de execução, os limites que trato como ponto de partida e não como lei, e uma forma de bloquear cada parâmetro ajustado para que a carga de dados seguinte siga o mesmo caminho.
Sete etapas de pré-processamento de dados na ordem certa
Uma exportação de vendas pode parecer completa e ainda esconder linhas de faturas duplicadas, custos unitários em branco e datas guardadas em dois formatos. Se limpar esses problemas na ordem errada, todas as médias seguintes herdam-nos.
Qualquer etapa que aprenda um valor a partir dos dados deve ser executada depois da divisão. Uma média, uma mediana ou um intervalo de normalização calculado sobre o ficheiro inteiro deixa as linhas de validação influenciarem o treino. A pontuação parece então mais forte do que o modelo será nos pedidos do próximo mês.
Etapa | O que fazer | Está pronta quando |
|---|---|---|
1. Analisar e limpar | Verifique a contagem de linhas, os tipos de dados e as taxas de nulos; elimine duplicados exatos; padronize datas e rótulos | Tabela base limpa, com um único rótulo por categoria |
2. Dividir os dados | Embaralhe as linhas e depois divida-as em conjuntos de treino e de validação | Existem dois conjuntos e ainda não foi calculado nenhum parâmetro aprendido |
3. Tratar valores em falta | Elimine linhas, elimine a variável ou impute usando apenas os dados de treino | Todos os campos estão completos ou as lacunas estão sinalizadas |
4. Codificar e criar variáveis | Converta categorias em números; crie rácios, partes de datas e médias móveis | Uma tabela de variáveis pronta para o modelo, com colunas documentadas |
5. Tratar outliers | Verifique os valores extremos e depois limite-os, transforme-os ou sinalize-os | Os valores extremos estão explicados, não adivinhados |
6. Normalizar variáveis numéricas | Ajuste um normalizador nos dados de treino e aplique-o aos dados de validação | As colunas numéricas estão em intervalos comparáveis |
7. Bloquear o pipeline | Guarde todas as transformações ajustadas para que os novos dados sigam o mesmo caminho | Uma execução repetível que funciona em cada nova carga de dados |
Imagine que um retalhista tem 12 000 linhas de pedidos, incluindo 900 linhas de faturas duplicadas. Se imputar os preços em falta antes de eliminar esses duplicados, a mesma fatura é contada duas vezes e a média afasta-se da lista de preços.
Regra prática: Termine a linha em que está antes de calcular qualquer coisa de que a linha seguinte precise.
Compare o arquivo que você tem aberto com essas sete linhas. A primeira linha que você ainda não concluiu é a única que vale a pena tocar hoje.
Faça o perfil e a limpeza dos dados brutos de negócio
O perfil é uma passagem de uma hora que um gestor consegue concluir antes de alguém abrir um modelo. Mantenha o arquivo bruto intacto e registre cada alteração em um log de limpeza, para que o responsável financeiro veja por que um total mudou.
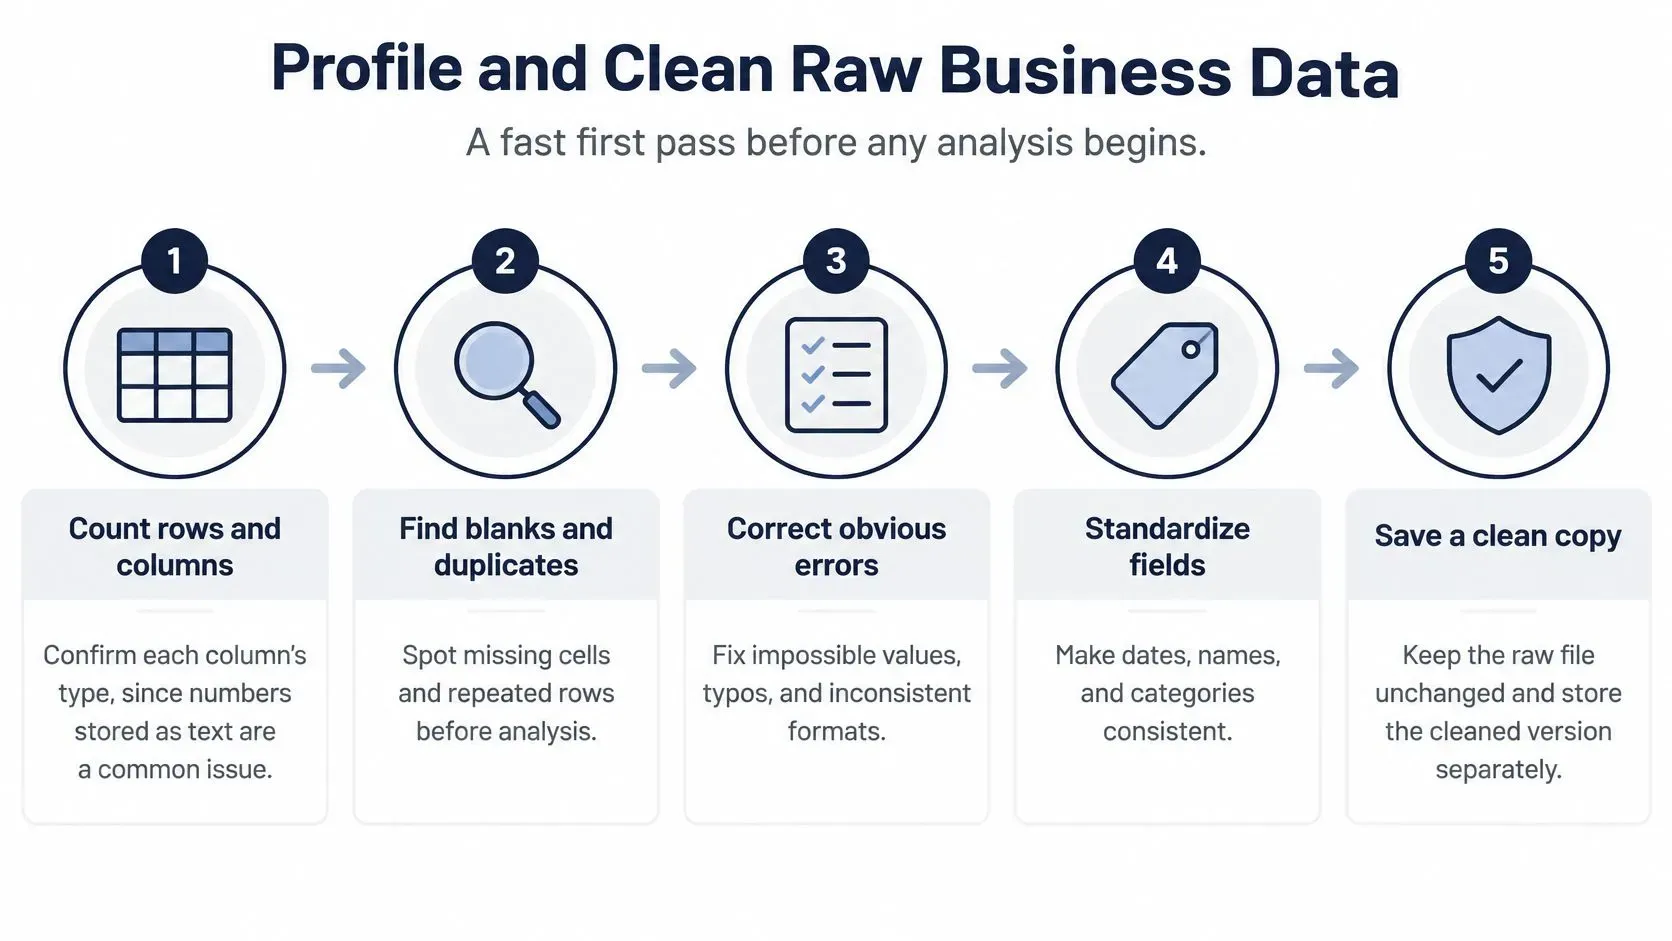
- Conte linhas e colunas e confirme o tipo de cada uma. Um custo armazenado como texto não soma e não gera nenhum erro visível. Converta-o antes de confiar em um total.
- Calcule a taxa de nulos de cada coluna. Uma coluna com mais de 30% em branco segue as regras de valores ausentes, em vez de um preenchimento rápido. Eu só descartaria uma coluna por completo quando os vazios passarem de 50% e o campo não for necessário para a decisão.
- Remova duplicatas exatas, não registros parecidos. Compare número da fatura, data e valor em conjunto. Um segundo pedido com outro ID de linha é uma venda real. Excluí-lo porque o cliente e o dia coincidem é o deslize que subestima a receita.
- Normalize os formatos de uma só vez. Um único padrão de data, uma única moeda por coluna e nenhum espaço sobrando nos códigos. Formatos mistos dividem um produto em duas séries e quebram qualquer junção posterior.
- Padronize os rótulos de categoria.
UK,U.K.eUnited Kingdomsão um único mercado. Quatro grafias de uma mesma linha de produtos em uma exportação de e-commerce de três anos causam o mesmo dano. Escolha um rótulo e mapeie os demais.
Suponha que essa exportação também armazene datas de pedido como 2024-03-01 em um ano e 01/03/2024 em outro. Enquanto os dois não virarem um único padrão, um gráfico mensal conta março em dobro ou o omite.
O que o log e o corte de privacidade protegem
O log de limpeza é uma tabela curta: coluna, regra, linhas alteradas, responsável, data. Quando o financeiro perguntar por que março do ano passado diminuiu, você aponta a regra de duplicatas em vez de reconstruir o arquivo de memória.
Antes de o arquivo chegar a qualquer plataforma de análise, remova nomes de clientes, e-mails e dados de pagamento. Você não precisa deles para prever a demanda, e deixá-los na extração cria um problema de privacidade que nenhum modelo resolve.
Se quiser uma segunda opinião sobre o que é "bom" em extrações comerciais, os insights de qualidade de dados de vendas da Pipecorn são uma lista de verificação útil para identificadores, completude e consistência. Use-os para decidir quais colunas vale manter e depois volte ao corte por taxa de nulos acima.
Divida os dados antes de qualquer aprendizado
A divisão é uma cerca. Nada que estime uma estatística deve ser calculado sobre o arquivo completo.
Para classificação supervisionada de texto, o guia de classificação de texto do Google recomenda embaralhar antes da divisão, porque manter a ordem original pode enviesar os dois conjuntos. Depois de embaralhar, uma divisão típica coloca 80% dos exemplos no treino e 20% na validação. As mesmas transformações se aplicam então aos dois conjuntos, mas só depois de aprendidas nas linhas de treino.
Por que um arquivo de vendas ordenado engana
As exportações costumam chegar ordenadas por data, região ou cliente. Se você dividir esse arquivo de cima para baixo, treina com 2023 e valida com o fim de 2024. A pontuação passa a refletir o calendário, o calendário de promoções ou o mix de uma única região. Ela não diz se o modelo entendeu os pedidos.
Embaralhe quando cada linha for um caso independente: um pedido fechado, uma conta cancelada, um ticket classificado. Não embaralhe quando a pergunta for uma previsão.
Mantenha a ordem temporal para previsões. Treine com os meses anteriores e teste com os posteriores. Embaralhar deixaria o modelo ver o futuro e chamar isso de competência.
Campos de texto precisam de um corte por frequência
Tickets de suporte e descrições de produtos se desdobram em milhares de tokens. No mesmo fluxo do Google, você descarta tokens que aparecem menos de duas vezes, mantém os 20.000 principais atributos de token e classifica o que resta com uma pontuação de importância baseada em teste F. Um token que aparece uma única vez costuma ser um erro de digitação ou um SKU isolado, não um padrão que mereça uma coluna.
Depois da divisão, ajuste todos os mapeamentos apenas com os dados de treino e aplique esse mapeamento congelado à validação. Recalcular um vocabulário ou uma lista de categorias sobre as linhas reservadas é outra forma de vazar a resposta para o preparo.
Preencha valores ausentes sem distorcer os resultados
A frequência com que um campo fica em branco, e se a decisão precisa desse campo, define a ação. As faixas abaixo são uma regra prática, não uma lei. Um modelo de risco regulado pode se recusar a descartar linhas que uma previsão de varejo pode dispensar.
Percentual de valores ausentes | Importância da variável | Ação |
|---|---|---|
Menos de 5% | Qualquer | Elimine essas linhas se restarem dados suficientes |
5% a 30% | Baixa | Elimine a variável |
5% a 30% | Alta | Impute usando apenas as linhas de treino |
Mais de 30% | Alta | Impute, adicione uma coluna indicadora de ausência e investigue por que o campo está em branco |
Mais de 30% | Baixa | Elimine a variável |
Alguns custos em branco num arquivo de pedidos que, fora isso, está completo correspondem à primeira linha. Excluir essas linhas prejudica menos do que inventar um preço. Um campo de pesquisa pouco usado, na faixa intermediária, não justifica um palpite preenchido, então a coluna sai. O tempo de relacionamento, que você usa para churn, fica, e você o estima.
A orientação do Google sobre preparação de dados para clustering cita três opções práticas: remover exemplos com valores ausentes, remover a variável ou prever os valores ausentes a partir de outros dados. Lacunas raras podem justificar a exclusão de linhas. Lacunas frequentes normalmente significam que você elimina a variável ou faz a imputação.
Preveja a lacuna em vez de colar uma constante
Para um campo numérico, treine uma regressão nas linhas em que o valor existe e depois estime os vazios. A idade ausente de um cliente, por exemplo, pode ser estimada a partir da renda e do tempo de relacionamento, em vez de substituída por uma única média da empresa. Isso aproveita relações em que você já confia.
O valor dos pedidos é assimétrico. Alguns tickets grandes de atacado puxam a média para cima, então preencher com a média faz cestas comuns parecerem mais valiosas do que são. A mediana fica junto do pedido típico e se move menos quando entra uma fatura de grande volume. Compare as estatísticas descritivas antes e depois do preenchimento. Uma mudança grande significa que o método está reescrevendo o negócio, e não tapando um buraco.
Em categorias, rotule o vazio como Unknown. A lacuna costuma ser o sinal: um checkout que nunca captou a região, ou um produto sem código de fornecedor. Transformar isso em um nível real mantém a linha e mostra ao modelo que o campo estava vazio de propósito.
Vazios frequentes não são raros nas operações. Um estudo de 2025 sobre dados incompletos de consumo de água descreve um conjunto de dados de edifícios com 33.888 registros horários, de fevereiro de 2019 a dezembro de 2023, com valores ausentes em 20% das horas, o que cai na faixa em que eliminar linhas de forma indiscriminada descartaria histórico demais (o estudo).
Ajuste o imputador apenas nas linhas de treino. O guia da ELECTE sobre dados ausentes detalha as opções de imputação, se você quiser uma segunda leitura sobre o método, e não sobre a ordem.
Codifique categorias e crie variáveis úteis
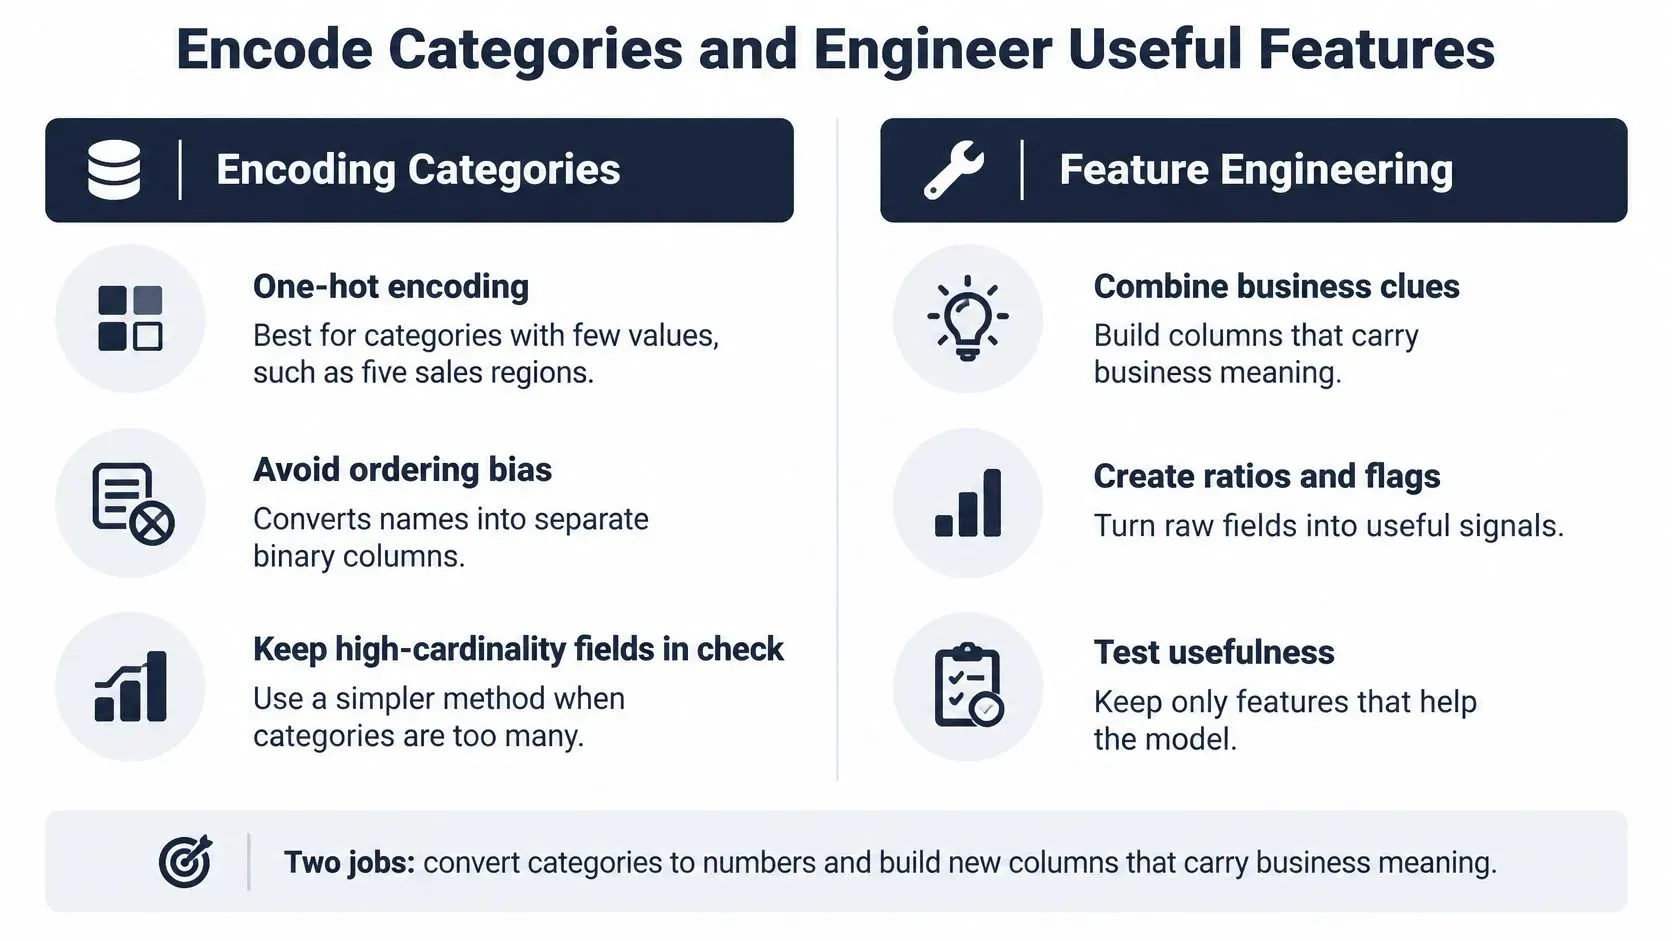
Há dois trabalhos aqui. Transformar rótulos em números que o modelo possa usar e criar colunas que respondam a uma pergunta de negócio que os campos brutos não respondem.
Codificação sem um ranking falso
A codificação one-hot serve para categorias com poucos valores, como cinco regiões de vendas. Cada região vira sua própria coluna de sim ou não, e nenhuma região é "maior" que outra.
A codificação ordinal serve para uma ordem real, como os tamanhos P, M e G. Os números correspondem a uma classificação que o negócio já usa.
Não atribua 1, 2, 3 a nomes sem ordem, como canal ou cidade. O modelo tratará um código maior como mais de alguma coisa. Esse ranking falso aparece depois como um coeficiente confiante e errado. Quando um campo tem centenas de níveis, o one-hot cria uma tabela muito larga. Agrupe os níveis raros em Other antes de codificar e defina esse agrupamento apenas nas linhas de treino.
Colunas que respondem a uma pergunta de negócio
Monte uma lista curta, ligada a uma única decisão, e não um despejo de todas as razões que você consegue calcular.
- Percentual de margem:
(price − cost) / pricemostra se uma promoção ainda cobre o custo, algo que a receita sozinha não revela. - Dias desde a última compra: uma análise de churn precisa da recência, não de mais uma cópia do ID do cliente.
- Dia da semana e mês: o planejamento de demanda considera os picos de sexta-feira e os meses sazonais, que ficam escondidos dentro de um timestamp completo.
- Média móvel de 7 dias: as unidades diárias oscilam muito. A média semanal mostra se a demanda está crescendo.
- Razão estoque/vendas: o gestor de estoque percebe uma falta se formando antes do que permitiria a simples contagem do estoque disponível.
Eu começaria com dez a quinze variáveis ligadas a essa única decisão. Elimine uma delas quando duas colunas tiverem correlação acima de 0,95, porque a segunda repete a primeira. Escreva o significado de negócio ao lado do nome da coluna no dicionário de dados. Um mapa de codificação ou uma média móvel aprendidos sobre o arquivo inteiro, incluindo linhas que você pretendia reservar para teste, repetem o vazamento que você já bloqueou na divisão dos dados.
Escale os números e controle os outliers
Um valor extremo não é automaticamente um erro. Um pedido de 40 unidades de uma conta B2B é uma venda real. Sinalize-o para que não domine uma média e mantenha-o no histórico. Um preço unitário de 100.000 digitado no lugar de 1.000 é um erro de entrada. Corrija o dígito, não o "trate" como demanda.
Verifique o valor extremo antes de excluí-lo
Duas verificações funcionam bem juntas. A regra de 1,5 × intervalo interquartil marca pontos distantes do centro da coluna. Uma verificação de domínio pergunta se o valor pode existir: estoque negativo, uma data na próxima década, um desconto maior que o preço de venda. Verifique primeiro. Depois limite nos percentis 1 e 99, aplique uma transformação logarítmica à receita assimétrica ou adicione um indicador e mantenha o número original para os relatórios.
Um pedido em grande volume que você exclui é uma receita que você nunca mais vai prever. Um erro de digitação que você mantém vira um preço que o modelo acha que os clientes pagarão.
Execute o resumo novamente após limitar os valores. O centro da coluna deve se mover muito pouco. Se a mediana saltar, o limite está fazendo trabalho demais e você deve olhar novamente as linhas de origem.
Qual escalonador combina com o perfil
O escalonamento impede que uma coluna em unidades grandes, como a receita anual, abafe uma coluna em unidades pequenas, como unidades por pedido. A documentação de pré-processamento do Scikit-learn observa que o StandardScaler centraliza cada variável na média do conjunto de treino e escala pela variância, e que isso pode ter desempenho ruim quando há muitos outliers. O RobustScaler é a alternativa direta que usa estimativas mais resistentes de centro e de amplitude.
Perfil dos dados | Escalonador | Por que se encaixa |
|---|---|---|
Aproximadamente simétrico, poucos valores extremos | StandardScaler | Centraliza na média e escala pela variância |
Muitos outliers, como pedidos em grande volume ocasionais | RobustScaler | Usa mediana e intervalo interquartil, que resistem a extremos |
Valores que precisam de um intervalo fixo, como avaliações de 1 a 5 | MinMaxScaler | Mapeia os valores para 0-1 sem alterar sua forma |
Ajuste o scaler apenas nos dados de treino e depois aplique esse ajuste à validação. Reajustá-lo no conjunto de reserva deixa que as linhas extremas da validação definam a escala. Para um olhar mais detalhado sobre como identificar valores extremos antes de escolher um tratamento, consulte o guia da ELECTE sobre outliers.
Automatize o pipeline e verifique seus resultados
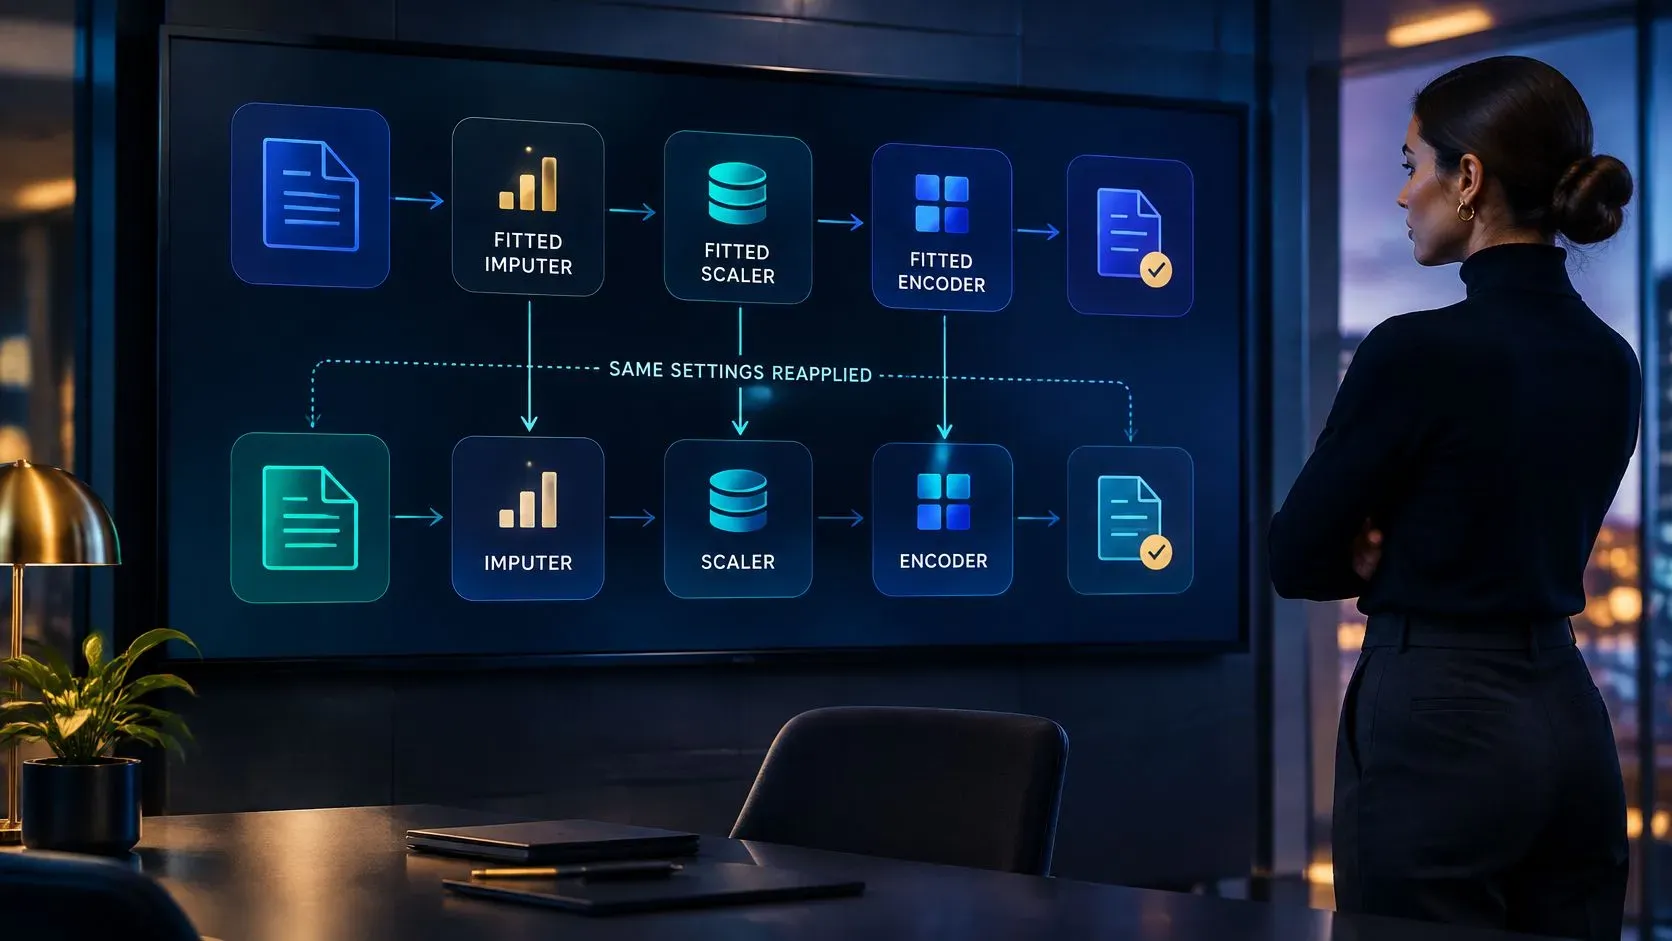
Um arquivo limpo guardado em um único notebook pode divergir entre execuções. Um novo arquivo pode receber um valor de imputação, uma codificação de categorias ou uma escala diferente, fazendo um dashboard mudar mesmo quando o negócio não mudou.
Um pipeline mantém juntos o imputador, o codificador e o escalonador já ajustados, e aplica as mesmas transformações a novos arquivos. Ajuste essas etapas usando apenas a partição de treino. Aplique as configurações ajustadas aos dados de validação e de teste sem recalculá-las. A nota da IBM sobre vazamento de dados explica por que ajustar etapas de pré-processamento sobre dados de treino e de teste juntos pode vazar informação para a avaliação.
Verificações após cada execução
Um job bem-sucedido só confirma que o processo rodou. Verifique se o resultado ainda corresponde à origem e às regras que você definiu:
- Contagem de linhas: reconcilie o arquivo carregado com a exportação, considerando as duplicatas registradas.
- Taxa de nulos por coluna: investigue qualquer aumento repentino, que pode indicar que um campo da origem deixou de chegar.
- Intervalos de valores: verifique se preços, quantidades e datas continuam dentro dos limites aceitos.
- Novas categorias: encaminhe uma região ou um SKU nunca visto para um grupo definido, em vez de descartá-lo sem aviso.
Para ver exemplos práticos de validação de dados, analise como essas verificações se aplicam a arquivos empresariais. Trate os resultados automatizados como estimativas e revise manualmente os primeiros ciclos antes de usá-los para acionar alertas.
O ELECTE, uma plataforma de análise de dados com IA para empresas em crescimento, conecta-se ao seu software de contabilidade ou a um arquivo enviado e executa análises de dados e previsões sem a necessidade de um analista. Os clientes economizam mais de 10 horas por semana ao automatizar a análise financeira. Esse ganho depende de usar etapas ajustadas que você consiga defender em uma revisão, em vez de recalculá-las a cada novo envio.
Nesta semana, escolha um conjunto de dados e passe-o pela tabela de sete linhas, marcando quais etapas ainda são manuais. Automatize as etapas repetidas, mas mantenha sob revisão as decisões de julgamento, como duplicata versus reposição real ou erro de digitação versus pedido em grande volume, até que as regras estejam estáveis.
O ELECTE conecta seus dados contábeis ou um arquivo enviado, prepara essas informações e as transforma em previsões e relatórios que você pode revisar com sua equipe. Se quiser que essas etapas de pré-processamento de dados sejam aplicadas da mesma forma em cada carga, acesse o ELECTE e veja como a plataforma executa o processo com os seus próprios números.
Comentários
Ainda não há comentários — comece a conversa.