10 strumenti di anomaly detection che valgono il tuo tempo nel 2026
Confronta 10 strumenti di anomaly detection per observability, qualità dei dati e analisi di business. Trova quello giusto e scopri come ELECTE automatizza gli insight.

Che cosa significa anomaly detection nella tua giornata? Per un SRE è una metrica del server che rompe il pattern alle 2 di notte. Per un team dati è una tabella del data warehouse che ha smesso di aggiornarsi. Per un responsabile finanziario è il flusso di cassa o il margine che si muove in un modo che nessuno sa spiegare.
Sono tre problemi diversi e richiedono tre tipi diversi di strumenti di anomaly detection. Il monitoraggio di cloud e infrastruttura osserva i sistemi. L'alerting dedicato sulle metriche osserva un insieme più ristretto di numeri. La qualità dei dati e l'observability del data warehouse verificano se i dati alla base dei tuoi report sono affidabili. Acquistare a cavallo di più categorie è il modo in cui i team finiscono per pagare una piattaforma grande il doppio del loro problema.
Conta anche il contesto. Downtime e dati errati non sono rischi astratti, e l'impatto finanziario delle interruzioni IT è il motivo per cui un allarme precoce vale più di un postmortem. Il mercato più ampio riflette questo passaggio dagli strumenti specialistici di sicurezza all'analisi di tutti i giorni: il report di Fortune Business Insights sul mercato dell'anomaly detection valuta il mercato circa 6,98 miliardi di USD nel 2025 e prevede 28,15 miliardi di USD entro il 2034.
Di seguito trovi la valutazione di un professionista su 10 opzioni, con i limiti di ciascuna, seguita da un semplice schema per aiutarti a scegliere.
1. ELECTE AI Agents
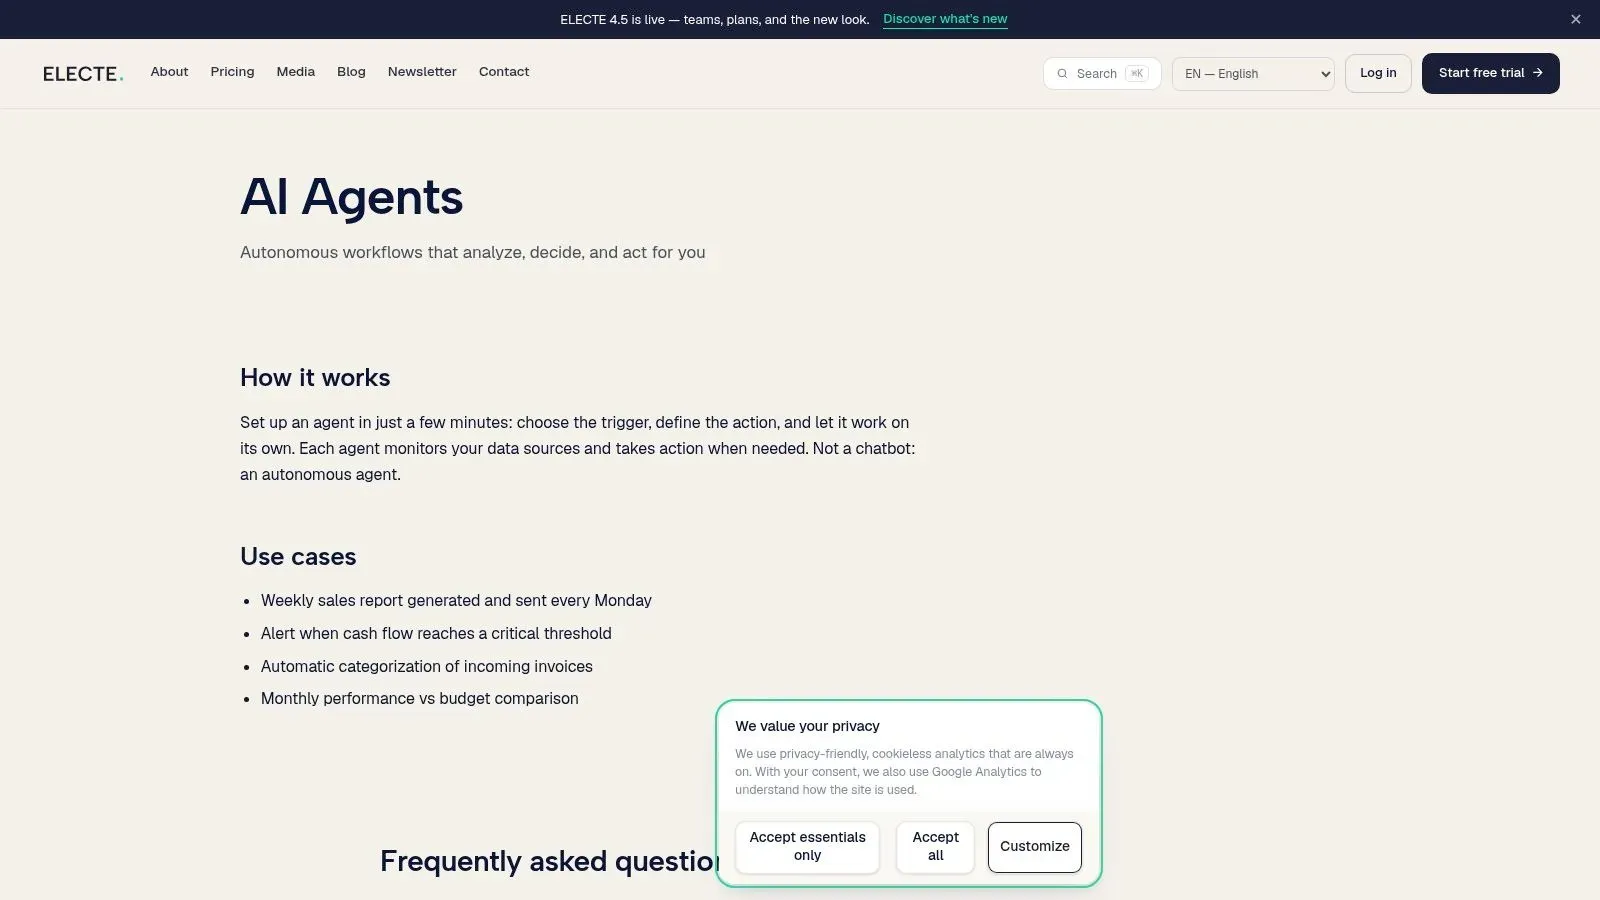
Gli strumenti di anomaly detection più in basso in questa lista monitorano sistemi, metriche e pipeline. Gli AI Agents di ELECTE osservano i dati di business, e questa distinzione decide se l'opzione fa al caso tuo. Gli agenti monitorano in continuo i dati collegati, individuano anomalie e tendenze emergenti e portano in evidenza gli insight, così il tuo team non deve passare in rassegna report su report per capire cosa è cambiato.
L'agente funziona come un analista sempre attivo, non come un chatbot in attesa di un prompt ingegnoso. Legge i tuoi dati, segnala movimenti insoliti in ricavi, transazioni, inventario o indicatori di rischio e presenta ciò che richiede attenzione in un linguaggio su cui un manager può agire. Per questo è la voce di questa lista pensata per l'anomaly detection dal punto di vista del responsabile finanziario, non dell'SRE.
Dove il modello ad agenti aiuta di più
- Monitoraggio continuo: anomalie e tendenze emergono mentre si formano, non a fine mese quando qualcuno apre finalmente un foglio di calcolo.
- Analisi azionabile: l'output spiega cosa è cambiato e perché conta, invece di fermarsi a uno scambio di domanda e risposta.
- Contesto di piattaforma più ampio: il rilevamento affianca previsioni, valutazione del rischio e reportistica, quindi un'anomalia segnalata può confluire in una revisione delle previsioni o in un report pronto per il CdA.
- Accessibile per progetto: i team senza competenze tecniche specialistiche possono lavorare direttamente con gli insight, un aspetto importante per le PMI senza un data scientist.
Due limiti meritano un'occhiata attenta. La qualità degli insight dipende dalle fonti che colleghi: l'onboarding passa da connessioni ai software di contabilità o dal caricamento di file, quindi verifica che la configurazione copra i tuoi sistemi prima di impegnarti. Conta anche la scelta del piano, perché i prezzi crescono da Starter a Enterprise e funzioni come gli insight AI illimitati e le previsioni avanzate sono nei livelli superiori.
Consiglio questa strada quando le tue anomalie si trovano nei KPI di business e non nei log dell'infrastruttura, e quando chi deve agire su un alert è un responsabile finanziario o operativo, non un ingegnere.
2. Amazon CloudWatch
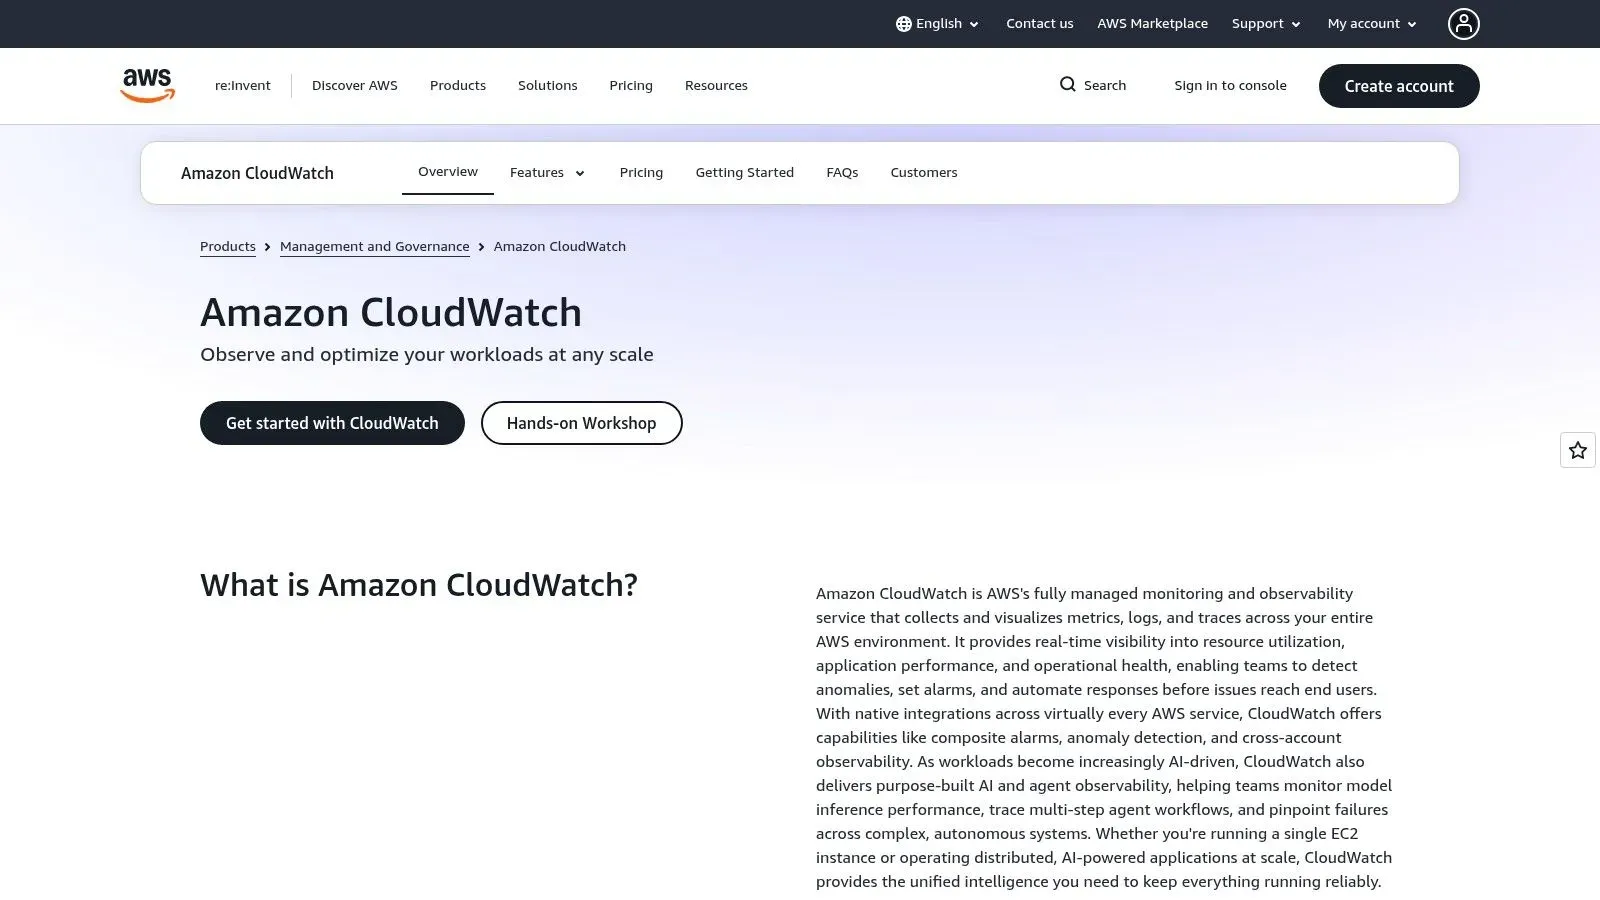
Se i tuoi carichi di lavoro girano già su AWS, Amazon CloudWatch è la strada più semplice. La sua anomaly detection sulle metriche apprende i pattern attesi dai dati storici, costruisce un intervallo atteso e permette di impostare un allarme quando una metrica ne esce. L'intervallo si adatta a tendenze e pattern orari, giornalieri e settimanali, il che è meglio di una soglia statica per servizi con picchi prevedibili.
CloudWatch copre sia le metriche fornite da AWS sia quelle personalizzate, e gli allarmi di anomalia possono essere creati a partire dai dati delle metriche e da espressioni di metric math supportate. Sul fronte dei log, CloudWatch Logs può individuare pattern nuovi o in evoluzione, e la creazione di rilevatori di anomalie nei Logs non comporta di per sé alcun costo.
- Integrazione nativa: metriche, log, dashboard e allarmi vivono già in un unico ambiente AWS.
- Allarmi, non solo grafici: le bande di anomalia si collegano all'alerting, così il rilevamento arriva a un ingegnere in reperibilità.
Il compromesso è l'ambito. Si tratta di telemetria operativa, non di analisi di business generale, e configurazione e interpretazione possono risultare ostiche per chi non è tecnico. Anche i modelli di anomalia sulle metriche e gli allarmi possono generare costi AWS, quindi il numero di modelli va tenuto sotto controllo man mano che si cresce.
3. Datadog Watchdog
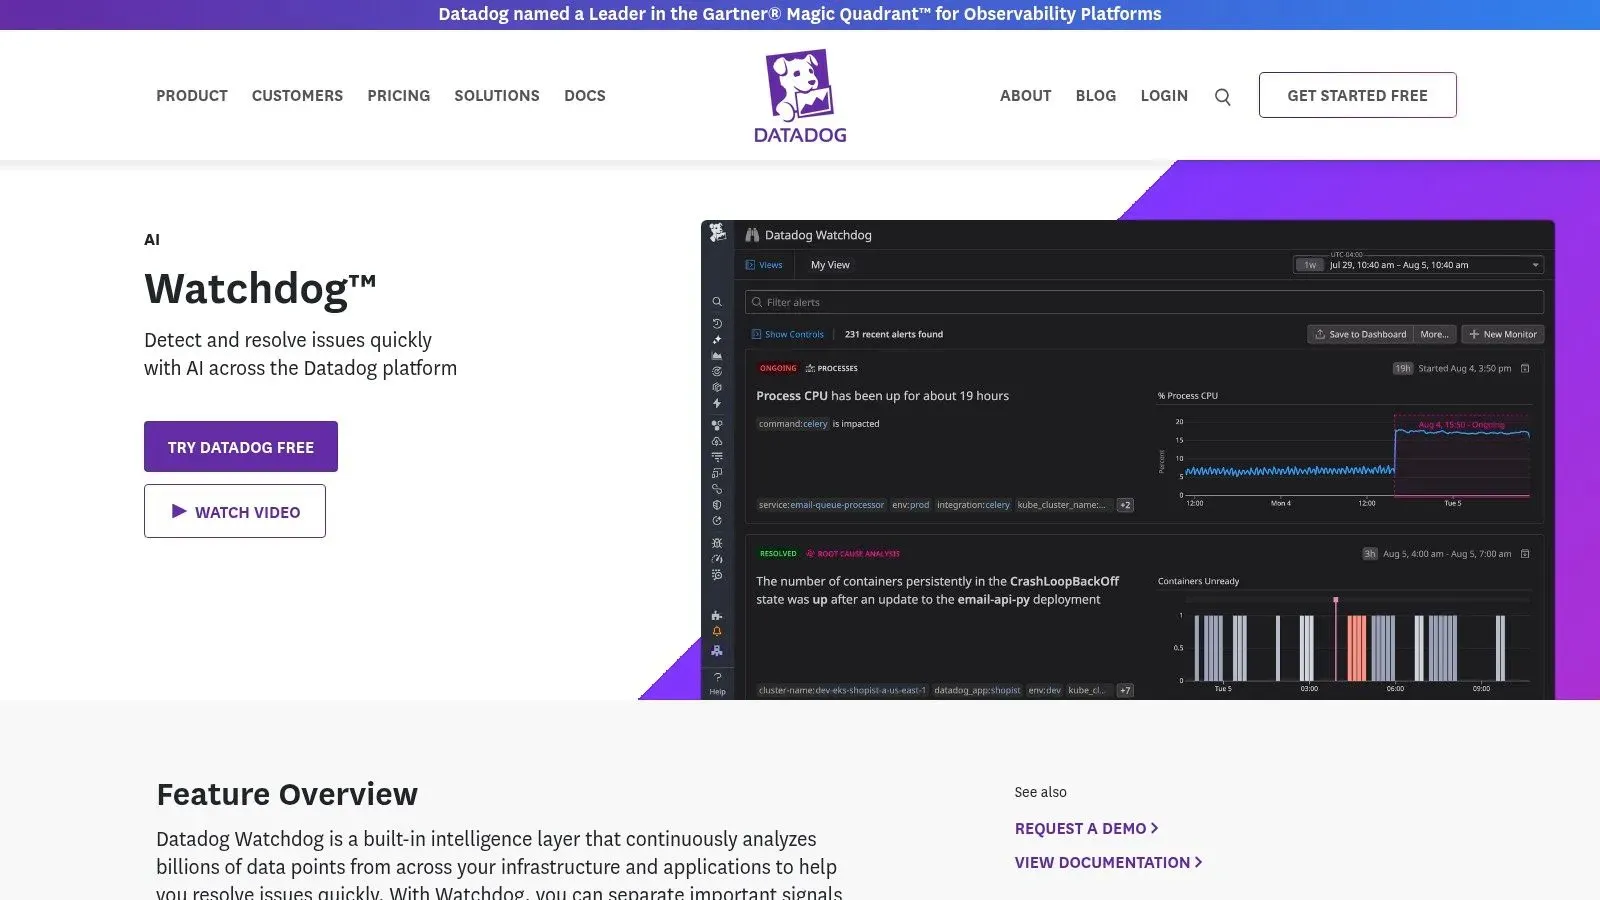
Datadog Watchdog è ciò che ottieni quando l'anomaly detection è integrata in una piattaforma di observability completa invece di essere aggiunta dopo. Osserva infrastruttura, prestazioni delle applicazioni, log e telemetria dell'esperienza utente, poi evidenzia comportamenti insoliti e possibili fattori concorrenti durante un incidente.
Watchdog rileva anomalie nelle metriche, outlier e superamenti di soglia basati su previsioni. Il suo vero punto di forza è la correlazione. Quando la latenza ha un picco, i segnali correlati dei vari prodotti Datadog compaiono uno accanto all'altro, così un ingegnere può passare dal sintomo alla causa probabile senza mettere insieme console separate. Una prova gratuita di 14 giorni permette di testare questo flusso di lavoro sulla tua telemetria.
Un alert senza contesto di indagine sposta soltanto il lavoro. È la correlazione che trasforma un picco in una diagnosi.
Il problema sono i costi. Il prezzo cresce con host, prodotti monitorati, metriche personalizzate e volume di dati, e alcune funzioni avanzate dipendono dal piano. Inoltre è pensato per l'observability tecnica, non per l'analisi di business. Se la tua domanda riguarda vendite o margini, parti dagli insight sull'anomaly detection per il 2026 e da uno strumento orientato al business.
4. New Relic
New Relic si guadagna un posto qui per come si lascia valutare. Il piano gratuito include 100 GB di dati in ingresso al mese e un utente con accesso all'intera piattaforma, senza una prova a scadenza. Un piccolo team può far girare carichi di lavoro reali, capire come funzionano gli alert e decidere sulla base di evidenze anziché di una presentazione commerciale.
La piattaforma riunisce telemetria di applicazioni, infrastruttura e log con query e dashboard. Le condizioni di alert possono usare il rilevamento dinamico delle anomalie, che adatta le soglie al variare del comportamento dei dati e riduce la taratura manuale richiesta dalle soglie statiche. New Relic offre un'ampia libreria di integrazioni indicate dal fornitore, quindi molti stack comuni si collegano senza sviluppi personalizzati.
- Una vera valutazione gratuita: i piccoli team possono verificare l'adeguatezza prima di qualsiasi discussione di budget.
- Un costo ben visibile: i prezzi pubblicati per i dati in ingresso rendono prevedibile una delle voci di spesa principali.
Prevedibile non significa economico. Il prezzo cresce con i dati acquisiti, con gli accessi degli utenti e, a volte, con il calcolo avanzato, quindi il conto sale man mano che conservi più telemetria. Il compromesso da valutare: se ti serve il rilevamento delle anomalie solo su poche metriche, paghi prezzi da piattaforma per una sola funzione. Uno strumento di alerting dedicato spesso svolge quel compito a un costo inferiore. Come Datadog, parla il linguaggio della telemetria tecnica, non dell'analisi di business: un team finance che cerca derive nei ricavi troverà lo strumento sbagliato per la sua domanda.
5. Elastic
Elastic è adatto ai team che vogliono controllo e hanno gli specialisti per esercitarlo. I suoi job di machine learning modellano il comportamento normale in serie temporali e altri dati supportati, poi segnalano le deviazioni con un punteggio di anomalia. Le regole di sicurezza possono generare un alert quando le anomalie superano un punteggio scelto da te, rendendo Elastic utile sia per l'observability sia per i flussi di sicurezza.
Questo approccio ha radici profonde. Il rilevamento basato sulle anomalie nasce nella sicurezza informatica negli anni Ottanta, e una rassegna sull'intrusion detection ospitata da Princeton descrive IDES, pubblicato nel 1987, come uno dei primi sistemi a profilare l'attività normale e a generare alert in tempo reale. Elastic applica lo stesso principio su scala moderna. Prima si caratterizza il normale, poi si segnala la deviazione significativa.
Cosa valutare prima di impegnarti
- Flessibilità: controlli la progettazione dei job, il punteggio e il modo in cui i risultati alimentano ricerca e alerting.
- Vantaggio dello stack esistente: se Elastic già gestisce la tua ricerca, aggiungere il rilevamento è un passo incrementale.
I costi sono operativi. La configurazione dei job e l'amministrazione continua possono richiedere specialisti, l'alerting sulle anomalie richiede una sottoscrizione o un livello di progetto idoneo, e i modelli hanno bisogno di dati storici sufficienti prima di diventare affidabili.
6. Google Cloud Monitoring
Per i team che hanno standardizzato su Google Cloud, Google Cloud Monitoring è la scelta naturale, come CloudWatch lo è per AWS. Monitora le metriche tra progetti e risorse, supporta metriche personalizzate e gestite e usa gli ambiti delle metriche per tenere sotto controllo più progetti da un unico punto.
Le regole di alerting instradano le notifiche attraverso canali come email, SMS, Slack e PagerDuty, coprendo la maggior parte delle configurazioni di reperibilità senza strumenti aggiuntivi. I prezzi sono a consumo, con quote mensili gratuite pubblicate per alcuni dati, così puoi stimare i costi prima che i volumi ti sorprendano.
- Sensato per chi usa GCP: nessun nuovo fornitore, nessuna nuova strategia per gli agent, nessuno spostamento di dati tra cloud.
- Quote trasparenti: i livelli gratuiti per alcuni dati rendono l'adozione iniziale a basso rischio.
Però bisogna essere precisi sull'adeguatezza. Si tratta di monitoraggio delle operazioni cloud, non di un sistema di controllo per KPI di business come vendite o scorte. I costi dipendono dall'acquisizione dei dati e da altri utilizzi, e configurazione e interpretazione possono richiedere competenze cloud che il tuo team potrebbe non avere internamente. Verifica in un progetto pilota i flussi specifici di rilevamento delle anomalie rispetto alle tue esigenze di alerting, perché una buona capacità generale di monitoraggio non garantisce il comportamento di rilevamento che desideri.
7. Anomaly.io
Non tutti i team hanno bisogno di una suite. Anomaly.io fa una cosa sola. Invii le metriche, impara i pattern nel tempo, rileva trend, correlazioni e altre deviazioni, e invia alert con un contesto in linguaggio semplice tramite canali come email, SMS e PagerDuty.
Due dettagli lo rendono pratico. Il feedback su alert rilevanti o irrilevanti regola il rilevamento futuro, affrontando direttamente l'alert fatigue. Inoltre i prezzi pubblici indicano limiti di metriche e velocità di rilevamento, così conosci i confini prima di integrarlo. Accetta metriche da diversi linguaggi di programmazione, mantenendo semplice la strumentazione.
Regola pratica: giudica un sistema di rilevamento dagli alert che il tuo team riesce davvero a esaminare ogni giorno, non solo dai punteggi nei benchmark.
Questa focalizzazione ha due facce. È un servizio di metriche, non una piattaforma completa di analisi di business o di reporting, e il rilevamento dipende dall'invio di dati adatti e dal tempo concesso per apprendere i pattern. Prima di impegnarti, verifica integrazioni attuali, adeguatezza del servizio e modalità di supporto. Se stai ancora scegliendo il metodo, confronta gli algoritmi di anomaly detection per serie temporali prima di tutto, perché l'algoritmo deve corrispondere alla stagionalità e alla forma dei tuoi dati.
8. Anomalo
Immagina che le tue dashboard sembrino a posto, ma nessuno si fidi dei numeri. È il problema per cui è stato creato Anomalo. Monitora le tabelle del data warehouse, usa il machine learning per individuare pattern insoliti e controlla aggiornamento, volume, dati mancanti e anomalie nelle tabelle prima che i dati errati arrivino a un report.
A fare la differenza è la combinazione di rilevamento appreso e regole esplicite. I controlli di validazione no-code convivono con le opzioni SQL e API personalizzate, così un analista può codificare una regola di business mentre i modelli sorvegliano i cambiamenti che nessuno aveva pensato di specificare. Le visualizzazioni e le funzioni di analisi delle cause radice aiutano poi a risalire da una tabella segnalata a ciò che è cambiato.
- Due livelli di difesa: Sono coperti sia i cambiamenti inattesi sia le regole di business note.
- Oltre gli ingegneri: I controlli no-code permettono agli analisti di gestire direttamente una parte del monitoraggio.
- Una prova dal retail: Un caso di studio nel retail descrive il monitoraggio di vendite, inventario e dati di prodotto.
Il problema è l'accesso. Anomalo è orientato alle grandi aziende e in genere richiede una demo, invece di un semplice acquisto self-service. L'adattamento dipende anche dalle fonti dati supportate e dalla configurazione del data warehouse, quindi conviene verificare la compatibilità fin da subito.
9. Bigeye
Bigeye considera il rilevamento delle anomalie parte dell'osservabilità dei dati, non un flusso di allarmi isolato. Analizza i dati, rileva le anomalie nel loro comportamento e combina il monitoraggio con lineage, validazione, riconciliazione e gestione degli incidenti. Quando qualcosa si rompe, il lineage mostra quali report e utenti a valle sono coinvolti.
La gestione degli alert è curata. Gli alert correlati vengono raggruppati in issue, i flussi di indagine mantengono ordinato il triage e il feedback sugli alert può migliorare la pertinenza di quelli futuri. Questo ciclo di feedback conta perché la fiducia decide se un team continua a usare un sistema di rilevamento. Un recente studio di Nature sul rilevamento di anomalie negli ERP ha riportato una precisione dell'88,56% anche dopo che il voto d'insieme (ensemble) aveva ridotto i falsi positivi: un promemoria del fatto che la gestione del rumore è una funzionalità, non un ripensamento.
Il deployment prevede approcci con agent e senza agent, e la documentazione sulla sicurezza descrive la crittografia più AWS PrivateLink opzionale per l'Enterprise. I limiti riguardano target e trasparenza. Bigeye è pensato per i team dati delle grandi aziende, richiede una configurazione tecnica e connessioni ai sistemi dati, e non pubblica i prezzi. Per approfondire la disciplina di fondo, intercettare i dati errati prima del reporting spiega perché i controlli sul warehouse proteggono ogni decisione a valle.
10. Monte Carlo
Monte Carlo chiude l'elenco nella categoria dell'osservabilità dei dati e il suo punto di forza è il contesto d'impatto. Rileva problemi di freschezza, volume, schema e distribuzione dei dati, poi usa il lineage per mostrare cosa dipende dall'asset interessato. Un ingegnere che indaga su una tabella non aggiornata può vedere quali dashboard alimenta prima che se ne accorgano gli stakeholder.
La copertura si estende ad asset dati, sistemi e modifiche legate al codice, con gestione degli incidenti e integrazioni per instradare i problemi nei flussi di lavoro esistenti. Per le organizzazioni con pipeline consolidate e team dati dedicati, questa vista delle dipendenze accorcia la distanza tra rilevamento e risoluzione.
- Indagine connessa: Le anomalie arrivano con il contesto di dipendenze e impatto già allegato.
- Ampia copertura dell'affidabilità: Le categorie di guasto più comuni sono riunite in un'unica piattaforma.
I limiti sono simili a quelli degli altri. È progettato per l'affidabilità della data platform, non per semplici analisi di business destinate a team non tecnici. Il valore dipende anche dalla scala e dalla complessità del patrimonio di dati: un piccolo warehouse con tre pipeline trae meno vantaggio dal lineage di uno molto esteso. I prezzi non sono pubblici e la valutazione è guidata dal fornitore, quindi per definire il budget serve una conversazione con il reparto vendite.
Punti chiave per scegliere lo strumento giusto e ottenere risultati concreti
Partite dal compito da svolgere, non dall'elenco dei fornitori. Un team può acquistare un sistema di monitoraggio dell'infrastruttura per rispondere a domande di business, oppure un sistema di observability per il data warehouse quando basterebbe un semplice alert su una metrica. Prima di confrontare le funzionalità, abbinate la categoria alla decisione che dovete prendere.
Un metodo di selezione in quattro passaggi
- Abbinate lo strumento ai vostri dati. Le metriche di infrastruttura portano a CloudWatch, Datadog, New Relic, Elastic o Google Cloud Monitoring. Le tabelle del data warehouse portano ad Anomalo, Bigeye o Monte Carlo. I KPI di business richiedono una piattaforma pensata per il business.
- Verificate l'integrazione con ciò che usate già. Un sistema di rilevamento che non riesce a leggere i vostri dati cloud, del warehouse o contabili crea un'altra pipeline da mantenere. Controllate connettori e requisiti sui dati storici durante un pilota su dati reali.
- Controllate come il prezzo cresce con il volume. Ingestione, host, metriche personalizzate e tabelle monitorate aumentano nel tempo. Simulate il costo al doppio del volume attuale prima di firmare.
- Verificate che i colleghi non tecnici sappiano agire sugli alert. Un punteggio di anomalia da solo non dice a un responsabile finanziario cosa fare. Cercate spiegazioni in linguaggio chiaro, cause probabili e un passo successivo definito.
L'implementazione non è il traguardo. I cambiamenti normali, tra cui promozioni, lanci di prodotto e comportamenti dei clienti in evoluzione, spostano la vostra baseline. Una analisi di Future AGI sulle modalità di errore del rilevamento di anomalie indica il concept drift e la scarsità di anomalie etichettate come problemi che i benchmark spesso non rilevano. Chiedete a ogni fornitore chi approva le modifiche alla baseline, come viene raccolto il feedback e se è possibile annullare un adattamento sbagliato.
Un sistema di rilevamento con un recall leggermente inferiore può creare più valore se riduce l'affaticamento da alert e spiega quale azione è richiesta.
Un'azienda in crescita senza un team dati può evitare la complessità dell'infrastruttura e monitorare direttamente le metriche di business. ELECTE, una piattaforma di analisi dei dati basata su AI, monitora i dati aziendali, individua le anomalie, evidenzia i trend e genera report. La maggior parte degli utenti è operativa in meno di 5 minuti dopo aver collegato il software di contabilità o caricato un file.
Affiancate ai vostri dati aziendali un analista sempre attivo, invece dell'ennesima dashboard che nessuno controlla. ELECTE monitora i vostri numeri, segnala anomalie e trend appena emergono e li trasforma in insight e report chiari su cui il vostro team può agire. Collegate il software di contabilità o caricate un file per vedere subito la vostra prima previsione.
Commenti
Ancora nessun commento — inizia tu la conversazione.