10 เครื่องมือตรวจจับความผิดปกติที่น่าลงทุนเวลาในปี 2026
เปรียบเทียบเครื่องมือตรวจจับความผิดปกติ 10 รายการสำหรับ observability คุณภาพข้อมูล และการวิเคราะห์ธุรกิจ เลือกให้เหมาะกับงานของคุณ และดูว่า ELECTE ช่วยสร้างอินไซต์อัตโนมัติได้อย่างไร

การตรวจจับความผิดปกติมีความหมายอย่างไรในงานประจำวันของคุณ? สำหรับ SRE คือเมตริกของเซิร์ฟเวอร์ที่ผิดแพทเทิร์นตอนตี 2 สำหรับทีมข้อมูล คือตารางในคลังข้อมูลที่หยุดอัปเดต สำหรับผู้จัดการฝ่ายการเงิน คือกระแสเงินสดหรือมาร์จิ้นที่เปลี่ยนไปโดยไม่มีใครอธิบายได้
นี่คือปัญหาสามแบบที่ต่างกัน และต้องใช้เครื่องมือตรวจจับความผิดปกติคนละประเภท การเฝ้าติดตามระบบคลาวด์และโครงสร้างพื้นฐานดูแลตัวระบบ การแจ้งเตือนเมตริกโดยเฉพาะดูแลตัวเลขชุดที่แคบกว่า ส่วนคุณภาพข้อมูลและ observability ของคลังข้อมูลตรวจสอบว่าข้อมูลเบื้องหลังรายงานของคุณเชื่อถือได้หรือไม่ การซื้อข้ามหมวดหมู่คือสาเหตุที่หลายทีมจ่ายเงินให้แพลตฟอร์มที่ใหญ่กว่าปัญหาของตัวเองถึงสองเท่า
บริบทก็สำคัญเช่นกัน ระบบล่มและข้อมูลผิดพลาดไม่ใช่ความเสี่ยงที่เป็นนามธรรม และผลกระทบทางการเงินจากการหยุดชะงักของระบบไอทีคือเหตุผลที่การเตือนล่วงหน้าดีกว่าการทำ postmortem ตลาดโดยรวมสะท้อนการเปลี่ยนจากเครื่องมือด้านความปลอดภัยเฉพาะทางมาสู่การวิเคราะห์ในงานประจำวัน โดยรายงานตลาดการตรวจจับความผิดปกติของ Fortune Business Insights ประเมินมูลค่าตลาดที่ประมาณ 6.98 พันล้านดอลลาร์สหรัฐในปี 2025 และคาดการณ์ว่าจะถึง 28.15 พันล้านดอลลาร์สหรัฐภายในปี 2034
ด้านล่างคือการประเมินจากมุมมองผู้ปฏิบัติงานสำหรับ 10 ตัวเลือก พร้อมข้อจำกัดตามจริงของแต่ละรายการ และตามด้วยกรอบการตัดสินใจง่าย ๆ เพื่อช่วยคุณเลือก
1. ELECTE AI Agents
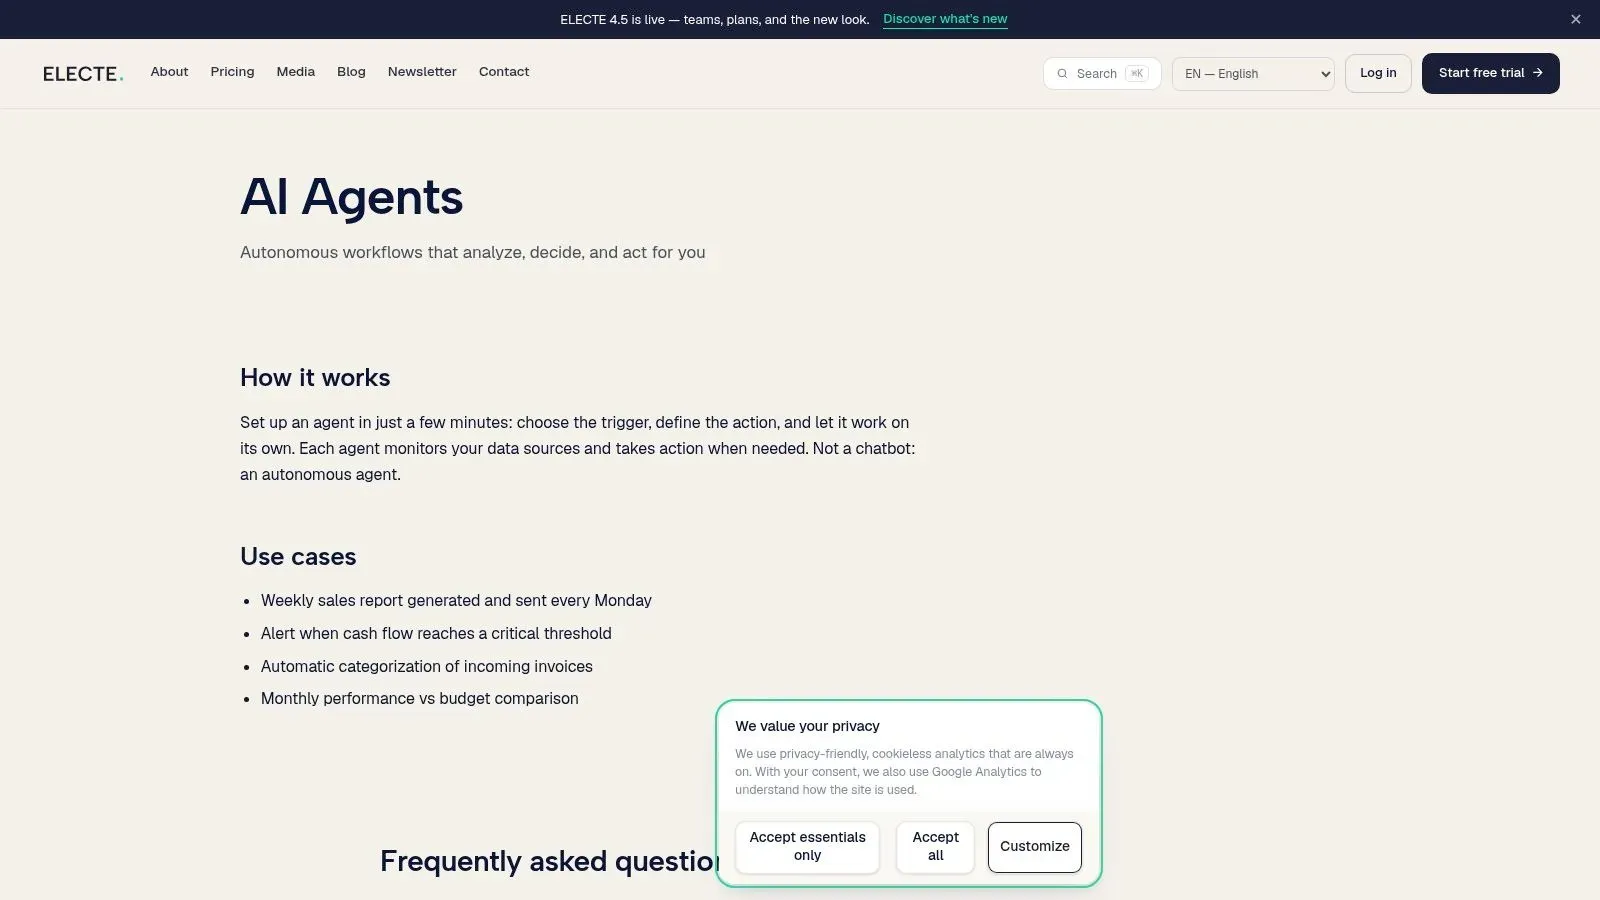
เครื่องมือตรวจจับความผิดปกติในลำดับถัดไปของรายการนี้เฝ้าติดตามระบบ เมตริก และไปป์ไลน์ ส่วนAI Agents ของ ELECTEเฝ้าดูข้อมูลทางธุรกิจ และความแตกต่างนี้เองที่ตัดสินว่าตัวเลือกนี้เหมาะกับคุณหรือไม่ เอเจนต์จะติดตามข้อมูลที่เชื่อมต่อไว้อย่างต่อเนื่อง ระบุความผิดปกติและแนวโน้มที่เพิ่งเกิดขึ้น และนำเสนออินไซต์ เพื่อให้ทีมของคุณไม่ต้องไล่เปิดรายงานทีละฉบับเพื่อหาว่าอะไรเปลี่ยนไป
เอเจนต์ทำงานเหมือนนักวิเคราะห์ที่ออนไลน์ตลอดเวลา ไม่ใช่แชทบอทที่รอพรอมต์ฉลาด ๆ มันอ่านข้อมูลของคุณ ชี้การเคลื่อนไหวที่ผิดปกติของรายได้ ธุรกรรม สินค้าคงคลัง หรือตัวชี้วัดความเสี่ยง และนำเสนอสิ่งที่ต้องให้ความสนใจด้วยภาษาที่ผู้จัดการนำไปลงมือทำได้ จึงเป็นรายการในลิสต์นี้ที่เน้นการตรวจจับความผิดปกติในแบบของผู้จัดการฝ่ายการเงิน ไม่ใช่แบบของ SRE
จุดที่โมเดลเอเจนต์ช่วยได้มากที่สุด
- การเฝ้าติดตามต่อเนื่อง: ความผิดปกติและแนวโน้มจะปรากฏทันทีที่เกิดขึ้น ไม่ใช่ตอนสิ้นเดือนที่ใครสักคนเพิ่งเปิดสเปรดชีต
- การวิเคราะห์ที่นำไปปฏิบัติได้: ผลลัพธ์อธิบายว่าอะไรเปลี่ยนไปและสำคัญอย่างไร แทนที่จะจบแค่การถามตอบผ่านพรอมต์
- บริบทของแพลตฟอร์มที่กว้างกว่า: การตรวจจับทำงานควบคู่กับการพยากรณ์ การประเมินความเสี่ยง และการทำรายงาน ความผิดปกติที่ถูกชี้จึงนำไปสู่การปรับพยากรณ์หรือรายงานระดับบอร์ดได้
- ออกแบบให้เข้าถึงง่าย: ทีมที่ไม่มีทักษะเทคนิคเฉพาะทางก็ใช้อินไซต์ได้โดยตรง ซึ่งสำคัญสำหรับ SME ที่ไม่มีนักวิทยาศาสตร์ข้อมูล
มีข้อจำกัดสองข้อที่ควรพิจารณาให้ดี ข้อแรก คุณภาพของอินไซต์ขึ้นอยู่กับแหล่งข้อมูลที่คุณเชื่อมต่อ การเริ่มต้นใช้งานทำผ่านการเชื่อมต่อกับซอฟต์แวร์บัญชีหรือการอัปโหลดไฟล์ ดังนั้นควรตรวจสอบให้แน่ใจว่าการตั้งค่าครอบคลุมระบบของคุณก่อนตัดสินใจใช้งาน ข้อที่สอง การเลือกแพ็กเกจก็สำคัญ เพราะราคาปรับตามระดับตั้งแต่ Starter ถึง Enterprise และความสามารถอย่าง AI อินไซต์แบบไม่จำกัดและการพยากรณ์ขั้นสูงจะอยู่ในแพ็กเกจระดับสูง
ฉันแนะนำแนวทางนี้เมื่อความผิดปกติของคุณอยู่ใน KPI ทางธุรกิจ ไม่ใช่ในล็อกของโครงสร้างพื้นฐาน และเมื่อผู้ที่ต้องลงมือจัดการเมื่อมีการแจ้งเตือนเป็นผู้จัดการฝ่ายการเงินหรือฝ่ายปฏิบัติการ ไม่ใช่วิศวกร
2. Amazon CloudWatch
หาก workload ของคุณรันบน AWS อยู่แล้ว Amazon CloudWatch คือทางที่ง่ายที่สุด ฟีเจอร์ตรวจจับความผิดปกติของเมตริกจะเรียนรู้รูปแบบที่คาดไว้จากข้อมูลย้อนหลัง สร้างช่วงค่าที่คาดหวัง และให้คุณตั้งการแจ้งเตือนเมื่อเมตริกออกนอกช่วงนั้น ช่วงค่านี้ปรับตามแนวโน้มและรูปแบบรายชั่วโมง รายวัน และรายสัปดาห์ ซึ่งดีกว่าเกณฑ์คงที่สำหรับบริการที่มีช่วงพีกที่คาดเดาได้
CloudWatch ครอบคลุมทั้งเมตริกที่ AWS จัดให้และเมตริกแบบกำหนดเอง และสามารถสร้างการแจ้งเตือนความผิดปกติจากข้อมูลเมตริกและนิพจน์คณิตศาสตร์ของเมตริกที่รองรับได้ ในส่วนของล็อก CloudWatch Logs สามารถระบุรูปแบบใหม่หรือรูปแบบที่เปลี่ยนไปได้ และการสร้างตัวตรวจจับความผิดปกติของ Logs ไม่มีค่าใช้จ่ายในตัวเอง
- เข้ากับระบบเดิมโดยตรง: เมตริก ล็อก แดชบอร์ด และการแจ้งเตือนอยู่ในสภาพแวดล้อม AWS เดียวกันอยู่แล้ว
- มีการแจ้งเตือน ไม่ใช่แค่กราฟ: แถบความผิดปกติเชื่อมกับระบบแจ้งเตือน ทำให้การตรวจจับไปถึงวิศวกรที่เข้าเวร
ข้อแลกเปลี่ยนคือขอบเขต เครื่องมือนี้เน้นเทเลเมทรีด้านการปฏิบัติการ ไม่ใช่การวิเคราะห์ธุรกิจทั่วไป และการตั้งค่าตลอดจนการตีความอาจดูยุ่งยากสำหรับผู้ใช้ที่ไม่ใช่สายเทคนิค โมเดลตรวจจับความผิดปกติของเมตริกและการแจ้งเตือนอาจมีค่าใช้จ่าย AWS เพิ่มด้วย จึงต้องคอยดูจำนวนโมเดลเมื่อขยายระบบ
3. Datadog Watchdog
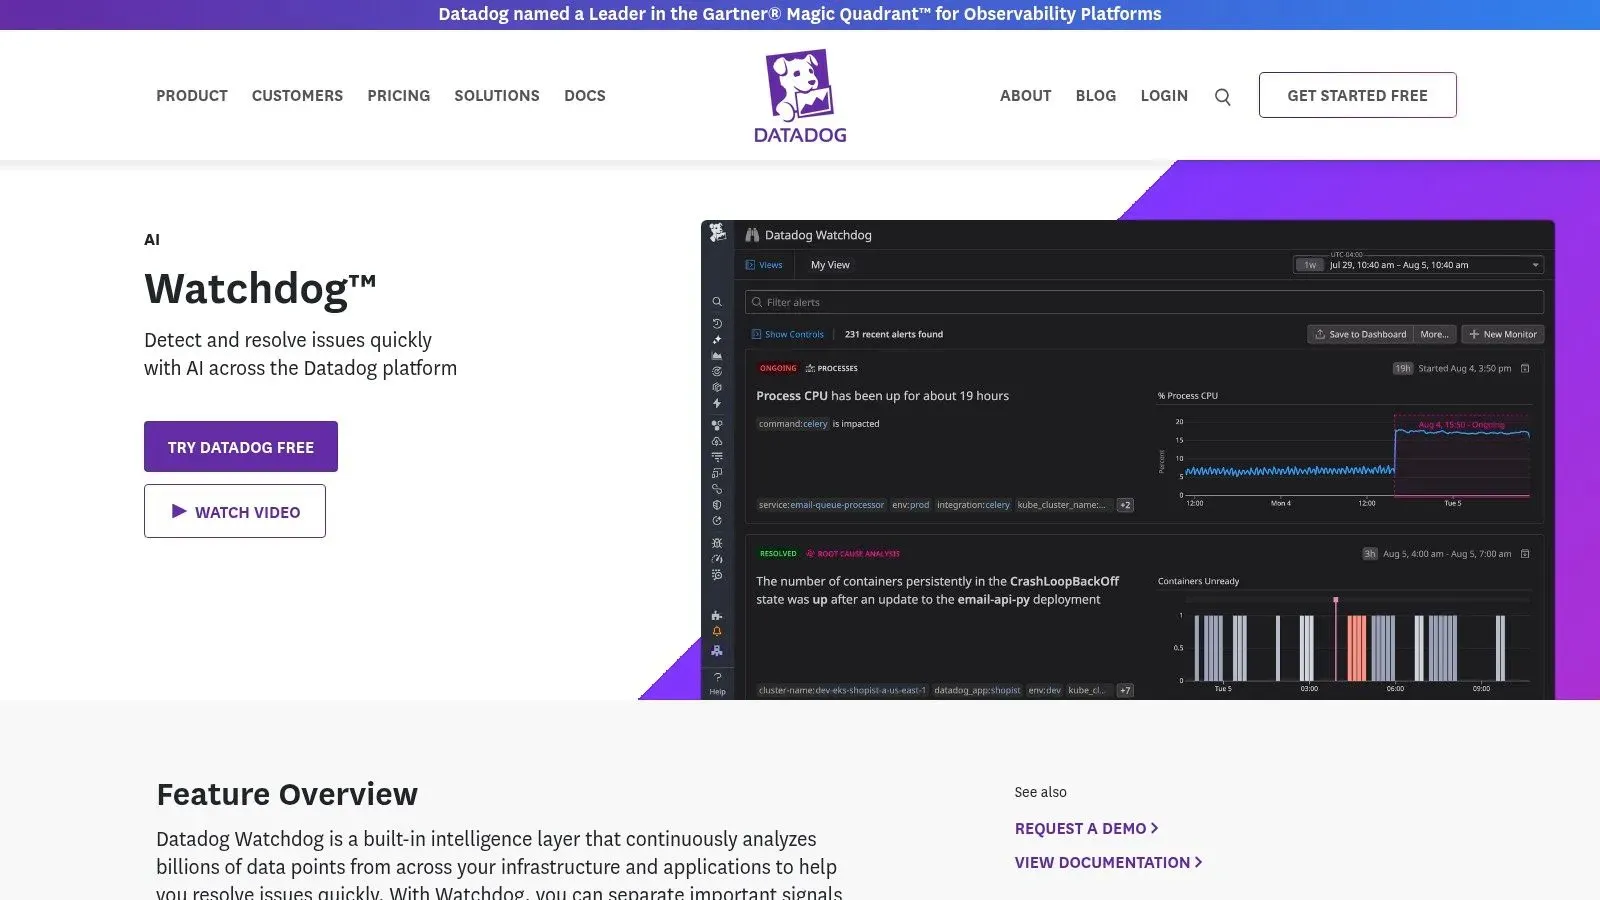
Datadog Watchdog คือสิ่งที่คุณได้เมื่อการตรวจจับความผิดปกติถูกสร้างไว้ในแพลตฟอร์ม observability เต็มรูปแบบ ไม่ใช่ส่วนที่ต่อเติมเข้ามา เครื่องมือนี้เฝ้าดูโครงสร้างพื้นฐาน ประสิทธิภาพแอปพลิเคชัน ล็อก และเทเลเมทรีด้านประสบการณ์ผู้ใช้ แล้วชี้ให้เห็นพฤติกรรมที่ผิดปกติและปัจจัยที่อาจเกี่ยวข้องระหว่างเกิดเหตุการณ์
Watchdog ตรวจจับความผิดปกติของเมตริก ค่านอกเกณฑ์ และการข้ามเกณฑ์ตามการพยากรณ์ จุดแข็งที่แท้จริงคือการหาความสัมพันธ์ เมื่อค่าความหน่วงพุ่งสูง สัญญาณที่เกี่ยวข้องจากผลิตภัณฑ์ต่าง ๆ ของ Datadog จะแสดงอยู่ข้างกัน วิศวกรจึงไล่จากอาการไปสู่สาเหตุที่น่าจะเป็นได้โดยไม่ต้องไล่ดูหลายคอนโซลแยกกัน ทดลองใช้ฟรี 14 วัน ให้คุณทดสอบขั้นตอนนี้กับเทเลเมทรีของคุณเอง
การแจ้งเตือนที่ไม่มีบริบทสำหรับการสืบสวนก็แค่ย้ายงานไปที่อื่น การหาความสัมพันธ์คือสิ่งที่เปลี่ยนค่าที่พุ่งขึ้นให้กลายเป็นการวินิจฉัย
ต้นทุนคือข้อเสีย ราคาเพิ่มขึ้นตามจำนวนโฮสต์ ผลิตภัณฑ์ที่ใช้มอนิเตอร์ เมตริกแบบกำหนดเอง และปริมาณข้อมูล และความสามารถขั้นสูงบางอย่างขึ้นอยู่กับแพ็กเกจของคุณ อีกทั้งยังสร้างมาเพื่อ observability ทางเทคนิค ไม่ใช่การวิเคราะห์ธุรกิจ หากคำถามของคุณเกี่ยวกับยอดขายหรืออัตรากำไร ให้เริ่มจากอินไซต์การตรวจจับความผิดปกติสำหรับปี 2026 และเครื่องมือที่เน้นธุรกิจ
4. New Relic
New Relic ติดอันดับในรายการนี้ด้วยเกณฑ์การประเมินเป็นหลัก แพ็กเกจฟรีรวม ข้อมูลนำเข้า 100 GB ต่อเดือนและผู้ใช้แบบเต็มแพลตฟอร์ม 1 คน โดยไม่มีระยะทดลองใช้ที่หมดอายุ ทีมขนาดเล็กจึงรันเวิร์กโหลดจริง เรียนรู้รูปแบบการแจ้งเตือน และตัดสินใจจากหลักฐาน ไม่ใช่จากสไลด์ของฝ่ายขาย
แพลตฟอร์มนี้รวมข้อมูลเทเลเมทรีของแอปพลิเคชัน โครงสร้างพื้นฐาน และล็อกเข้าด้วยกัน พร้อมการสืบค้นและแดชบอร์ด เงื่อนไขการแจ้งเตือนสามารถใช้ การตรวจจับความผิดปกติแบบไดนามิก ซึ่งปรับเกณฑ์ตามพฤติกรรมของข้อมูลที่เปลี่ยนไปตามเวลา จึงลดงานปรับค่าด้วยมือที่เกณฑ์แบบคงที่ต้องใช้ New Relic มีไลบรารีอินทิเกรชันกว้างขวางตามที่ผู้ให้บริการระบุ ทำให้สแตกทั่วไปจำนวนมากเชื่อมต่อได้โดยไม่ต้องเขียนโค้ดเชื่อมเอง
- ทดลองใช้ฟรีจริง: ทีมขนาดเล็กตรวจสอบความเหมาะสมได้ก่อนเริ่มคุยเรื่องงบประมาณ
- ปัจจัยต้นทุนที่มองเห็นได้: ราคาข้อมูลนำเข้าที่เปิดเผยทำให้คาดการณ์ค่าใช้จ่ายหลักข้อหนึ่งได้
คาดการณ์ได้ไม่ได้แปลว่าถูก ราคาปรับตามปริมาณข้อมูลนำเข้า สิทธิ์การเข้าถึงของผู้ใช้ และบางครั้งรวมถึงการประมวลผลขั้นสูง ยิ่งเก็บเทเลเมทรีมาก ค่าใช้จ่ายยิ่งสูงขึ้น ข้อแลกเปลี่ยนที่ควรชั่งน้ำหนัก: หากคุณต้องการตรวจจับความผิดปกติกับเมตริกเพียงไม่กี่ตัว คุณก็กำลังจ่ายราคาระดับแพลตฟอร์มเพื่อฟีเจอร์เดียว เครื่องมือแจ้งเตือนเฉพาะทางมักทำงานนี้ได้ในราคาที่ถูกกว่า เช่นเดียวกับ Datadog เครื่องมือนี้พูดภาษาของเทเลเมทรีเชิงเทคนิค ไม่ใช่การวิเคราะห์ธุรกิจ ทีมการเงินที่มองหาความเบี่ยงเบนของรายได้จะพบว่าเป็นเครื่องมือที่ไม่ตรงกับคำถาม
5. Elastic
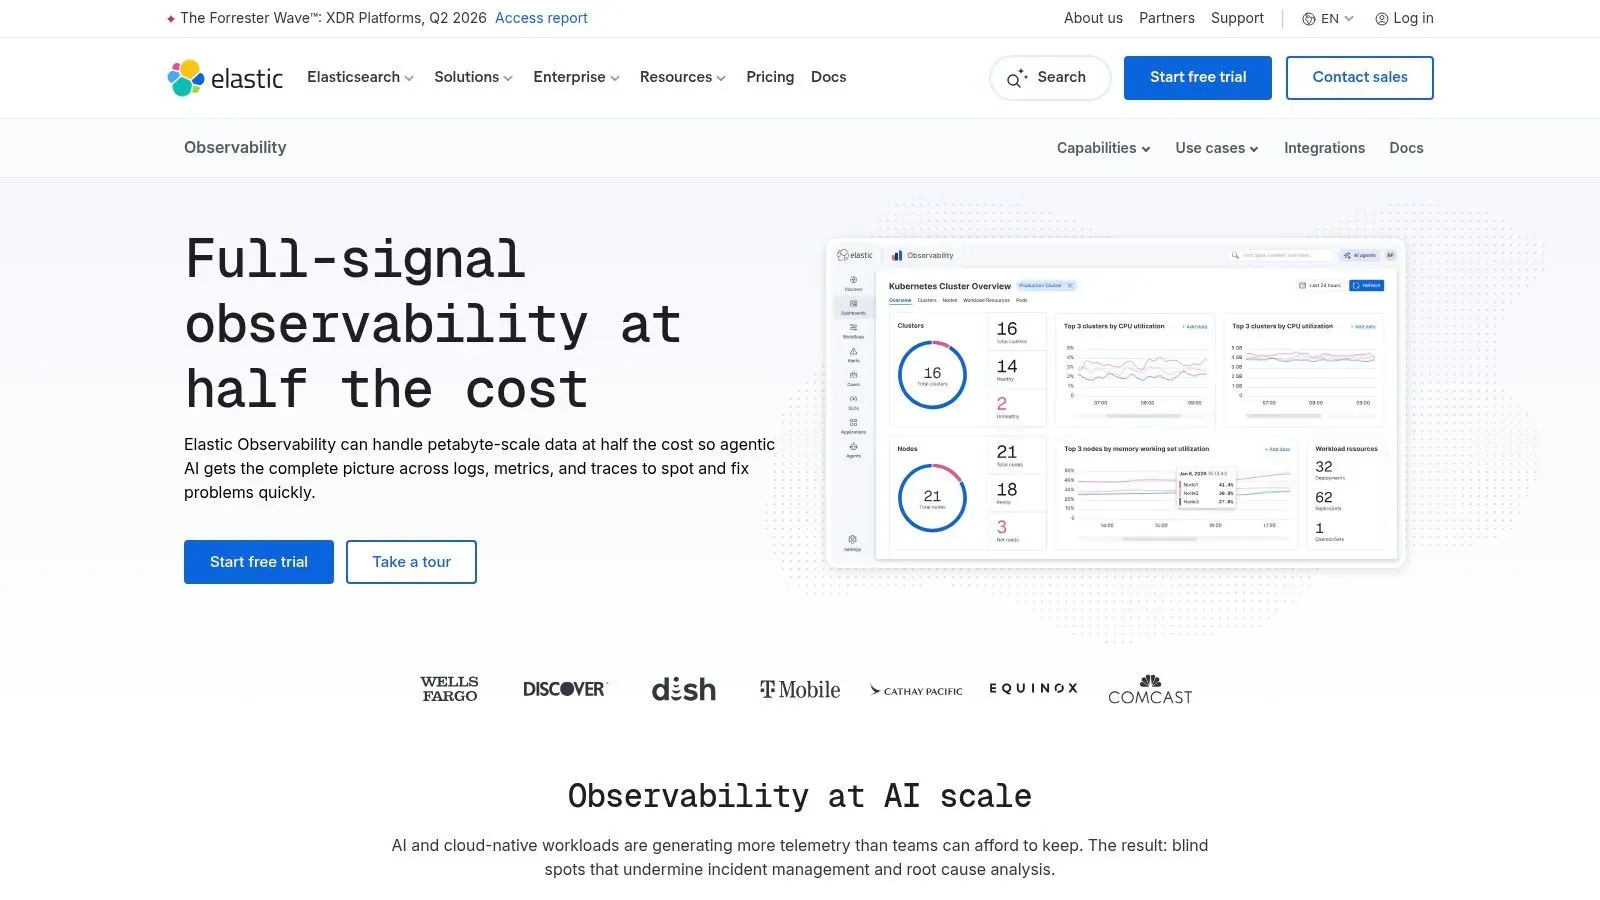
Elastic เหมาะกับทีมที่ต้องการควบคุมได้เต็มที่และมีผู้เชี่ยวชาญพร้อมใช้งาน งานแมชชีนเลิร์นนิงของ Elastic สร้างแบบจำลองพฤติกรรมปกติในข้อมูลอนุกรมเวลาและข้อมูลประเภทอื่นที่รองรับ แล้วแจ้งส่วนที่เบี่ยงเบนพร้อมคะแนนความผิดปกติ กฎด้านความปลอดภัยสามารถแจ้งเตือนเมื่อความผิดปกติเกินคะแนนที่คุณกำหนด ทำให้ Elastic มีประโยชน์ทั้งในงาน observability และงานด้านความปลอดภัย
แนวทางนี้มีรากฐานยาวนาน การตรวจจับตามความผิดปกติเริ่มก่อตัวในวงการความปลอดภัยคอมพิวเตอร์ช่วงทศวรรษ 1980 และงานสำรวจการตรวจจับการบุกรุกที่โฮสต์โดยพรินซ์ตันอธิบายว่า IDES ซึ่งเผยแพร่ในปี 1987 เป็นระบบยุคแรกที่สร้างโปรไฟล์กิจกรรมปกติและสร้างการแจ้งเตือนแบบเรียลไทม์ Elastic ใช้หลักการเดียวกันในระดับขนาดสมัยใหม่ คือกำหนดลักษณะของสิ่งที่ปกติก่อน แล้วแจ้งเมื่อเบี่ยงเบนอย่างมีนัยสำคัญ
สิ่งที่ควรพิจารณาก่อนตัดสินใจ
- ความยืดหยุ่น: คุณควบคุมการออกแบบงาน การให้คะแนน และวิธีที่ผลลัพธ์ไหลเข้าสู่การค้นหาและการแจ้งเตือนได้เอง
- ข้อได้เปรียบจากสแตกเดิม: หาก Elastic ขับเคลื่อนระบบค้นหาของคุณอยู่แล้ว การเพิ่มการตรวจจับก็เป็นการต่อยอดเพียงเล็กน้อย
ต้นทุนอยู่ที่การดำเนินงาน การตั้งค่างานและการดูแลระบบต่อเนื่องอาจต้องใช้ผู้เชี่ยวชาญ การแจ้งเตือนความผิดปกติต้องใช้การสมัครสมาชิกหรือระดับโปรเจกต์ที่มีสิทธิ์ และแบบจำลองต้องการข้อมูลย้อนหลังที่เพียงพอก่อนจึงจะเชื่อถือได้
6. Google Cloud Monitoring
สำหรับทีมที่ใช้ Google Cloud เป็นมาตรฐาน Google Cloud Monitoring เป็นตัวเลือกเริ่มต้นที่เป็นธรรมชาติ เช่นเดียวกับ CloudWatch สำหรับ AWS โดยตรวจสอบเมตริกข้ามโปรเจกต์และทรัพยากร รองรับเมตริกแบบกำหนดเองและแบบที่ระบบจัดการให้ และใช้ metrics scope เพื่อให้คุณดูหลายโปรเจกต์ได้จากที่เดียว
กฎการแจ้งเตือนส่งการแจ้งเตือนผ่านหลายช่องทาง รวมถึง อีเมล, SMS, Slack และ PagerDuty ซึ่งครอบคลุมการตั้งค่าเวรเฝ้าระบบส่วนใหญ่โดยไม่ต้องใช้เครื่องมือเพิ่มเติม ราคาคิดตามการใช้งาน และมีโควตาฟรีรายเดือนที่เผยแพร่ไว้สำหรับข้อมูลบางประเภท คุณจึงประเมินค่าใช้จ่ายล่วงหน้าได้ ก่อนที่ปริมาณข้อมูลจะสร้างความประหลาดใจ
- เหมาะกับองค์กรที่ใช้ GCP: ไม่ต้องเพิ่มผู้ให้บริการใหม่ ไม่ต้องวางกลยุทธ์เอเจนต์ใหม่ และไม่ต้องย้ายข้อมูลข้ามคลาวด์
- โควตาฟรีที่โปร่งใส: แพ็กเกจฟรีสำหรับข้อมูลบางประเภททำให้เริ่มใช้งานได้โดยมีความเสี่ยงต่ำ
แต่ต้องระบุความเหมาะสมให้ชัดเจน นี่คือการมอนิเตอร์การปฏิบัติการบนคลาวด์ ไม่ใช่เครื่องมือเฝ้าดู KPI ทางธุรกิจ เช่น ยอดขายหรือสินค้าคงคลัง ค่าใช้จ่ายขึ้นอยู่กับการนำเข้าข้อมูลและการใช้งานอื่น ๆ และการตั้งค่ารวมถึงการตีความอาจต้องใช้ความเชี่ยวชาญด้านคลาวด์ที่ทีมของคุณอาจไม่มีภายในองค์กร ควรตรวจสอบเวิร์กโฟลว์ตรวจจับความผิดปกติที่ต้องการให้ตรงกับความต้องการด้านการแจ้งเตือนในช่วงทดลองใช้ เพราะความแข็งแกร่งด้านการมอนิเตอร์โดยทั่วไปไม่ได้รับประกันพฤติกรรมการตรวจจับที่คุณต้องการ
7. Anomaly.io
ไม่ใช่ทุกทีมที่ต้องการชุดเครื่องมือครบวงจร Anomaly.io ทำงานเพียงอย่างเดียว คุณส่งเมตริกเข้าไป ระบบจะเรียนรู้รูปแบบเมื่อเวลาผ่านไป ตรวจจับแนวโน้ม ความสัมพันธ์ และความเบี่ยงเบนอื่น ๆ แล้วส่งการแจ้งเตือนพร้อมบริบทที่อ่านเข้าใจง่ายผ่านช่องทางต่าง ๆ เช่น อีเมล ข้อความ และ PagerDuty
มีสองจุดที่ทำให้ใช้งานได้จริง ได้แก่ ฟีดแบ็กว่าการแจ้งเตือนใดเกี่ยวข้องหรือไม่เกี่ยวข้องจะปรับการตรวจจับในอนาคต ซึ่งแก้ปัญหาการแจ้งเตือนมากเกินไปโดยตรง อีกทั้งราคาที่เปิดเผยต่อสาธารณะยังระบุขีดจำกัดของเมตริกและความเร็วในการตรวจจับ คุณจึงรู้ขอบเขตก่อนเชื่อมต่อ รองรับเมตริกจากหลายภาษาโปรแกรม ทำให้การติดตั้งเครื่องมือวัดเป็นเรื่องง่าย
หลักปฏิบัติ: ประเมินตัวตรวจจับจากจำนวนการแจ้งเตือนที่ทีมของคุณตรวจสอบได้จริงต่อวัน ไม่ใช่จากคะแนนเบนช์มาร์กเพียงอย่างเดียว
จุดเน้นนี้มีทั้งข้อดีและข้อจำกัด มันเป็นบริการเมตริก ไม่ใช่แพลตฟอร์มวิเคราะห์ธุรกิจหรือจัดทำรายงานแบบครบวงจร และการตรวจจับขึ้นอยู่กับการส่งข้อมูลที่เหมาะสมและการให้เวลาระบบเรียนรู้รูปแบบ ก่อนตัดสินใจ ควรตรวจสอบการเชื่อมต่อ ความเหมาะสมของบริการ และข้อตกลงด้านการสนับสนุนในปัจจุบัน หากคุณยังเลือกวิธีไม่ได้ ให้เปรียบเทียบอัลกอริทึมตรวจจับความผิดปกติของอนุกรมเวลาก่อน เพราะอัลกอริทึมควรสอดคล้องกับฤดูกาลและลักษณะข้อมูลของคุณ
8. Anomalo
สมมติว่าแดชบอร์ดของคุณดูปกติดี แต่ไม่มีใครเชื่อถือตัวเลข นั่นคือปัญหาที่ Anomalo ถูกสร้างมาเพื่อแก้ โดยมอนิเตอร์ตารางในคลังข้อมูล ใช้แมชชีนเลิร์นนิงตรวจจับรูปแบบที่ผิดปกติ และตรวจสอบความสดใหม่ ปริมาณ ข้อมูลที่ขาดหาย และความผิดปกติของตารางก่อนที่ข้อมูลเสียจะไปถึงรายงาน
จุดต่างคือการผสมผสานระหว่างการตรวจจับที่เรียนรู้เองกับกฎที่กำหนดชัดเจน การตรวจสอบแบบโนโค้ดทำงานร่วมกับ SQL แบบกำหนดเองและตัวเลือก API เพื่อให้นักวิเคราะห์ใส่กฎทางธุรกิจได้ ขณะที่โมเดลคอยจับการเปลี่ยนแปลงที่ไม่มีใครคิดจะระบุไว้ จากนั้นการแสดงภาพและฟีเจอร์สืบหาสาเหตุหลักจะช่วยให้คุณย้อนรอยจากตารางที่ถูกแจ้งเตือนไปยังสิ่งที่เปลี่ยนแปลง
- ป้องกันสองชั้น: ครอบคลุมทั้งการเปลี่ยนแปลงที่ไม่คาดคิดและกฎทางธุรกิจที่ทราบอยู่แล้ว
- ไม่จำกัดเฉพาะวิศวกร: การตรวจสอบแบบไม่ต้องเขียนโค้ดช่วยให้นักวิเคราะห์ดูแลการมอนิเตอร์บางส่วนได้โดยตรง
- ตัวอย่างจากธุรกิจค้าปลีก: กรณีศึกษาจากธุรกิจค้าปลีกอธิบายการมอนิเตอร์ข้อมูลยอดขาย สินค้าคงคลัง และสินค้า
อุปสรรคอยู่ที่การเข้าถึง Anomalo มุ่งเน้นลูกค้าองค์กรและโดยทั่วไปต้องขอเดโม ไม่ได้ซื้อแบบบริการตนเองได้ง่ายๆ ความเหมาะสมยังขึ้นอยู่กับแหล่งข้อมูลที่รองรับและการตั้งค่าคลังข้อมูลของคุณ ดังนั้นควรตรวจสอบความเข้ากันได้ตั้งแต่เนิ่นๆ
9. Bigeye
Bigeye มองการตรวจจับความผิดปกติเป็นส่วนหนึ่งของ data observability ไม่ใช่สตรีมการแจ้งเตือนที่แยกขาดจากกัน โดยจะทำโปรไฟล์ข้อมูล ตรวจจับความผิดปกติในพฤติกรรมของข้อมูล และรวมการมอนิเตอร์เข้ากับlineage การตรวจสอบความถูกต้อง การกระทบยอด และการจัดการเหตุการณ์ เมื่อมีบางอย่างขัดข้อง lineage จะแสดงว่ารายงานและผู้ใช้ปลายทางรายใดได้รับผลกระทบ
การจัดการการแจ้งเตือนทำได้อย่างรอบคอบ การแจ้งเตือนที่เกี่ยวข้องกันจะถูกจัดกลุ่มเป็นประเด็น เวิร์กโฟลว์การตรวจสอบช่วยให้การคัดกรองเป็นระเบียบ และฟีดแบ็กต่อการแจ้งเตือนช่วยเพิ่มความเกี่ยวข้องของการแจ้งเตือนในอนาคต วงจรฟีดแบ็กนี้สำคัญ เพราะความเชื่อมั่นเป็นตัวตัดสินว่าทีมจะใช้ตัวตรวจจับต่อไปหรือไม่ งานวิจัยใน Nature เกี่ยวกับการตรวจจับความผิดปกติใน ERP ล่าสุดรายงานค่า precision 88.56% แม้หลังการโหวตแบบ ensemble ลดผลบวกลวงแล้ว ซึ่งย้ำเตือนว่าการจัดการสัญญาณรบกวนเป็นฟีเจอร์หลัก ไม่ใช่เรื่องที่คิดทีหลัง
การติดตั้งมีทั้งแบบใช้เอเจนต์และไม่ใช้เอเจนต์ และเอกสารด้านความปลอดภัยระบุถึงการเข้ารหัสพร้อม AWS PrivateLink แบบเลือกใช้สำหรับ Enterprise ข้อจำกัดอยู่ที่กลุ่มเป้าหมายและความโปร่งใส Bigeye เหมาะกับทีมข้อมูลระดับองค์กร ต้องตั้งค่าทางเทคนิคและเชื่อมต่อกับระบบข้อมูล และไม่แสดงราคาต่อสาธารณะ สำหรับหลักการพื้นฐาน บทความการจับข้อมูลเสียก่อนทำรายงานอธิบายว่าเหตุใดการตรวจสอบในคลังข้อมูลจึงปกป้องทุกการตัดสินใจที่ตามมา
10. Monte Carlo
Monte Carlo ปิดท้ายรายการในหมวด data observability จุดแข็งคือบริบทของผลกระทบ โดยตรวจจับปัญหาด้านความสดใหม่ ปริมาณ สคีมา และการกระจายตัวของข้อมูล แล้วใช้ lineage แสดงว่าอะไรพึ่งพาแอสเซ็ตที่ได้รับผลกระทบ วิศวกรที่ตรวจสอบตารางที่ข้อมูลล้าสมัยจะเห็นได้ว่าตารางนั้นป้อนข้อมูลให้แดชบอร์ดใดบ้าง ก่อนที่ผู้มีส่วนได้ส่วนเสียจะสังเกตเห็น
ความครอบคลุมขยายไปทั่วแอสเซ็ตข้อมูล ระบบ และการเปลี่ยนแปลงที่เกี่ยวข้องกับโค้ด พร้อมการจัดการเหตุการณ์และการเชื่อมต่อเพื่อส่งปัญหาเข้าสู่เวิร์กโฟลว์ที่มีอยู่ สำหรับองค์กรที่มีไปป์ไลน์ที่มั่นคงและมีทีมข้อมูลเฉพาะ มุมมองความเชื่อมโยงนี้ช่วยย่นระยะจากการตรวจพบไปสู่การแก้ไข
- การตรวจสอบที่เชื่อมโยงกัน: ความผิดปกติมาพร้อมบริบทของความเชื่อมโยงและผลกระทบ
- ครอบคลุมความน่าเชื่อถือในวงกว้าง: ความล้มเหลวประเภทที่พบบ่อยอยู่ในแพลตฟอร์มเดียว
ข้อจำกัดคล้ายกับเครื่องมือคู่แข่งในกลุ่มเดียวกัน เครื่องมือนี้ออกแบบมาเพื่อความน่าเชื่อถือของแพลตฟอร์มข้อมูล ไม่ใช่การวิเคราะห์ธุรกิจแบบง่ายสำหรับทีมที่ไม่ใช่สายเทคนิค คุณค่าที่ได้ยังขึ้นอยู่กับขนาดและความซับซ้อนของระบบข้อมูลของคุณ เพราะคลังข้อมูลขนาดเล็กที่มีเพียงสามไปป์ไลน์จะได้ประโยชน์จาก lineage น้อยกว่าระบบขนาดใหญ่ที่ซับซ้อน ราคาไม่มีการเปิดเผยต่อสาธารณะ และการประเมินนำโดยผู้ให้บริการ ดังนั้นการหาข้อมูลงบประมาณจึงต้องคุยกับทีมขาย
สรุปประเด็นสำคัญสำหรับการเลือกเครื่องมือและใช้งานให้เกิดผลจริง
เริ่มจากงานที่ต้องทำ ไม่ใช่รายชื่อผู้ให้บริการ ทีมอาจซื้อเครื่องมือมอนิเตอร์โครงสร้างพื้นฐานเพื่อตอบคำถามทางธุรกิจ หรือซื้อระบบ observability สำหรับคลังข้อมูล ทั้งที่การแจ้งเตือนจากเมตริกพื้นฐานก็เพียงพอ ควรเลือกประเภทเครื่องมือให้ตรงกับการตัดสินใจที่ต้องทำก่อนจะเปรียบเทียบฟีเจอร์
กรอบการเลือกเครื่องมือ 4 ขั้นตอน
- เลือกเครื่องมือให้ตรงกับข้อมูลของคุณ เมตริกโครงสร้างพื้นฐานเหมาะกับ CloudWatch, Datadog, New Relic, Elastic หรือ Google Cloud Monitoring ตารางในคลังข้อมูลเหมาะกับ Anomalo, Bigeye หรือ Monte Carlo ส่วน KPI ทางธุรกิจเหมาะกับแพลตฟอร์มที่ออกแบบสำหรับผู้ใช้ฝั่งธุรกิจ
- ตรวจสอบการเชื่อมต่อกับระบบที่คุณใช้อยู่ ตัวตรวจจับที่อ่านข้อมูลจากคลาวด์ คลังข้อมูล หรือระบบบัญชีของคุณไม่ได้ จะกลายเป็นอีกไปป์ไลน์ที่ต้องดูแล ควรตรวจสอบตัวเชื่อมต่อและข้อกำหนดด้านข้อมูลย้อนหลังระหว่างการทดลองใช้กับข้อมูลจริง
- ตรวจสอบว่าราคาเพิ่มตามปริมาณอย่างไร ปริมาณข้อมูลที่นำเข้า จำนวนโฮสต์ เมตริกแบบกำหนดเอง และตารางที่มอนิเตอร์ ล้วนเพิ่มขึ้นตามเวลา ควรคำนวณค่าใช้จ่ายที่ปริมาณเป็นสองเท่าของปัจจุบันก่อนเซ็นสัญญา
- ยืนยันว่าเพื่อนร่วมทีมที่ไม่ใช่สายเทคนิคลงมือแก้ไขตามการแจ้งเตือนได้ คะแนนความผิดปกติเพียงอย่างเดียวไม่ได้บอกผู้จัดการฝ่ายการเงินว่าต้องทำอะไร ควรมองหาคำอธิบายด้วยภาษาที่เข้าใจง่าย สาเหตุที่เป็นไปได้ และขั้นตอนถัดไปที่ชัดเจน
การติดตั้งใช้งานไม่ใช่เส้นชัย การเปลี่ยนแปลงตามปกติ เช่น โปรโมชัน การเปิดตัวผลิตภัณฑ์ และพฤติกรรมลูกค้าที่เปลี่ยนไป ทำให้ค่าฐานเปลี่ยนตามไปด้วย บทวิเคราะห์ของ Future AGI เกี่ยวกับรูปแบบความล้มเหลวของการตรวจจับความผิดปกติ ระบุว่า concept drift และความขาดแคลนของความผิดปกติที่มีป้ายกำกับ เป็นปัญหาที่การเปรียบเทียบเบนช์มาร์กมักมองข้าม ควรถามผู้ให้บริการทุกรายว่าใครอนุมัติการเปลี่ยนค่าฐาน รับฟีดแบ็กอย่างไร และย้อนกลับการปรับตัวที่ผิดพลาดได้หรือไม่
ตัวตรวจจับที่มี recall ต่ำกว่าเล็กน้อยอาจสร้างคุณค่าได้มากกว่า หากลดความล้าจากการแจ้งเตือนและอธิบายได้ว่าต้องทำอะไร
บริษัทที่กำลังเติบโตและไม่มีทีมข้อมูลสามารถข้ามความซับซ้อนของโครงสร้างพื้นฐาน แล้วมอนิเตอร์เมตริกทางธุรกิจได้โดยตรง ELECTE เป็นแพลตฟอร์มวิเคราะห์ข้อมูลที่ขับเคลื่อนด้วย AI ที่มอนิเตอร์ข้อมูลธุรกิจ ระบุความผิดปกติ แสดงแนวโน้ม และสร้างรายงาน ผู้ใช้ส่วนใหญ่พร้อมใช้งานภายใน ไม่ถึง 5 นาที หลังเชื่อมต่อซอฟต์แวร์บัญชีหรืออัปโหลดไฟล์
ให้นักวิเคราะห์ที่ทำงานตลอดเวลาดูแลข้อมูลธุรกิจของคุณ แทนที่จะมีแดชบอร์ดอีกอันที่ไม่มีใครเปิดดู ELECTE มอนิเตอร์ตัวเลขของคุณ แจ้งความผิดปกติและแนวโน้มทันทีที่เกิดขึ้น และเปลี่ยนให้เป็นข้อมูลเชิงลึกและรายงานที่ชัดเจนซึ่งทีมของคุณนำไปลงมือทำได้ เชื่อมต่อซอฟต์แวร์บัญชีหรืออัปโหลดไฟล์ แล้วดูการพยากรณ์แรกของคุณได้ทันที
ความคิดเห็น
ยังไม่มีความคิดเห็น — เริ่มการสนทนาได้เลย