10 інструментів для виявлення аномалій, які варто розглянути у 2026 році
Порівняйте 10 інструментів для виявлення аномалій: observability, якість даних і бізнес-аналітика. Знайдіть те, що підходить саме вам, і дізнайтеся, як ELECTE автоматизує аналітичні висновки.

Що означає виявлення аномалій у вашій щоденній роботі? Для SRE-інженера це метрика сервера, що вийшла за звичну поведінку о другій ночі. Для команди даних — таблиця в сховищі, яка перестала оновлюватися. Для фінансового менеджера — грошовий потік або маржа, що змінюються так, як ніхто не може пояснити.
Це три різні задачі, і для них потрібні три різні типи інструментів для виявлення аномалій. Моніторинг хмари та інфраструктури стежить за системами. Спеціалізовані сервіси сповіщень про метрики стежать за вужчим набором показників. Інструменти якості даних і observability сховищ перевіряють, чи можна довіряти даним, на яких побудовані ваші звіти. Купувати інструменти з різних категорій означає платити за платформу вдвічі більшу, ніж потрібно для вашої задачі.
Важливий і контекст. Простої та неякісні дані — не абстрактні ризики, а фінансові наслідки IT-збоїв якраз і пояснюють, чому раннє попередження краще за розбір інциденту постфактум. Ширший ринок відображає перехід від вузькоспеціалізованих інструментів безпеки до повсякденної аналітики: звіт Fortune Business Insights про ринок виявлення аномалій оцінює його приблизно в 6,98 млрд доларів США у 2025 році і прогнозує 28,15 млрд доларів США до 2034 року.
Нижче — практична оцінка 10 варіантів із чесним описом обмежень кожного, а далі — простий алгоритм вибору.
1. ELECTE AI Agents
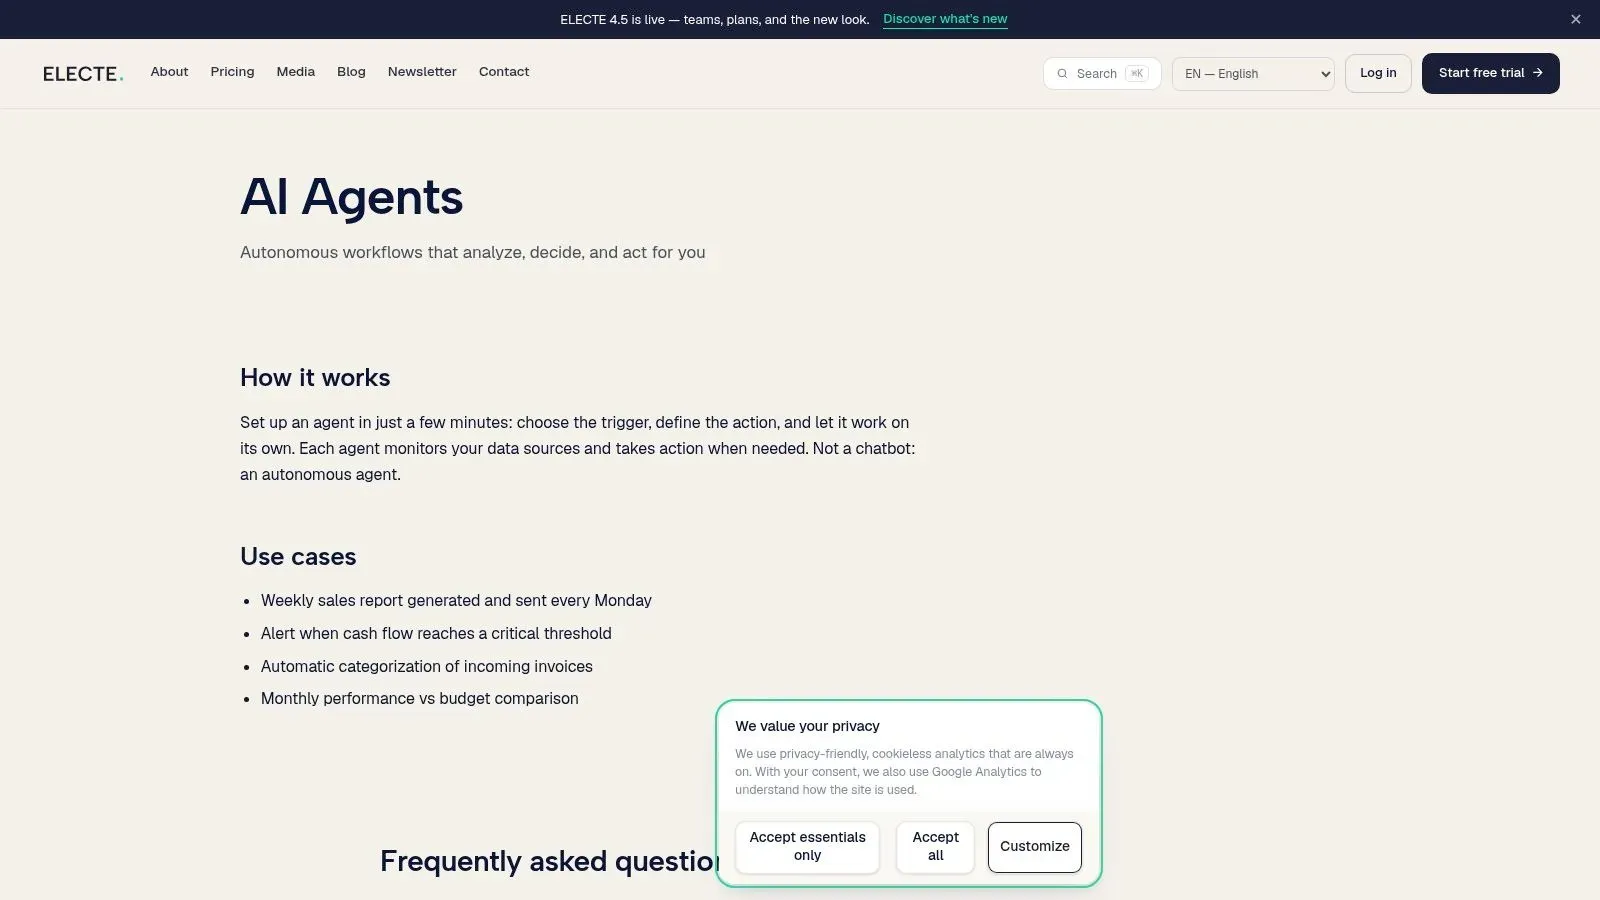
Інструменти для виявлення аномалій, наведені нижче, стежать за системами, метриками та пайплайнами. AI-агенти ELECTE стежать за бізнес-даними, і саме ця відмінність визначає, чи підійде вам цей варіант. Агенти безперервно відстежують підключені дані, виявляють аномалії та нові тренди й подають висновки, щоб вашій команді не доводилося переглядати звіт за звітом у пошуках змін.
Агент працює як аналітик, що не вимикається, а не як чат-бот, який чекає вдалого запиту. Він аналізує ваші дані, позначає незвичні зміни у виручці, транзакціях, запасах чи показниках ризику та подає те, що потребує уваги, мовою, зрозумілою менеджеру. Тому це єдиний пункт у списку, орієнтований на фінансового менеджера, а не на SRE-інженера.
Де модель агента допомагає найбільше
- Безперервний моніторинг: аномалії та тренди з'являються одразу, а не наприкінці місяця, коли хтось нарешті відкриє таблицю.
- Дієвий аналіз: результат пояснює, що змінилося і чому це важливо, а не обмежується обміном запитом і відповіддю.
- Ширший контекст платформи: виявлення працює разом із прогнозуванням, оцінкою ризиків і звітністю, тож виявлена аномалія може потрапити в оновлений прогноз або у звіт для ради директорів.
- Доступність за задумом: команди без спеціальних технічних навичок можуть працювати з висновками безпосередньо, що важливо для малого й середнього бізнесу без data scientist у штаті.
Два обмеження варто розглянути уважно. Якість інсайтів залежить від підключених джерел: підключення відбувається через інтеграції з бухгалтерським ПЗ або завантаження файлів, тому перед рішенням переконайтеся, що налаштування охоплює ваші системи. Важливий і вибір тарифу: ціна зростає від Starter до Enterprise, а такі можливості, як необмежені AI-інсайти та розширене прогнозування, доступні на вищих тарифах.
Я раджу цей варіант, коли аномалії виникають у бізнес-показниках, а не в інфраструктурних логах, і коли реагувати на сповіщення має фінансовий чи операційний менеджер, а не інженер.
2. Amazon CloudWatch
Якщо ваші навантаження вже працюють в AWS, Amazon CloudWatch — шлях найменшого опору. Його виявлення аномалій у метриках вивчає очікувані патерни за історичними даними, будує очікуваний діапазон і дає змогу налаштувати сигнал тривоги, коли метрика виходить за його межі. Діапазон адаптується до трендів та погодинних, щоденних і щотижневих патернів, що краще за статичний поріг для сервісів із передбачуваними піками.
CloudWatch охоплює як метрики, які надає AWS, так і власні метрики, а сигнали тривоги про аномалії можна будувати на даних метрик і підтримуваних математичних виразах над метриками. Щодо логів, CloudWatch Logs може визначати нові або змінені патерни, а створення детекторів аномалій у Logs саме по собі не тарифікується.
- Нативна інтеграція: метрики, логи, дашборди та сигнали тривоги вже зібрані в одному середовищі AWS.
- Сповіщення, а не лише графіки: смуги аномалій підключаються до системи сповіщень, тож виявлення доходить до інженера, який чергує.
Компроміс — у межах застосування. Це операційна телеметрія, а не загальна бізнес-аналітика, а налаштування та інтерпретація можуть бути незручними для нетехнічних користувачів. Моделі аномалій метрик і сигнали тривоги також можуть збільшити рахунок AWS, тож із ростом варто стежити за кількістю моделей.
3. Datadog Watchdog
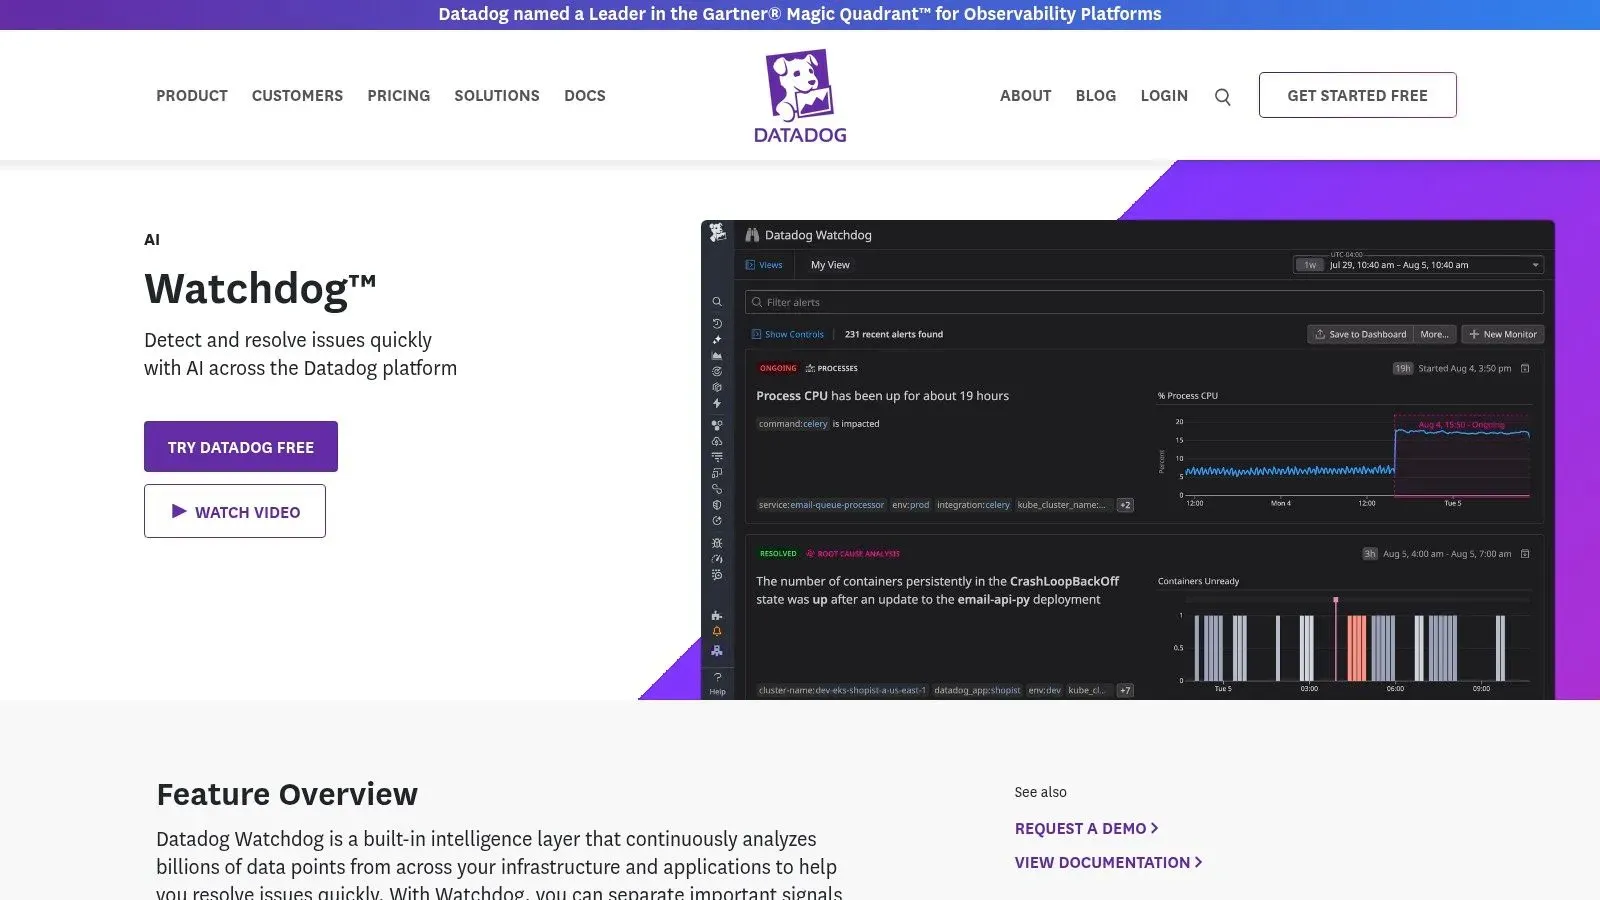
Datadog Watchdog — це результат вбудовування виявлення аномалій у повноцінну платформу спостережуваності, а не додавання його зверху. Він стежить за інфраструктурою, продуктивністю застосунків, логами та телеметрією користувацького досвіду, а потім підсвічує незвичну поведінку й потенційні чинники під час інциденту.
Watchdog виявляє аномалії метрик, викиди та перетини порогів на основі прогнозу. Його головна сила — кореляція. Коли зростає затримка, пов’язані сигнали з різних продуктів Datadog відображаються поруч, тож інженер переходить від симптому до ймовірної причини без зшивання окремих консолей. 14-денна безкоштовна пробна версія дає змогу перевірити цей процес на власній телеметрії.
Сповіщення без контексту для розслідування лише переносить роботу в інше місце. Саме кореляція перетворює сплеск на діагноз.
Підступ — у вартості. Ціна зростає разом із кількістю хостів, підключених продуктів, власних метрик і обсягом даних, а деякі розширені можливості залежать від вашого тарифу. Інструмент також розрахований на технічну спостережуваність, а не на бізнес-аналіз. Якщо ваше питання стосується продажів чи маржі, почніть із матеріалу інсайти з виявлення аномалій на 2026 рік та оберіть бізнес-орієнтований інструмент.
4. New Relic
New Relic потрапляє до цього списку завдяки умовам оцінювання. Безкоштовний тариф включає 100 ГБ щомісячного прийому даних і одного користувача з доступом до всієї платформи, без пробного періоду, що спливає. Невелика команда може запустити реальні навантаження, вивчити модель сповіщень і ухвалити рішення на основі фактів, а не комерційної презентації.
Платформа поєднує телеметрію застосунків, інфраструктури та журналів із запитами й дашбордами. Умови сповіщень можуть використовувати динамічне виявлення аномалій, яке адаптує пороги до зміни поведінки даних із часом. Це зменшує обсяг ручного налаштування, якого вимагають статичні пороги. New Relic пропонує широку бібліотеку інтеграцій, зазначених вендором, тому багато поширених стеків підключаються без додаткової розробки.
- Справді безкоштовне оцінювання: невеликі команди можуть перевірити відповідність до того, як заходитиме мова про бюджет.
- Зрозумілий чинник вартості: опублікована ціна за прийом даних робить одну з головних статей витрат передбачуваною.
Передбачувано не означає дешево. Ціна зростає разом з обсягом прийнятих даних, кількістю користувачів і подекуди з розширеними обчисленнями, тож рахунок збільшується, коли ви зберігаєте більше телеметрії. Варто врахувати й такий компроміс: якщо вам потрібне лише виявлення аномалій у кількох метриках, ви платите за платформу заради однієї функції. Спеціалізований інструмент сповіщень часто виконає це завдання дешевше. Як і Datadog, він говорить мовою технічної телеметрії, а не бізнес-аналітики, тож фінансова команда, що шукає відхилення виручки, знайде інструмент, не призначений для такого питання.
5. Elastic
Elastic підходить командам, які хочуть контролю і мають фахівців, здатних ним скористатися. Його завдання машинного навчання моделюють нормальну поведінку в часових рядах та інших підтримуваних даних, а потім позначають відхилення оцінкою аномальності. Правила безпеки можуть сповіщати, коли аномалії перевищують обраний вами поріг оцінки, що робить Elastic корисним і для спостережуваності, і для сценаріїв безпеки.
Цей підхід має глибоке коріння. Виявлення на основі аномалій сформувалося в комп’ютерній безпеці у 1980-х роках, а огляд систем виявлення вторгнень, розміщений у Прінстоні, описує IDES, опублікований у 1987 році, як одну з перших систем, що профілювала нормальну активність і генерувала сповіщення в реальному часі. Elastic застосовує той самий принцип у сучасному масштабі: спершу описати норму, потім позначити значне відхилення.
Що зважити перед ухваленням рішення
- Гнучкість: ви контролюєте структуру завдань, оцінювання та те, як результати потрапляють у пошук і сповіщення.
- Перевага наявного стеку: якщо Elastic уже забезпечує ваш пошук, додати виявлення аномалій — це поступовий крок.
Витрати тут операційні. Налаштування завдань і постійне адміністрування можуть потребувати фахівців, сповіщення про аномалії вимагають відповідної підписки або рівня проєкту, а моделям потрібно достатньо історичних даних, щоб їм можна було довіряти.
6. Google Cloud Monitoring
Для команд, які працюють на Google Cloud, Google Cloud Monitoring є природним вибором за замовчуванням — так само, як CloudWatch для AWS. Він відстежує метрики в різних проєктах і ресурсах, підтримує користувацькі та керовані метрики й використовує області метрик (metrics scopes), щоб ви могли стежити за кількома проєктами з одного місця.
Правила сповіщень надсилають повідомлення через канали, зокрема електронну пошту, SMS, Slack і PagerDuty, що покриває більшість схем чергування без додаткових інструментів. Ціноутворення залежить від використання, а для частини даних опубліковано безкоштовні місячні ліміти, тож ви можете оцінити витрати до того, як обсяг даних вас здивує.
- Логічний вибір для GCP-команд: жодного нового вендора, жодної нової стратегії агентів, жодного переміщення даних між хмарами.
- Прозорі ліміти: безкоштовні рівні для частини даних роблять початок роботи малоризиковим.
Проте варто чітко розуміти межі застосування. Це моніторинг хмарних операцій, а не інструмент для відстеження бізнес-KPI, як-от продажів чи запасів. Витрати залежать від обсягу прийому даних та іншого використання, а налаштування й інтерпретація можуть вимагати хмарної експертизи, якої в команди може не бути. Під час пілоту перевірте конкретні сценарії виявлення аномалій на відповідність вашим потребам у сповіщеннях, адже загальна сила моніторингу не гарантує потрібної вам поведінки виявлення.
7. Anomaly.io
Не кожній команді потрібен цілий набір інструментів. Anomaly.io виконує одне завдання. Ви надсилаєте метрики, сервіс з часом вивчає закономірності, виявляє тренди, кореляції та інші відхилення й надсилає сповіщення з контекстом простою мовою через такі канали, як електронна пошта, SMS і PagerDuty.
Дві деталі роблять його практичним. Відгуки про релевантні й нерелевантні сповіщення коригують подальше виявлення, що безпосередньо бореться зі втомою від сповіщень. Публічні ціни також містять ліміти метрик і швидкість виявлення, тож ви знаєте межі ще до інтеграції. Сервіс приймає метрики з кількох мов програмування, що спрощує інструментування.
Практичне правило: оцінюйте детектор за кількістю сповіщень, які ваша команда реально може переглянути за день, а не лише за результатами бенчмарків.
Така спрямованість має і зворотний бік. Це сервіс метрик, а не повноцінна платформа бізнес-аналітики чи звітності, а виявлення залежить від того, чи надсилаєте ви відповідні дані і чи даєте час на вивчення закономірностей. Перш ніж зобов’язуватися, перевірте актуальні інтеграції, відповідність сервісу вашим завданням і умови підтримки. Якщо ви ще вибираєте метод, спершу порівняйте алгоритми виявлення аномалій у часових рядах, адже алгоритм має відповідати вашій сезонності та формі даних.
8. Anomalo
Припустимо, ваші дашборди виглядають добре, але цифрам ніхто не довіряє. Саме для цієї проблеми створено Anomalo. Він відстежує таблиці сховища даних, використовує машинне навчання для виявлення незвичних закономірностей і перевіряє актуальність, обсяг, відсутні дані та аномалії таблиць ще до того, як погані дані потраплять у звіт.
Відмінність — у поєднанні навченого виявлення з явними правилами. No-code перевірки працюють поряд із користувацьким SQL та API, тож аналітик може закодувати бізнес-правило, поки моделі стежать за змінами, про які ніхто не подумав. Візуалізації та функції пошуку першопричин потім допомагають відстежити, що саме змінилося в позначеній таблиці.
- Два рівні захисту: охоплено як неочікувані зміни, так і відомі бізнес-правила.
- Не лише для інженерів: перевірки без коду дають аналітикам змогу самостійно відповідати за частину моніторингу.
- Приклад із ритейлу: кейс із ритейлу описує моніторинг продажів, запасів і даних про товари.
Складність — у доступі. Anomalo орієнтований на великі компанії й зазвичай вимагає демо, а не простої самостійної покупки. Відповідність вашим потребам також залежить від підтримуваних джерел даних і конфігурації вашого сховища, тому сумісність варто перевірити якомога раніше.
9. Bigeye
Bigeye розглядає виявлення аномалій як частину спостережуваності даних, а не як окремий потік сповіщень. Платформа профілює дані, виявляє аномалії в їхній поведінці та поєднує моніторинг із лінійністю даних (lineage), валідацією, зведенням і керуванням інцидентами. Коли щось ламається, lineage показує, на які звіти й користувачів це вплине далі за потоком.
Роботу зі сповіщеннями продумано добре. Пов’язані сповіщення групуються в проблеми, робочі процеси розслідування допомагають упорядкувати первинний розбір, а зворотний зв’язок щодо сповіщень може підвищувати релевантність майбутніх. Цей цикл важливий, бо саме довіра визначає, чи команда й надалі користуватиметься детектором. Нещодавнє дослідження Nature щодо виявлення аномалій в ERP показало точність 88,56% навіть після того, як ансамблеве голосування зменшило кількість хибнопозитивних спрацювань. Це нагадування, що керування шумом — це функція, а не другорядна справа.
Розгортання можливе з агентом і без нього, а в документації з безпеки згадано шифрування та опційний AWS PrivateLink для Enterprise. Обмеження — цільова аудиторія та прозорість. Bigeye розрахований на корпоративні команди з даних, потребує технічного налаштування та підключення до систем даних і не публікує цін. Щодо базової дисципліни: стаття про виявлення некоректних даних до формування звітності пояснює, чому перевірки у сховищі захищають кожне наступне рішення.
10. Monte Carlo
Monte Carlo завершує список у категорії спостережуваності даних, а його сильна сторона — контекст впливу. Платформа виявляє проблеми зі свіжістю, обсягом, схемою та розподілом даних, а потім за допомогою lineage показує, що залежить від ураженого ресурсу. Інженер, який розбирається із застарілою таблицею, бачить, які дашборди вона живить, ще до того, як проблему помітять стейкхолдери.
Покриття охоплює ресурси даних, системи та зміни, пов’язані з кодом, а керування інцидентами та інтеграції дозволяють спрямовувати проблеми в наявні робочі процеси. Для організацій зі сталими пайплайнами та окремими командами з даних такий погляд на залежності скорочує шлях від виявлення до розв’язання.
- Пов’язане розслідування: аномалії надходять із контекстом залежностей і впливу.
- Широке покриття надійності: типові категорії збоїв зібрано в одній платформі.
Обмеження схожі на ті, що мають аналоги. Інструмент створено для забезпечення надійності платформ даних, а не для простої бізнес-аналітики для нетехнічних команд. Цінність також залежить від масштабу й складності вашої екосистеми даних: невелике сховище з трьома конвеєрами отримає від відстеження походження даних менше користі, ніж розгалужене. Публічних цін немає, а оцінювання проводить вендор, тому щоб з'ясувати бюджет, потрібна розмова з відділом продажів.
Головні висновки: як обрати інструмент і отримати від нього користь
Починайте із завдання, а не зі списку вендорів. Команда може купити моніторинг інфраструктури, щоб відповідати на бізнес-питання, або observability для сховища даних, коли вистачило б простого сповіщення за метрикою. Перш ніж порівнювати функції, визначте категорію інструмента відповідно до рішення, яке потрібно ухвалити.
Чотири кроки вибору
- Підбирайте інструмент під свої дані. Метрики інфраструктури вказують на CloudWatch, Datadog, New Relic, Elastic або Google Cloud Monitoring. Таблиці у сховищі даних — на Anomalo, Bigeye або Monte Carlo. Бізнес-показники KPI — на платформу, орієнтовану на бізнес.
- Перевірте інтеграцію з тим, що вже використовуєте. Детектор, який не може читати дані вашої хмари, сховища чи бухгалтерії, створює ще один конвеєр, який доведеться підтримувати. Перевіряйте конектори та вимоги до історичних даних під час пілоту на реальних даних.
- З'ясуйте, як ціна зростає разом з обсягом. Обсяг завантажених даних, хости, користувацькі метрики та відстежувані таблиці з часом збільшуються. Перед підписанням порахуйте вартість за удвічі більшого обсягу, ніж сьогодні.
- Переконайтеся, що нетехнічні колеги можуть діяти за сповіщеннями. Сама оцінка аномалії не підкаже фінансовому менеджеру, що робити. Шукайте пояснення простою мовою, імовірні причини та зрозумілий наступний крок.
Впровадження — це ще не фініш. Звичайні зміни, зокрема акції, запуски продуктів і зміна поведінки клієнтів, зсувають базовий рівень. Огляд Future AGI щодо типових збоїв виявлення аномалій називає дрейф концепції та брак розмічених аномалій проблемами, які порівняння за бенчмарками часто не помічають. Запитайте кожного вендора, хто затверджує зміни базового рівня, як збирається зворотний зв'язок і чи можна відкотити невдалу адаптацію.
Детектор з трохи нижчою повнотою може принести більше користі, якщо зменшує втому від сповіщень і пояснює, які дії потрібні.
Компанія, що росте і не має команди з даних, може оминути складність інфраструктури та відстежувати бізнес-метрики напряму. ELECTE — платформа аналітики даних на основі ШІ — відстежує бізнес-дані, виявляє аномалії, показує тренди та створює звіти. Більшість користувачів починає працювати менш ніж за 5 хвилин після підключення бухгалтерського ПЗ або завантаження файлу.
Отримайте аналітика, який працює постійно, замість ще однієї панелі, яку ніхто не перевіряє. ELECTE відстежує ваші показники, позначає аномалії й тренди одразу після появи та перетворює їх на зрозумілі висновки й звіти, за якими команда може діяти. Підключіть бухгалтерське ПЗ або завантажте файл, щоб одразу побачити перший прогноз.
Коментарі
Коментарів поки немає — почніть обговорення.