10 công cụ phát hiện bất thường đáng dùng năm 2026
So sánh 10 công cụ phát hiện bất thường cho observability, chất lượng dữ liệu và phân tích kinh doanh. Chọn công cụ phù hợp và xem cách ELECTE tự động hóa insight.

Phát hiện bất thường có ý nghĩa gì trong công việc hằng ngày của bạn? Với một SRE, đó là chỉ số máy chủ lệch khỏi quy luật lúc 2 giờ sáng. Với đội dữ liệu, đó là một bảng trong kho dữ liệu ngừng cập nhật. Với quản lý tài chính, đó là dòng tiền hoặc biên lợi nhuận biến động mà không ai giải thích được.
Đây là ba bài toán khác nhau, và chúng cần ba loại công cụ phát hiện bất thường khác nhau. Giám sát đám mây và hạ tầng theo dõi hệ thống. Cảnh báo chỉ số chuyên dụng theo dõi một nhóm số liệu hẹp hơn. Chất lượng dữ liệu và observability cho kho dữ liệu kiểm tra xem dữ liệu đằng sau báo cáo của bạn có đáng tin hay không. Mua lẫn giữa các nhóm là cách khiến nhiều đội trả tiền cho một nền tảng lớn gấp đôi nhu cầu thực tế.
Bối cảnh cũng quan trọng. Thời gian ngừng hoạt động và dữ liệu sai không phải rủi ro trừu tượng, và tác động tài chính của gián đoạn IT chính là lý do cảnh báo sớm hiệu quả hơn việc phân tích sau sự cố. Thị trường rộng hơn cũng phản ánh sự dịch chuyển từ công cụ bảo mật chuyên biệt sang phân tích hằng ngày: báo cáo thị trường phát hiện bất thường của Fortune Business Insights định giá thị trường ở mức khoảng 6,98 tỷ USD năm 2025 và dự báo đạt 28,15 tỷ USD vào năm 2034.
Dưới đây là đánh giá thực tế về 10 lựa chọn, kèm những hạn chế cụ thể của từng công cụ, sau đó là một khung đơn giản giúp bạn chọn.
1. ELECTE AI Agents
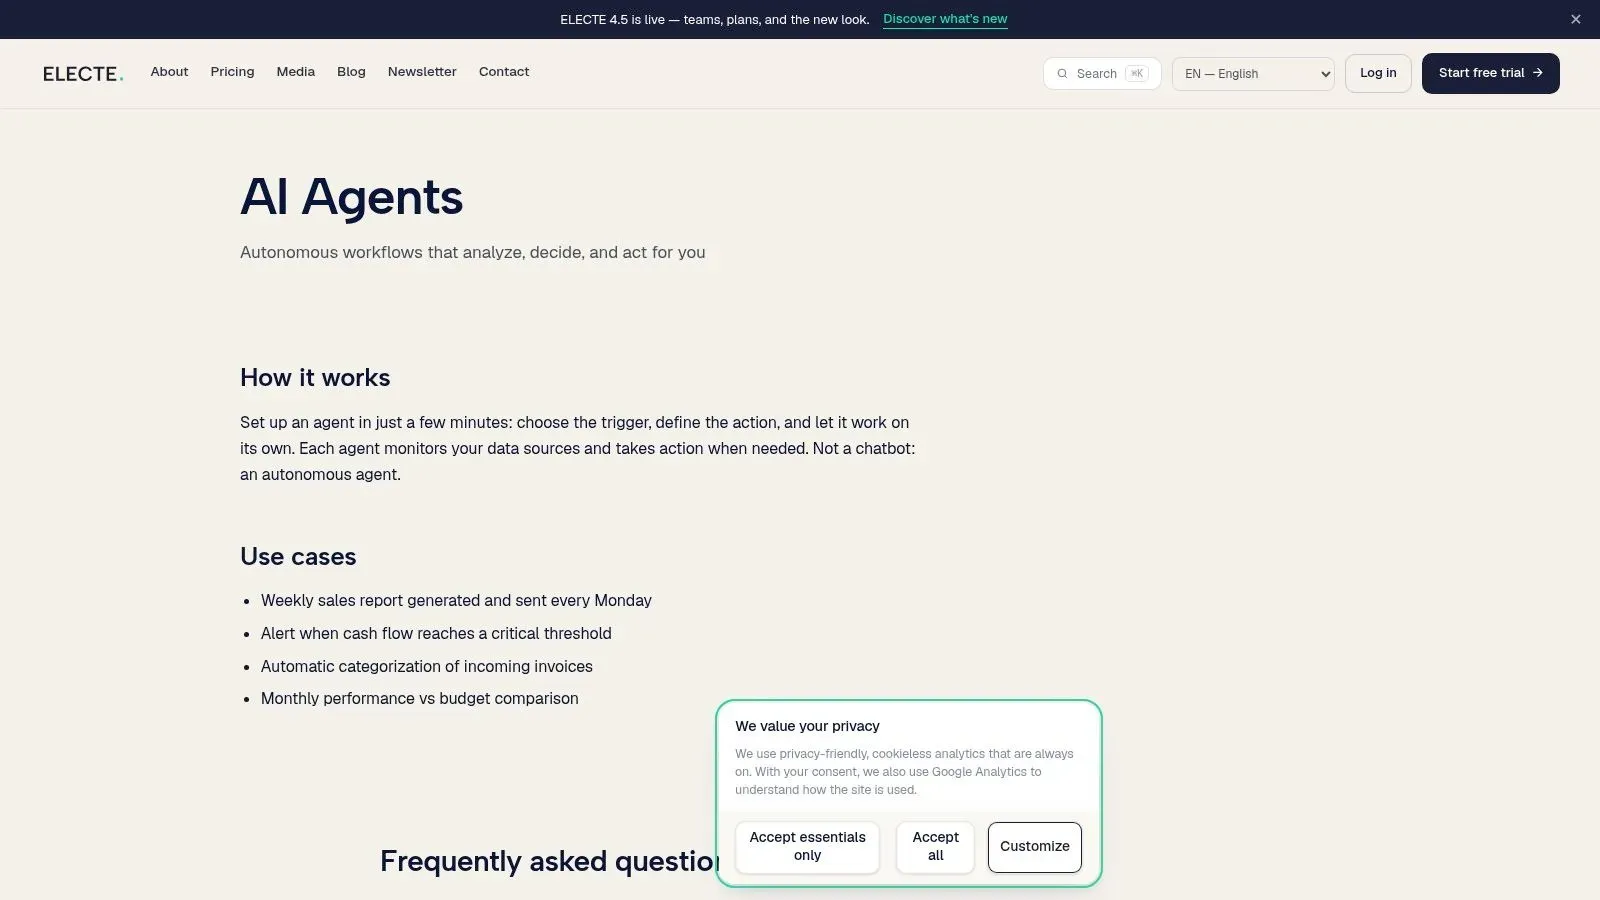
Các công cụ phát hiện bất thường ở phần sau của danh sách này giám sát hệ thống, chỉ số và pipeline. AI Agents của ELECTE theo dõi dữ liệu kinh doanh, và sự khác biệt này quyết định lựa chọn này có phù hợp với bạn hay không. Các agent giám sát liên tục dữ liệu đã kết nối, nhận diện bất thường và xu hướng mới nổi, rồi đưa ra insight để đội của bạn không phải xem hết báo cáo này đến báo cáo khác để tìm điều gì đã thay đổi.
Agent hoạt động như một nhà phân tích luôn trực tuyến, chứ không phải chatbot chờ một câu lệnh khéo léo. Nó đọc dữ liệu của bạn, đánh dấu biến động bất thường về doanh thu, giao dịch, tồn kho hoặc chỉ báo rủi ro, và trình bày những gì cần chú ý bằng ngôn ngữ mà nhà quản lý có thể hành động ngay. Vì vậy, đây là mục trong danh sách hướng đến phiên bản phát hiện bất thường của quản lý tài chính, không phải của SRE.
Nơi mô hình agent hữu ích nhất
- Giám sát liên tục: Bất thường và xu hướng xuất hiện ngay khi hình thành, chứ không phải đến cuối tháng khi ai đó mới mở bảng tính.
- Phân tích có thể hành động: Kết quả giải thích điều gì đã thay đổi và vì sao quan trọng, thay vì chỉ dừng ở một lượt hỏi và đáp.
- Bối cảnh nền tảng rộng hơn: Phát hiện nằm cạnh dự báo, đánh giá rủi ro và báo cáo, nên một bất thường được đánh dấu có thể chuyển thẳng vào điều chỉnh dự báo hoặc báo cáo sẵn sàng trình hội đồng.
- Dễ tiếp cận ngay từ thiết kế: Các đội không có kỹ năng kỹ thuật chuyên sâu vẫn có thể làm việc trực tiếp với insight, điều này quan trọng với các doanh nghiệp vừa và nhỏ không có chuyên gia khoa học dữ liệu.
Có hai hạn chế cần xem xét kỹ. Chất lượng insight phụ thuộc vào các nguồn bạn kết nối: việc triển khai thực hiện qua kết nối phần mềm kế toán hoặc tải tệp lên, vì vậy hãy xác nhận quá trình thiết lập bao phủ các hệ thống của bạn trước khi cam kết. Việc chọn gói cũng quan trọng, vì giá tăng dần từ Starter đến Enterprise và các tính năng như insight AI không giới hạn và dự báo nâng cao nằm ở các gói cao hơn.
Tôi khuyên chọn hướng này khi các bất thường nằm ở KPI kinh doanh chứ không phải nhật ký hạ tầng, và khi người phải hành động theo cảnh báo là quản lý tài chính hoặc vận hành, không phải kỹ sư.
2. Amazon CloudWatch
Nếu khối lượng công việc của bạn đã chạy trên AWS, Amazon CloudWatch là con đường ít trở ngại nhất. Tính năng phát hiện bất thường theo chỉ số học các mẫu kỳ vọng từ dữ liệu lịch sử, xây dựng một khoảng giá trị kỳ vọng và cho phép bạn đặt cảnh báo khi chỉ số vượt khỏi khoảng đó. Khoảng này thích ứng với xu hướng và các mẫu theo giờ, ngày và tuần, tốt hơn ngưỡng cố định đối với các dịch vụ có đỉnh tải dự đoán được.
CloudWatch hỗ trợ cả chỉ số do AWS cung cấp lẫn chỉ số tùy chỉnh, và cảnh báo bất thường có thể được xây dựng từ dữ liệu chỉ số và các biểu thức toán học chỉ số được hỗ trợ. Về phía nhật ký, CloudWatch Logs có thể nhận diện các mẫu mới hoặc đang thay đổi, và việc tạo bộ phát hiện bất thường cho Logs không tự phát sinh phí.
- Tích hợp sẵn: Chỉ số, nhật ký, dashboard và cảnh báo đã nằm chung trong một môi trường AWS.
- Cảnh báo, không chỉ biểu đồ: Dải bất thường kết nối với hệ thống cảnh báo, nên kết quả phát hiện đến được kỹ sư trực.
Đổi lại là phạm vi hẹp. Đây là dữ liệu telemetry vận hành, không phải phân tích kinh doanh tổng quát, và việc thiết lập cũng như diễn giải có thể khó với người không chuyên kỹ thuật. Các mô hình và cảnh báo bất thường theo chỉ số cũng có thể phát sinh phí AWS, vì vậy cần theo dõi số lượng mô hình khi bạn mở rộng.
3. Datadog Watchdog
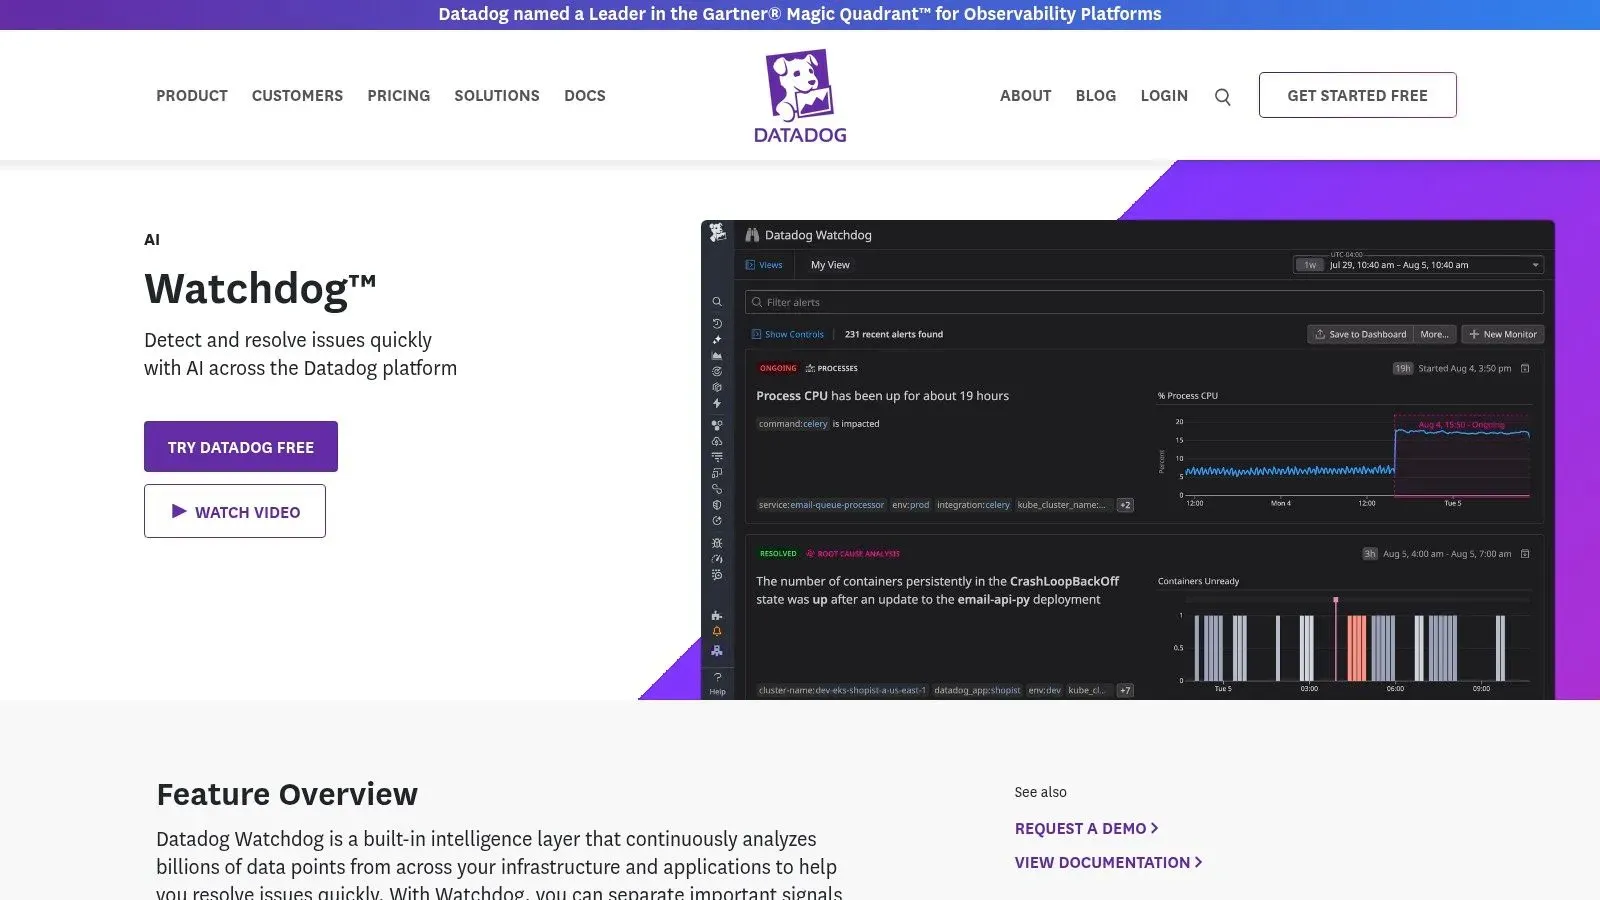
Datadog Watchdog là kết quả khi phát hiện bất thường được tích hợp sẵn trong một nền tảng observability đầy đủ thay vì gắn thêm vào. Nó theo dõi hạ tầng, hiệu năng ứng dụng, nhật ký và telemetry trải nghiệm người dùng, rồi làm nổi bật hành vi bất thường và các yếu tố có thể góp phần trong một sự cố.
Watchdog phát hiện bất thường theo chỉ số, giá trị ngoại lai và việc vượt ngưỡng dựa trên dự báo. Điểm mạnh thực sự của nó là khả năng tương quan. Khi độ trễ tăng vọt, các tín hiệu liên quan trên các sản phẩm Datadog được đặt cạnh nhau, nên kỹ sư có thể đi từ triệu chứng đến nguyên nhân khả dĩ mà không phải ghép nhiều bảng điều khiển riêng lẻ. Bản dùng thử miễn phí 14 ngày cho phép bạn thử quy trình này trên telemetry của chính mình.
Một cảnh báo thiếu bối cảnh điều tra chỉ chuyển công việc sang chỗ khác. Tương quan mới là thứ biến một đợt tăng vọt thành chẩn đoán.
Chi phí là điểm cần lưu ý. Giá tăng theo số máy chủ, sản phẩm được giám sát, chỉ số tùy chỉnh và khối lượng dữ liệu, và một số tính năng nâng cao phụ thuộc vào gói của bạn. Công cụ này cũng được xây dựng cho observability kỹ thuật, không phải phân tích kinh doanh. Nếu câu hỏi của bạn liên quan đến doanh số hay biên lợi nhuận, hãy bắt đầu với insight phát hiện bất thường năm 2026 và một công cụ hướng đến kinh doanh.
4. New Relic
New Relic có mặt trong danh sách này nhờ các điều kiện dùng thử. Gói miễn phí bao gồm 100 GB dữ liệu nạp vào mỗi tháng và một người dùng với đầy đủ tính năng của nền tảng, không giới hạn thời gian dùng thử. Một nhóm nhỏ có thể chạy khối lượng công việc thực tế, làm quen với cơ chế cảnh báo và quyết định dựa trên bằng chứng thay vì một bài thuyết trình bán hàng.
Nền tảng kết hợp dữ liệu telemetry của ứng dụng, hạ tầng và log với truy vấn và bảng điều khiển. Điều kiện cảnh báo có thể dùng tính năng phát hiện bất thường động, tự điều chỉnh ngưỡng khi hành vi dữ liệu thay đổi theo thời gian, giúp giảm công sức tinh chỉnh thủ công mà các ngưỡng tĩnh đòi hỏi. New Relic cung cấp thư viện tích hợp phong phú do nhà cung cấp liệt kê, nên nhiều hệ thống phổ biến có thể kết nối mà không cần xây dựng thêm kết nối tùy chỉnh.
- Dùng thử miễn phí thực sự: Các nhóm nhỏ có thể kiểm chứng mức độ phù hợp trước khi bàn đến ngân sách.
- Khoản chi phí dễ thấy: Giá nạp dữ liệu được công bố giúp một khoản chi lớn trở nên dễ dự đoán.
Dễ dự đoán không có nghĩa là rẻ. Giá tăng theo lượng dữ liệu nạp vào, quyền truy cập của người dùng và đôi khi cả tài nguyên tính toán nâng cao, nên hóa đơn sẽ tăng khi bạn lưu giữ nhiều telemetry hơn. Điểm cần cân nhắc: nếu bạn chỉ cần phát hiện bất thường cho một vài chỉ số, bạn đang trả giá của cả nền tảng cho một tính năng duy nhất. Một công cụ cảnh báo chuyên dụng thường đáp ứng việc này với chi phí thấp hơn. Giống như Datadog, công cụ này nói ngôn ngữ của telemetry kỹ thuật chứ không phải phân tích kinh doanh, nên đội tài chính muốn tìm sự lệch của doanh thu sẽ thấy đây là công cụ không phù hợp với câu hỏi của họ.
5. Elastic
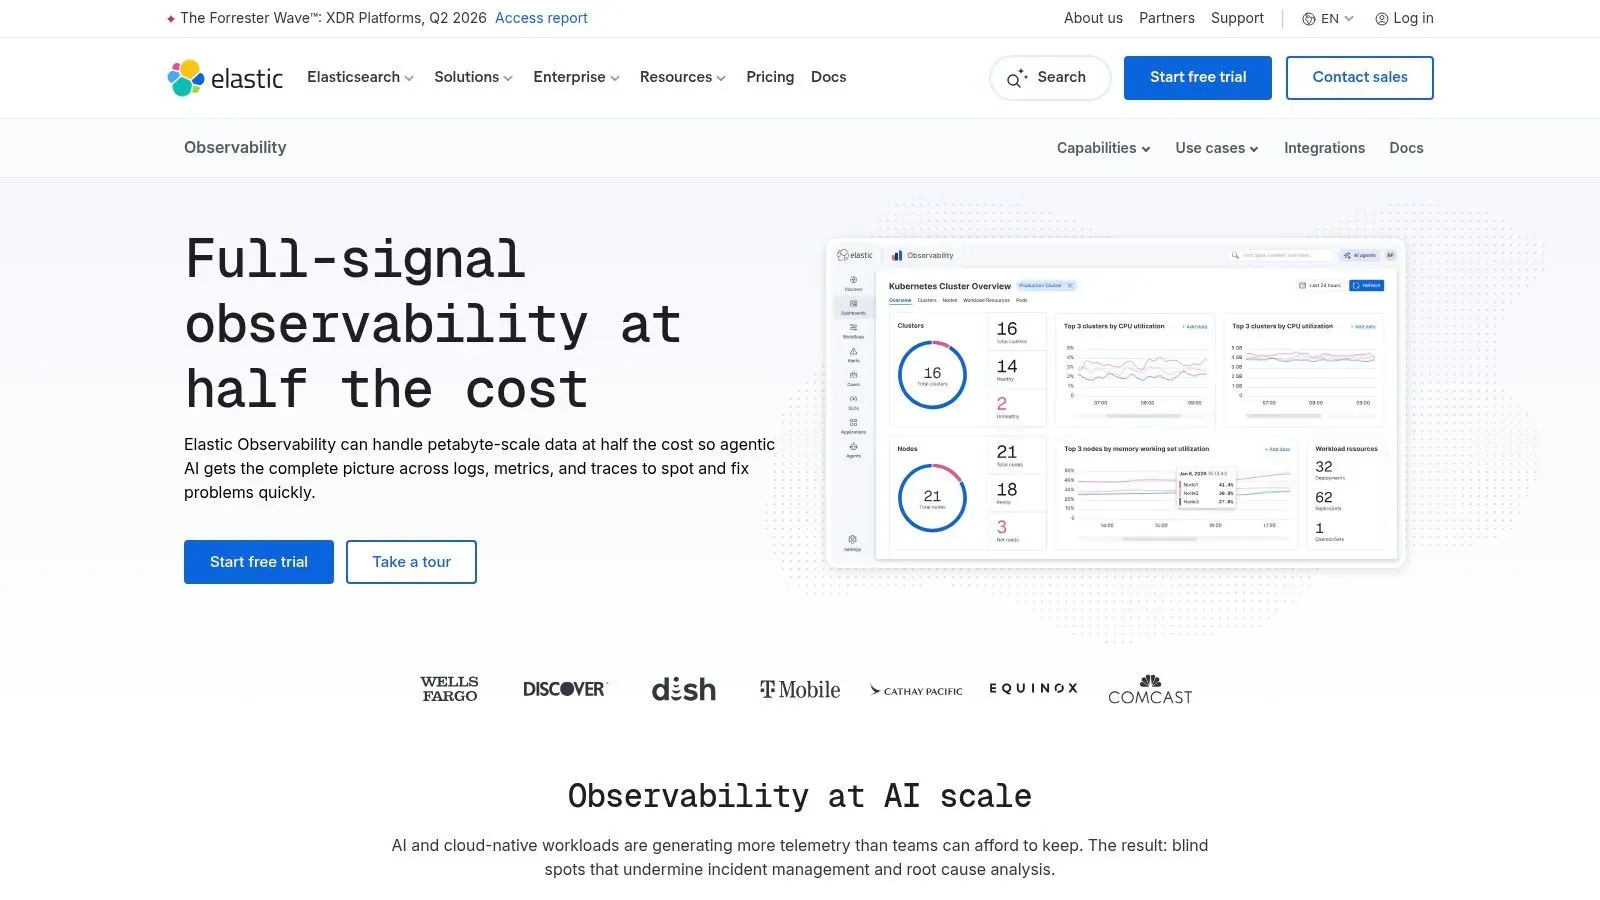
Elastic phù hợp với các nhóm muốn toàn quyền kiểm soát và có chuyên gia để vận hành. Các tác vụ học máy của Elastic mô hình hóa hành vi bình thường trong chuỗi thời gian và các dữ liệu được hỗ trợ khác, sau đó đánh dấu các sai lệch bằng điểm bất thường. Các quy tắc bảo mật có thể cảnh báo khi điểm bất thường vượt ngưỡng bạn chọn, giúp Elastic hữu ích ở cả quy trình quan sát hệ thống lẫn bảo mật.
Cách tiếp cận này có nguồn gốc sâu xa. Phát hiện dựa trên bất thường hình thành trong lĩnh vực bảo mật máy tính vào thập niên 1980, và một khảo sát về phát hiện xâm nhập do Princeton lưu trữ mô tả IDES, công bố năm 1987, là một hệ thống đời đầu lập hồ sơ hoạt động bình thường và tạo cảnh báo theo thời gian thực. Elastic áp dụng cùng nguyên tắc ở quy mô hiện đại. Trước hết xác định thế nào là bình thường, sau đó đánh dấu những sai lệch đáng kể.
Cần cân nhắc gì trước khi quyết định
- Tính linh hoạt: Bạn kiểm soát cách thiết kế tác vụ, cách chấm điểm và cách kết quả đi vào tìm kiếm và cảnh báo.
- Lợi thế từ hệ thống sẵn có: Nếu Elastic đã vận hành tìm kiếm của bạn, việc bổ sung phát hiện bất thường chỉ là mở rộng thêm.
Chi phí nằm ở khâu vận hành. Việc cấu hình tác vụ và quản trị liên tục có thể cần chuyên gia, cảnh báo bất thường đòi hỏi gói đăng ký hoặc cấp dự án đủ điều kiện, và các mô hình cần đủ dữ liệu lịch sử thì mới đáng tin cậy.
6. Google Cloud Monitoring
Với các nhóm đã chuẩn hóa trên Google Cloud, Google Cloud Monitoring là lựa chọn mặc định tự nhiên, giống như CloudWatch với AWS. Công cụ giám sát chỉ số trên nhiều dự án và tài nguyên, hỗ trợ chỉ số tùy chỉnh và chỉ số được quản lý, đồng thời dùng phạm vi chỉ số (metrics scope) để bạn theo dõi nhiều dự án từ một nơi.
Các quy tắc cảnh báo gửi thông báo qua nhiều kênh, gồm email, SMS, Slack và PagerDuty, đáp ứng hầu hết cách thiết lập trực ca mà không cần thêm công cụ. Giá tính theo mức sử dụng, với hạn mức miễn phí hằng tháng được công bố cho một số dữ liệu, nên bạn có thể ước tính chi phí trước khi khối lượng dữ liệu gây bất ngờ.
- Hợp lý với các đơn vị dùng GCP: Không cần nhà cung cấp mới, không cần chiến lược agent mới, không phải di chuyển dữ liệu giữa các đám mây.
- Hạn mức minh bạch: Gói miễn phí cho một số dữ liệu giúp việc áp dụng ban đầu ít rủi ro.
Tuy nhiên, cần nhìn đúng mức độ phù hợp. Đây là công cụ giám sát vận hành đám mây, không phải công cụ theo dõi các KPI kinh doanh như doanh số hay tồn kho. Chi phí phụ thuộc vào lượng dữ liệu nạp vào và các mức sử dụng khác, còn việc thiết lập và diễn giải có thể đòi hỏi chuyên môn về đám mây mà nhóm của bạn chưa có sẵn. Hãy kiểm tra các quy trình phát hiện bất thường cụ thể so với nhu cầu cảnh báo của bạn trong giai đoạn chạy thử, vì năng lực giám sát nói chung không đảm bảo hành vi phát hiện mà bạn mong muốn.
7. Anomaly.io
Không phải nhóm nào cũng cần một bộ công cụ trọn gói. Anomaly.io chỉ làm một việc. Bạn gửi chỉ số, công cụ học các mẫu theo thời gian, phát hiện xu hướng, mối tương quan và các sai lệch khác, rồi gửi cảnh báo kèm ngữ cảnh dễ hiểu qua các kênh như email, tin nhắn và PagerDuty.
Hai chi tiết khiến công cụ này thực dụng. Phản hồi về cảnh báo phù hợp hay không phù hợp sẽ điều chỉnh việc phát hiện sau này, trực tiếp giải quyết tình trạng quá tải cảnh báo. Bảng giá công khai cũng nêu rõ giới hạn chỉ số và tốc độ phát hiện, nên bạn biết các giới hạn trước khi tích hợp. Công cụ nhận chỉ số từ nhiều ngôn ngữ lập trình, giúp việc tích hợp đo lường đơn giản.
Quy tắc thực tế: Hãy đánh giá một công cụ phát hiện bằng số cảnh báo mà nhóm bạn thực sự xem xét được mỗi ngày, chứ không chỉ dựa vào điểm benchmark.
Sự tập trung này có hai mặt. Đây là dịch vụ về chỉ số, không phải nền tảng phân tích kinh doanh hay báo cáo hoàn chỉnh, và việc phát hiện phụ thuộc vào việc gửi dữ liệu phù hợp và dành thời gian để học các mẫu. Trước khi quyết định, hãy kiểm tra các tích hợp hiện có, mức độ phù hợp của dịch vụ và chế độ hỗ trợ. Nếu bạn vẫn đang chọn phương pháp, hãy so sánh các thuật toán phát hiện bất thường trong chuỗi thời gian trước, vì thuật toán cần phù hợp với tính mùa vụ và hình dạng dữ liệu của bạn.
8. Anomalo
Giả sử các bảng điều khiển của bạn trông ổn, nhưng không ai tin các con số. Đó là vấn đề mà Anomalo được xây dựng để giải quyết. Công cụ giám sát các bảng trong kho dữ liệu, dùng học máy để phát hiện các mẫu bất thường và kiểm tra độ mới, khối lượng, dữ liệu thiếu và các bất thường của bảng trước khi dữ liệu lỗi đến được báo cáo.
Điểm khác biệt là sự kết hợp giữa phát hiện do máy học và các quy tắc tường minh. Các kiểm tra xác thực không cần code nằm cạnh các tùy chọn SQL tùy chỉnh và API, nên nhà phân tích có thể mã hóa một quy tắc kinh doanh trong khi các mô hình theo dõi những thay đổi mà không ai nghĩ đến việc chỉ định. Các tính năng trực quan hóa và điều tra nguyên nhân gốc sau đó giúp bạn lần ngược từ bảng bị đánh dấu đến điều đã thay đổi.
- Hai lớp phòng vệ: Bao quát cả những thay đổi bất ngờ lẫn các quy tắc nghiệp vụ đã biết.
- Không chỉ dành cho kỹ sư: Các kiểm tra không cần mã cho phép nhà phân tích trực tiếp phụ trách một phần việc giám sát.
- Bằng chứng từ ngành bán lẻ: Một nghiên cứu điển hình trong ngành bán lẻ mô tả việc giám sát dữ liệu doanh số, tồn kho và sản phẩm.
Rào cản nằm ở khâu tiếp cận. Anomalo hướng đến doanh nghiệp lớn và thường yêu cầu đặt lịch demo thay vì cho mua tự phục vụ đơn giản. Mức độ phù hợp còn phụ thuộc vào các nguồn dữ liệu được hỗ trợ và cách bạn thiết lập kho dữ liệu, vì vậy hãy xác nhận khả năng tương thích ngay từ đầu.
9. Bigeye
Bigeye xem phát hiện bất thường là một phần của khả năng quan sát dữ liệu, chứ không phải một luồng cảnh báo riêng lẻ. Công cụ này lập hồ sơ dữ liệu, phát hiện bất thường trong hành vi dữ liệu và kết hợp giám sát với lineage, xác thực, đối soát và quản lý sự cố. Khi có điều gì hỏng, lineage cho biết những báo cáo và người dùng nào ở hạ nguồn bị ảnh hưởng.
Việc xử lý cảnh báo được làm khá chu đáo. Các cảnh báo liên quan được gom thành sự cố, quy trình điều tra giúp việc phân loại có trật tự, và phản hồi về cảnh báo có thể nâng cao độ phù hợp của các cảnh báo sau. Vòng phản hồi này quan trọng vì niềm tin quyết định việc một nhóm có tiếp tục dùng bộ phát hiện hay không. Một nghiên cứu trên Nature về phát hiện bất thường trong ERP ghi nhận độ chính xác 88,56% ngay cả sau khi bỏ phiếu tổng hợp (ensemble) đã giảm dương tính giả, một lời nhắc rằng kiểm soát nhiễu là một tính năng, không phải việc làm sau.
Bigeye có cả phương thức triển khai dùng agent và không dùng agent, còn tài liệu bảo mật mô tả mã hóa cùng AWS PrivateLink tùy chọn cho gói Enterprise. Hạn chế nằm ở đối tượng sử dụng và mức độ minh bạch. Bigeye hướng đến các nhóm dữ liệu doanh nghiệp, cần thiết lập kỹ thuật và kết nối với các hệ thống dữ liệu, đồng thời không công bố giá. Về nền tảng của vấn đề, bài phát hiện dữ liệu xấu trước khi báo cáo giải thích vì sao các kiểm tra ở kho dữ liệu bảo vệ mọi quyết định phía sau.
10. Monte Carlo
Monte Carlo khép lại danh sách ở nhóm quan sát dữ liệu, và thế mạnh của công cụ này là bối cảnh tác động. Nó phát hiện sự cố về độ mới, khối lượng, lược đồ và phân phối dữ liệu, rồi dùng lineage để cho thấy những gì phụ thuộc vào tài sản bị ảnh hưởng. Một kỹ sư đang điều tra một bảng lỗi thời có thể thấy bảng đó cấp dữ liệu cho những dashboard nào trước khi các bên liên quan kịp nhận ra.
Phạm vi bao phủ trải rộng trên tài sản dữ liệu, hệ thống và các thay đổi liên quan đến mã, cùng với quản lý sự cố và các tích hợp để chuyển vấn đề vào quy trình làm việc hiện có. Với những tổ chức đã có pipeline ổn định và đội ngũ dữ liệu chuyên trách, góc nhìn về phụ thuộc này rút ngắn khoảng cách từ phát hiện đến xử lý.
- Điều tra liền mạch: Các bất thường đi kèm sẵn bối cảnh về phụ thuộc và tác động.
- Bao quát độ tin cậy rộng: Các nhóm lỗi phổ biến đều nằm trong một nền tảng.
Các hạn chế cũng giống những công cụ cùng loại. Nó được thiết kế cho độ tin cậy của nền tảng dữ liệu, chứ không phải phân tích kinh doanh đơn giản cho các nhóm phi kỹ thuật. Giá trị còn phụ thuộc vào quy mô và độ phức tạp của hệ dữ liệu, vì một kho dữ liệu nhỏ với ba pipeline hưởng lợi từ lineage ít hơn một hệ thống phình to. Giá không được công bố và việc đánh giá do nhà cung cấp dẫn dắt, nên muốn biết ngân sách phải trao đổi với bộ phận kinh doanh.
Những điểm chính khi chọn công cụ và khai thác hiệu quả
Hãy bắt đầu từ công việc cần làm, không phải danh sách nhà cung cấp. Một nhóm có thể mua công cụ giám sát hạ tầng để trả lời câu hỏi kinh doanh, hoặc mua giải pháp quan sát kho dữ liệu trong khi một cảnh báo chỉ số đơn giản là đủ. Hãy xác định đúng nhóm công cụ phù hợp với quyết định bạn cần đưa ra trước khi so sánh tính năng.
Khung lựa chọn gồm bốn bước
- Chọn công cụ phù hợp với dữ liệu của bạn. Chỉ số hạ tầng hướng đến CloudWatch, Datadog, New Relic, Elastic hoặc Google Cloud Monitoring. Bảng trong kho dữ liệu hướng đến Anomalo, Bigeye hoặc Monte Carlo. KPI kinh doanh hướng đến một nền tảng dành cho người làm kinh doanh.
- Kiểm tra khả năng tích hợp với những gì bạn đang dùng. Một công cụ phát hiện không đọc được dữ liệu đám mây, kho dữ liệu hay kế toán của bạn sẽ tạo thêm một pipeline phải bảo trì. Hãy kiểm tra các trình kết nối và yêu cầu về dữ liệu lịch sử trong giai đoạn chạy thử trên dữ liệu thực.
- Xem chi phí thay đổi thế nào theo khối lượng. Lượng dữ liệu nạp vào, số máy chủ, chỉ số tùy chỉnh và số bảng được giám sát đều tăng theo thời gian. Hãy tính chi phí ở mức gấp đôi khối lượng hiện tại trước khi ký.
- Đảm bảo đồng nghiệp không chuyên kỹ thuật có thể xử lý cảnh báo. Chỉ riêng điểm bất thường không cho một quản lý tài chính biết cần làm gì. Hãy tìm giải thích bằng ngôn ngữ dễ hiểu, nguyên nhân có thể và bước tiếp theo rõ ràng.
Triển khai xong chưa phải là điểm kết thúc. Những thay đổi bình thường, gồm khuyến mãi, ra mắt sản phẩm và hành vi khách hàng thay đổi, sẽ làm dịch chuyển đường cơ sở của bạn. Một bài đánh giá của Future AGI về các dạng lỗi của phát hiện bất thường chỉ ra concept drift (trôi dạt khái niệm) và việc thiếu bất thường được gắn nhãn là những vấn đề mà các phép so sánh benchmark thường bỏ sót. Hãy hỏi từng nhà cung cấp ai phê duyệt thay đổi đường cơ sở, phản hồi được ghi nhận ra sao và bạn có thể hoàn tác một lần thích ứng sai hay không.
Một công cụ phát hiện có recall thấp hơn đôi chút vẫn có thể tạo ra nhiều giá trị hơn nếu giảm tình trạng mệt mỏi vì cảnh báo và giải thích rõ hành động cần thực hiện.
Một công ty đang tăng trưởng mà chưa có đội dữ liệu có thể bỏ qua sự phức tạp của hạ tầng và giám sát trực tiếp các chỉ số kinh doanh. ELECTE, một nền tảng phân tích dữ liệu ứng dụng AI, giám sát dữ liệu kinh doanh, nhận diện bất thường, phát hiện xu hướng và tạo báo cáo. Hầu hết người dùng có thể bắt đầu sử dụng trong chưa đầy 5 phút sau khi kết nối phần mềm kế toán hoặc tải lên một tệp.
Hãy có một chuyên viên phân tích làm việc liên tục trên dữ liệu kinh doanh của bạn, thay vì thêm một dashboard không ai xem. ELECTE theo dõi các con số của bạn, cảnh báo bất thường và xu hướng ngay khi chúng xuất hiện, rồi chuyển thành thông tin chi tiết và báo cáo rõ ràng để đội ngũ của bạn hành động. Kết nối phần mềm kế toán hoặc tải lên một tệp để xem ngay dự báo đầu tiên.
Bình luận
Chưa có bình luận nào — hãy bắt đầu cuộc trò chuyện.