2026年に試す価値のある異常検知ツール10選
オブザーバビリティ、データ品質、ビジネス分析向けの異常検知ツール10種を比較。自社に合う製品を見つけ、ELECTEがどのようにインサイトを自動化するかもご覧ください。

あなたの業務では、異常検知とは何を意味しますか。SREにとっては、午前2時にサーバーメトリクスがいつものパターンから外れることです。データチームにとっては、更新が止まったウェアハウスのテーブルです。財務マネージャーにとっては、キャッシュフローや利益率が誰にも説明できない動きを見せることです。
これらは3つの異なる問題であり、それぞれ異なる種類の異常検知ツールが必要です。クラウドやインフラの監視は、システムを見ます。専用のメトリクスアラートは、より限られた数値を見ます。データ品質やウェアハウスのオブザーバビリティは、レポートの元になっているデータが信頼できるかどうかを確認します。カテゴリをまたいで購入すると、課題の2倍も大きなプラットフォームにお金を払うことになりがちです。
背景も重要です。ダウンタイムや不正確なデータは抽象的なリスクではなく、ITの障害がもたらす財務的影響こそ、事後検証よりも早期警告が優れている理由です。市場全体にも、専門的なセキュリティツールから日常的な分析への移行が表れています。Fortune Business Insightsの異常検知市場レポートは、市場規模を2025年に約69.8億米ドルと評価し、2034年までに281.5億米ドルに達すると予測しています。
以下では、実務者の視点から10の選択肢を評価し、それぞれの限界も率直に示したうえで、選び方のシンプルなフレームワークを紹介します。
1. ELECTE AI Agents
このリストの後半に挙げた異常検知ツールは、システム、メトリクス、パイプラインを監視します。ELECTEのAI Agentsが監視するのはビジネスデータであり、この違いが自社に合うかどうかを左右します。エージェントは接続されたデータを継続的に監視し、異常や新たなトレンドを特定して、インサイトを提示します。チームがレポートを次々に確認して変化を探す必要はありません。
このエージェントは、巧みなプロンプトを待つチャットボットではなく、常時稼働のアナリストのように機能します。データを読み取り、売上、取引、在庫、リスク指標の通常と異なる動きを検知し、注意すべき点をマネージャーが行動に移せる言葉で提示します。そのため、このリストの中で、SRE向けではなく財務マネージャー向けの異常検知を想定した選択肢です。
エージェント型モデルが特に役立つ場面
- 継続的なモニタリング: 誰かがようやくスプレッドシートを開く月末ではなく、異常やトレンドが現れた時点で把握できます。
- 実行につながる分析: プロンプトと回答のやり取りで終わらず、何が変わったのか、なぜ重要なのかを説明します。
- より広いプラットフォームの文脈: 検知は予測、リスク評価、レポーティングと並んで提供されるため、検知した異常を予測の見直しや取締役会向けレポートにそのまま反映できます。
- 誰でも使いやすい設計: 専門的な技術スキルがないチームでもインサイトを直接活用できます。データサイエンティストを雇っていない中小企業にとって重要な点です。
2つの制約は慎重に検討する価値があります。インサイトの質は、接続するデータソースに左右されます。オンボーディングは会計ソフトとの連携またはファイルのアップロードで行うため、契約前に、お使いのシステムがセットアップの対象に含まれているかを確認してください。プランの選択も重要です。料金は Starter から Enterprise まで段階的に上がり、無制限のAIインサイトや高度な予測といった機能は上位プランに含まれます。
異常がインフラのログではなくビジネスKPIに現れる場合、そしてアラートを受けて対応する担当者がエンジニアではなく経理・財務やオペレーションのマネージャーである場合に、このルートをおすすめします。
2. Amazon CloudWatch
ワークロードがすでにAWS上で稼働しているなら、Amazon CloudWatchが最も手軽な選択肢です。メトリクスの異常検出機能は、過去データから想定されるパターンを学習して期待範囲を作成し、メトリクスがその範囲を外れたときにアラームを発報できます。この範囲はトレンドや時間単位・日単位・週単位のパターンに適応するため、ピークが予測できるサービスでは固定のしきい値よりも優れています。
CloudWatchはAWSが提供するメトリクスとカスタムメトリクスの両方に対応しており、異常検出アラームはメトリクスデータや、サポートされているメトリクス数式から作成できます。ログ面では、CloudWatch Logsが新しいパターンや変化したパターンを特定でき、Logsの異常検出器の作成自体には料金がかかりません。
- ネイティブな適合性: メトリクス、ログ、ダッシュボード、アラームがすべて1つのAWS環境にまとまっています。
- グラフだけでなくアラームも: 異常検出の範囲をアラートに連携できるため、検知結果がオンコール担当のエンジニアに届きます。
トレードオフは対象範囲です。これは運用テレメトリ向けであり、一般的なビジネス分析向けではありません。また、セットアップや結果の解釈は、技術に詳しくないユーザーにはわかりにくい場合があります。メトリクスの異常検出モデルとアラームにはAWSの料金が発生することもあるため、規模を拡大する際はモデル数に注意が必要です。
3. Datadog Watchdog
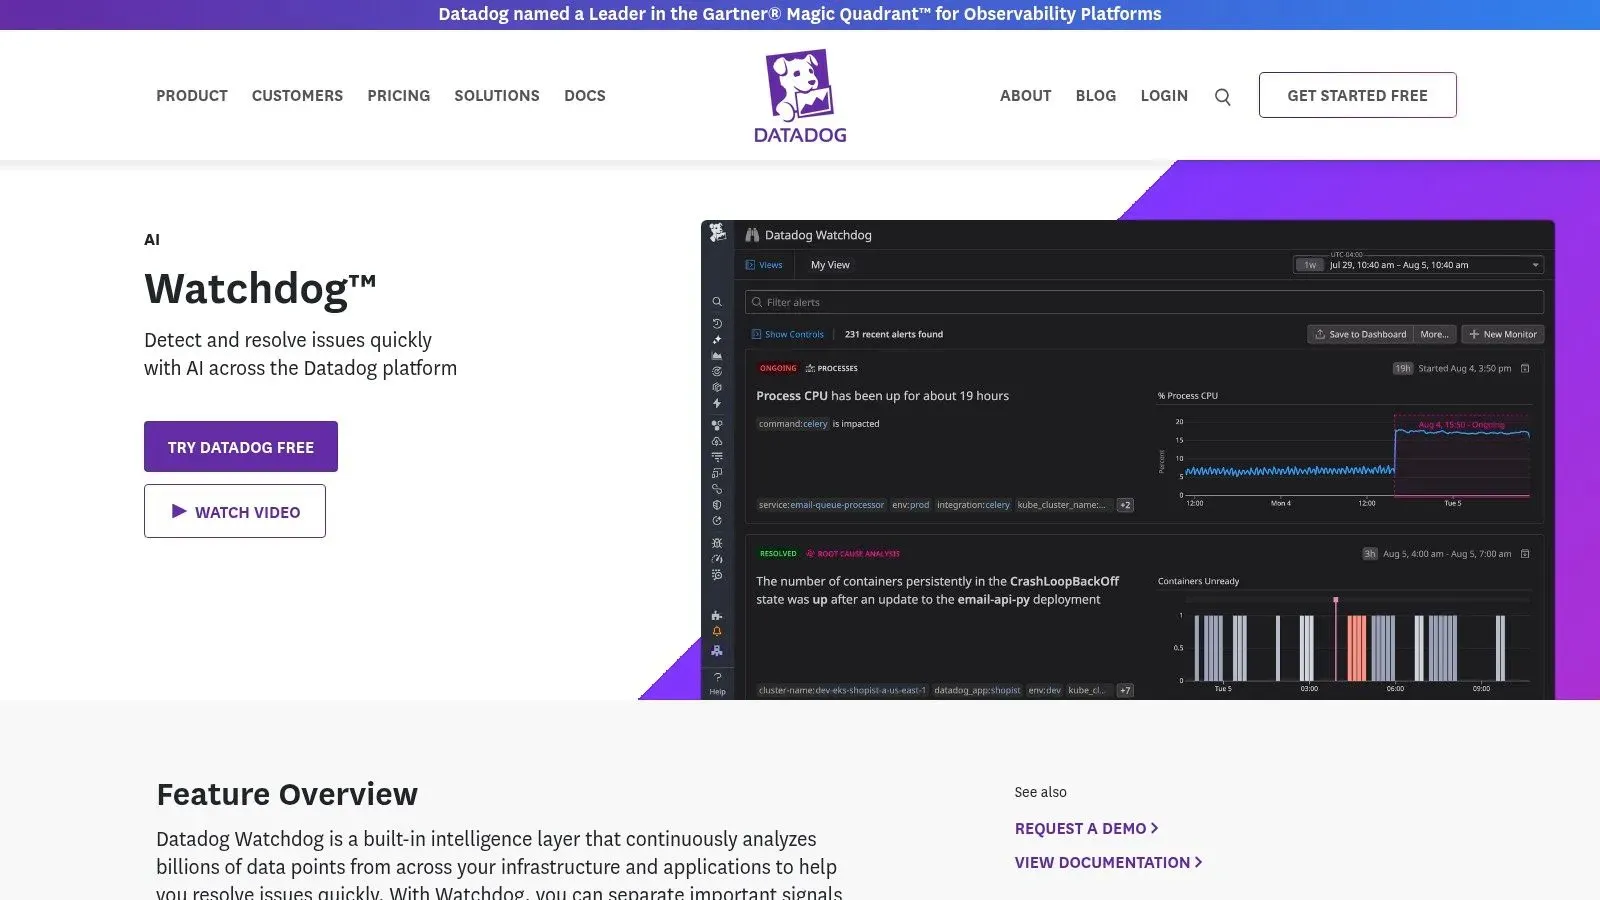
Datadog Watchdogは、異常検出を後付けではなく、包括的なオブザーバビリティプラットフォームに組み込んだ製品です。インフラ、アプリケーションパフォーマンス、ログ、ユーザーエクスペリエンスのテレメトリを監視し、異常な挙動とインシデント中に原因となりうる要素を示します。
Watchdogはメトリクスの異常、外れ値、予測に基づくしきい値超過を検出します。真の強みは相関分析です。レイテンシが急上昇すると、Datadogの各プロダクトにまたがる関連シグナルが並べて表示されるため、エンジニアは複数のコンソールをつなぎ合わせることなく、症状から原因の見当までたどり着けます。14日間の無料トライアルで、自社のテレメトリを使ってこのワークフローを試せます。
調査のための文脈がないアラートは、作業を先送りするだけです。スパイクを診断に変えるのが相関分析です。
難点はコストです。料金はホスト数、利用するプロダクト、カスタムメトリクス、データ量に応じて増え、一部の高度な機能はプランによって異なります。また、技術的なオブザーバビリティ向けに作られており、ビジネス分析向けではありません。売上や利益率に関する課題であれば、まず2026年の異常検出インサイトを参照し、ビジネス向けのツールから検討してください。
4. New Relic
New Relic は、評価のしやすさという点でここに入れる価値があります。無料プランには月 100 GB のデータ取り込みとフルプラットフォームユーザー 1 名が含まれ、試用期限もありません。小規模なチームでも実際のワークロードを動かし、アラートの仕組みを学び、営業資料ではなく実測データに基づいて判断できます。
このプラットフォームは、アプリケーション、インフラ、ログのテレメトリーを、クエリやダッシュボードと組み合わせて扱えます。アラート条件には動的な異常検知を使えます。データの挙動が変わるにつれてしきい値が自動で調整されるため、固定しきい値で必要になる手作業のチューニングを減らせます。New Relic はベンダーが公開している幅広い連携ライブラリを備えており、一般的なスタックの多くは独自の接続処理なしで接続できます。
- 本当に使える無料評価: 小規模なチームでも、予算の話をする前に適合性を検証できます。
- 見えやすいコスト要因: 取り込み料金が公開されているため、主要な支出の一つを見通しやすくなります。
見通しやすいことは、安いことを意味しません。料金はデータ取り込み量、ユーザーアクセス、場合によっては高度な計算処理に応じて増えるため、保持するテレメトリーが増えれば請求額も上がります。検討すべきトレードオフがあります。数個のメトリクスで異常検知ができれば十分な場合、1 つの機能のためにプラットフォーム価格を払うことになります。その用途であれば、専用のアラートツールのほうが安く済むことが多いでしょう。Datadog と同様に、扱うのはビジネス分析ではなく技術的なテレメトリーの言語です。売上の乖離を探したい財務チームにとっては、課題に合わないツールになります。
5. Elastic
Elastic は、自分たちで細かく制御したく、それを使いこなせる専門人材がいるチームに向いています。機械学習ジョブが、時系列データやその他の対応データにおける通常の挙動をモデル化し、逸脱を異常スコアとともに検出します。セキュリティルールでは、異常が指定したスコアを超えたときにアラートを出せるため、Elastic はオブザーバビリティとセキュリティの両方のワークフローで役立ちます。
この考え方には長い歴史があります。異常ベースの検知は 1980 年代にコンピューターセキュリティの分野で形になりました。プリンストン大学がホストする侵入検知の調査論文では、1987 年に発表された IDES が、通常の活動をプロファイル化してリアルタイムでアラートを生成する初期のシステムとして紹介されています。Elastic は同じ原則を現代の規模で適用しています。まず通常の状態を特徴づけ、そこからの大きな逸脱を検出するのです。
導入を決める前に検討すべき点
- 柔軟性: ジョブの設計、スコアリング、結果を検索やアラートにどう反映するかを自分で制御できます。
- 既存スタックの強み: すでに Elastic で検索を運用している場合、検知の追加は段階的に進められます。
コストは運用面にかかります。ジョブの設定や継続的な管理には専門人材が必要になる場合があります。異常アラートには対象のサブスクリプションまたはプロジェクト階層が必要で、モデルが信頼できる精度になるには十分な過去データが要ります。
6. Google Cloud Monitoring
Google Cloud を標準としているチームにとって、Google Cloud Monitoring は、AWS における CloudWatch と同様、自然な第一候補です。プロジェクトやリソースをまたいでメトリクスを監視でき、カスタムメトリクスとマネージドメトリクスの両方に対応しています。また、メトリクススコープを使えば、複数のプロジェクトを一か所からまとめて確認できます。
アラートルールは、メール、SMS、Slack、PagerDuty などのチャネルで通知を送れるため、ほとんどのオンコール体制は追加ツールなしでカバーできます。料金は従量課金で、一部のデータには毎月の無料枠が公開されています。そのため、データ量が増えて想定外のコストが発生する前に、費用を見積もれます。
- GCP を使う組織に適している: 新しいベンダーも、新しいエージェント戦略も、クラウド間のデータ移動も必要ありません。
- 明確な無料枠: 一部のデータに無料枠があるため、導入初期のリスクを抑えられます。
ただし、適合範囲は正確に見極めてください。これはクラウド運用の監視ツールであり、売上や在庫といったビジネス KPI を監視するものではありません。コストはデータの取り込み量などの利用状況によって変わります。また、セットアップや結果の解釈には、社内にないクラウドの専門知識が必要になる場合があります。具体的な異常検知のワークフローがアラート要件を満たすかどうかは、パイロット導入で確認してください。監視機能全般が優れていても、求める検知の挙動が得られるとは限らないためです。
7. Anomaly.io
すべてのチームにスイート製品が必要なわけではありません。Anomaly.io が担うのは一つの仕事だけです。メトリクスを送ると、時間をかけてパターンを学習し、トレンド、相関、その他の逸脱を検出します。そして、メール、テキストメッセージ、PagerDuty などのチャネルで、わかりやすい言葉の補足を添えてアラートを送ります。
実用面では二つの特長があります。アラートが有用だったかどうかのフィードバックが今後の検知に反映されるため、アラート疲れに直接対処できます。さらに、公開されている料金表にはメトリクスの上限と検知速度が明記されているので、導入前に制約を把握できます。複数のプログラミング言語からメトリクスを送れるため、計測の仕組みもシンプルに保てます。
実践的な基準: 検知ツールは、ベンチマークのスコアだけでなく、チームが1日に実際に確認できるアラート数で評価しましょう。
この絞り込みには、長所と短所の両面があります。これはメトリクス向けのサービスであり、ビジネス分析やレポーティングを網羅するプラットフォームではありません。また、検知には適切なデータの送信と、パターンを学習するための時間が必要です。導入を決める前に、現在の連携先、サービスの適合性、サポート体制を確認してください。手法がまだ決まっていない場合は、まず時系列異常検知アルゴリズムを比較してください。アルゴリズムは、季節性やデータの形に合ったものを選ぶ必要があるためです。
8. Anomalo
ダッシュボードには問題がなさそうでも、誰も数字を信用していないとします。Anomalo は、まさにこの問題のために作られています。ウェアハウスのテーブルを監視し、機械学習で通常と異なるパターンを検出します。また、不正なデータがレポートに届く前に、鮮度、データ量、欠損データ、テーブルの異常をチェックします。
学習ベースの検知と明示的なルールを組み合わせている点が差別化要因です。ノーコードの検証チェックに加えて、カスタム SQL と API も利用できます。そのため、アナリストはビジネスルールを組み込みつつ、誰も想定していなかった変化はモデルに監視させられます。さらに、可視化と根本原因の調査機能により、検出されたテーブルを変化の原因までさかのぼって追跡できます。
- 2層の防御: 予期しない変化と既知のビジネスルールの両方をカバーします。
- エンジニア以外にも対応: ノーコードのチェックにより、アナリストが一部のモニタリングを自ら管理できます。
- 小売での実績: ある小売業の事例では、売上、在庫、商品データを監視しています。
課題は導入のしやすさです。Anomaloは企業向けで、通常はセルフサービスで簡単に購入できず、デモの申し込みが必要です。適合性はサポートされるデータソースやウェアハウスの構成にも左右されるため、早い段階で互換性を確認してください。
9. Bigeye
Bigeyeは、異常検知を単独のアラートの流れとしてではなく、データオブザーバビリティの一部として捉えています。データをプロファイリングし、データの挙動に現れる異常を検知し、モニタリングをリネージ、検証、突合、インシデント管理と組み合わせます。問題が発生すると、リネージによって影響を受ける下流のレポートやユーザーがわかります。
アラートの扱いもよく考えられています。関連するアラートはひとつの課題にまとめられ、調査ワークフローによってトリアージが整理され、アラートへのフィードバックは今後のアラートの精度向上にも役立ちます。検知ツールを使い続けるかどうかはチームの信頼で決まるため、このフィードバックの仕組みは重要です。最近のERPの異常検知に関するNatureの研究では、アンサンブル投票で誤検知を減らした後でも適合率は88.56%と報告されており、ノイズ管理は後付けではなく機能の一部であることを示しています。
デプロイはエージェント方式とエージェントレス方式に対応し、セキュリティ関連の文書では暗号化に加え、Enterprise向けにAWS PrivateLinkをオプションで利用できると説明されています。制約は対象ユーザーと透明性です。Bigeyeは企業のデータチーム向けで、技術的なセットアップとデータシステムへの接続が必要であり、価格は公開されていません。基本となる考え方については、レポート作成前に不良データを検出する方法で、ウェアハウスでのチェックが下流のあらゆる意思決定を守る理由を解説しています。
10. Monte Carlo
Monte Carloはデータオブザーバビリティ分野の最後を飾るツールで、強みは影響範囲の把握にあります。鮮度、ボリューム、スキーマ、データ分布の問題を検知し、リネージを使って対象アセットに依存するものを示します。古くなったテーブルを調べるエンジニアは、関係者が気づく前に、そのテーブルがどのダッシュボードにデータを供給しているかを確認できます。
対象範囲はデータアセット、システム、コード関連の変更に及び、インシデント管理と連携機能によって、問題を既存のワークフローに振り分けられます。パイプラインが整備され、専任のデータチームがいる組織では、この依存関係の可視化が検知から解決までの時間を短縮します。
- つながった調査: 異常には依存関係と影響範囲のコンテキストが付いて届きます。
- 幅広い信頼性のカバー範囲: 一般的な障害カテゴリを1つのプラットフォームで扱えます。
制約面は同種のツールと共通しています。非技術系チーム向けのシンプルなビジネス分析ではなく、データ基盤の信頼性を高めることを目的に設計されています。また、得られる価値はデータ環境の規模と複雑さによって変わります。パイプラインが3本しかない小規模なウェアハウスでは、大規模で入り組んだ環境ほどリネージの効果は得られません。価格は公開されておらず、評価もベンダー主導で進むため、予算を把握するには営業担当との相談が必要です。
ツール選定と成果につなげるための要点
ベンダー一覧ではなく、まず目的から考えましょう。ビジネス上の問いに答えるためにインフラ監視を導入したり、単純な指標アラートで足りるのにウェアハウスのオブザーバビリティを選んだりするチームは少なくありません。機能を比較する前に、下したい判断に合ったカテゴリを選んでください。
選定のための4ステップ
- データに合ったツールを選ぶ。インフラ指標なら CloudWatch、Datadog、New Relic、Elastic、Google Cloud Monitoring が候補です。ウェアハウスのテーブルなら Anomalo、Bigeye、Monte Carlo、ビジネスKPIならビジネス向けのプラットフォームが適しています。
- 既存環境との連携を確認する。クラウド、ウェアハウス、会計データを読み取れない検知ツールは、保守すべきパイプラインを1つ増やすだけです。実データを使ったパイロットで、コネクタや必要な過去データの条件を確認しましょう。
- ボリューム増加時の料金を確認する。取り込み量、ホスト数、カスタム指標、監視対象テーブルは時間とともに増えていきます。契約前に、現在の2倍のボリュームでコストを試算してください。
- 非技術系のメンバーがアラートに対応できるか確認する。異常スコアだけでは、経理担当者は何をすべきか分かりません。平易な言葉での説明、考えられる原因、明確な次のアクションがあるかを見てください。
導入はゴールではありません。プロモーション、新製品の発売、顧客行動の変化といった通常の変動でも、ベースラインは動きます。Future AGI による異常検知の失敗パターンのレビューでは、コンセプトドリフトとラベル付き異常データの不足が、ベンチマーク比較では見落とされがちな問題として挙げられています。ベースラインの変更を誰が承認するのか、フィードバックをどう取り込むのか、不適切な適応をロールバックできるのかを、すべてのベンダーに確認しましょう。
再現率がやや低い検知ツールでも、アラート疲れを減らし、必要な対応を説明できるなら、より大きな価値を生むことがあります。
データチームのない成長企業は、インフラの複雑さを避けて、ビジネス指標を直接監視できます。AI搭載のデータ分析プラットフォームである ELECTE は、ビジネスデータを監視し、異常を特定し、トレンドを可視化し、レポートを生成します。多くのユーザーは、会計ソフトを接続するかファイルをアップロードしてから5分以内に利用を開始しています。
誰も見ないダッシュボードをもう1つ増やすのではなく、ビジネスデータに常時稼働のアナリストを置きましょう。ELECTE は数値を監視し、異常やトレンドが現れた時点で知らせ、チームが行動に移せる明確なインサイトとレポートにまとめます。会計ソフトを接続するかファイルをアップロードすれば、最初の予測がすぐに表示されます。
コメント
まだコメントはありません — 会話を始めましょう。