Previsão de demanda para o varejo: métodos, dados e benefícios
Saiba como funciona a previsão de demanda para o varejo, quais métodos usar, de quais dados ela precisa e como reduzir rupturas e excesso de estoque com planos de estoque melhores.

Uma ruptura de estoque costuma ser atribuída ao fornecedor. Na maioria das vezes, ela começa bem mais perto de casa. Um estudo sobre estoque no varejo apresentado na conferência da IEOM Society em Bangladesh, em 2025, indica que de 51% a 73% das rupturas em supermercados têm origem dentro da própria operação de varejo, e que previsões imprecisas (incluindo a subestimação da demanda) e erros de pedido estão entre as principais causas.
Essa constatação muda o enfoque do trabalho. A previsão de demanda para o varejo não é uma disputa para escolher o algoritmo mais avançado. É uma disciplina operacional: extrair sinais honestos de demanda de dados que rupturas e promoções já distorceram, adequar o método ao modo como cada produto vende e conectar o resultado a pontos de reposição que um comprador vai usar na manhã de segunda-feira.
Este guia cobre o ciclo completo. Você verá o que a previsão precisa entregar, quais entradas pesam mais, como seis métodos comuns se comparam por situação de varejo, por que itens de baixo giro exigem uma arquitetura diferente, como o estoque doméstico e a troca de canal inflam o efeito aparente das promoções, qual métrica de erro usar em cada decisão e uma verificação em cinco etapas para fazer antes do próximo ciclo de compras.
O que a previsão de demanda significa no chão de loja
Uma previsão do tempo ganha confiança quando é local e tem horário: a chance de chuva na sua cidade na terça à tarde basta para decidir se você leva o guarda-chuva. A previsão de demanda faz o mesmo trabalho para o estoque. Ela estima quantas unidades de um item específico os clientes comprarão em uma loja específica durante uma semana específica, para que o comprador peça a quantidade certa, e não apenas uma quantidade plausível.
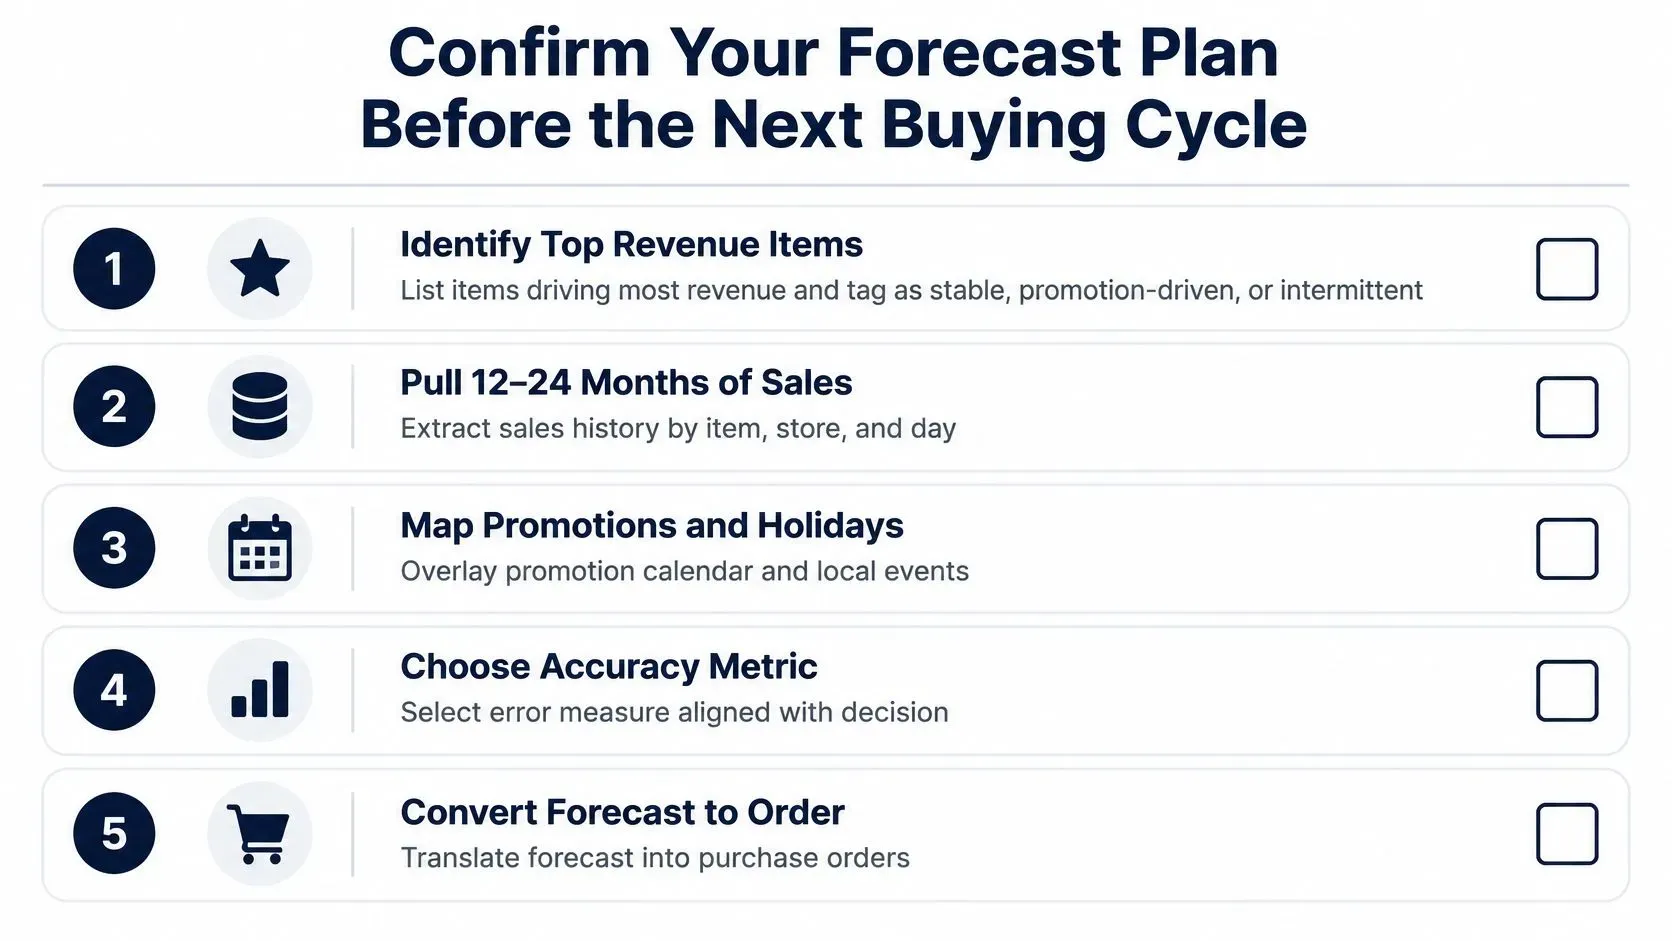
As cinco etapas abaixo resumem toda a ideia, da previsão até o pedido de compra que ela deve disparar.
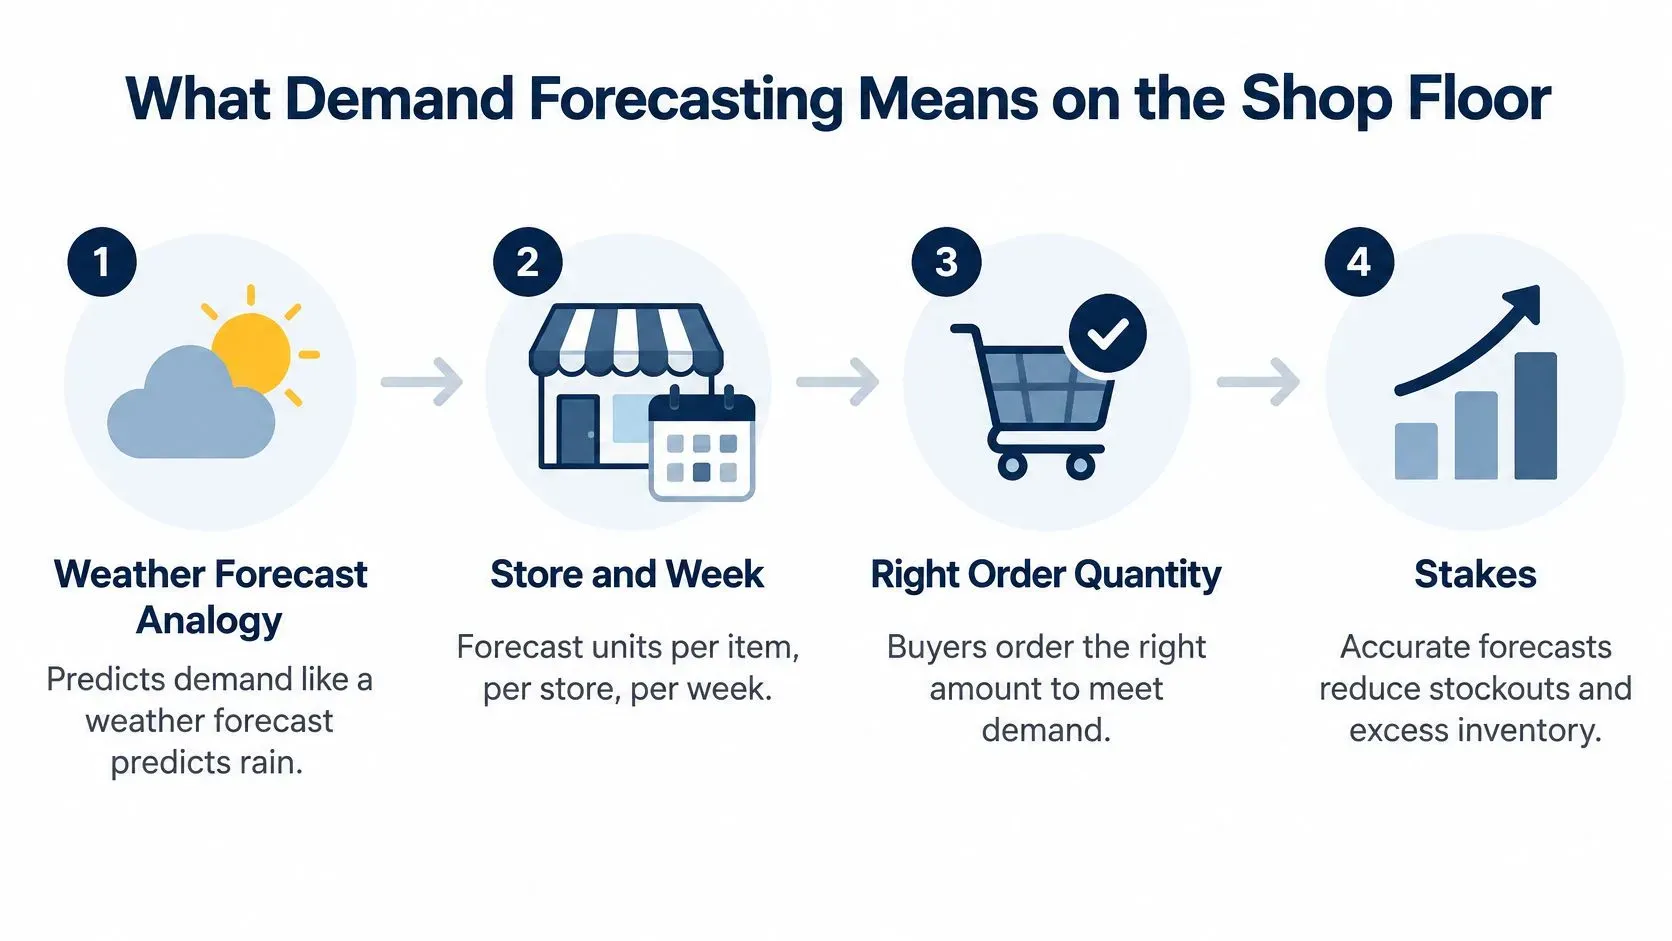
O alvo é a demanda, não o total de vendas que o caixa registrou. Um zero registrado enquanto a prateleira de shampoo estava vazia é demanda censurada; um pico promocional pode ter sido antecipado das duas semanas seguintes ou tirado de uma loja vizinha. Médias por categoria e relatórios mensais escondem esses problemas por item e por loja, então o sinal precisa se manter granular e ser atualizado com frequência.
O ciclo de trabalho é este:
- Colete o histórico de vendas e de estoque por item, loja e dia, incluindo os dias em que a prateleira estava vazia.
- Limpe e alinhe os dados: uma unidade de medida, um calendário, nenhuma linha duplicada quando o sistema de uma loja reapresenta uma semana.
- Ajuste e preveja a demanda por item e loja, na granularidade que a sua decisão de pedido exige.
- Traduza a previsão em pedidos e estoque de segurança, usando os prazos de entrega e o nível de serviço que você prometeu.
- Meça os erros e ajuste, item a item, em vez de uma vez por ano na hora do orçamento.
Cada etapa protege contra um de três custos. Se você prevê de menos, perde vendas que não recupera, porque o cliente compra o substituto ou vai embora. Se prevê demais, o caixa fica parado em estoque que precisará de remarcação. Se acerta a quantidade mais ou menos, mas erra o momento, você paga nos dois lados: frete mais caro no pedido urgente e armazenagem do excedente.
A regra que mais economiza dinheiro: uma previsão só se paga quando uma regra de reposição age sobre ela. Um número perfeito parado em um relatório não muda nada na prateleira.
As entradas de dados e por que as rupturas as distorcem
Antes de comparar modelos, olhe o que entra neles. As entradas que mais melhoram a precisão no varejo são previsíveis e pouco glamorosas, e muitas equipes não têm duas ou três delas.
- Histórico de vendas por item, loja e dia. Qualquer nível mais agregado esconde as semanas de promoção e os picos de fim de semana que carregam o sinal.
- Estoque disponível e duração das rupturas. Sem eles, não dá para distinguir uma semana fraca de uma prateleira vazia.
- Preços e profundidade do desconto. Um corte de 10% e um de 30% não geram a mesma curva de resposta, então registre o preço de prateleira que o cliente paga, não o preço de tabela.
- O calendário de promoções, incluindo posição de exposição e publicidade de destaque.
- Feriados e eventos locais. Uma festa escolar a duas ruas dali movimenta mais água engarrafada do que um feriado nacional.
- Clima, especialmente para as categorias de frescos, sazonais e jardinagem.
- Preços da concorrência, sempre que você conseguir observá-los de forma consistente.
- Prazos de entrega dos fornecedores e atrasos, que definem quanta cobertura você precisa.
Por que uma prateleira vazia registra um falso zero
Digamos que seu shampoo venda em média 40 unidades por semana e a prateleira fique vazia por três dias. Esses dias registram zero venda. Um modelo treinado com esse histórico aprende que a demanda cai sempre que o estoque acaba, o oposto da verdade. Os clientes que não encontraram o produto não mudaram de ideia; foram comprar em outro lugar.
Atrasos de fornecedores, reposição lenta e as suas próprias decisões de pedido censuram as vendas exatamente da mesma forma. O modelo não tem como distinguir uma venda perdida de um desinteresse, e continuará pedindo de menos o item que esgota mais rápido.
A falha é bem documentada. Uma revisão de 2026 sobre aprendizado de máquina na previsão para o varejo identifica conjuntos de dados incompletos, fluxos de dados fragmentados, mudanças no comportamento do consumidor, promoções, reações de concorrentes e sazonalidade como causas de modelos enviesados e frágeis. A mesma revisão cita uma pesquisa com 661 profissionais de estoque em que 51% às vezes seguiam com previsões que já consideravam pouco confiáveis por não haver alternativa melhor, enquanto mudanças tarifárias e de política comercial (19%) e oscilações da inflação ou dos preços de commodities (17%) figuravam entre os maiores fatores de perturbação.
A correção em quatro etapas, em ordem
- Marque todos os dias de ruptura de stock no histórico de vendas, indicando as horas ou os dias em que o artigo esteve indisponível.
- Estime as vendas perdidas nesses dias a partir de artigos comparáveis na mesma loja e na mesma semana.
- Classifique cada período como disponível ou limitado antes de iniciar qualquer treino.
- Treine com o histórico ajustado e compare os resultados em semanas reservadas para teste, nunca nas semanas que corrigiu.
Para a maioria das PME, este trabalho melhora mais a precisão do que trocar de algoritmo. Um modelo só aprende o que o registo contém; se o registo diz que a procura caiu durante uma ruptura de stock, uma arquitetura mais sofisticada apenas aprende a coisa errada mais depressa. O nosso guia ELECTE sobre integração de várias fontes explica a infraestrutura que reúne dados de vendas, stock e promoções numa única tabela utilizável.
Métodos de previsão comparados por situação de retalho
Não existe um método melhor, apenas o método que se adequa à situação. A tabela abaixo é a comparação que eu gostaria de ter afixada sobre uma mesa de planeamento.
Método | Melhor cenário no varejo | Dados necessários | Ponto forte | Ponto de atenção |
|---|---|---|---|---|
Média móvel ou suavização exponencial | Itens estáveis e de alto volume | 1 a 2 anos de vendas semanais | Simples, barato e fácil de explicar | Ignora promoções e variações sazonais |
Modelos sazonais como SARIMA | Itens com ciclos semanais ou anuais claros | Histórico de duas ou mais temporadas | Captura tendência e sazonalidade | Tem dificuldade com milhares de séries ao mesmo tempo |
Métodos da família Croston | SKUs intermitentes e de baixo giro | Histórico de vendas com muitos períodos zerados | Separa a frequência das vendas do seu volume | Escolha errada para itens de venda constante |
Regressão com variáveis de promoção e preço | Categorias movidas por promoções | Calendário de promoções e histórico de preços | Mostra como cada fator move a demanda | Perde eficácia quando as promoções são raras |
Ensembles de árvores como XGBoost ou LightGBM | Grandes portfólios de item por loja | Vendas, calendário, promoções e preços | Aprende com muitas séries relacionadas | Exige dados limpos e monitoramento contínuo |
Ensembles híbridos LSTM-XGBoost | Redes multicategoria com sinais ricos | 36 meses de dados de ponto de venda e promoções | Reduziu o erro percentual absoluto médio em 28,6% em média, num horizonte de quatro semanas, em um estudo com 14 organizações de varejo | Mais pesado de construir e de explicar |
O padrão por trás das linhas importa mais do que qualquer linha isolada. Uma revisão por pares da pesquisa em previsão para o varejo relata que modelos globais de machine learning, incluindo redes neurais feed-forward e recorrentes, árvores de regressão com gradient boosting e random forests, muitas vezes superam modelos separados de séries temporais e de regressão quando os varejistas preveem grandes conjuntos de séries de vendas. A vantagem cresce com o portfólio: milhares de combinações item-loja em que cada produto tem demanda esparsa, intermitente, sazonal ou sensível a promoções.
Como é a comparação em uma rede real
Imagine uma rede regional com 40 lojas. Os itens básicos, com vendas semanais estáveis, usam suavização exponencial, porque o gerente de categoria consegue ler o número e questioná-lo. A moda sazonal, com oito promoções por ano, usa um modelo de gradient boosting treinado em todas as lojas ao mesmo tempo, porque o histórico de uma só loja é curto demais para aprender uma curva de desconto.
A revisão também deixa claro que os métodos mais antigos não estão obsoletos. Seu desempenho continua competitivo em conjuntos de dados menores, produtos estáveis e cenários em que interpretabilidade e poucos dados pesam mais do que o último ponto de precisão.
A contenção compensa. Uma avaliação de 2026 da demanda do varejo nos EUA com o conjunto de dados M5, cobrindo 25.940 séries item-loja em cinco janelas móveis de 28 dias, reduziu o erro percentual absoluto ponderado médio de 0,9006, com um benchmark sazonal ingênuo, para 0,7022, com um modelo LightGBM que usa a demanda histórica, uma melhoria de cerca de 22%. Adicionar variáveis de varejo e operacionais chegou apenas a 0,6979, e indicadores macroeconômicos defasados chegaram a 0,6978, um ganho de aproximadamente 0,02%.
Construa primeiro a linha de base. Um número sazonal ingênuo ou de suavização exponencial, produzido em uma tarde, mostra se o modelo de machine learning mereceu sua complexidade. Rode os dois nas mesmas semanas reservadas para teste e fique com o vencedor.
A escolha do modelo deve seguir a escala e a estrutura do portfólio, não o fato de o método ser mais novo. Esse único princípio vai economizar mais dinheiro do que qualquer busca de hiperparâmetros.
Itens de baixo giro e demanda esparsa precisam de modelo próprio
Alguns produtos não têm um nível de demanda. Têm um evento de demanda. Uma peça de reposição que vende quatro vezes por ano, uma variante de cauda longa no e-commerce, uma combinação loja-SKU que move duas unidades por mês: os modelos sazonais padrão lidam mal com esses casos, e o motivo é estrutural.
Zeros e vendas positivas vêm de dois processos diferentes. Se uma venda acontece é uma pergunta. Qual o tamanho dela quando acontece é outra. Os métodos do tipo Croston estimam as duas coisas separadamente, e por isso se sustentam em dados de varejo cheios de zeros. Um benchmark de previsão para o varejo com demanda intermitente relata Croston com WAPE de 93,15% e MASE de 0,9852, à frente das alternativas naive e SARIMAX com que foi comparado. Leia esse WAPE como um resultado relativo em uma série cheia de zeros, não como uma boa pontuação de precisão em termos absolutos.
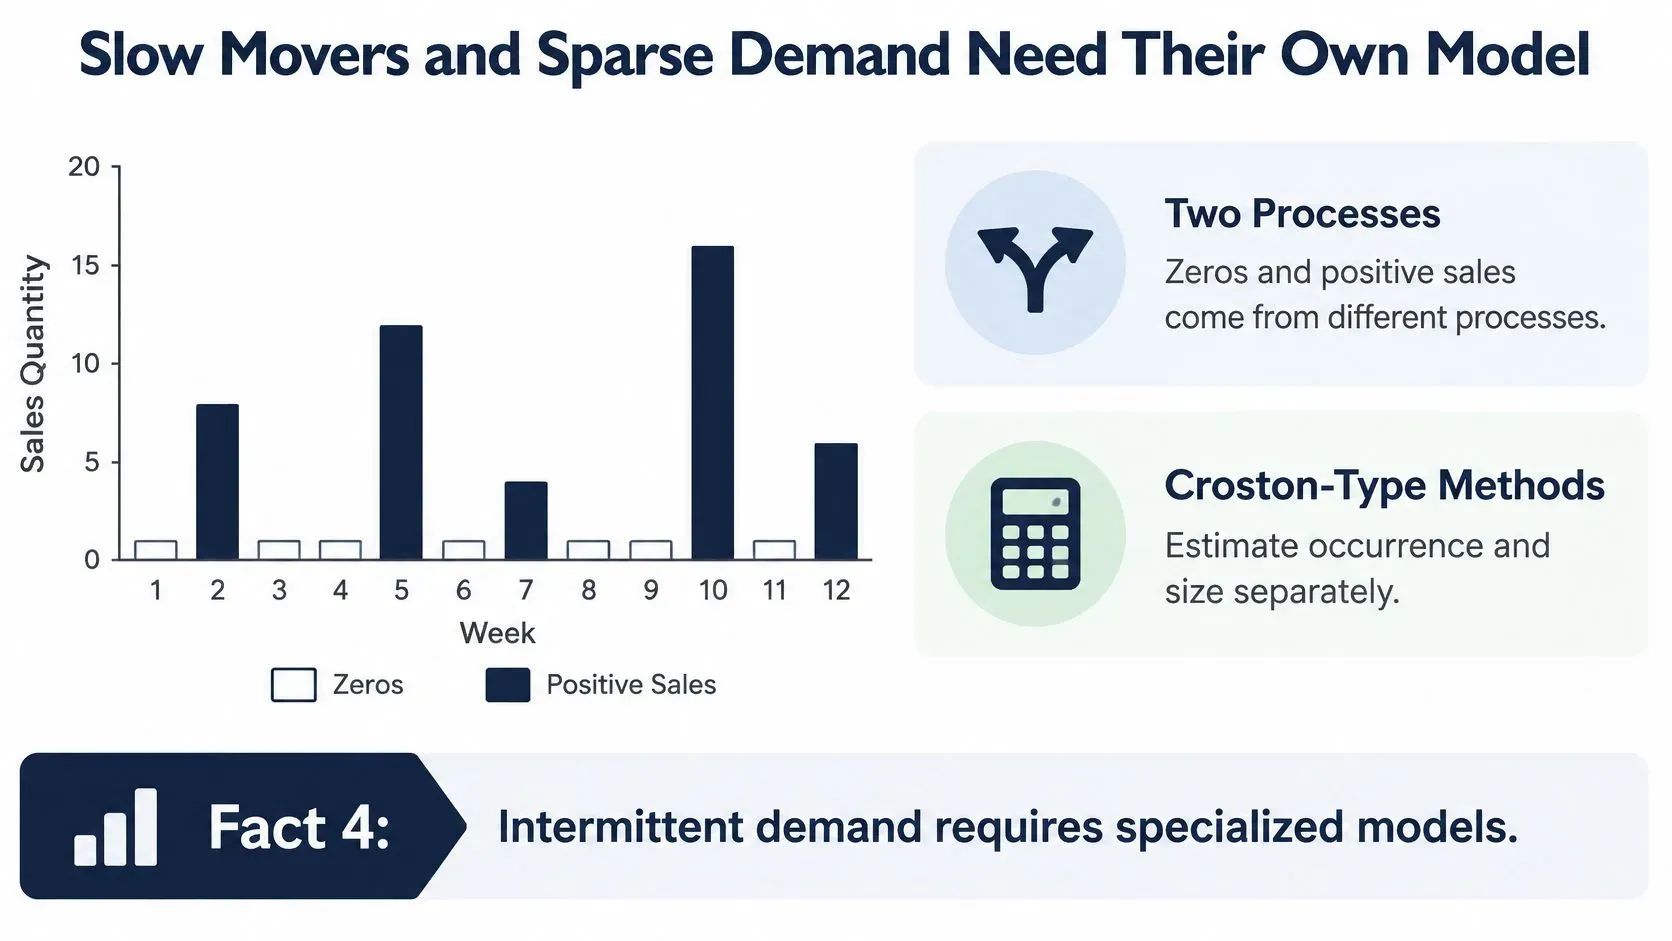
O modo de falha é específico e caro. Um modelo padrão de regressão ou sazonal vê uma sequência de zeros e conclui que a demanda é baixa e estável, então define o estoque de segurança de acordo. O item de baixo giro que vende em surtos imprevisíveis fica sem estoque, enquanto o item parado mantém três meses de cobertura. Um erro custa uma venda; o outro custa caixa e espaço de prateleira.
Há uma segunda lição no mesmo território. Um benchmark com dados de vendas com demanda intermitente, observações ausentes e rotatividade frequente de sortimento constatou que modelos localizados baseados em árvores tiveram o melhor desempenho entre as abordagens testadas, com o XGBoost alcançando o menor erro quadrático médio (RMSE) relatado, de 4,833. A conclusão não é "use XGBoost em tudo". É que, quando os produtos giram rápido, modelos construídos por família de produtos podem superar um único modelo generalizado, obrigado a fazer a média de padrões incompatíveis.
Como direcionar uma série
- Classifique antes de modelar. Calcule o Intervalo Médio de Demanda e o coeficiente de variação ao quadrado da demanda não nula de cada série. O primeiro é o intervalo típico, em períodos, entre vendas; o segundo mede quanto o tamanho dessas vendas oscila de uma venda para a seguinte.
- Direcione as séries intermitentes para modelos da família Croston, hurdle ou de ocorrência-tamanho.
- Envie os itens estáveis e de alto volume para modelos sazonais ou de machine learning, que é o lugar deles.
- Reverifique a classificação todo trimestre. Os itens mudam de categoria conforme envelhecem, são descontinuados ou pegam, e uma regra de direcionamento que nunca é reexecutada se degrada.
Mantenha a classificação em uma tabela que possa ser consultada. Quando um gerente de categoria perguntar por que um produto é previsto com um método estranho, a resposta deve ser dois números, não um dar de ombros.
Promoções, estocagem e mudanças de canal
Semanas promocionais não são semanas comuns, e misturá-las à linha de base corrompe as duas. Modele a demanda base e os efeitos da promoção como coisas separadas e depois some-os.
Uma comparação de abordagens de previsão para o varejo constatou que conjuntos de árvores de decisão superaram a regressão linear, a regressão linear penalizada e os métodos de árvore de regressão na demanda diária em nível de rede quando os SKUs tinham mais de cinco promoções históricas. Cinco é o limite útil nesse resultado. Abaixo dele, não há exemplos suficientes para o modelo aprender como a profundidade do desconto, o momento da promoção e as interações com o calendário do produto movem a demanda; por isso, uma regularização mais forte ou um benchmark mais simples causa menos dano do que um modelo flexível perseguindo ruído.
Dê ao modelo variáveis explícitas: status da promoção, percentual de desconto, posição de exposição, proximidade de feriados e demanda defasada pós-promoção. Esta última costuma ficar de fora, mas é a variável que captura a queda.
A queda que ninguém prevê
Imagine que um desconto de 30% em shampoo aumenta as vendas durante uma semana e, em seguida, as vendas ficam abaixo da tendência por duas semanas. Os clientes fizeram estoque; não compraram mais ao longo do trimestre. Trate toda a janela de três semanas como uma única unidade de análise. O erro no período promocional mostra se você pediu o suficiente. O erro no período pós-promoção mostra se você pediu demais para o resto do mês. Avaliados separadamente, os dois erros aparecem. Avaliados em conjunto, eles se anulam e o relatório parece limpo, embora você tenha errado nas duas decisões.
Uma pesquisa sobre o ciclo de vida promocional observa que estudos anteriores costumam ignorar a fase pós-promocional, em que a demanda cai porque os clientes fizeram estoque durante a ação, e relata que métodos de machine learning podem melhorar as previsões ao longo de todo o ciclo de vida, e não apenas durante a promoção em si.
O canal acrescenta uma segunda camada de ilusão. Um estudo sobre promoções multicanal em um supermercado regional brasileiro estimou um deslocamento de demanda de 11,23% das lojas físicas para o online e de 19,34% no sentido inverso, enquanto promoções coordenadas reduziram a canibalização em 30,04%. Os incentivos de fidelidade geraram o maior aumento medido, de 3,5%. Se você prevê cada canal de forma independente, vai contar duas vezes uma demanda que apenas mudou de endereço.
Em seguida, siga quatro regras na avaliação:
- Avalie separadamente os períodos promocionais e não promocionais, para que uma semana boa não esconda um mês ruim.
- Compare com uma linha de base de lift ou outra linha de base causal semelhante; do contrário, você só está medindo o quanto o modelo aprendeu o volume.
- Avalie por SKU e por frequência de promoção, porque o limite de cinco promoções muda o que você pode esperar.
- Mantenha ativa uma variável defasada de pós-promoção, para que o modelo possa expressar a queda em vez de ser surpreendido por ela.
Se os descontos estão corroendo sua margem, nosso guia para proteger as margens durante campanhas de desconto aborda o lado de precificação do mesmo problema.
Medindo a acurácia e transformando previsões em pedidos
Escolha a métrica depois de escolher a decisão. Cada medida responde a uma pergunta diferente e esconde algo diferente.
Métrica | Quando usar | Atenção a |
|---|---|---|
WAPE (erro percentual absoluto ponderado) | Comparar a acurácia entre itens de tamanhos diferentes | Dá mais peso aos itens de alto volume |
MASE (erro absoluto escalado médio) | Comparar modelos em séries intermitentes ou com muitos zeros | Precisa de um benchmark ingênuo para ser lida corretamente |
MAPE (erro percentual absoluto médio) | Relatórios simples sobre itens estáveis e de alto volume | Instável ou indefinida quando a demanda real é zero |
Viés | Identificar superestimação ou subestimação sistemática | Erros que se compensam podem escondê-lo, a menos que seja lido por período |
Nível de serviço | Verificar se a previsão protege a disponibilidade na prateleira | Depende das configurações de reposição, não apenas da previsão |
Erros percentuais falham em itens de baixo giro. Quando a demanda real é zero, o denominador é zero e a métrica explode ou é excluída da média, e os dois resultados favorecem o modelo. Reporte o WAPE ou um erro escalado junto com o viés e o nível de serviço, e leia-os por segmento, em vez de como um único número para todo o catálogo.
De um número a um ponto de reposição
Uma previsão vira pedido por meio de uma conta que qualquer pessoa da equipe pode conferir. A demanda esperada durante o lead time, mais um estoque de segurança dimensionado para o nível de serviço desejado, resulta no ponto de reposição.
Imagine que uma loja espera vender 40 unidades durante um prazo de entrega do fornecedor de cinco dias e mantém uma reserva de 10 unidades. O ponto de reposição é de 50 unidades. Quando o stock disponível mais o stock já encomendado desce para 50, a encomenda é enviada. Se o comprador encomendar com 40 porque a reserva nunca foi acordada, a prateleira fica vazia no primeiro dia em que o camião se atrasar.
Duas rotinas mantêm este processo rigoroso. Defina alertas de exceção para quando o erro de previsão de um artigo ultrapassar o seu limite durante dois ou mais períodos consecutivos, para que alguém analise o artigo em vez de olhar apenas para o painel. Faça uma verificação mensal de enviesamento por categoria, para detetar sobreprevisão ou subprevisão sistemática que os erros de cada artigo, ao serem calculados em média, acabam por esconder.
Uma previsão estatisticamente precisa pode, ainda assim, causar ruturas de stock se o momento da encomenda, a frequência de revisão ou o stock de segurança estiverem mal calibrados. Reveja a previsão e as regras de reposição em conjunto, ou continuará a corrigir o elemento errado.
O nosso guia de análise de dados de stock da ELECTE aprofunda a ligação entre as posições de stock e os números em que os compradores baseiam as suas decisões.
Confirme o seu plano de previsão antes do próximo ciclo de compras
Antes de fazer a próxima encomenda, confirme que o processo de previsão se adequa aos produtos e às decisões que tem de apoiar. Cinco verificações tornam o plano prático:
- Faça a triagem do seu sortido. Identifique os artigos que geram a maior parte da sua receita e classifique-os como estáveis, impulsionados por promoções ou intermitentes. Para os restantes, uma regra mais simples pode ser suficiente.
- Verifique o histórico de vendas. Extraia 12 a 24 meses de vendas por artigo, loja e dia, e assinale os dias de rutura de stock. Se só tiver 12 meses disponíveis, utilize os dados, mas conte com um erro maior.
- Teste face a uma referência. Defina uma referência sazonal e compare modelos mais sofisticados em semanas reservadas para teste. O resultado do M5 acima mostra por que razão um modelo mais complexo deve justificar o seu lugar.
- Defina a rotina de medição. Escolha uma métrica para cada decisão e mantenha o respetivo limite e a cadência de revisão consistentes entre ciclos.
- Reveja as falhas repetidas. Volte a verificar os pontos de reposição dos artigos com erros de previsão recorrentes antes de fazer a encomenda.
A ELECTE aplica seis métodos de previsão aos dados do utilizador, compara-os entre si e seleciona o mais preciso. A sua calculadora gratuita de ponto de reposição ajuda a calcular o ponto de reposição de cada artigo.
As previsões reduzem o risco, mas não conseguem contemplar todas as mudanças. Um modelo pode não antecipar o lançamento de um novo produto ou uma promoção sem histórico de vendas comparável. Mantenha uma rotina de revisão a par da previsão, para que os compradores possam reagir quando a procura real diferir do plano.
A ELECTE liga dados de vendas, stock e promoções, compara seis métodos de previsão com os dados disponíveis e apresenta previsões, precisão e exceções em painéis visuais que as equipas podem partilhar. Se é retalhista e quer avaliar previsões de procura a par das suas próprias vendas, visite a ELECTE.
Comentários
Ainda não há comentários — comece a conversa.