Schritte der Datenvorverarbeitung: So bereinigen Sie Geschäftsdaten
Erfahren Sie, mit welchen Schritten der Datenvorverarbeitung aus unsauberen Geschäftsdaten verlässliche Erkenntnisse werden – mit Beispielen für KMU. So automatisiert ELECTE sie.
Sie haben einen Verkaufsexport gezogen, der fertig aussieht. Bestellungen, Kosten und Datumsangaben füllen die Tabelle. Dann landet eine Prognose auf dem Schreibtisch der Finanzleitung, und der durchschnittliche Bestellwert ist gesprungen, obwohl sich am Sortiment nichts geändert hat.
Dieser Sprung ist oft ein Vorverarbeitungsfehler und keine Änderung im Kaufverhalten. Wer fehlende Preise auffüllt, solange doppelte Rechnungen noch in der Datei stehen, oder den gesamten Export skaliert, bevor er Zeilen zurückhält, bringt dem Modell Fakten bei, die es noch nicht kennen darf. Die meisten Beiträge führen die Schritte der Datenvorverarbeitung als einzelne Techniken auf, die sich in beliebiger Reihenfolge anwenden lassen. Gerade die Reihenfolge bläht die Ergebnisse auf.
Im Folgenden finden Sie die Abfolge, die ich empfehle, wenn ein Analyst eine aktive Geschäftsdatei verantwortet. Sie erhalten eine Ablaufreihenfolge, die Schwellenwerte, die ich als Ausgangspunkte und nicht als Gesetze behandle, und eine Methode, jede angepasste Einstellung zu fixieren, damit der nächste Datenimport demselben Weg folgt.
Sieben Schritte der Datenvorverarbeitung in der richtigen Reihenfolge
Ein Verkaufsexport kann vollständig wirken und trotzdem doppelte Rechnungszeilen, leere Stückkosten und Datumsangaben in zwei Formaten verbergen. Bereinigen Sie diese Probleme in der falschen Reihenfolge, erbt jeder spätere Durchschnitt sie.
Jeder Schritt, der einen Wert aus den Daten lernt, muss nach der Aufteilung laufen. Ein Mittelwert, ein Median oder ein Skalierungsbereich, der auf der gesamten Datei berechnet wird, lässt Validierungszeilen das Training beeinflussen. Der Score wirkt dann stärker, als das Modell bei den Bestellungen des nächsten Monats sein wird.
Schritt | Was Sie tun | Fertig, wenn |
|---|---|---|
1. Profilieren und bereinigen | Zeilenzahlen, Datentypen und Null-Raten prüfen; exakte Duplikate entfernen; Datumsangaben und Bezeichnungen vereinheitlichen | Saubere Basistabelle mit einer Bezeichnung pro Kategorie |
2. Daten aufteilen | Zeilen mischen, dann in Trainings- und Validierungsdaten aufteilen | Zwei Datensätze liegen vor, und es wurden noch keine gelernten Einstellungen berechnet |
3. Fehlende Werte behandeln | Zeilen entfernen, das Merkmal entfernen oder ausschließlich anhand der Trainingsdaten imputieren | Jedes Feld ist vollständig oder seine Lücken sind markiert |
4. Kodieren und Merkmale entwickeln | Kategorien in Zahlen umwandeln; Verhältnisse, Zeitanteile und gleitende Durchschnitte bilden | Eine modellfertige Merkmalstabelle mit dokumentierten Spalten |
5. Ausreißer behandeln | Extremwerte prüfen, dann begrenzen, transformieren oder markieren | Extremwerte sind erklärt, nicht geraten |
6. Numerische Merkmale skalieren | Einen Skalierer auf den Trainingsdaten anpassen und auf die Validierungsdaten anwenden | Numerische Spalten liegen in vergleichbaren Bereichen |
7. Pipeline fixieren | Jede angepasste Transformation speichern, damit neue Daten demselben Weg folgen | Ein wiederholbarer Ablauf, der bei jedem neuen Datenimport funktioniert |
Angenommen, ein Händler hat 12.000 Bestellpositionen, darunter 900 doppelte Rechnungszeilen. Wenn Sie fehlende Preise imputieren, bevor Sie diese Duplikate entfernen, zählt dieselbe Rechnung doppelt, und der Durchschnitt weicht von der Preisliste ab.
Praxisregel: Schließen Sie die aktuelle Zeile ab, bevor Sie etwas berechnen, das die nächste Zeile braucht.
Legen Sie die Datei, die Sie gerade geöffnet haben, auf diese sieben Zeilen. Die erste Zeile, die Sie noch nicht abgeschlossen haben, ist die einzige, die heute einen Eingriff wert ist.
Rohdaten aus dem Geschäftsbetrieb profilieren und bereinigen
Das Profiling ist ein einstündiger Durchgang, den eine Führungskraft abschließen kann, bevor jemand ein Modell öffnet. Lassen Sie die Rohdatei unangetastet und halten Sie jede Änderung in einem Bereinigungsprotokoll fest, damit eine Finanzleitung nachvollziehen kann, warum sich eine Summe verschoben hat.
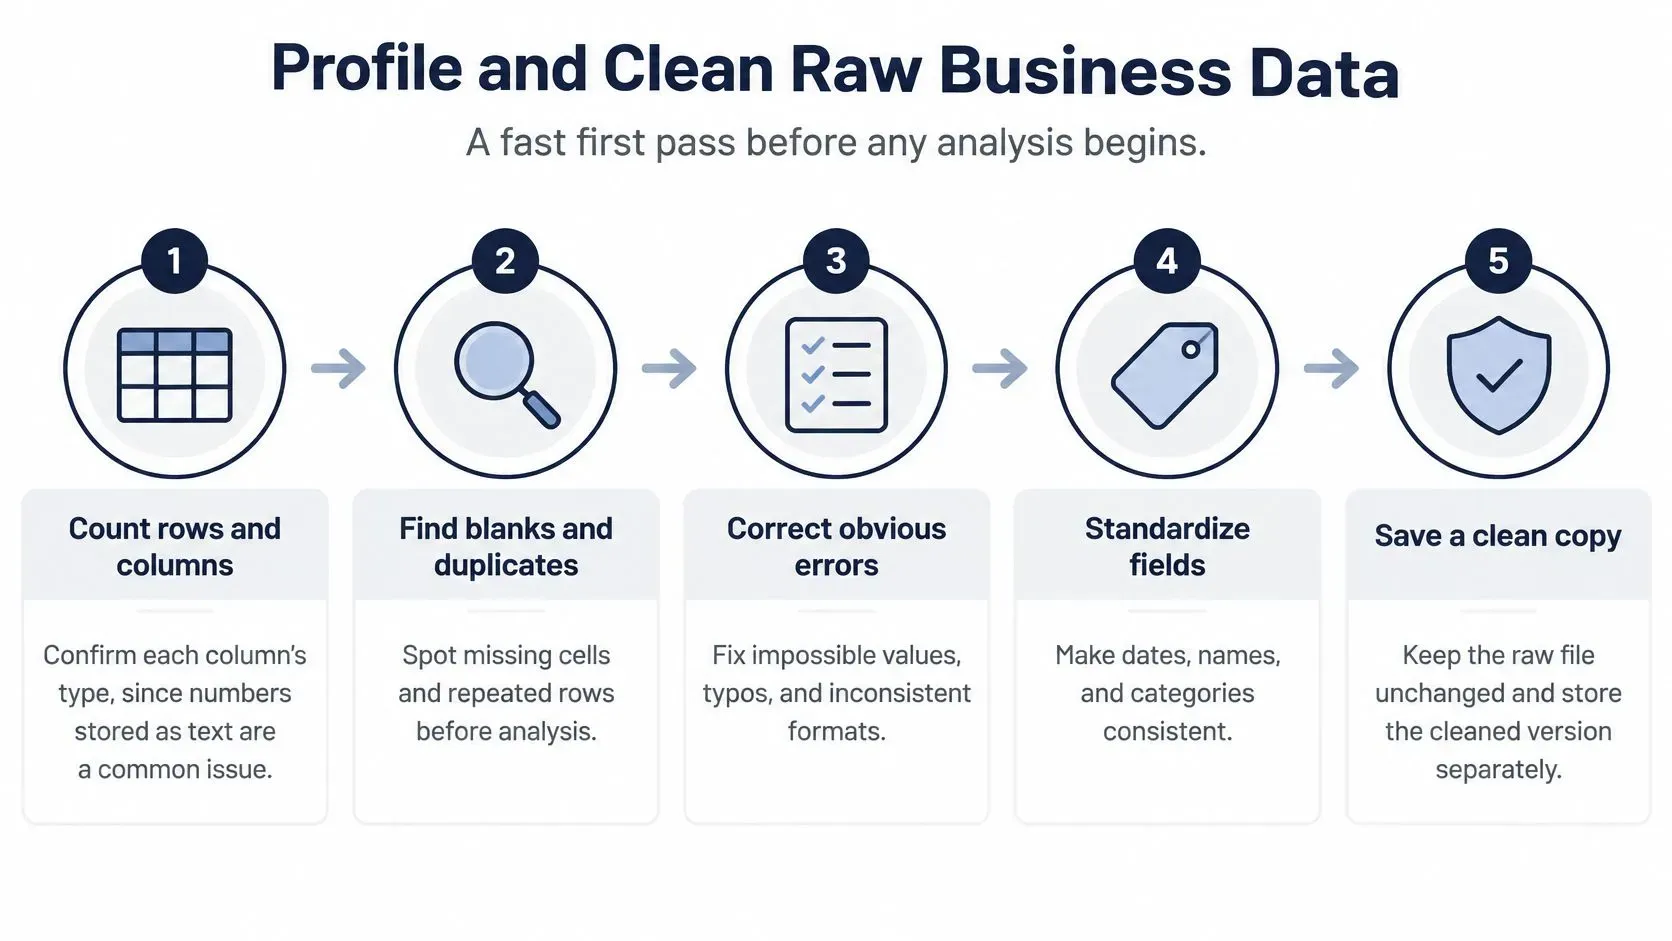
- Zeilen und Spalten zählen, dann jeden Datentyp prüfen. Ein als Text gespeicherter Kostenwert lässt sich nicht summieren, und das fällt nicht durch eine Fehlermeldung auf. Wandeln Sie ihn um, bevor Sie einer Summe vertrauen.
- Die Quote fehlender Werte für jede Spalte berechnen. Eine Spalte mit mehr als 30 % Leerwerten geht an die Regeln für fehlende Werte, statt schnell aufgefüllt zu werden. Eine Spalte würde ich nur dann ganz streichen, wenn die Leerwerte 50 % übersteigen und das Feld für die Entscheidung nicht erforderlich ist.
- Exakte Duplikate entfernen, keine ähnlich aussehenden Zeilen. Gleichen Sie über Rechnungsnummer, Datum und Betrag zusammen ab. Eine zweite Bestellung mit anderer Positions-ID ist ein echter Verkauf. Sie zu löschen, weil Kunde und Tag übereinstimmen, ist der Fehler, der den Umsatz zu niedrig ausweist.
- Formate in einem Durchgang vereinheitlichen. Ein Datumsformat, eine Währung pro Spalte und keine überzähligen Leerzeichen in Codes. Gemischte Formate teilen ein Produkt in zwei Reihen und stören jede spätere Verknüpfung.
- Kategoriebezeichnungen standardisieren.
UK,U.K.undUnited Kingdomsind ein einziger Markt. Vier Schreibweisen derselben Produktlinie in einem dreijährigen E-Commerce-Export richten denselben Schaden an. Wählen Sie eine Bezeichnung und ordnen Sie die übrigen zu.
Angenommen, derselbe Export speichert Bestelldaten in einem Jahr als 2024-03-01 und in einem anderen als 01/03/2024. Solange beides nicht in ein Format überführt ist, zählt ein Monatsdiagramm den März doppelt oder lässt ihn weg.
Was das Protokoll und der Datenschutzschnitt absichern
Das Bereinigungsprotokoll ist eine kurze Tabelle: Spalte, Regel, geänderte Zeilen, Person, Datum. Wenn die Finanzabteilung fragt, warum der letzte März geschrumpft ist, zeigen Sie auf die Duplikatregel, statt die Datei aus dem Gedächtnis nachzubauen.
Bevor die Datei eine Analyseplattform erreicht, entfernen Sie Kundennamen, E-Mail-Adressen und Zahlungsdaten. Für eine Absatzprognose brauchen Sie sie nicht, und wenn sie im Extrakt bleiben, entsteht ein Datenschutzproblem, das sich mit einem Modell nicht mehr beheben lässt.
Wenn Sie eine zweite Einschätzung dazu möchten, wie „gut“ bei kommerziellen Extrakten aussieht, sind die Erkenntnisse von Pipecorn zur Qualität von Vertriebsdaten eine nützliche Checkliste für Kennungen, Vollständigkeit und Konsistenz. Entscheiden Sie damit, welche Spalten behalten werden sollen, und kehren Sie dann zum oben beschriebenen Schnitt nach Quote fehlender Werte zurück.
Daten aufteilen, bevor irgendein Lernen stattfindet
Die Aufteilung ist ein Zaun. Nichts, was eine Statistik schätzt, gehört auf die vollständige Datei.
Für überwachte Textklassifikation empfiehlt Googles Leitfaden zur Textklassifikation, vor der Aufteilung zu mischen, weil die ursprüngliche Reihenfolge beide Datensätze verzerren kann. Nach dem Mischen kommen typischerweise 80 % der Beispiele ins Training und 20 % in die Validierung. Dieselben Transformationen gelten dann für beide Sätze, aber erst, nachdem sie auf den Trainingszeilen gelernt wurden.
Warum eine sortierte Verkaufsdatei lügt
Exporte kommen oft nach Datum, Region oder Kunde sortiert an. Teilen Sie eine solche Datei von oben nach unten auf, trainieren Sie mit 2023 und validieren mit dem Spätjahr 2024. Der Wert folgt dann dem Kalender, einem Aktionskalender oder dem Mix einer einzelnen Region. Er sagt nichts darüber aus, ob das Modell die Bestellungen verstanden hat.
Mischen Sie, wenn jede Zeile ein unabhängiger Fall ist: eine abgeschlossene Bestellung, ein abgewanderter Kunde, ein klassifiziertes Ticket. Mischen Sie nicht, wenn die Frage eine Prognose ist.
Behalten Sie für Prognosen die zeitliche Reihenfolge bei. Trainieren Sie mit früheren Monaten und testen Sie mit späteren. Ein Mischen würde das Modell die Zukunft sehen lassen und das als Können ausgeben.
Textfelder brauchen einen Häufigkeitsschnitt
Support-Tickets und Produktbeschreibungen ergeben tausende Tokens. Im selben Google-Verfahren verwerfen Sie Tokens, die weniger als zweimal vorkommen, behalten die 20.000 wichtigsten Token-Merkmale und ordnen den Rest mit einem auf dem F-Test basierenden Wichtigkeitswert. Ein Token, das nur einmal auftaucht, ist meist ein Tippfehler oder eine einmalige Artikelnummer, kein Muster, das eine Spalte wert wäre.
Passen Sie nach der Aufteilung jede Zuordnung nur auf den Trainingsdaten an und wenden Sie diese festgelegte Zuordnung dann auf die Validierung an. Ein Vokabular oder eine Kategorienliste auf den zurückgehaltenen Zeilen neu zu berechnen, ist eine weitere Möglichkeit, die Antwort in die Aufbereitung durchsickern zu lassen.
Fehlende Werte auffüllen, ohne Ergebnisse zu verzerren
Wie oft ein Feld leer ist und ob die Entscheidung dieses Feld braucht, bestimmt die Maßnahme. Die folgenden Bereiche sind eine praktische Faustregel, kein Gesetz. Ein regulatorisches Risikomodell darf womöglich Zeilen nicht verwerfen, die eine Handelsprognose entbehren kann.
Anteil fehlender Werte | Wichtigkeit des Merkmals | Maßnahme |
|---|---|---|
Unter 5 % | Beliebig | Diese Zeilen entfernen, sofern genug Daten übrig bleiben |
5 % bis 30 % | Niedrig | Merkmal entfernen |
5 % bis 30 % | Hoch | Nur anhand der Trainingszeilen imputieren |
Über 30 % | Hoch | Imputieren, eine Spalte als Kennzeichen für fehlende Werte ergänzen und untersuchen, warum das Feld leer ist |
Über 30 % | Niedrig | Merkmal entfernen |
Eine Handvoll leerer Kostenfelder in einer sonst vollständigen Bestelldatei entspricht der ersten Zeile. Diese Zeilen zu löschen schadet weniger, als einen Preis zu erfinden. Ein selten genutztes Umfragefeld im mittleren Bereich ist keine ausgefüllte Vermutung wert, also fällt die Spalte weg. Die Kundenbindungsdauer, die Sie für die Abwanderungsanalyse nutzen, bleibt, und Sie schätzen sie.
Googles Leitfaden zur Datenaufbereitung für Clustering nennt drei praktische Optionen: Beispiele mit fehlenden Werten entfernen, das Merkmal entfernen oder die fehlenden Werte aus anderen Daten vorhersagen. Seltene Lücken können das Löschen von Zeilen rechtfertigen. Häufige Lücken bedeuten meist, dass Sie das Merkmal entfernen oder imputieren.
Die Lücke vorhersagen, statt eine Konstante einzusetzen
Trainieren Sie bei einem numerischen Feld eine Regression auf den Zeilen, in denen der Wert vorhanden ist, und schätzen Sie dann die leeren Werte. Ein fehlendes Kundenalter lässt sich zum Beispiel aus Einkommen und Kundenbindungsdauer schätzen, statt es durch einen einzigen unternehmensweiten Durchschnitt zu ersetzen. So nutzen Sie Zusammenhänge, denen Sie bereits vertrauen.
Der Bestellwert ist schief verteilt. Einige große Großhandelsbestellungen ziehen den Mittelwert nach oben, sodass eine Auffüllung mit dem Mittelwert gewöhnliche Warenkörbe wohlhabender aussehen lässt, als sie sind. Der Median liegt bei der typischen Bestellung und verschiebt sich weniger, wenn eine Großrechnung eingeht. Vergleichen Sie die Kennzahlen vor und nach dem Auffüllen. Eine große Verschiebung zeigt, dass die Methode das Geschäft umschreibt, statt eine Lücke zu schließen.
Bei Kategorien kennzeichnen Sie das leere Feld als Unknown. Die Lücke ist oft das Signal: ein Checkout, der die Region nie erfasst hat, oder ein Produkt ohne Lieferantennummer. Wird daraus eine echte Ausprägung, bleibt die Zeile erhalten, und das Modell erfährt, dass das Feld bewusst leer war.
Häufige Lücken sind im operativen Geschäft keine Seltenheit. Eine Studie von 2025 zu unvollständigen Wasserverbrauchsdaten beschreibt einen Gebäudedatensatz mit 33.888 stündlichen Messwerten von Februar 2019 bis Dezember 2023, bei dem in 20 % der Stunden Werte fehlen. Das liegt in dem Bereich, in dem das pauschale Löschen von Zeilen zu viel Historie verwerfen würde (die Studie).
Passen Sie den Imputer nur an den Trainingszeilen an. Im ELECTE-Leitfaden zu fehlenden Daten finden Sie die Imputationsverfahren ausführlicher erklärt, falls Sie die Methode noch einmal prüfen möchten, nicht die Reihenfolge.
Kategorien kodieren und nützliche Merkmale entwickeln
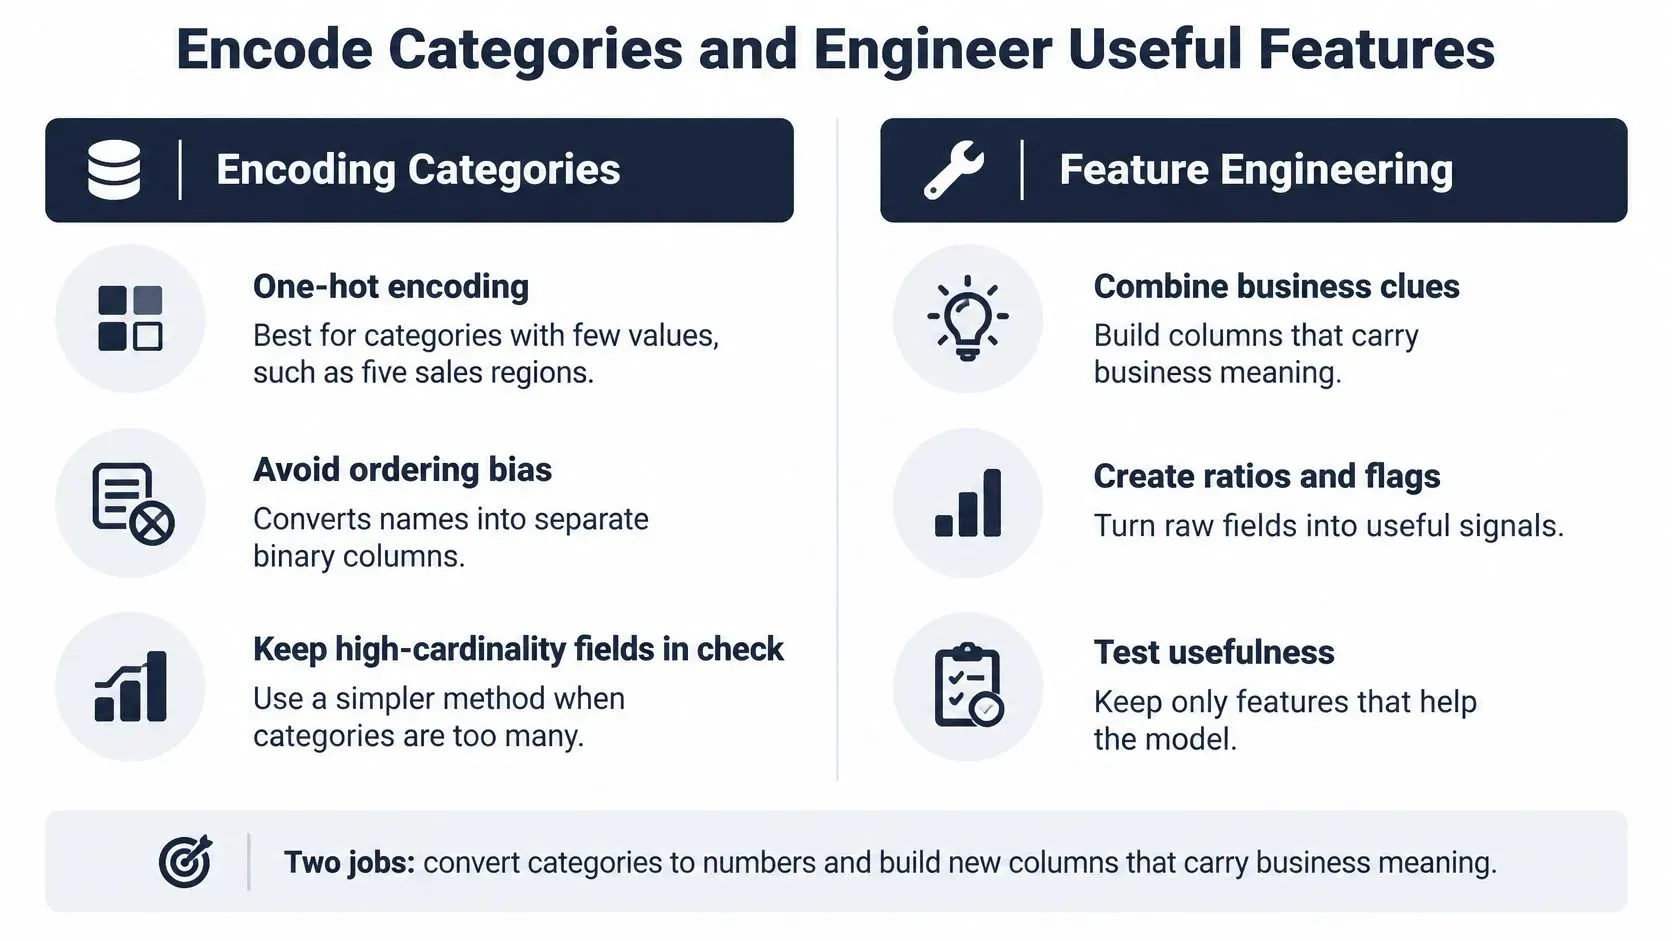
Hier gibt es zwei Aufgaben. Wandeln Sie Labels in Zahlen um, die das Modell nutzen kann, und bauen Sie Spalten, die eine Geschäftsfrage beantworten, die die Rohfelder nicht beantworten.
Kodieren ohne falsche Rangfolge
One-Hot-Kodierung eignet sich für Kategorien mit wenigen Werten, etwa fünf Vertriebsregionen. Jede Region wird zu einer eigenen Ja-Nein-Spalte, und keine Region ist „größer“ als eine andere.
Ordinale Kodierung passt zu einer echten Reihenfolge, etwa den Größen S, M und L. Die Zahlen entsprechen einer Rangfolge, die das Unternehmen bereits verwendet.
Weisen Sie ungeordneten Namen wie Kanal oder Stadt nicht 1, 2, 3 zu. Das Modell behandelt einen höheren Code als „mehr“ von etwas. Diese falsche Rangfolge zeigt sich später als selbstsicherer, aber falscher Koeffizient. Hat ein Feld Hunderte von Ausprägungen, erzeugt One-Hot eine sehr breite Tabelle. Fassen Sie seltene Ausprägungen vor dem Kodieren unter Other zusammen und lernen Sie diese Gruppierung nur anhand der Trainingszeilen.
Spalten, die eine Geschäftsfrage beantworten
Erstellen Sie eine kurze Liste, die an eine Entscheidung gebunden ist, statt jede Kennzahl zu bilden, die Ihnen einfällt.
- Margenprozentsatz:
(price − cost) / pricezeigt, ob eine Aktion die Kosten noch deckt – das kann der Umsatz allein nicht. - Tage seit dem letzten Kauf: Eine Abwanderungsanalyse braucht die Aktualität des Kaufs, nicht noch eine Kopie der Kunden-ID.
- Wochentag und Monat: Die Bedarfsplanung interessiert sich für Freitagsspitzen und saisonale Monate, die in einem vollständigen Zeitstempel verborgen sind.
- Gleitender 7-Tage-Durchschnitt: Die täglichen Stückzahlen schwanken stark. Ein Wochendurchschnitt zeigt, ob die Nachfrage steigt.
- Verhältnis von Lagerbestand zu Absatz: Ein Bestandsmanager erkennt einen entstehenden Engpass früher, als es der reine Lagerbestand erlaubt.
Ich würde mit zehn bis fünfzehn Features beginnen, die an diese eine Entscheidung gekoppelt sind. Streichen Sie eine Spalte aus einem Paar, wenn die Korrelation über 0,95 liegt, denn die zweite Spalte wiederholt die erste. Notieren Sie die geschäftliche Bedeutung neben dem Spaltennamen im Datenwörterbuch. Wenn eine Kodierungstabelle oder ein gleitender Durchschnitt auf der gesamten Datei gelernt wird, einschließlich der Zeilen, die Sie zurückhalten wollten, entsteht dasselbe Leck, das Sie bei der Aufteilung bereits verhindert haben.
Zahlen skalieren und Ausreißer in den Griff bekommen
Ein Extremwert ist nicht automatisch ein Fehler. Eine Bestellung über 40 Einheiten von einem B2B-Kunden ist ein echter Verkauf. Markieren Sie sie, damit sie einen Mittelwert nicht dominiert, und lassen Sie sie in der Historie. Ein Stückpreis von 100.000, der statt 1.000 eingetippt wurde, ist ein Eingabefehler. Korrigieren Sie die Ziffer und behandeln Sie ihn nicht als „Nachfrage“.
Prüfen Sie den Extremwert, bevor Sie ihn löschen
Zwei Prüfungen ergänzen sich gut. Die 1,5-fache Interquartilsabstand-Regel markiert Punkte, die weit von der Mitte der Spalte entfernt liegen. Eine fachliche Prüfung fragt, ob der Wert überhaupt existieren kann: negativer Lagerbestand, ein Datum im nächsten Jahrzehnt, ein Rabatt über dem Verkaufspreis. Prüfen Sie zuerst. Kappen Sie dann am 1. und 99. Perzentil, wenden Sie eine Log-Transformation auf schief verteilte Umsätze an oder fügen Sie ein Flag hinzu und behalten Sie den Rohwert für das Reporting.
Eine Großbestellung, die Sie löschen, ist Umsatz, den Sie nie wieder prognostizieren werden. Ein Tippfehler, den Sie behalten, wird zu einem Preis, von dem das Modell glaubt, dass Kunden ihn zahlen.
Führen Sie die Zusammenfassung nach dem Kappen erneut aus. Das Zentrum der Spalte sollte sich kaum verschieben. Springt der Median, leistet die Kappung zu viel und Sie sollten sich die Quellzeilen noch einmal ansehen.
Welcher Scaler zum Profil passt
Skalierung verhindert, dass eine Spalte in großen Einheiten, etwa der Jahresumsatz, eine Spalte in kleinen Einheiten, etwa Stück pro Bestellung, erdrückt. In der Preprocessing-Dokumentation von Scikit-learn steht, dass StandardScaler jedes Feature am Mittelwert des Trainingssatzes zentriert und nach der Varianz skaliert und dass dies bei vielen Ausreißern schlecht funktionieren kann. RobustScaler ist der direkte Ersatz, der robustere Schätzer für Zentrum und Streuung verwendet.
Datenprofil | Scaler | Warum er passt |
|---|---|---|
Annähernd symmetrisch, wenige Extremwerte | StandardScaler | Zentriert am Mittelwert und skaliert nach der Varianz |
Starke Ausreißer, etwa gelegentliche Großbestellungen | RobustScaler | Nutzt Median und Interquartilsabstand, die gegenüber Extremwerten robust sind |
Werte brauchen einen festen Bereich, etwa Bewertungen von 1 bis 5 | MinMaxScaler | Bildet Werte auf 0–1 ab, ohne ihre Verteilungsform zu verändern |
Passen Sie den Scaler nur auf den Trainingsdaten an (Fit) und wenden Sie diese Anpassung dann auf die Validierungsdaten an. Wenn Sie ihn auf der zurückgehaltenen Menge neu anpassen, bestimmen extreme Validierungszeilen die Skalierung mit. Wie Sie Extremwerte erkennen, bevor Sie sich für eine Behandlung entscheiden, lesen Sie im ELECTE-Leitfaden zu Ausreißern.
Die Pipeline automatisieren und ihre Ergebnisse prüfen
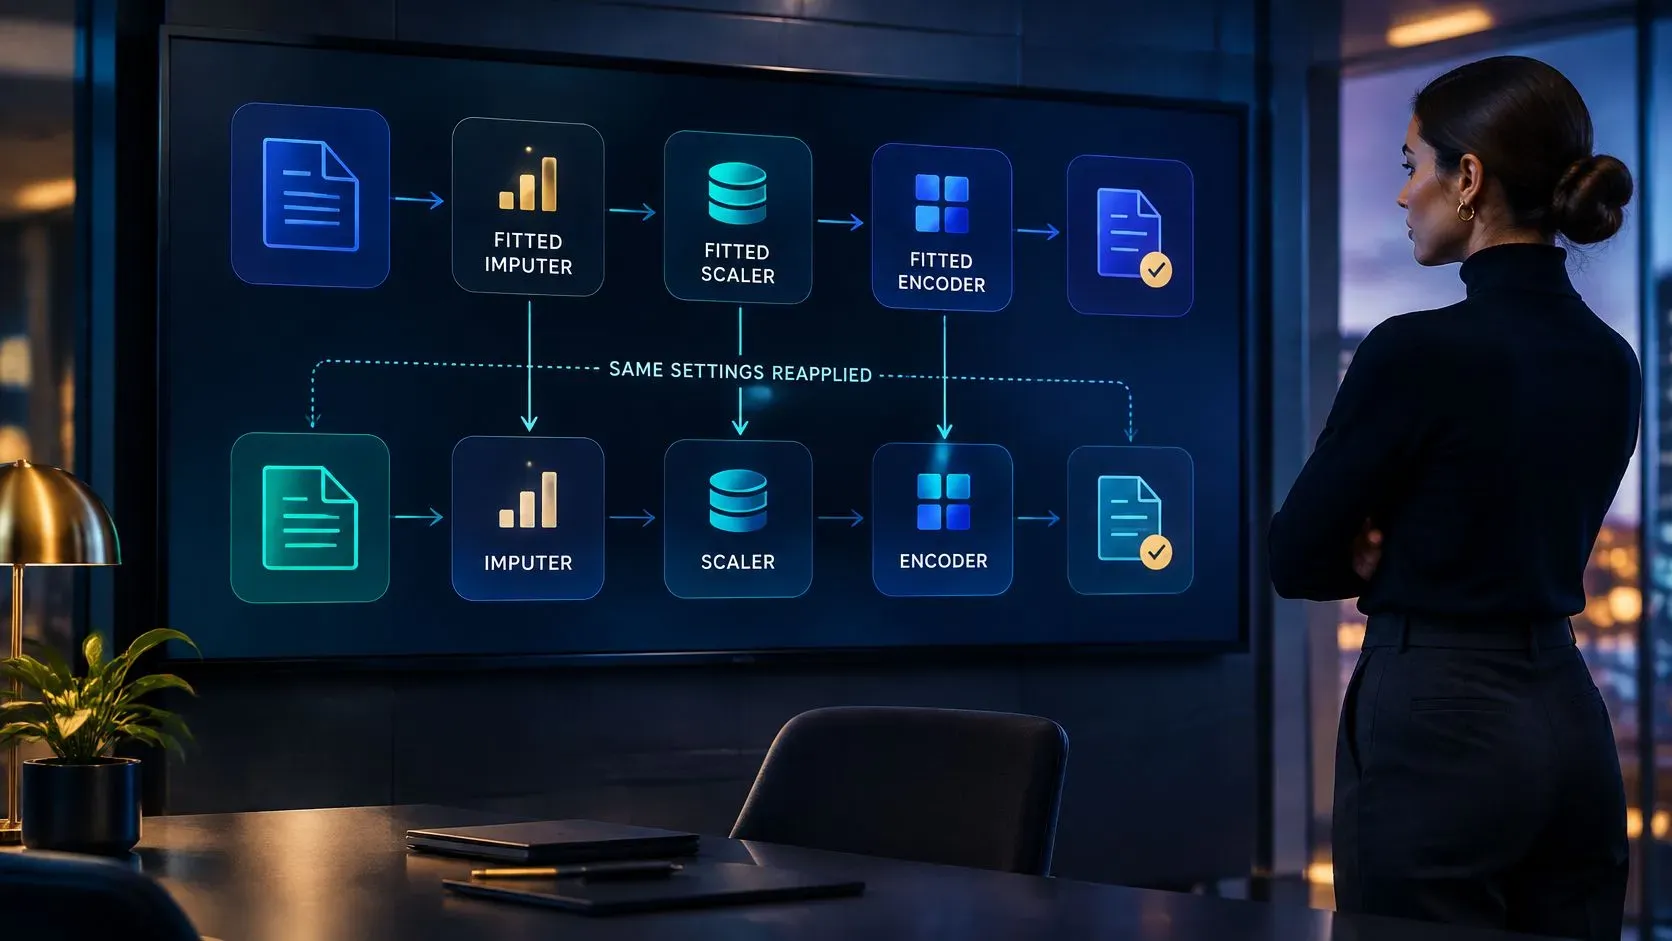
Eine bereinigte Datei, die in einem einzelnen Notebook liegt, kann zwischen den Läufen abdriften. Eine neue Datei bekommt womöglich einen anderen Imputationswert, eine andere Kategorienkodierung oder eine andere Skalierung, sodass sich ein Dashboard verändert, obwohl sich das zugrunde liegende Geschäft nicht verändert hat.
Eine Pipeline hält den angepassten Imputer, Encoder und Scaler zusammen und wendet dieselben Transformationen auf neue Dateien an. Passen Sie diese Schritte nur auf der Trainingspartition an. Wenden Sie die angepassten Einstellungen auf Validierungs- und Testdaten an, ohne sie neu zu berechnen. Der Hinweis von IBM zu Data Leakage erklärt, warum das Anpassen von Vorverarbeitungsschritten über Trainings- und Testdaten hinweg Informationen in die Auswertung einfließen lassen kann.
Prüfungen nach jedem Lauf
Ein erfolgreicher Job bestätigt nur, dass der Prozess gelaufen ist. Prüfen Sie, ob die Ausgabe weiterhin zur Quelle und zu den von Ihnen festgelegten Regeln passt:
- Zeilenanzahl: Gleichen Sie die geladene Datei mit dem Export ab und berücksichtigen Sie dabei protokollierte Duplikate.
- Null-Quote je Spalte: Prüfen Sie einen plötzlichen Anstieg – er kann bedeuten, dass ein Quellfeld nicht mehr geliefert wird.
- Wertebereiche: Stellen Sie sicher, dass Preise, Mengen und Datumsangaben innerhalb der zulässigen Grenzen bleiben.
- Neue Kategorien: Leiten Sie eine bisher unbekannte Region oder SKU in einen definierten Sammelbereich um, statt sie unbemerkt zu verwerfen.
Für praktische Beispiele zur Datenvalidierung sehen Sie sich an, wie diese Prüfungen auf Geschäftsdateien angewendet werden. Behandeln Sie automatisierte Ergebnisse als Schätzwerte und prüfen Sie die ersten Zyklen manuell, bevor Sie damit Warnmeldungen auslösen.
ELECTE, eine KI-gestützte Datenanalyse-Plattform für wachsende Unternehmen, verbindet sich mit Ihrer Buchhaltungssoftware oder einer hochgeladenen Datei und führt Datenanalysen und Prognosen durch, ohne dass ein Analyst nötig ist. Kunden sparen durch die Automatisierung der Finanzanalyse mehr als 10 Stunden pro Woche. Diese Entlastung setzt voraus, dass Sie angepasste Schritte verwenden, die Sie in einem Review begründen können, statt sie bei jedem Upload neu zu berechnen.
Nehmen Sie sich diese Woche einen Datensatz vor, gehen Sie ihn anhand der Tabelle mit den sieben Zeilen durch und markieren Sie, welche Schritte noch manuell erfolgen. Automatisieren Sie einen wiederkehrenden Schritt, aber behalten Sie Ermessensentscheidungen – etwa Duplikat oder echte Nachbestellung, Tippfehler oder Großbestellung – unter Prüfung, bis die Regeln stabil sind.
ELECTE verbindet Ihre Buchhaltungsdaten oder einen Datei-Upload, bereitet die Daten auf und macht daraus Prognosen und Berichte, die Sie gemeinsam mit Ihrem Team prüfen können. Wenn Sie diese Schritte der Datenvorverarbeitung bei jedem Laden gleich anwenden möchten, besuchen Sie ELECTE und sehen Sie, wie die Plattform den gesamten Ablauf mit Ihren eigenen Zahlen ausführt.
Kommentare
Noch keine Kommentare — starten Sie die Diskussion.