ขั้นตอนการเตรียมข้อมูลเบื้องต้น: วิธีทำความสะอาดข้อมูลทางธุรกิจ
เรียนรู้ขั้นตอนการเตรียมข้อมูลที่เปลี่ยนบันทึกทางธุรกิจที่ยุ่งเหยิงให้เป็นข้อมูลเชิงลึกที่เชื่อถือได้ พร้อมตัวอย่างสำหรับ SME และดูว่า ELECTE ทำขั้นตอนเหล่านี้โดยอัตโนมัติได้อย่างไร
คุณดึงไฟล์ส่งออกยอดขายที่ดูเรียบร้อยครบถ้วน มีทั้งคำสั่งซื้อ ต้นทุน และวันที่อยู่เต็มชีต จากนั้นรายงานพยากรณ์ก็ไปถึงโต๊ะหัวหน้าฝ่ายการเงิน และมูลค่าคำสั่งซื้อเฉลี่ยกลับพุ่งสูงขึ้น ทั้งที่แคตตาล็อกสินค้าไม่ได้เปลี่ยนแปลงเลย
การพุ่งขึ้นแบบนั้นมักเกิดจากข้อผิดพลาดในการเตรียมข้อมูล ไม่ใช่พฤติกรรมการซื้อที่เปลี่ยนไป หากเติมราคาที่ว่างทั้งที่ไฟล์ยังมีใบแจ้งหนี้ซ้ำอยู่ หรือปรับสเกลข้อมูลทั้งชุดก่อนที่จะแยกแถวบางส่วนออกไว้ ก็เท่ากับสอนโมเดลด้วยข้อเท็จจริงที่มันยังไม่ควรเห็น บทความส่วนใหญ่แสดงขั้นตอนการเตรียมข้อมูลเป็นเทคนิคแยกกันที่จะทำลำดับใดก็ได้ แต่ลำดับนี่เองคือสิ่งที่ทำให้ผลลัพธ์สูงเกินจริง
ต่อไปนี้คือลำดับที่ผมแนะนำเมื่อนักวิเคราะห์ดูแลไฟล์ธุรกิจที่ใช้งานจริง คุณจะได้ลำดับการทำงาน เกณฑ์ที่ผมถือเป็นจุดเริ่มต้นมากกว่ากฎตายตัว และวิธีล็อกค่าที่ปรับจากข้อมูลแต่ละอย่าง เพื่อให้การโหลดข้อมูลครั้งต่อไปใช้เส้นทางเดียวกัน
ขั้นตอนการเตรียมข้อมูล 7 ขั้นตามลำดับที่ถูกต้อง
ไฟล์ส่งออกยอดขายอาจดูครบถ้วน แต่ยังซ่อนแถวใบแจ้งหนี้ซ้ำ ต้นทุนต่อหน่วยที่ว่าง และวันที่ที่เก็บเป็นสองรูปแบบ หากแก้ปัญหาเหล่านี้ผิดลำดับ ค่าเฉลี่ยทุกตัวในขั้นถัดไปก็จะรับปัญหานั้นไปด้วย
ทุกขั้นตอนที่เรียนรู้ค่าตัวเลขจากข้อมูลต้องทำหลังจากแยกชุดข้อมูลแล้ว ค่าเฉลี่ย ค่ามัธยฐาน หรือช่วงการปรับสเกลที่คำนวณจากไฟล์ทั้งชุดจะทำให้แถวข้อมูลสำหรับตรวจสอบเข้าไปมีอิทธิพลต่อชุดฝึกสอน คะแนนที่ได้จึงดูดีกว่าที่โมเดลจะทำได้จริงกับคำสั่งซื้อเดือนหน้า
ขั้นตอน | สิ่งที่ต้องทำ | ถือว่าเสร็จเมื่อ |
|---|---|---|
1. ตรวจสอบและทำความสะอาด | ตรวจจำนวนแถว ชนิดข้อมูล และอัตราค่าว่าง ลบข้อมูลที่ซ้ำกันทุกประการ และปรับรูปแบบวันที่และป้ายกำกับให้เป็นมาตรฐาน | ได้ตารางฐานที่สะอาด โดยแต่ละหมวดหมู่มีป้ายกำกับเดียว |
2. แบ่งข้อมูล | สุ่มสลับลำดับแถว แล้วแบ่งเป็นชุดฝึกสอนและชุดตรวจสอบ | มีข้อมูลสองชุดแล้ว และยังไม่มีการคำนวณค่าตั้งที่เรียนรู้จากข้อมูล |
3. จัดการค่าที่หายไป | ลบแถว ลบฟีเจอร์ หรือเติมค่าโดยใช้เฉพาะข้อมูลชุดฝึกสอน | ทุกช่องข้อมูลครบถ้วน หรือมีการทำเครื่องหมายช่องที่ยังว่าง |
4. เข้ารหัสและสร้างฟีเจอร์ | แปลงหมวดหมู่เป็นตัวเลข สร้างอัตราส่วน ส่วนประกอบของเวลา และค่าเฉลี่ยเคลื่อนที่ | ได้ตารางฟีเจอร์ที่พร้อมใช้กับโมเดล พร้อมเอกสารอธิบายแต่ละคอลัมน์ |
5. จัดการค่าผิดปกติ | ตรวจสอบค่าที่สูงหรือต่ำผิดปกติ แล้วจำกัดค่า แปลงค่า หรือทำเครื่องหมายไว้ | ค่าที่ผิดปกติมีคำอธิบาย ไม่ใช่การคาดเดา |
6. ปรับสเกลฟีเจอร์ตัวเลข | ฟิตตัวปรับสเกลกับข้อมูลชุดฝึกสอน แล้วนำไปใช้กับข้อมูลชุดตรวจสอบ | คอลัมน์ตัวเลขอยู่ในช่วงที่เปรียบเทียบกันได้ |
7. ล็อกไปป์ไลน์ | บันทึกการแปลงข้อมูลที่ฟิตแล้วทุกขั้นตอน เพื่อให้ข้อมูลใหม่ผ่านกระบวนการเดียวกัน | ได้กระบวนการที่รันซ้ำได้ และใช้ได้กับข้อมูลที่โหลดเข้ามาใหม่ทุกครั้ง |
สมมติว่าร้านค้าปลีกแห่งหนึ่งมีรายการสั่งซื้อ 12,000 บรรทัด โดยมีแถวใบแจ้งหนี้ซ้ำ 900 แถว หากเติมค่าราคาที่หายไปก่อนลบแถวซ้ำเหล่านั้น ใบแจ้งหนี้เดียวกันจะถูกนับสองครั้ง และทำให้ค่าเฉลี่ยเบี่ยงออกจากราคาในรายการราคาจริง
กฎปฏิบัติ: ทำแถวที่คุณกำลังทำอยู่ให้เสร็จก่อน แล้วค่อยคำนวณสิ่งที่แถวถัดไปต้องใช้
ลองเทียบไฟล์ที่คุณเปิดอยู่กับเจ็ดแถวนั้น แถวแรกที่คุณยังทำไม่เสร็จคือแถวเดียวที่ควรแตะในวันนี้
ตรวจสอบโปรไฟล์และทำความสะอาดข้อมูลธุรกิจดิบ
การทำโปรไฟล์ข้อมูลคือขั้นตอนหนึ่งชั่วโมงที่ผู้จัดการทำเสร็จได้ก่อนที่ใครจะเปิดโมเดล เก็บไฟล์ดิบไว้โดยไม่แก้ไข และบันทึกทุกการเปลี่ยนแปลงลงในบันทึกการทำความสะอาด เพื่อให้หัวหน้าฝ่ายการเงินเห็นว่าทำไมยอดรวมจึงเปลี่ยน
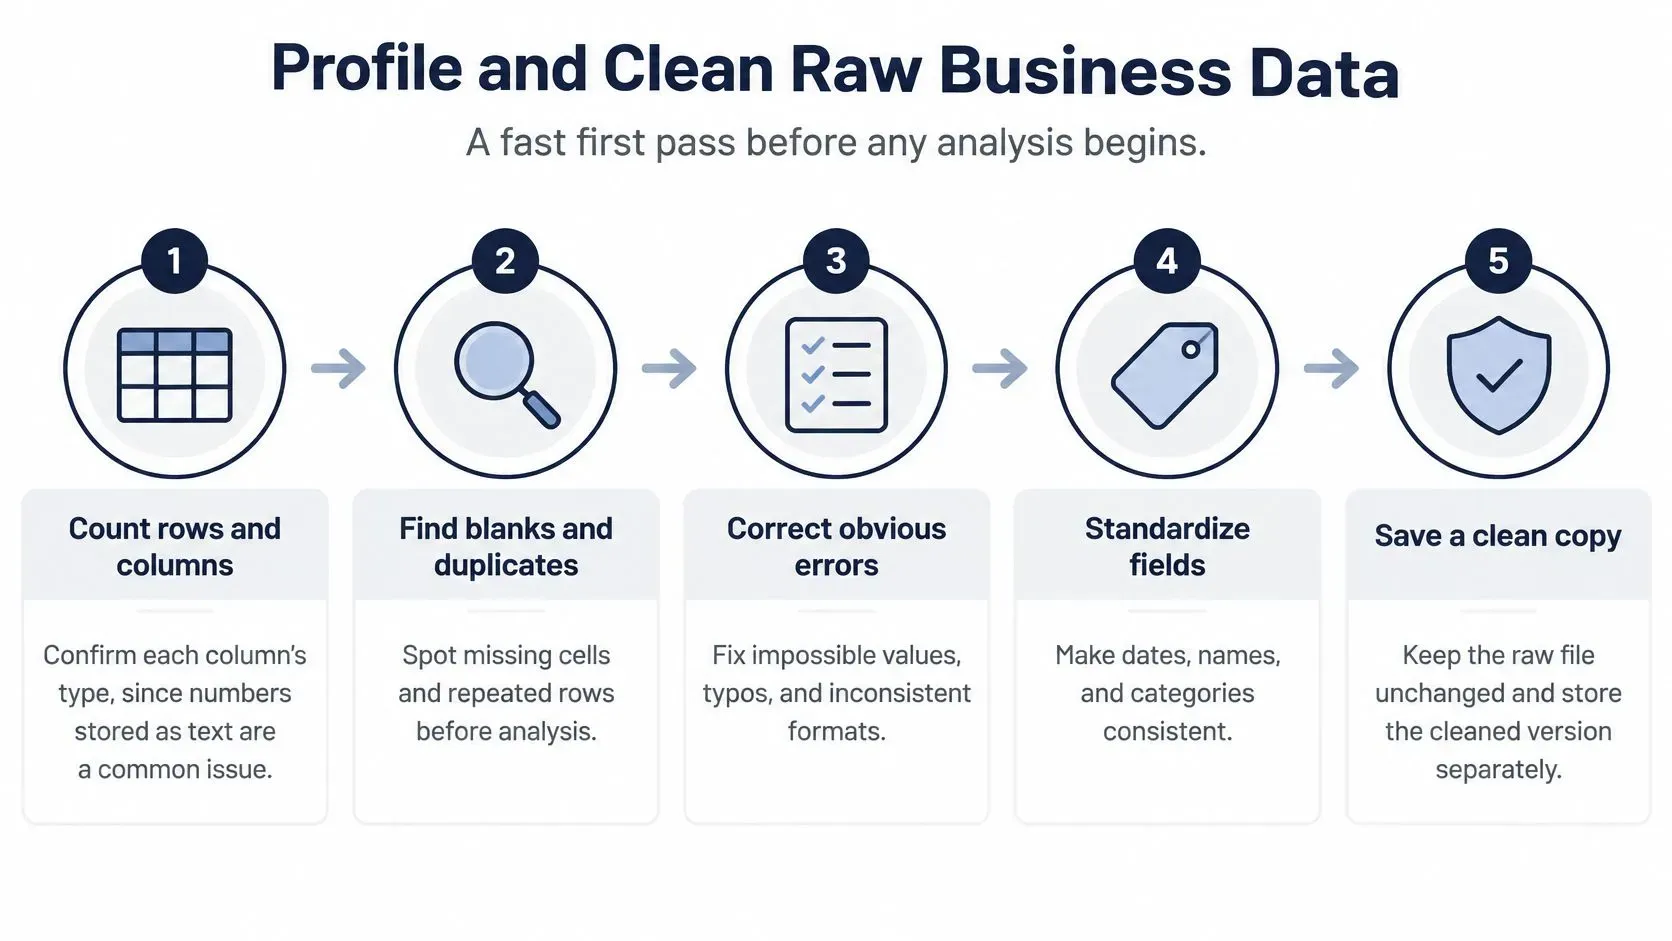
- นับจำนวนแถวและคอลัมน์ แล้วยืนยันชนิดข้อมูลของแต่ละคอลัมน์ ต้นทุนที่เก็บเป็นข้อความจะรวมยอดไม่ได้ และจะไม่แจ้งข้อผิดพลาดให้เห็นชัด ควรแปลงก่อนเชื่อถือยอดรวมใดๆ
- คำนวณอัตราค่าว่างของทุกคอลัมน์ คอลัมน์ที่ว่างเกิน 30% ให้ใช้กฎจัดการค่าที่หายไป ไม่ใช่เติมค่าแบบเร็วๆ ผมจะลบคอลัมน์ทิ้งทั้งหมดก็ต่อเมื่อค่าว่างเกิน 50% และฟิลด์นั้นไม่จำเป็นต่อการตัดสินใจ
- ลบเฉพาะแถวที่ซ้ำกันทุกประการ ไม่ใช่แถวที่แค่คล้ายกัน จับคู่จากเลขที่ใบแจ้งหนี้ วันที่ และจำนวนเงินพร้อมกัน คำสั่งซื้อที่สองซึ่งมีรหัสบรรทัดต่างกันคือยอดขายจริง การลบทิ้งเพียงเพราะลูกค้าและวันที่ตรงกันคือความพลาดที่ทำให้รายได้ต่ำกว่าความเป็นจริง
- ปรับรูปแบบให้เป็นมาตรฐานในรอบเดียว ใช้รูปแบบวันที่เดียว สกุลเงินเดียวต่อคอลัมน์ และไม่มีช่องว่างแปลกปลอมในรหัส รูปแบบที่ปะปนกันจะแยกสินค้าหนึ่งรายการออกเป็นสองชุดข้อมูล และทำให้การรวมตารางในภายหลังผิดพลาด
- ทำป้ายกำกับหมวดหมู่ให้เป็นมาตรฐาน
UK,U.K.และUnited Kingdomคือตลาดเดียวกัน สายผลิตภัณฑ์เดียวที่สะกดสี่แบบในไฟล์ส่งออกอีคอมเมิร์ซสามปีก็สร้างความเสียหายแบบเดียวกัน เลือกป้ายกำกับเดียวแล้วแมปที่เหลือเข้าด้วยกัน
สมมติว่าไฟล์ส่งออกนั้นเก็บวันที่สั่งซื้อเป็น 2024-03-01 ในปีหนึ่ง และเป็น 01/03/2024 ในอีกปีหนึ่ง จนกว่าทั้งสองจะเป็นรูปแบบเดียวกัน แผนภูมิรายเดือนจะนับเดือนมีนาคมซ้ำสองครั้งหรือตกหล่นไป
สิ่งที่บันทึกและการตัดข้อมูลส่วนบุคคลช่วยปกป้อง
บันทึกการทำความสะอาดคือตารางสั้นๆ ประกอบด้วย คอลัมน์ กฎ จำนวนแถวที่เปลี่ยน ผู้ดำเนินการ และวันที่ เมื่อฝ่ายการเงินถามว่าทำไมยอดเดือนมีนาคมที่ผ่านมาลดลง คุณชี้ไปที่กฎการลบแถวซ้ำได้ทันที แทนที่จะต้องไล่สร้างไฟล์ใหม่จากความจำ
ก่อนที่ไฟล์จะถึงแพลตฟอร์มวิเคราะห์ใดๆ ให้ตัดชื่อลูกค้า อีเมล และรายละเอียดการชำระเงินออก คุณไม่จำเป็นต้องใช้ข้อมูลเหล่านี้เพื่อพยากรณ์ความต้องการ และการปล่อยไว้ในไฟล์ที่ส่งออกจะสร้างปัญหาด้านความเป็นส่วนตัวที่โมเดลแก้ไขให้ไม่ได้
หากต้องการความเห็นเพิ่มเติมว่าข้อมูลที่ "ดี" สำหรับไฟล์ส่งออกเชิงพาณิชย์ควรเป็นอย่างไร ข้อมูลเชิงลึกด้านคุณภาพข้อมูลการขายจาก Pipecorn เป็นเช็กลิสต์ที่มีประโยชน์เรื่องตัวระบุ ความครบถ้วน และความสอดคล้อง ใช้เพื่อตัดสินใจว่าควรเก็บคอลัมน์ใด แล้วกลับมาที่เกณฑ์อัตราค่าว่างข้างต้น
แบ่งข้อมูลก่อนเริ่มการเรียนรู้ใดๆ
การแบ่งข้อมูลเปรียบเหมือนรั้วกั้น สิ่งใดที่ใช้ประมาณค่าสถิติไม่ควรทำบนไฟล์ทั้งหมด
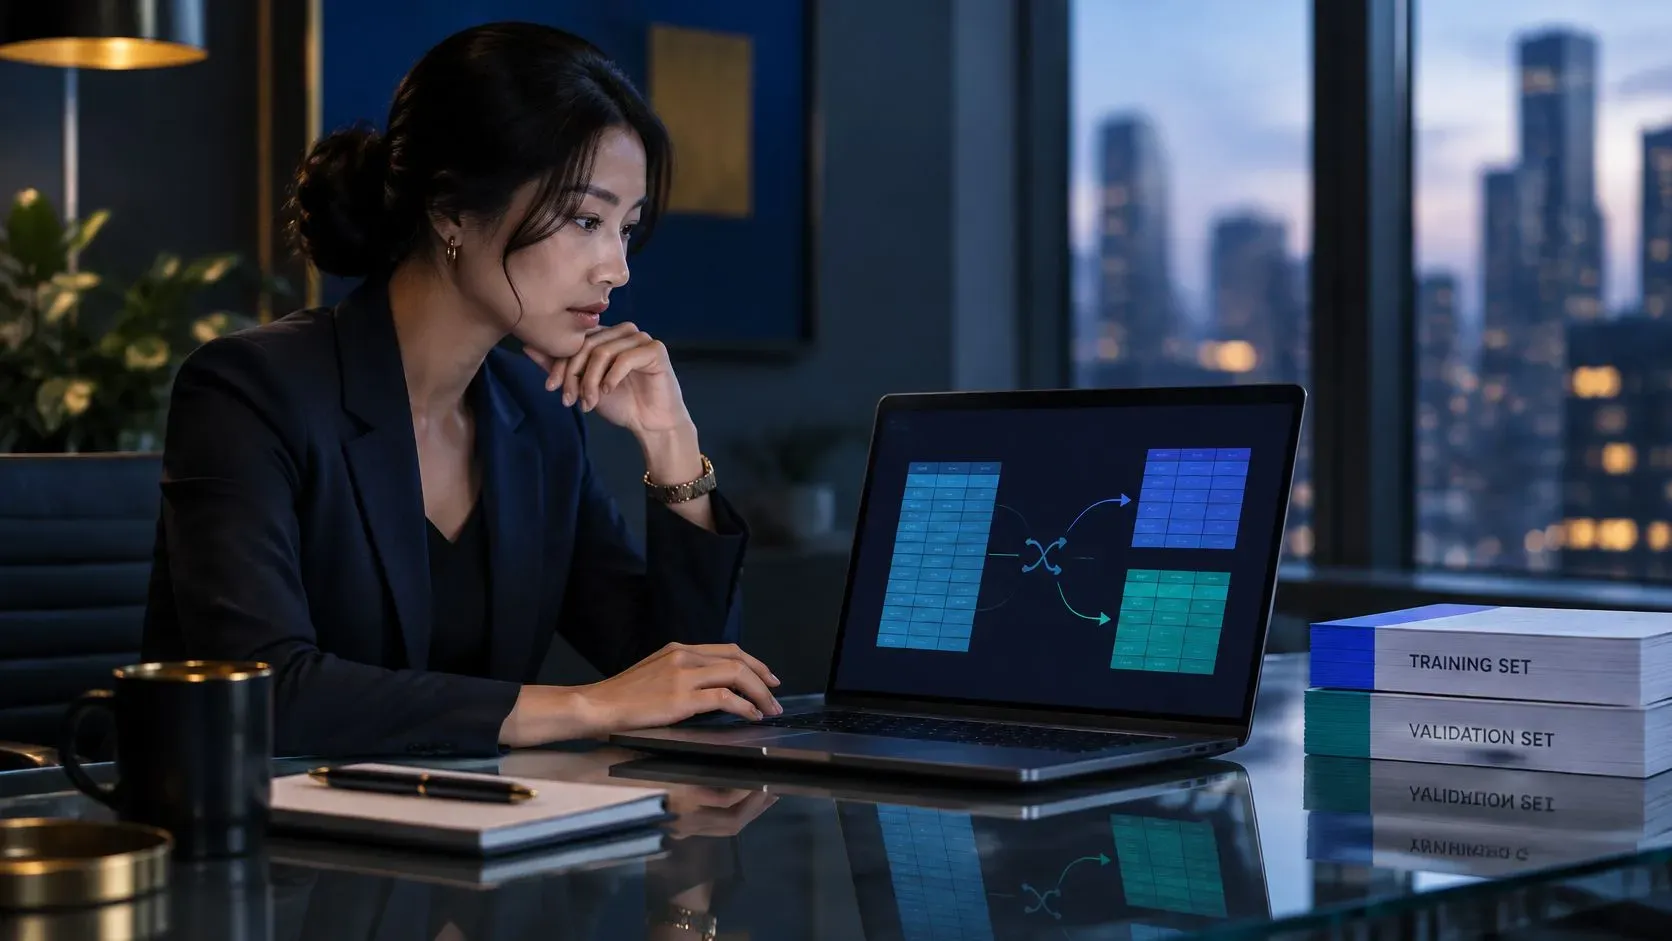
สำหรับการจำแนกข้อความแบบมีผู้สอน (supervised text classification) คู่มือการจำแนกข้อความของ Google แนะนำให้สับลำดับข้อมูลก่อนแบ่งชุด เพราะการคงลำดับเดิมไว้อาจทำให้ทั้งสองชุดเอนเอียง หลังสับลำดับแล้ว สัดส่วนการแบ่งโดยทั่วไปคือนำตัวอย่าง 80% ไปฝึกโมเดล และ 20% ไปตรวจสอบ (validation) จากนั้นจึงใช้การแปลงข้อมูลชุดเดียวกันกับทั้งสองชุด แต่ต้องเรียนรู้การแปลงนั้นจากแถวข้อมูลฝึกเท่านั้น
ทำไมไฟล์ยอดขายที่เรียงลำดับไว้จึงให้ผลที่ผิดเพี้ยน
ไฟล์ที่ส่งออกมามักเรียงตามวันที่ ภูมิภาค หรือลูกค้า ถ้าแบ่งไฟล์นั้นจากบนลงล่าง คุณจะฝึกโมเดลด้วยข้อมูลปี 2023 แล้วตรวจสอบด้วยข้อมูลช่วงปลายปี 2024 คะแนนที่ได้จึงสะท้อนปฏิทิน ปฏิทินโปรโมชัน หรือสัดส่วนของภูมิภาคใดภูมิภาคหนึ่ง ไม่ได้บอกว่าโมเดลเข้าใจคำสั่งซื้อจริงหรือไม่
ให้สับลำดับเมื่อแต่ละแถวเป็นกรณีที่เป็นอิสระต่อกัน เช่น คำสั่งซื้อที่ปิดแล้ว บัญชีที่เลิกใช้งาน หรือตั๋วที่จำแนกแล้ว แต่ไม่ต้องสับลำดับเมื่อโจทย์คือการพยากรณ์
ให้คงลำดับเวลาไว้เมื่อพยากรณ์ ฝึกโมเดลด้วยเดือนก่อนหน้า และทดสอบด้วยเดือนถัดมา การสับลำดับจะทำให้โมเดลเห็นอนาคต แล้วนับว่าเป็นความสามารถ
ช่องข้อความต้องตัดตามความถี่
ตั๋วซัพพอร์ตและคำอธิบายสินค้าจะแตกออกเป็นโทเคนนับพัน ในขั้นตอนเดียวกันของ Google คุณจะตัดโทเคนที่ปรากฏน้อยกว่า สอง ครั้งทิ้ง เก็บฟีเจอร์โทเคนอันดับต้น ๆ 20,000 รายการ แล้วจัดอันดับส่วนที่เหลือด้วยคะแนนความสำคัญที่อิงการทดสอบ F โทเคนที่โผล่มาแค่ครั้งเดียวมักเป็นคำพิมพ์ผิดหรือ SKU ที่ใช้ครั้งเดียว ไม่ใช่รูปแบบที่คุ้มกับการมีหนึ่งคอลัมน์
หลังแบ่งชุดแล้ว ให้ฟิตการแมปทุกอย่างจากข้อมูลฝึกเท่านั้น แล้วนำการแมปที่ตรึงไว้นั้นไปใช้กับชุดตรวจสอบ การคำนวณคลังคำศัพท์หรือรายการหมวดหมู่ใหม่บนแถวที่กันไว้ เป็นอีกทางหนึ่งที่ทำให้คำตอบรั่วเข้าไปในขั้นตอนเตรียมข้อมูล
เติมค่าที่ขาดหายโดยไม่ทำให้ผลลัพธ์เบี้ยว
ช่องข้อมูลว่างบ่อยแค่ไหน และการตัดสินใจต้องใช้ช่องนั้นหรือไม่ เป็นตัวกำหนดว่าจะทำอย่างไร เกณฑ์ช่วงด้านล่างเป็นหลักปฏิบัติคร่าว ๆ ไม่ใช่กฎตายตัว โมเดลความเสี่ยงในธุรกิจที่มีการกำกับดูแลอาจไม่อนุญาตให้ตัดแถวที่การพยากรณ์ในงานค้าปลีกยอมเสียได้
สัดส่วนข้อมูลที่หายไป | ความสำคัญของฟีเจอร์ | การดำเนินการ |
|---|---|---|
ต่ำกว่า 5% | ทุกระดับ | ลบแถวเหล่านั้นออก หากยังมีข้อมูลเหลือเพียงพอ |
5% ถึง 30% | ต่ำ | ลบฟีเจอร์นั้นออก |
5% ถึง 30% | สูง | เติมค่าที่หายไปโดยใช้เฉพาะแถวข้อมูลชุดฝึกสอน |
มากกว่า 30% | สูง | เติมค่าที่หายไป เพิ่มคอลัมน์ระบุค่าว่าง และตรวจสอบว่าเหตุใดฟิลด์นี้จึงว่างเปล่า |
มากกว่า 30% | ต่ำ | ลบฟีเจอร์นั้นออก |
แถวแรกคือไฟล์คำสั่งซื้อที่ข้อมูลครบเกือบทั้งหมด แต่มีต้นทุนว่างอยู่เพียงไม่กี่รายการ การลบแถวเหล่านั้นเสียหายน้อยกว่าการแต่งราคาขึ้นมาเอง ส่วนฟิลด์แบบสำรวจที่แทบไม่ได้ใช้และมีข้อมูลอยู่ในช่วงกลาง ก็ไม่คุ้มที่จะเติมค่าเดา จึงตัดคอลัมน์นั้นทิ้ง ส่วนอายุการเป็นลูกค้า (tenure) ที่คุณใช้วิเคราะห์การเลิกใช้บริการ (churn) ให้เก็บไว้และประมาณค่าขึ้นมา
แนวทางการเตรียมข้อมูลสำหรับการทำคลัสเตอร์ของ Google ระบุทางเลือกเชิงปฏิบัติสามข้อ ได้แก่ ลบตัวอย่างที่มีค่าที่ขาดหาย ลบฟีเจอร์นั้น หรือทำนายค่าที่ขาดจากข้อมูลอื่น หากช่องว่างเกิดขึ้นน้อย การลบแถวอาจสมเหตุสมผล แต่ถ้าเกิดบ่อย มักต้องตัดฟีเจอร์ทิ้งหรือเติมค่า (impute)
ทำนายช่องว่าง แทนการแปะค่าคงที่
สำหรับฟิลด์ตัวเลข ให้เทรนโมเดลถดถอยจากแถวที่มีค่าอยู่ แล้วประมาณค่าช่องที่ว่าง เช่น อายุลูกค้าที่ขาดหายสามารถประมาณจากรายได้และอายุการเป็นลูกค้า แทนการใช้ค่าเฉลี่ยของทั้งบริษัทเพียงค่าเดียว วิธีนี้ใช้ความสัมพันธ์ที่คุณเชื่อถืออยู่แล้ว
มูลค่าคำสั่งซื้อมีการกระจายแบบเบ้ ใบสั่งซื้อขายส่งขนาดใหญ่ไม่กี่ใบดึงค่าเฉลี่ยให้สูงขึ้น การเติมด้วยค่าเฉลี่ยจึงทำให้ตะกร้าสินค้าทั่วไปดูมีมูลค่าสูงกว่าความเป็นจริง ส่วนค่ามัธยฐานอยู่ใกล้คำสั่งซื้อทั่วไปและขยับน้อยกว่าเมื่อมีใบแจ้งหนี้ขายส่งก้อนใหญ่เข้ามา ให้เปรียบเทียบสถิติสรุปก่อนและหลังการเติมค่า หากเปลี่ยนไปมาก แสดงว่าวิธีนั้นกำลังเขียนธุรกิจใหม่ ไม่ได้อุดช่องโหว่
สำหรับข้อมูลหมวดหมู่ ให้ระบุช่องว่างเป็น Unknown บ่อยครั้งช่องว่างนั้นเองคือสัญญาณ เช่น หน้าชำระเงินที่ไม่เคยเก็บข้อมูลภูมิภาค หรือสินค้าที่ไม่มีรหัสซัพพลายเออร์ การทำให้เป็นระดับข้อมูลจริงช่วยเก็บแถวไว้ และบอกโมเดลว่าฟิลด์นั้นว่างโดยมีเหตุผล
ช่องว่างที่เกิดบ่อยไม่ใช่เรื่องแปลกในงานปฏิบัติการ งานศึกษาปี 2025 เรื่องข้อมูลการใช้น้ำที่ไม่สมบูรณ์อธิบายชุดข้อมูลอาคารที่มีบันทึกรายชั่วโมง 33,888 รายการ ตั้งแต่กุมภาพันธ์ 2019 ถึงธันวาคม 2023 โดยมีค่าที่ขาดหายใน 20% ของชั่วโมง ซึ่งอยู่ในช่วงที่การลบแถวทั้งหมดจะทิ้งประวัติไปมากเกินไป (งานศึกษานี้)
ให้ฟิตตัวเติมค่า (imputer) จากแถวเทรนเท่านั้น คู่มือข้อมูลที่ขาดหายของ ELECTE อธิบายตัวเลือกการเติมค่าอย่างละเอียดยิ่งขึ้น หากต้องการทบทวนวิธีการอีกรอบ ไม่ใช่ลำดับขั้นตอน
เข้ารหัสหมวดหมู่และสร้างฟีเจอร์ที่เป็นประโยชน์
ขั้นตอนนี้มีสองงาน คือแปลงป้ายกำกับเป็นตัวเลขที่โมเดลใช้ได้ และสร้างคอลัมน์ที่ตอบคำถามทางธุรกิจซึ่งฟิลด์ดิบตอบไม่ได้
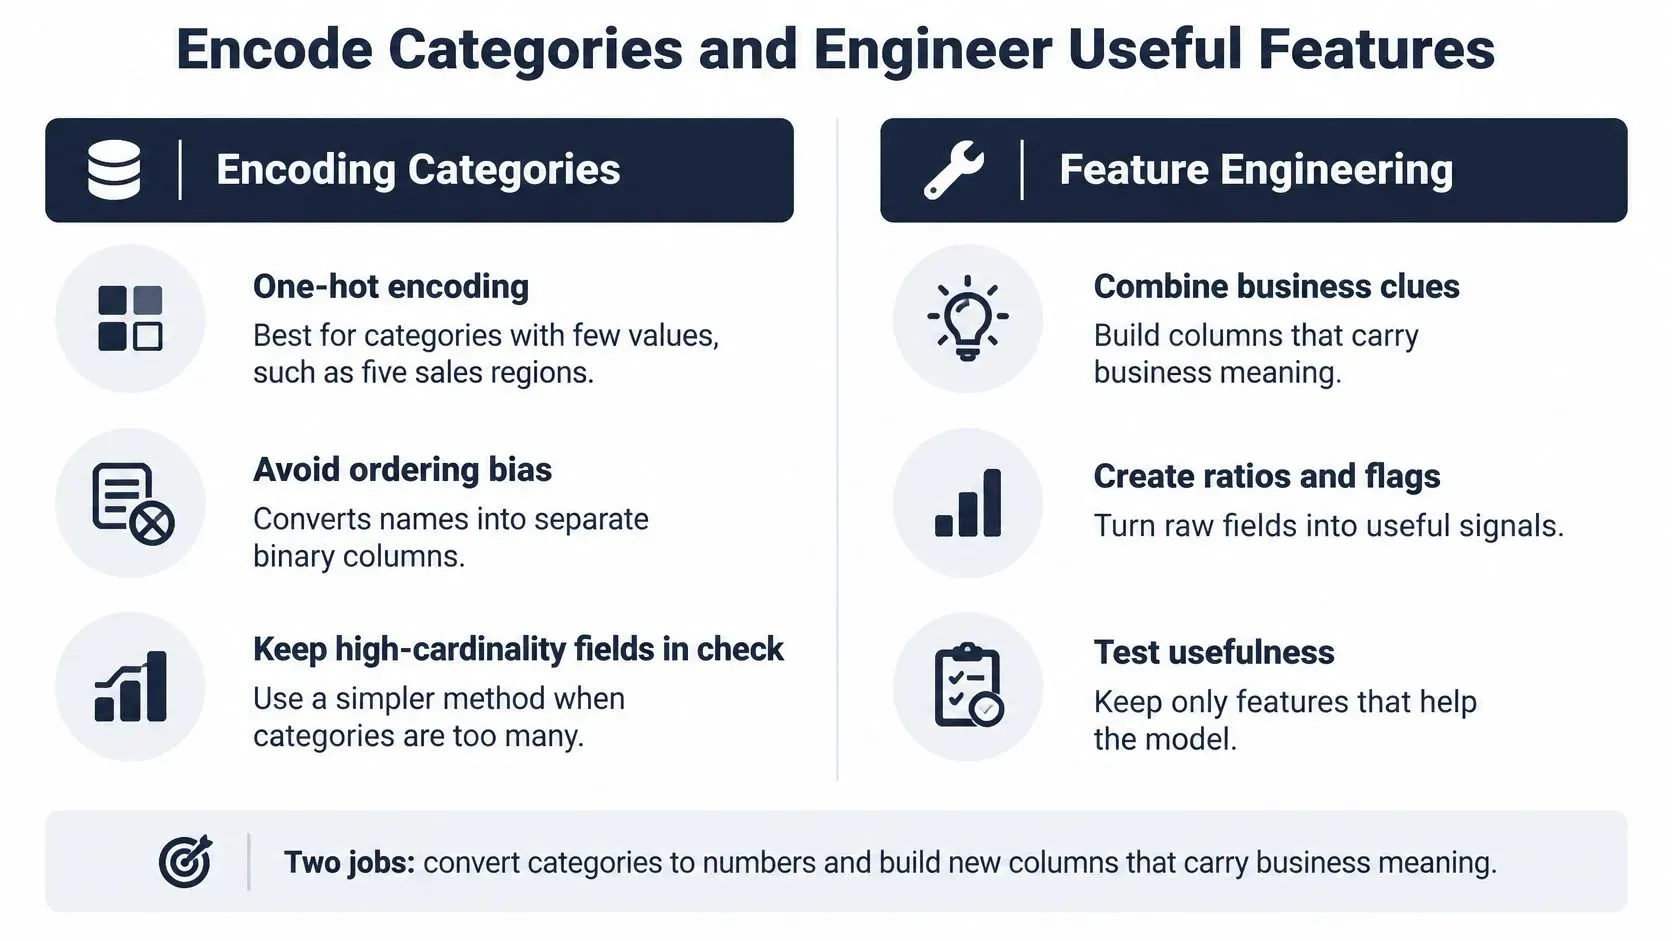
การเข้ารหัสโดยไม่สร้างลำดับปลอม
One-hot encoding เหมาะกับหมวดหมู่ที่มีค่าไม่มาก เช่น ห้าภูมิภาคการขาย แต่ละภูมิภาคจะกลายเป็นคอลัมน์ใช่/ไม่ใช่ของตัวเอง และไม่มีภูมิภาคใดที่ "ใหญ่กว่า" อีกภูมิภาค
Ordinal encoding เหมาะกับข้อมูลที่มีลำดับจริง เช่น ไซซ์ S, M และ L ตัวเลขจะตรงกับการจัดอันดับที่ธุรกิจใช้อยู่แล้ว
อย่ากำหนด 1, 2, 3 ให้ชื่อที่ไม่มีลำดับ เช่น ช่องทางขายหรือเมือง โมเดลจะมองว่ารหัสที่สูงกว่าคือมีบางสิ่งมากกว่า ลำดับปลอมนี้จะปรากฏภายหลังเป็นสัมประสิทธิ์ที่มั่นใจแต่ผิด เมื่อฟิลด์มีหลายร้อยระดับ one-hot จะสร้างตารางที่กว้างมาก ให้รวมระดับที่พบน้อยเป็น Other ก่อนเข้ารหัส และเรียนรู้การจัดกลุ่มนี้จากแถวเทรนเท่านั้น
คอลัมน์ที่ตอบคำถามทางธุรกิจ
สร้างรายการสั้นๆ ที่ผูกกับการตัดสินใจเดียว ไม่ใช่เทอัตราส่วนทุกแบบที่คิดออกมาใส่ไว้
- เปอร์เซ็นต์กำไรขั้นต้น:
(price − cost) / priceบอกได้ว่าโปรโมชันยังคุ้มต้นทุนหรือไม่ ซึ่งดูจากรายได้อย่างเดียวไม่ได้ - จำนวนวันนับจากการซื้อครั้งล่าสุด: การทบทวนลูกค้าที่หายไปต้องใช้ความใหม่ของการซื้อ ไม่ใช่รหัสลูกค้าซ้ำอีกชุด
- วันในสัปดาห์และเดือน: การวางแผนอุปสงค์ต้องดูยอดพุ่งวันศุกร์และเดือนตามฤดูกาลที่ซ่อนอยู่ในค่าเวลาแบบเต็ม
- ค่าเฉลี่ยเคลื่อนที่ 7 วัน: ยอดขายรายวันขึ้นลงไม่สม่ำเสมอ ค่าเฉลี่ยรายสัปดาห์จะบอกว่าอุปสงค์กำลังเพิ่มขึ้นหรือไม่
- อัตราส่วนสต็อกต่อยอดขาย: ผู้จัดการสินค้าคงคลังเห็นสัญญาณขาดสต็อกได้เร็วกว่าการดูจำนวนคงเหลือดิบ
ผมจะเริ่มจากฟีเจอร์สิบถึงสิบห้าตัวที่เชื่อมกับการตัดสินใจเดียวนั้น ตัดคอลัมน์หนึ่งออกเมื่อคู่คอลัมน์มีสหสัมพันธ์เกิน 0.95 เพราะคอลัมน์ที่สองซ้ำกับคอลัมน์แรก เขียนความหมายทางธุรกิจไว้ข้างชื่อคอลัมน์ในพจนานุกรมข้อมูล แผนที่การเข้ารหัสหรือค่าเฉลี่ยเคลื่อนที่ที่เรียนรู้จากไฟล์ทั้งหมด รวมถึงแถวที่ตั้งใจกันไว้เป็นชุดทดสอบ จะทำให้เกิดการรั่วไหลซ้ำกับที่คุณป้องกันไว้ตอนแบ่งข้อมูล
ปรับสเกลตัวเลขและจัดการค่าผิดปกติ
ค่าสุดโต่งไม่ได้เป็นข้อผิดพลาดเสมอไป ออเดอร์ 40 ชิ้นจากบัญชีลูกค้า B2B คือยอดขายจริง ให้ติดแฟลกไว้เพื่อไม่ให้มันครอบงำค่าเฉลี่ย และเก็บไว้ในประวัติ ส่วนราคาต่อหน่วย 100,000 ที่พิมพ์ผิดจาก 1,000 คือข้อผิดพลาดในการป้อนข้อมูล ให้แก้ตัวเลข อย่า "จัดการ" มันเหมือนเป็นอุปสงค์
ตรวจค่าสุดโต่งก่อนลบ
สองวิธีตรวจที่ใช้คู่กันได้ดี กฎ 1.5 × ช่วงควอร์ไทล์ จะระบุจุดที่อยู่ไกลจากกลางคอลัมน์ ส่วนการตรวจตามโดเมนจะถามว่าค่านั้นเป็นไปได้หรือไม่ เช่น สต็อกติดลบ วันที่ในอีกหลายสิบปีข้างหน้า หรือส่วนลดที่สูงกว่าราคาขาย ให้ตรวจสอบก่อน แล้วจึงจำกัดค่าที่เปอร์เซ็นไทล์ที่ 1 และ 99 ใช้การแปลงลอการิทึมกับรายได้ที่เบ้ หรือเพิ่มแฟลกแล้วเก็บค่าดิบไว้สำหรับรายงาน
ออเดอร์ล็อตใหญ่ที่คุณลบทิ้งคือรายได้ที่คุณจะไม่มีวันพยากรณ์ได้อีก ส่วนข้อผิดพลาดที่คุณเก็บไว้จะกลายเป็นราคาที่โมเดลคิดว่าลูกค้ายินดีจ่าย
รันสรุปผลอีกครั้งหลังจำกัดค่า ศูนย์กลางของคอลัมน์ควรขยับแทบไม่มาก หากค่ามัธยฐานกระโดด แสดงว่าการจำกัดค่าทำงานมากเกินไป และคุณควรกลับไปดูแถวต้นทางอีกครั้ง
เลือกตัวปรับสเกลให้ตรงกับลักษณะข้อมูล
การปรับสเกลช่วยไม่ให้คอลัมน์ที่มีหน่วยใหญ่ เช่น รายได้ต่อปี กลบคอลัมน์ที่มีหน่วยเล็ก เช่น จำนวนหน่วยต่อออเดอร์ เอกสารการประมวลผลล่วงหน้าของ Scikit-learn ระบุว่า StandardScaler จัดให้แต่ละฟีเจอร์อยู่กึ่งกลางที่ค่าเฉลี่ยของชุดฝึกและปรับสเกลตามความแปรปรวน และอาจทำงานได้ไม่ดีเมื่อมีค่าผิดปกติจำนวนมาก ส่วน RobustScaler เป็นตัวทดแทนที่ใช้ค่าประมาณของจุดศูนย์กลางและช่วงที่ทนทานกว่า
ลักษณะของข้อมูล | Scaler | เหตุผลที่เหมาะสม |
|---|---|---|
ค่อนข้างสมมาตร มีค่าสุดโต่งน้อย | StandardScaler | จัดให้ค่าอยู่รอบค่าเฉลี่ย และปรับสเกลตามความแปรปรวน |
มีค่าผิดปกติมาก เช่น คำสั่งซื้อจำนวนมากที่เกิดขึ้นเป็นครั้งคราว | RobustScaler | ใช้ค่ามัธยฐานและพิสัยระหว่างควอร์ไทล์ ซึ่งทนต่อค่าสุดโต่ง |
ค่าต้องอยู่ในช่วงคงที่ เช่น คะแนนรีวิวตั้งแต่ 1 ถึง 5 | MinMaxScaler | แปลงค่าให้อยู่ระหว่าง 0-1 โดยไม่เปลี่ยนรูปร่างของการกระจาย |
ให้ fit scaler กับข้อมูลชุดฝึก (training data) เท่านั้น แล้วนำค่าที่ fit ได้ไปใช้กับชุดตรวจสอบ (validation) การ fit ซ้ำบนชุดข้อมูลที่กันไว้จะทำให้แถวข้อมูลที่สุดโต่งในชุด validation เข้ามากำหนดสเกลเอง หากต้องการเรียนรู้เพิ่มเติมเกี่ยวกับวิธีสังเกตค่าสุดโต่งก่อนเลือกวิธีจัดการ ดูได้ที่ คู่มือเรื่องค่าผิดปกติของ ELECTE
ทำไปป์ไลน์ให้อัตโนมัติและตรวจสอบผลลัพธ์
ไฟล์ที่ทำความสะอาดแล้วและเก็บไว้ใน notebook เดียวอาจคลาดเคลื่อนระหว่างการรันแต่ละครั้ง ไฟล์ใหม่อาจได้ค่าเติมข้อมูลที่ขาด การเข้ารหัสหมวดหมู่ หรือสเกลที่ต่างออกไป ทำให้แดชบอร์ดเปลี่ยนแม้ธุรกิจจริงจะไม่ได้เปลี่ยน
ไปป์ไลน์จะเก็บ imputer, encoder และ scaler ที่ fit แล้วไว้ด้วยกัน และใช้การแปลงแบบเดียวกันกับไฟล์ใหม่ ให้ fit ขั้นตอนเหล่านี้โดยใช้เฉพาะส่วนข้อมูลชุดฝึก แล้วนำค่าที่ fit ไว้ไปใช้กับข้อมูลชุดตรวจสอบและชุดทดสอบโดยไม่คำนวณใหม่ บันทึกของ IBM เรื่อง data leakage อธิบายว่าเหตุใดการ fit ขั้นตอนเตรียมข้อมูลข้ามชุดฝึกและชุดทดสอบจึงอาจทำให้ข้อมูลรั่วไหลเข้าสู่การประเมินผล
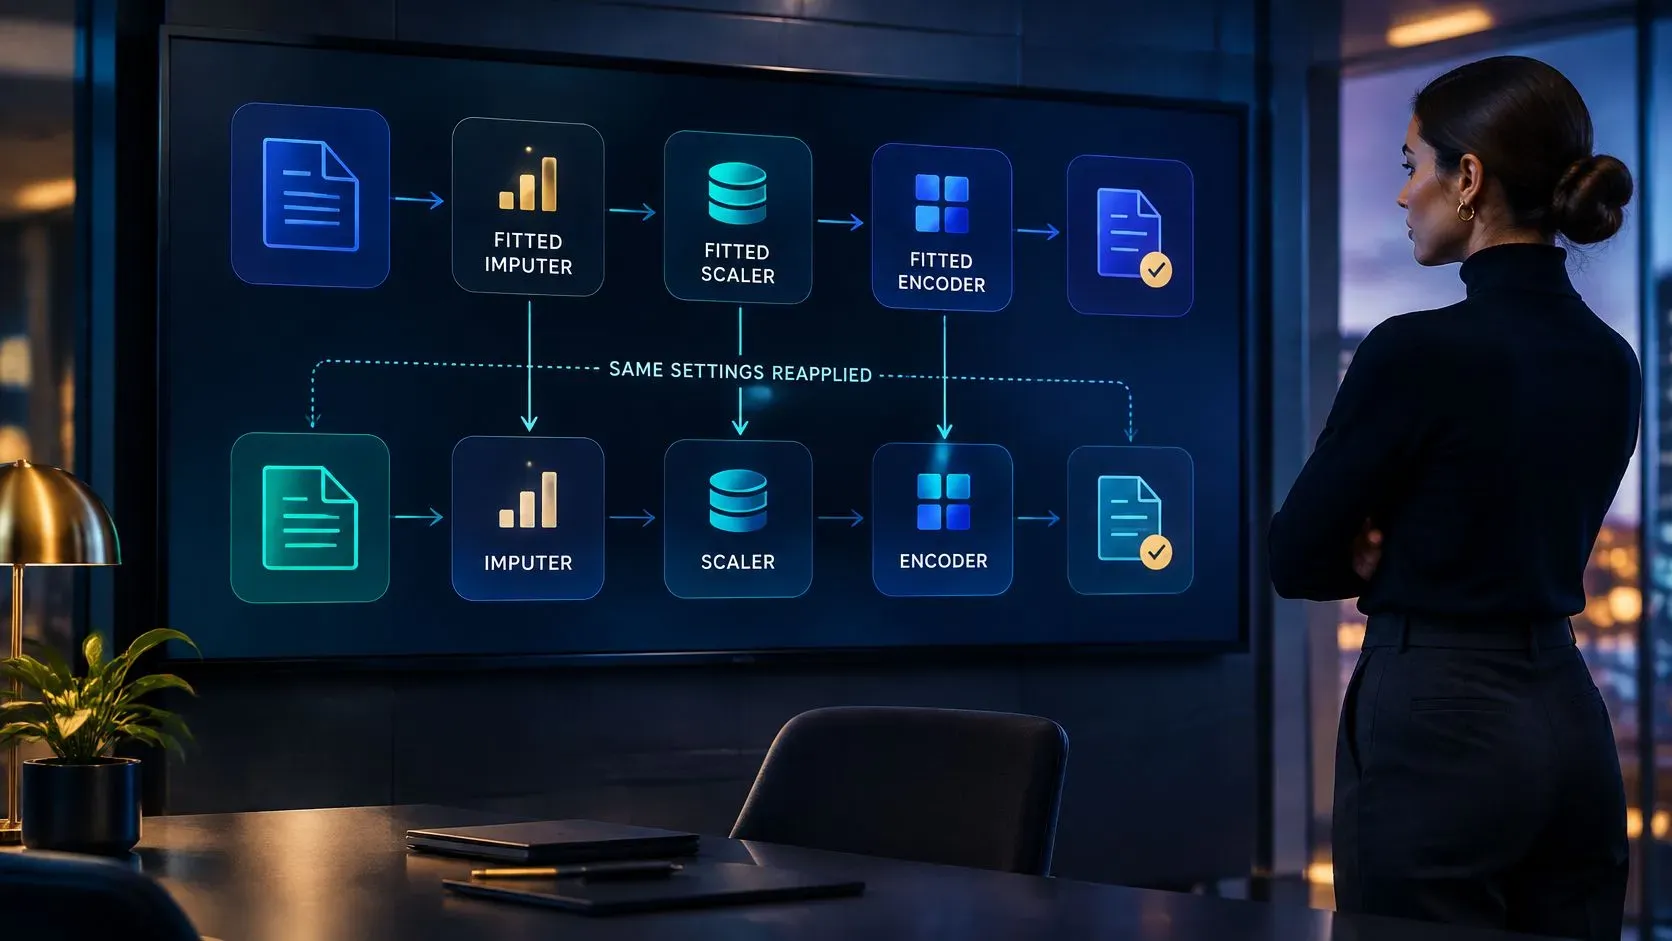
สิ่งที่ต้องตรวจสอบหลังการรันทุกครั้ง
งานที่รันสำเร็จเพียงยืนยันว่ากระบวนการทำงานครบเท่านั้น ให้ตรวจสอบว่าผลลัพธ์ยังตรงกับแหล่งข้อมูลและกฎที่คุณกำหนดหรือไม่:
- จำนวนแถว: กระทบยอดไฟล์ที่โหลดเข้ากับไฟล์ที่ส่งออก โดยนับรวมรายการซ้ำที่บันทึกไว้
- อัตราค่าว่างต่อคอลัมน์: ตรวจสอบหากเพิ่มขึ้นกะทันหัน ซึ่งอาจหมายความว่าฟิลด์จากแหล่งข้อมูลหยุดส่งเข้ามา
- ช่วงของค่า: ตรวจสอบว่าราคา ปริมาณ และวันที่ยังอยู่ในขอบเขตที่ยอมรับได้
- หมวดหมู่ใหม่: ส่งภูมิภาคหรือ SKU ที่ไม่เคยพบไปยังกลุ่มที่กำหนดไว้ แทนที่จะทิ้งไปโดยไม่แจ้งเตือน
สำหรับตัวอย่างการตรวจสอบความถูกต้องของข้อมูลในทางปฏิบัติ ลองดูว่าการตรวจสอบเหล่านี้ใช้กับไฟล์ธุรกิจอย่างไร ควรถือว่าผลลัพธ์อัตโนมัติเป็นเพียงค่าประมาณ และตรวจสอบด้วยตนเองในไม่กี่รอบแรกก่อนนำไปใช้ทริกเกอร์การแจ้งเตือน
ELECTE แพลตฟอร์มวิเคราะห์ข้อมูลด้วย AI สำหรับธุรกิจที่กำลังเติบโต เชื่อมต่อกับซอฟต์แวร์บัญชีหรือไฟล์ที่อัปโหลด แล้ววิเคราะห์ข้อมูลและพยากรณ์ได้โดยไม่ต้องมีนักวิเคราะห์ ลูกค้าประหยัดเวลาได้มากกว่า 10 ชั่วโมงต่อสัปดาห์ด้วยการวิเคราะห์การเงินอัตโนมัติ ประโยชน์นี้ขึ้นอยู่กับการใช้ขั้นตอนที่ฟิตแล้วและอธิบายได้ในการตรวจทาน แทนที่จะคำนวณใหม่ทุกครั้งที่อัปโหลด
สัปดาห์นี้ ลองนำชุดข้อมูลหนึ่งชุดมาตรวจตามตารางเจ็ดแถว และทำเครื่องหมายว่าขั้นตอนใดยังทำด้วยมืออยู่ ทำขั้นตอนที่ทำซ้ำให้เป็นอัตโนมัติ แต่ให้การตัดสินใจที่ต้องใช้วิจารณญาณ เช่น รายการซ้ำกับการสั่งซื้อซ้ำจริง หรือการพิมพ์ผิดกับการสั่งซื้อจำนวนมาก อยู่ในการตรวจสอบจนกว่ากฎจะนิ่ง
ELECTE เชื่อมต่อข้อมูลบัญชีหรือไฟล์ที่อัปโหลดของคุณ เตรียมข้อมูล และแปลงเป็นการพยากรณ์และรายงานที่คุณตรวจสอบร่วมกับทีมได้ หากต้องการให้ขั้นตอนเตรียมข้อมูลเหล่านี้ทำงานเหมือนกันทุกครั้งที่โหลด เข้าไปที่ ELECTE และดูว่าแพลตฟอร์มทำงานกับตัวเลขของคุณเองอย่างไร
ความคิดเห็น
ยังไม่มีความคิดเห็น — เริ่มการสนทนาได้เลย