שלבי עיבוד מקדים של נתונים: איך לנקות נתונים עסקיים
למדו אילו שלבי עיבוד מקדים של נתונים הופכים רשומות עסקיות מבולגנות לתובנות אמינות, עם דוגמאות לעסקים קטנים ובינוניים. גלו איך ELECTE מבצעת אותם באופן אוטומטי.
שלפתם ייצוא מכירות שנראה גמור. הזמנות, עלויות ותאריכים ממלאים את הגיליון. ואז תחזית מגיעה לשולחן של ראש הכספים, וערך ההזמנה הממוצע קפץ, למרות שדבר בקטלוג לא השתנה.
הקפיצה הזו היא לרוב שגיאת עיבוד מקדים, ולא שינוי בהתנהגות הקונים. מילוי מחירים חסרים בזמן שחשבוניות כפולות עדיין בקובץ, או התאמת קנה מידה לכל הייצוא לפני שהפרדתם שורות בצד, מלמדים את המודל עובדות שהוא לא אמור לראות עדיין. רוב המאמרים מציגים את שלבי עיבוד הנתונים המקדים כטכניקות נפרדות שאפשר ליישם בכל סדר. דווקא הסדר הוא החלק שמנפח את התוצאות.
להלן הרצף שאני ממליץ עליו כשאנליסט אחראי על קובץ עסקי חי. תקבלו סדר עבודה, ספים שאני רואה כנקודות התחלה ולא כחוקים, ודרך לנעול כל הגדרה שהותאמה, כך שטעינת הנתונים הבאה תלך באותו מסלול.
שבעה שלבי עיבוד מקדים של נתונים בסדר הנכון
ייצוא מכירות יכול להיראות שלם ועדיין להסתיר שורות חשבונית כפולות, עלויות יחידה חסרות ותאריכים השמורים בשני פורמטים. אם מנקים את הבעיות האלה בסדר הלא נכון, כל ממוצע שיחושב אחר כך ירש אותן.
כל שלב שלומד מספר מהנתונים חייב לרוץ אחרי ההפרדה. ממוצע, חציון או טווח התאמת קנה מידה שחושבו על הקובץ כולו נותנים לשורות האימות להשפיע על האימון. הציון נראה אז חזק יותר ממה שהמודל ישיג בהזמנות של החודש הבא.
שלב | מה עושים | מתי זה מוכן |
|---|---|---|
1. פרופיל וניקוי | בודקים מספר שורות, סוגי נתונים ושיעורי ערכים חסרים; מסירים כפילויות מדויקות; מתקננים תאריכים ותוויות | טבלת בסיס נקייה עם תווית אחת לכל קטגוריה |
2. פיצול הנתונים | מערבבים את השורות ואז מחלקים אותן לסט אימון וסט אימות | שני הסטים קיימים וטרם חושבו הגדרות נלמדות |
3. טיפול בערכים חסרים | מסירים שורות, מסירים את המאפיין, או משלימים ערכים באמצעות נתוני האימון בלבד | כל שדה שלם, או שהחוסרים בו מסומנים |
4. קידוד והנדסת מאפיינים | ממירים קטגוריות למספרים; בונים יחסים, רכיבי זמן וממוצעים נעים | טבלת מאפיינים מוכנה למודל עם עמודות מתועדות |
5. טיפול בערכים חריגים | מוודאים ערכים קיצוניים, ואז חוסמים אותם, מבצעים עליהם טרנספורמציה או מסמנים אותם | הערכים הקיצוניים מוסברים ולא מנוחשים |
6. סקלינג של מאפיינים מספריים | מתאימים סקיילר לנתוני האימון ומפעילים אותו על נתוני האימות | העמודות המספריות נמצאות בטווחים דומים |
7. נעילת הצינור | שומרים כל טרנספורמציה שהותאמה, כך שנתונים חדשים יעברו את אותו מסלול | הרצה חוזרת שעובדת על כל טעינת נתונים חדשה |
נניח שלקמעונאי יש 12,000 שורות הזמנה, ובהן 900 שורות חשבונית כפולות. אם משלימים מחירים חסרים לפני שמסירים את הכפילויות, אותה חשבונית נספרת פעמיים והממוצע מתרחק ממחירון המוצרים.
כלל מעשי: סיימו את השורה שאתם עובדים עליה לפני שאתם מחשבים משהו שהשורה הבאה זקוקה לו.
התאימו את הקובץ שפתחתם לשבע השורות האלה. השורה הראשונה שעוד לא סיימתם היא היחידה שכדאי לגעת בה היום.
פרופיל וניקוי של נתונים עסקיים גולמיים
יצירת פרופיל היא מעבר של שעה אחת שמנהל יכול לסיים לפני שמישהו פותח מודל. השאירו את הקובץ הגולמי ללא שינוי, וכתבו כל שינוי ביומן ניקוי, כדי שמנהל כספים יוכל לראות למה סכום מסוים השתנה.
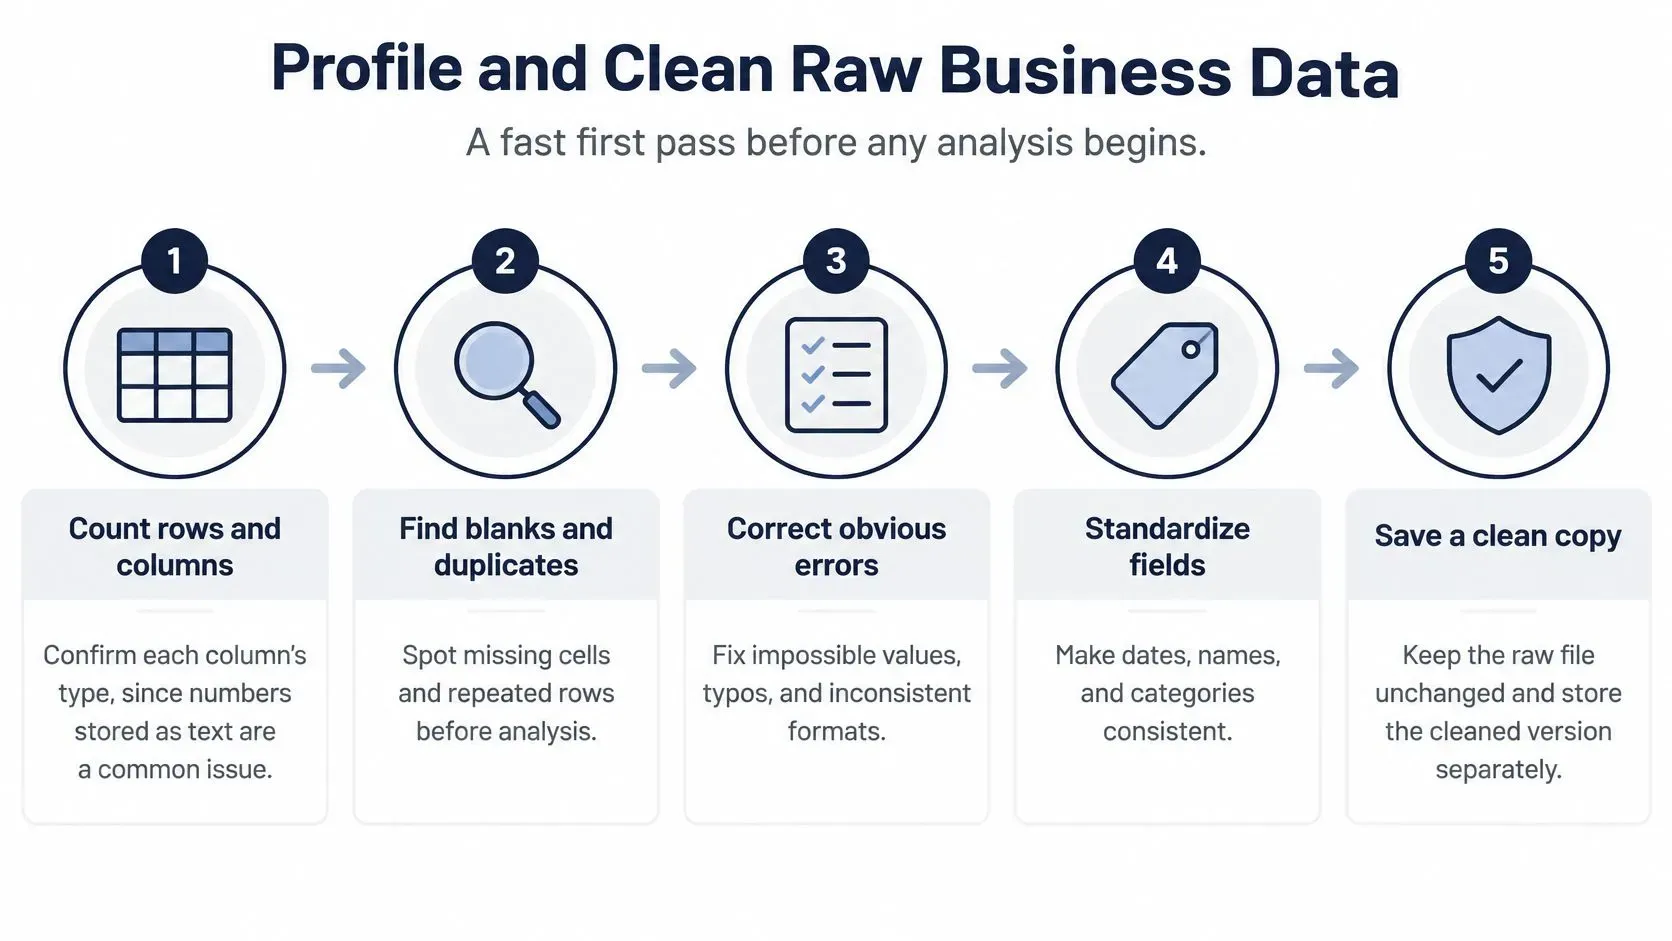
- ספרו שורות ועמודות, ואז אמתו את הסוג של כל עמודה. עלות שנשמרה כטקסט לא תיכלל בסכום, והדבר לא יגרום לשגיאה ברורה. המירו אותה לפני שאתם סומכים על סכום.
- חשבו את שיעור הערכים הריקים בכל עמודה. עמודה עם יותר מ-30% ריקים עוברת לכללי הטיפול בערכים חסרים ולא למילוי מהיר. אני הייתי מוחק עמודה לגמרי רק כשהריקים עוברים 50% והשדה אינו נדרש לצורך ההחלטה.
- הסירו כפילויות מדויקות, לא כאלה שרק דומות. התאימו לפי מספר חשבונית, תאריך וסכום יחד. הזמנה שנייה עם מזהה שורה שונה היא מכירה אמיתית. מחיקה שלה רק כי הלקוח והיום זהים היא הטעות שמציגה הכנסות נמוכות מהאמת.
- אחדו פורמטים במעבר אחד. תבנית תאריך אחת, מטבע אחד בכל עמודה, וללא רווחים מיותרים בקודים. פורמטים מעורבים מפצלים מוצר אחד לשתי סדרות ושוברים כל חיבור מאוחר יותר.
- אחדו את תוויות הקטגוריות.
UK,U.K.ו-United Kingdomהם שוק אחד. ארבע כתיבות של קו מוצרים אחד בייצוא מסחר אלקטרוני לשלוש שנים גורמות לאותו נזק. בחרו תווית אחת ומפו אליה את השאר.
נניח שבאותו ייצוא תאריכי ההזמנה נשמרים כ-2024-03-01 בשנה אחת וכ-01/03/2024 בשנה אחרת. כל עוד שניהם לא הפכו לתבנית אחת, תרשים חודשי יספור את מרץ פעמיים או יפספס אותו.
מה היומן והסרת הנתונים הפרטיים מגנים עליו
יומן הניקוי הוא טבלה קצרה: עמודה, כלל, מספר שורות ששונו, אחראי, תאריך. כשהכספים שואלים למה מרץ שעבר התכווץ, מצביעים על כלל הכפילויות ולא בונים את הקובץ מחדש מהזיכרון.
לפני שהקובץ מגיע לפלטפורמת ניתוח כלשהי, הסירו שמות לקוחות, כתובות אימייל ופרטי תשלום. אין בהם צורך כדי לחזות ביקוש, ולהשאיר אותם בייצוא יוצר בעיית פרטיות שאי אפשר לתקן באמצעות מודל.
אם אתם רוצים חוות דעת נוספת על איך נראים ייצואים מסחריים "טובים", תובנות איכות נתוני מכירות של Pipecorn הן רשימת בדיקה שימושית למזהים, שלמות ועקביות. השתמשו בהן כדי להחליט אילו עמודות כדאי לשמור, ואז חזרו לקריטריון שיעור הריקים שלמעלה.
פצלו את הנתונים לפני שמתחילה כל למידה
הפיצול הוא גדר. שום דבר שמעריך סטטיסטיקה לא שייך לקובץ המלא.
לסיווג טקסט מונחה (supervised), המדריך של Google לסיווג טקסט ממליץ לבצע ערבוב (shuffle) לפני החלוקה, מפני ששמירה על הסדר המקורי עלולה להטות את שתי הקבוצות. אחרי הערבוב, חלוקה אופיינית מציבה 80% מהדוגמאות באימון ו-20% באימות. אחר כך מופעלות אותן טרנספורמציות על שתי הקבוצות, אך רק לאחר שנלמדו משורות האימון.
למה קובץ מכירות ממוין משקר
ייצוא נתונים מגיע לעיתים קרובות ממוין לפי תאריך, אזור או לקוח. אם מפצלים קובץ כזה מלמעלה למטה, מאמנים על 2023 ומאמתים על סוף 2024. הציון עוקב אז אחר לוח השנה, אחר לוח המבצעים או אחר תמהיל של אזור אחד. הוא לא אומר אם המודל הבין את ההזמנות.
בצעו ערבוב כשכל שורה היא מקרה עצמאי: הזמנה שנסגרה, חשבון שנטש, פנייה שסווגה. אל תבצעו ערבוב כשהשאלה היא תחזית.
בתחזיות שמרו על סדר הזמן. אמנו על חודשים מוקדמים ובדקו על חודשים מאוחרים. ערבוב יאפשר למודל לראות את העתיד ולקרוא לזה מיומנות.
שדות טקסט דורשים חיתוך לפי תדירות
פניות תמיכה ותיאורי מוצרים מתפוצצים לאלפי טוקנים. באותו תהליך של Google מסלקים טוקנים שמופיעים פחות מ-פעמיים, שומרים את 20,000 מאפייני הטוקנים המובילים, ומדרגים את מה שנשאר בעזרת ציון חשיבות מבוסס מבחן F. טוקן שמופיע פעם אחת הוא בדרך כלל שגיאת הקלדה או SKU חד-פעמי, לא דפוס ששווה עבורו עמודה.
אחרי החלוקה, התאימו כל מיפוי על נתוני האימון בלבד, ואז החילו את המיפוי הקפוא על האימות. חישוב מחדש של אוצר מילים או של רשימת קטגוריות על השורות שהוחזקו בצד הוא דרך נוספת להדליף את התשובה לשלב ההכנה.
איך ממלאים ערכים חסרים בלי להטות את התוצאות
הפעולה נקבעת לפי התדירות שבה שדה נשאר ריק, והאם ההחלטה זקוקה לשדה הזה. הטווחים להלן הם כלל אצבע לעבודה, לא חוק. מודל סיכון מוסדר עשוי לאסור הסרה של שורות שתחזית קמעונאית יכולה לוותר עליהן.
שיעור הערכים החסרים | חשיבות המאפיין | פעולה |
|---|---|---|
מתחת ל-5% | כלשהי | להסיר את השורות האלה אם נשארו מספיק נתונים |
5% עד 30% | נמוכה | להסיר את המאפיין |
5% עד 30% | גבוהה | להשלים ערכים (imputation) על בסיס שורות האימון בלבד |
מעל 30% | גבוהה | להשלים ערכים, להוסיף עמודת סימון לערך חסר, ולבדוק מדוע השדה ריק |
מעל 30% | נמוכה | להסיר את המאפיין |
כמה עלויות חסרות בקובץ הזמנות שהוא שלם בדרך כלל הן המקרה הראשון. מחיקת השורות האלה פוגעת פחות מהמצאת מחיר. שדה סקר שנמצא בשימוש נדיר בטווח האמצעי לא שווה ניחוש שימולא בו, ולכן העמודה יוצאת. ותק הלקוח, שבו אתם משתמשים לחיזוי נטישה, נשאר, ואותו אתם אומדים.
ההנחיות של Google להכנת נתונים לאשכול מציינות שלוש אפשרויות מעשיות: להסיר דוגמאות שיש בהן ערכים חסרים, להסיר את המאפיין, או לחזות את הערכים החסרים מתוך נתונים אחרים. פערים נדירים יכולים להצדיק מחיקת שורות. פערים תכופים בדרך כלל אומרים שמוותרים על המאפיין או משלימים אותו.
חיזוי הפער במקום הדבקת קבוע
בשדה מספרי, אמנו מודל רגרסיה על שורות שבהן הערך קיים, ואז אמדו את הערכים החסרים. למשל, גיל לקוח חסר אפשר לאמוד לפי הכנסה וותק, במקום להחליף אותו בממוצע אחד לכל החברה. כך משתמשים בקשרים שכבר אתם סומכים עליהם.
ערכי ההזמנות מוטים. כמה כרטיסי סיטונאות גדולים מושכים את הממוצע מעלה, ולכן השלמה בממוצע גורמת לסלים רגילים להיראות עשירים יותר משהם. החציון נמצא ליד ההזמנה הטיפוסית וזז פחות כשחשבונית כמותית אחת נכנסת. השוו סטטיסטיקות מסכמות לפני ההשלמה ואחריה. שינוי גדול אומר שהשיטה משכתבת את העסק ולא מתקנת חור.
בקטגוריות, תייגו את הערך החסר כ-Unknown. הפער הוא לעיתים קרובות האות: קופה שלא קלטה אזור, או מוצר בלי קוד ספק. הפיכתו לרמה אמיתית שומרת על השורה ומראה למודל שהשדה היה ריק במכוון.
ערכים חסרים תכופים אינם נדירים בתפעול. מחקר מ-2025 על נתוני צריכת מים חסרים מתאר מערך נתונים של בניין עם 33,888 רשומות שעתיות מפברואר 2019 עד דצמבר 2023, כאשר ב-20% מהשעות חסרים ערכים. זה טווח שבו מחיקת שורות גורפת תזרוק יותר מדי היסטוריה (המחקר).
התאימו את המשלים על שורות האימון בלבד. המדריך של ELECTE לנתונים חסרים מפרט את אפשרויות ההשלמה, אם תרצו סבב נוסף על השיטה, ולא על הסדר.
קידוד קטגוריות והנדסת מאפיינים שימושיים
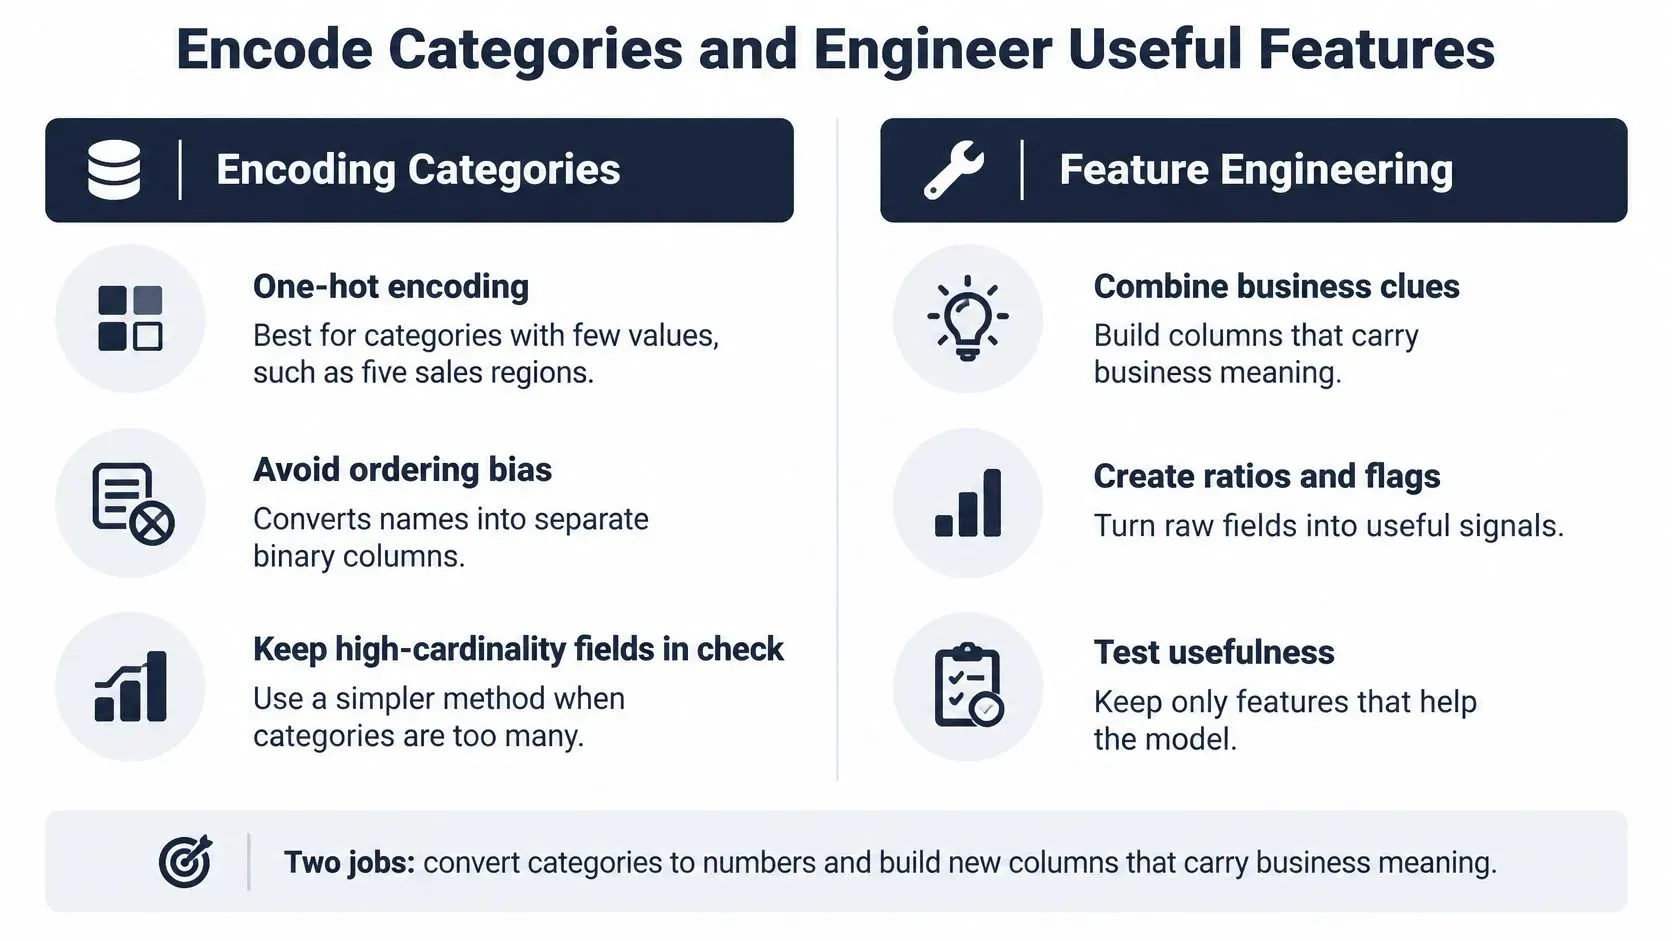
יש כאן שתי משימות. להפוך תוויות למספרים שהמודל יכול להשתמש בהם, ולבנות עמודות שעונות על שאלה עסקית שהשדות הגולמיים לא עונים עליה.
קידוד בלי דירוג מזויף
קידוד One-hot מתאים לקטגוריות עם מעט ערכים, כמו חמישה אזורי מכירות. כל אזור הופך לעמודת כן/לא משלו, ואף אזור לא "גדול" מאחר.
קידוד סדור (Ordinal) מתאים לסדר אמיתי, כמו מידות S, M ו-L. המספרים תואמים דירוג שהעסק כבר משתמש בו.
אל תקצו 1, 2, 3 לשמות ללא סדר כמו ערוץ או עיר. המודל יתייחס לקוד גבוה יותר כאל יותר מדבר מה. הדירוג המזויף הזה יופיע בהמשך כמקדם בטוח בעצמו ושגוי. כששדה כולל מאות רמות, one-hot יוצר טבלה רחבה מאוד. קבצו רמות נדירות ל-Other לפני הקידוד, ולמדו את הקיבוץ הזה על שורות האימון בלבד.
עמודות שעונות על שאלה עסקית
בנו רשימה קצרה הקשורה להחלטה אחת, לא שפך של כל יחס שאפשר לנסח.
- אחוז מרווח:
(price − cost) / priceמראה אם מבצע עדיין מכסה את העלות, מה שהכנסות לבדן לא יכולות להראות. - ימים מאז הרכישה האחרונה: בדיקת נטישה צריכה עדכניות, לא עוד עותק של מזהה הלקוח.
- יום בשבוע וחודש: תכנון ביקוש מושפע מזינוקי יום שישי ומחודשי עונתיות שמוסתרים בתוך חותמת זמן מלאה.
- ממוצע נע של 7 ימים: היחידות היומיות קופצות מעלה ומטה. ממוצע שבועי מראה אם הביקוש עולה.
- יחס מלאי למכירות: מנהל מלאי מזהה מחסור מתהווה מוקדם יותר ממה שמאפשרת ספירת מלאי גולמית.
הייתי מתחיל בעשרה עד חמישה-עשר מאפיינים הקשורים להחלטה אחת. כשעמודות מתואמות מעל 0.95, מוחקים אחת מהזוג, כי העמודה השנייה חוזרת על הראשונה. כתבו ליד שם העמודה במילון הנתונים את המשמעות העסקית שלה. מפת קידוד או ממוצע נע שנלמדו על הקובץ כולו, כולל שורות שהתכוונתם להשאיר בצד, יוצרים שוב את הדליפה שכבר חסמתם בחלוקה.
קנה מידה לערכים ושליטה בחריגים
ערך קיצוני אינו בהכרח טעות. הזמנה של 40 יחידות מלקוח B2B היא מכירה אמיתית. סמנו אותה כדי שלא תשלוט בממוצע, והשאירו אותה בהיסטוריה. מחיר יחידה של 100,000 שהוקלד במקום 1,000 הוא שגיאת הזנה. תקנו את הספרה, ואל "תטפלו" בו כאילו היה ביקוש.
בדקו את הערך הקיצוני לפני שמוחקים אותו
שתי בדיקות עובדות היטב יחד. כלל 1.5 × הטווח הבין-רבעוני מסמן נקודות הרחוקות מאמצע העמודה. בדיקת תחום שואלת אם הערך יכול להתקיים: מלאי שלילי, תאריך בעשור הבא, הנחה גבוהה ממחיר המכירה. קודם מאמתים. אחר כך חותכים באחוזון ה-1 וה-99, מפעילים טרנספורמציית לוג על הכנסות מוטות, או מוסיפים סימון ושומרים את המספר הגולמי לדיווח.
הזמנה גדולה שמחקתם היא הכנסה שלא תנבאו שוב לעולם. טעות הקלדה שהשארתם הופכת למחיר שהמודל חושב שלקוחות ישלמו.
הריצו שוב את הסיכום אחרי החיתוך. מרכז העמודה כמעט לא אמור לזוז. אם החציון קופץ, החיתוך עושה יותר מדי עבודה וכדאי לחזור ולבדוק את שורות המקור.
איזה סקלר מתאים לפרופיל
קנה מידה מונע מעמודה ביחידות גדולות, כמו הכנסה שנתית, להטביע עמודה ביחידות קטנות, כמו יחידות להזמנה. התיעוד של Scikit-learn על עיבוד מקדים מציין ש-StandardScaler ממרכז כל מאפיין סביב ממוצע סט האימון ומשנה קנה מידה לפי השונות, ושהוא עלול לתפקד גרוע כשיש הרבה חריגים. RobustScaler הוא תחליף מוכן שמשתמש באומדנים עמידים יותר למרכז ולטווח.
פרופיל הנתונים | Scaler | למה זה מתאים |
|---|---|---|
התפלגות סימטרית פחות או יותר, מעט ערכי קיצון | StandardScaler | ממקז סביב הממוצע ומשנה קנה מידה לפי השונות |
חריגים רבים, למשל הזמנות סיטונאיות מדי פעם | RobustScaler | משתמש בחציון ובטווח הבין-רבעוני, שעמידים בפני ערכי קיצון |
הערכים צריכים להיות בטווח קבוע, למשל דירוגים מ-1 עד 5 | MinMaxScaler | ממפה ערכים לטווח 0-1 מבלי לשנות את צורת ההתפלגות |
יש להתאים (fit) את הסקיילר לנתוני האימון בלבד, ואז להחיל את ההתאמה הזו על נתוני הוולידציה. התאמה מחדש על קבוצת הנתונים שהוחזקה בצד גורמת לכך שערכים קיצוניים בשורות הוולידציה יקבעו את קנה המידה. להעמקה בזיהוי ערכים קיצוניים לפני שבוחרים דרך טיפול, ראו את המדריך של ELECTE לערכים חריגים.
אוטומציה של ה-Pipeline ובדיקת הפלטים שלו
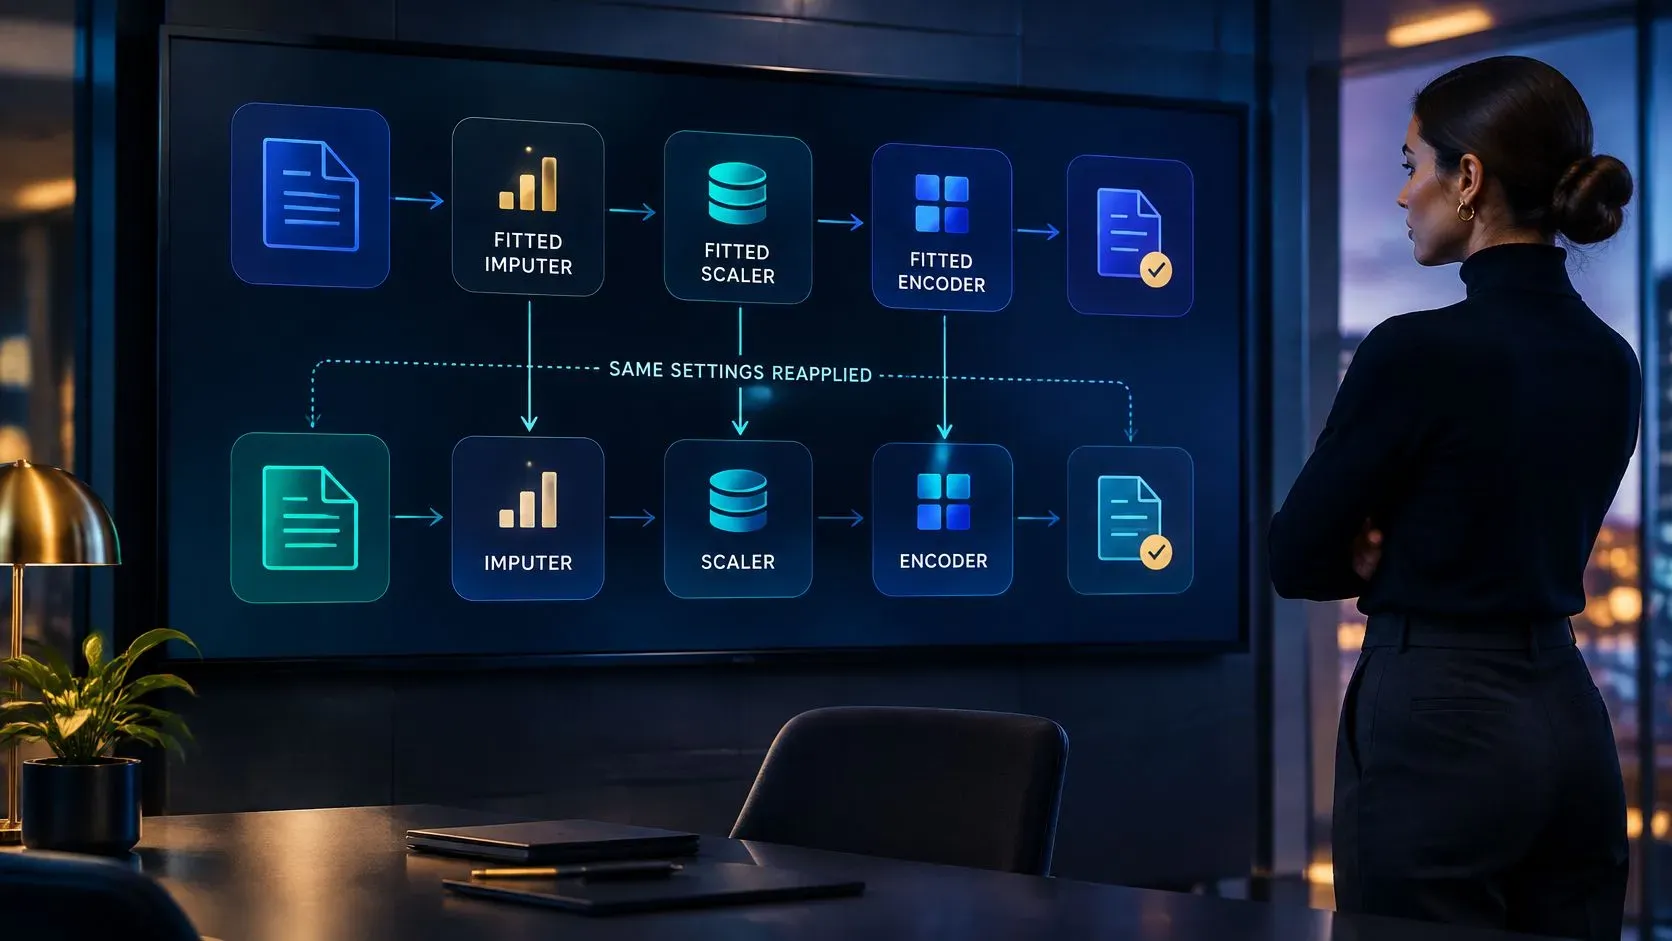
קובץ מנוקה ששמור במחברת אחת עלול להשתנות בין הרצות. קובץ חדש עשוי לקבל ערך השלמה, קידוד קטגוריות או קנה מידה אחרים, ולכן לוח מחוונים ישתנה גם כשהעסק עצמו לא השתנה.
Pipeline שומר יחד את ה-imputer, ה-encoder וה-scaler שהותאמו, ומחיל את אותן טרנספורמציות על קבצים חדשים. התאימו את השלבים האלה על מחיצת האימון בלבד. החילו את ההגדרות שהותאמו על נתוני הוולידציה והבדיקה בלי לחשב אותן מחדש. ההסבר של IBM על דליפת נתונים מראה מדוע התאמת שלבי עיבוד מקדים על נתוני האימון והבדיקה יחד עלולה להדליף מידע אל ההערכה.
בדיקות אחרי כל הרצה
עבודה שהסתיימה בהצלחה מאשרת רק שהתהליך רץ. בדקו אם הפלט עדיין תואם למקור ולכללים שהגדרתם:
- ספירת שורות: השוו בין הקובץ שנטען לבין הייצוא, תוך התחשבות בכפילויות שתועדו ביומן.
- שיעור ערכים חסרים בכל עמודה: בדקו עלייה פתאומית, שעשויה להעיד על כך ששדה במקור הפסיק להגיע.
- טווחי ערכים: ודאו שמחירים, כמויות ותאריכים נשארים בתוך הגבולות המותרים.
- קטגוריות חדשות: נתבו אזור או SKU שלא נראו קודם לקטגוריה מוגדרת, במקום להשמיט אותם ללא התראה.
לקבלת דוגמאות מעשיות לוולידציה של נתונים, עיינו באופן שבו הבדיקות האלה חלות על קבצים עסקיים. יש להתייחס לפלטים אוטומטיים כאל הערכות, ולבדוק ידנית את המחזורים הראשונים לפני שמשתמשים בהם להפעלת התראות.
ELECTE, פלטפורמת ניתוח נתונים מבוססת בינה מלאכותית לחברות בצמיחה, מתחברת לתוכנת הנהלת חשבונות או לקובץ שהועלה, ומבצעת ניתוח נתונים ותחזיות ללא צורך באנליסט. לקוחות חוסכים יותר מ-10 שעות בשבוע באמצעות אוטומציה של ניתוח פיננסי. התועלת הזו תלויה בשימוש בשלבים מותאמים (fitted) שאפשר להגן עליהם בביקורת, במקום לחשב אותם מחדש בכל העלאה.
השבוע, קחו מערך נתונים אחד והעבירו אותו דרך טבלת שבע השורות, וסמנו אילו שלבים עדיין ידניים. הפכו שלב שחוזר על עצמו לאוטומטי, אך השאירו החלטות שדורשות שיקול דעת, כמו כפילות מול הזמנה חוזרת אמיתית או שגיאת הקלדה מול הזמנה בכמות גדולה, בבדיקה ידנית עד שהכללים יתייצבו.
ELECTE מתחברת לנתוני הנהלת החשבונות שלכם או לקובץ שהעליתם, מכינה אותם והופכת אותם לתחזיות ולדוחות שאפשר לעבור עליהם עם הצוות. אם אתם רוצים שהשלבים האלה של עיבוד מקדים של נתונים יופעלו באותו אופן בכל טעינה, בקרו ב-ELECTE וראו כיצד הפלטפורמה מריצה את התהליך על המספרים שלכם.
תגובות
אין עדיין תגובות — התחל/י את השיחה.