Các bước tiền xử lý dữ liệu: cách làm sạch dữ liệu kinh doanh
Tìm hiểu các bước tiền xử lý dữ liệu giúp biến bản ghi kinh doanh lộn xộn thành thông tin đáng tin cậy, kèm ví dụ cho doanh nghiệp vừa và nhỏ. Xem cách ELECTE tự động hóa các bước này.
Bạn xuất một bảng dữ liệu bán hàng trông đã hoàn chỉnh. Đơn hàng, chi phí và ngày tháng đều đã điền đủ. Rồi bản dự báo đến tay trưởng bộ phận tài chính, và giá trị đơn hàng trung bình bỗng tăng vọt, dù danh mục sản phẩm không hề thay đổi.
Mức tăng đó thường là lỗi tiền xử lý chứ không phải do hành vi mua hàng thay đổi. Nếu bạn điền các giá bán còn trống khi tệp vẫn còn hóa đơn trùng lặp, hoặc chuẩn hóa toàn bộ dữ liệu trích xuất trước khi tách riêng một phần dòng, mô hình sẽ học những thông tin mà lẽ ra nó chưa được biết. Hầu hết bài viết đều liệt kê các bước tiền xử lý dữ liệu như những kỹ thuật riêng lẻ, áp dụng theo thứ tự nào cũng được. Chính thứ tự mới là yếu tố làm kết quả bị thổi phồng.
Dưới đây là trình tự tôi khuyến nghị khi một nhà phân tích phụ trách một tệp dữ liệu kinh doanh đang vận hành. Bạn sẽ có thứ tự thực hiện, các ngưỡng mà tôi xem là điểm khởi đầu chứ không phải quy luật, và cách khóa từng thiết lập đã được tính toán để lần tải dữ liệu tiếp theo đi theo cùng một quy trình.
Bảy bước tiền xử lý dữ liệu theo đúng thứ tự
Một bảng xuất dữ liệu bán hàng có thể trông đầy đủ nhưng vẫn ẩn các dòng hóa đơn trùng lặp, giá vốn đơn vị bị bỏ trống và ngày tháng lưu ở hai định dạng. Nếu xử lý các vấn đề này sai thứ tự, mọi giá trị trung bình sau đó đều thừa hưởng chúng.
Mọi bước tính một con số từ dữ liệu đều phải chạy sau khi tách dữ liệu. Nếu tính giá trị trung bình, trung vị hoặc khoảng chuẩn hóa trên toàn bộ tệp, các dòng kiểm định sẽ ảnh hưởng đến dữ liệu huấn luyện. Khi đó điểm số trông tốt hơn so với hiệu quả thực tế của mô hình trên các đơn hàng tháng tới.
Bước | Việc cần làm | Hoàn thành khi |
|---|---|---|
1. Khảo sát và làm sạch | Kiểm tra số dòng, kiểu dữ liệu và tỷ lệ giá trị rỗng; loại bỏ các dòng trùng lặp hoàn toàn; chuẩn hóa ngày tháng và nhãn | Có bảng nền sạch, mỗi danh mục chỉ có một nhãn |
2. Tách dữ liệu | Xáo trộn các dòng, rồi chia thành tập huấn luyện và tập kiểm định | Đã có hai tập và chưa tính bất kỳ thiết lập học từ dữ liệu nào |
3. Xử lý giá trị thiếu | Bỏ dòng, bỏ đặc trưng, hoặc điền giá trị thay thế chỉ dựa trên dữ liệu huấn luyện | Mọi trường đều đầy đủ hoặc các chỗ trống đã được đánh dấu |
4. Mã hóa và xây dựng đặc trưng | Chuyển danh mục thành số; tạo các tỷ lệ, thành phần thời gian và trung bình trượt | Có bảng đặc trưng sẵn sàng cho mô hình, các cột đều được ghi chú |
5. Xử lý ngoại lai | Xác minh các giá trị cực đoan, rồi giới hạn, biến đổi hoặc đánh dấu chúng | Các giá trị cực đoan đã được giải thích, không phải đoán |
6. Chuẩn hóa thang đo đặc trưng số | Khớp bộ chuẩn hóa trên dữ liệu huấn luyện và áp dụng cho dữ liệu kiểm định | Các cột số nằm trong khoảng giá trị tương đương nhau |
7. Khóa quy trình | Lưu mọi phép biến đổi đã khớp để dữ liệu mới đi theo cùng một lộ trình | Quy trình chạy lặp lại được trên mỗi lần tải dữ liệu mới |
Giả sử một nhà bán lẻ có 12.000 dòng đơn hàng, trong đó có 900 dòng hóa đơn trùng lặp. Nếu điền giá còn thiếu trước khi loại bỏ các dòng trùng, cùng một hóa đơn sẽ bị tính hai lần và làm giá trung bình lệch khỏi bảng giá.
Quy tắc thực tế: Hãy xử lý xong dòng hiện tại trước khi tính bất kỳ thứ gì mà dòng tiếp theo cần.
Hãy đối chiếu tệp bạn đang mở với bảy dòng đó. Dòng đầu tiên mà bạn chưa hoàn thành là dòng duy nhất đáng xử lý hôm nay.
Phân tích hồ sơ và làm sạch dữ liệu kinh doanh thô
Phân tích hồ sơ dữ liệu (profiling) là một lượt rà soát kéo dài một giờ mà người quản lý có thể hoàn tất trước khi ai đó mở mô hình. Hãy giữ nguyên tệp thô và ghi mọi thay đổi vào nhật ký làm sạch để trưởng bộ phận tài chính biết vì sao một tổng số thay đổi.
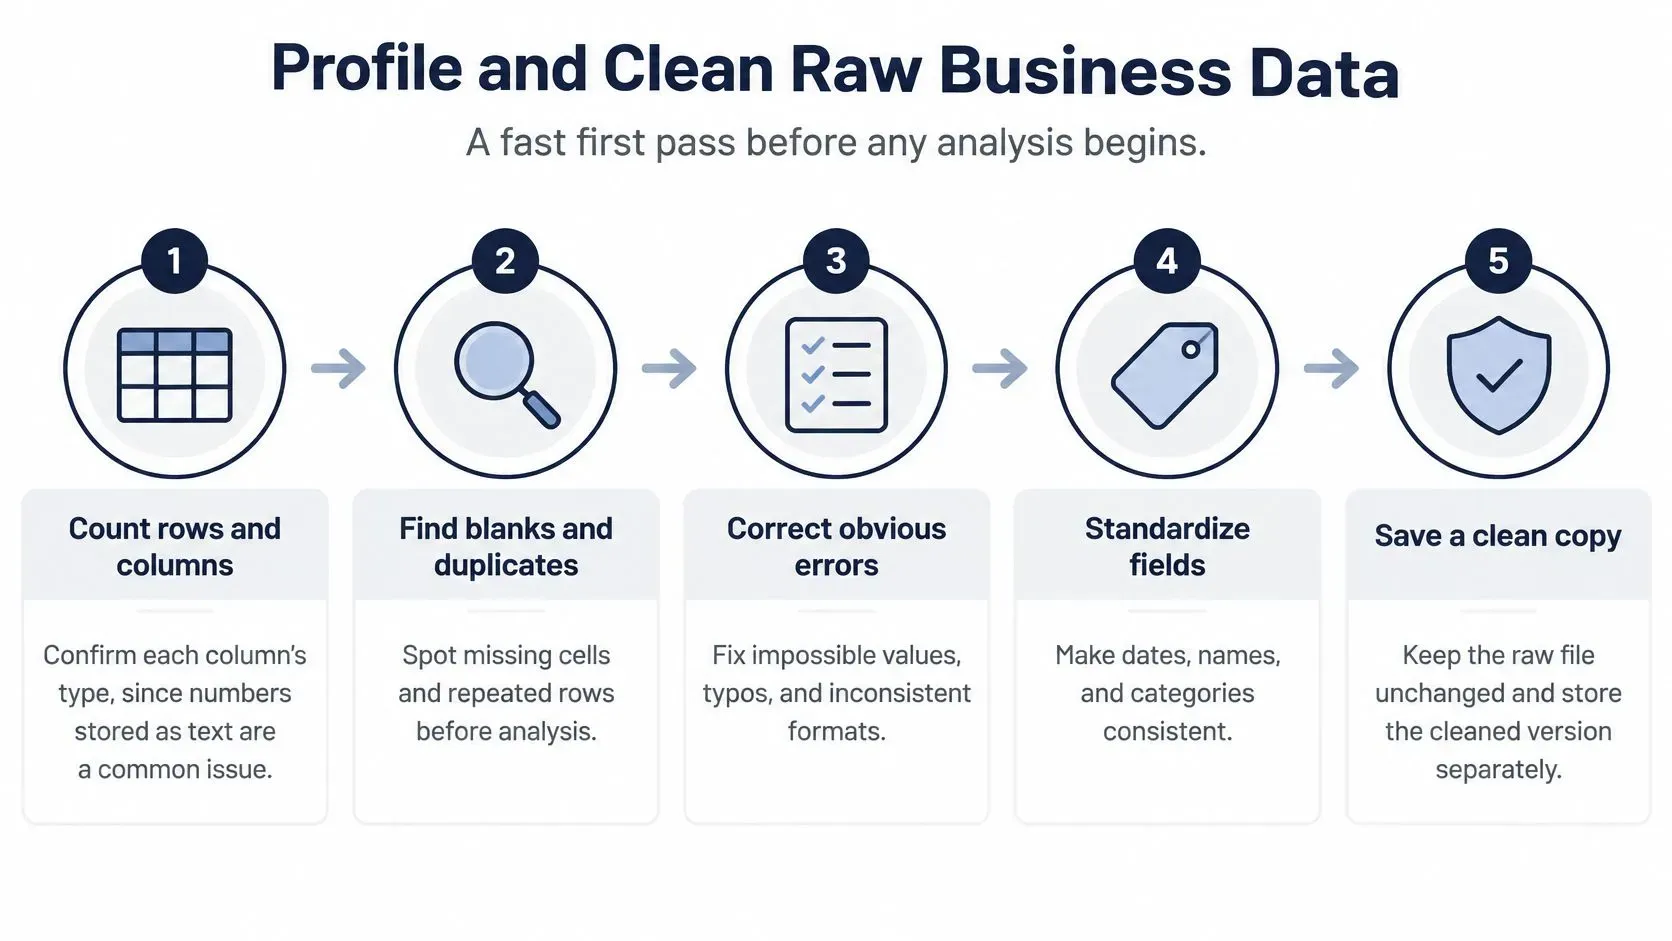
- Đếm số hàng và số cột, rồi xác nhận kiểu dữ liệu của từng cột. Chi phí lưu dưới dạng văn bản sẽ không cộng được và cũng không báo lỗi rõ ràng. Hãy chuyển đổi trước khi tin vào một tổng số.
- Tính tỷ lệ giá trị rỗng ở mọi cột. Cột có hơn 30% ô trống nên áp dụng quy tắc xử lý giá trị thiếu thay vì điền nhanh. Tôi chỉ loại hẳn một cột khi ô trống vượt 50% và trường đó không cần thiết cho quyết định.
- Xóa bản trùng khớp hoàn toàn, không xóa bản chỉ giống nhau. Đối chiếu đồng thời số hóa đơn, ngày và số tiền. Một đơn hàng thứ hai có mã dòng khác là một giao dịch bán thật. Xóa nó chỉ vì khách hàng và ngày trùng nhau là sai sót khiến doanh thu bị thấp hơn thực tế.
- Chuẩn hóa định dạng trong một lượt. Một kiểu ngày, một loại tiền tệ cho mỗi cột và không có khoảng trắng thừa trong mã. Định dạng lẫn lộn tách một sản phẩm thành hai chuỗi số liệu và làm hỏng mọi phép nối dữ liệu sau này.
- Chuẩn hóa nhãn danh mục.
UK,U.K.vàUnited Kingdomlà cùng một thị trường. Bốn cách viết của một dòng sản phẩm trong bản xuất dữ liệu thương mại điện tử ba năm gây thiệt hại tương tự. Hãy chọn một nhãn và ánh xạ các nhãn còn lại về nhãn đó.
Giả sử bản xuất đó lưu ngày đặt hàng dạng 2024-03-01 ở một năm và 01/03/2024 ở năm khác. Cho đến khi cả hai về cùng một kiểu, biểu đồ theo tháng sẽ đếm trùng tháng 3 hoặc bỏ sót nó.
Nhật ký và bước loại bỏ dữ liệu cá nhân bảo vệ điều gì
Nhật ký làm sạch là một bảng ngắn: cột, quy tắc, số hàng thay đổi, người thực hiện, ngày. Khi bộ phận tài chính hỏi vì sao tháng 3 năm ngoái giảm, bạn chỉ ra quy tắc xử lý bản trùng thay vì dựng lại tệp theo trí nhớ.
Trước khi tệp đến bất kỳ nền tảng phân tích nào, hãy xóa tên khách hàng, email và thông tin thanh toán. Bạn không cần chúng để dự báo nhu cầu, và để chúng lại trong bản trích xuất sẽ tạo ra vấn đề quyền riêng tự mà mô hình không thể khắc phục.
Nếu muốn có ý kiến tham khảo thứ hai về thế nào là "tốt" đối với dữ liệu thương mại, những góc nhìn về chất lượng dữ liệu bán hàng của Pipecorn là danh sách kiểm tra hữu ích cho mã định danh, độ đầy đủ và tính nhất quán. Hãy dùng chúng để quyết định nên giữ những cột nào, rồi quay lại bước cắt theo tỷ lệ rỗng ở trên.
Chia dữ liệu trước khi bất kỳ quá trình học nào diễn ra
Việc chia dữ liệu là một hàng rào. Không thống kê nào được ước tính trên toàn bộ tệp.
Với bài toán phân loại văn bản có giám sát, hướng dẫn phân loại văn bản của Google khuyên nên xáo trộn dữ liệu trước khi chia, vì giữ nguyên thứ tự ban đầu có thể gây thiên lệch cho cả hai tập. Sau khi xáo trộn, cách chia điển hình đưa 80% mẫu vào tập huấn luyện và 20% vào tập kiểm định. Sau đó các phép biến đổi giống nhau được áp dụng cho cả hai tập, nhưng chỉ sau khi đã được học trên các hàng huấn luyện.
Vì sao tệp bán hàng đã sắp xếp cho kết quả sai lệch
Dữ liệu xuất ra thường được sắp xếp theo ngày, khu vực hoặc khách hàng. Nếu chia tệp đó từ trên xuống dưới, bạn huấn luyện trên năm 2023 và kiểm định trên cuối năm 2024. Điểm số khi đó phản ánh lịch, lịch khuyến mãi hoặc cơ cấu của một khu vực. Nó không cho bạn biết mô hình có hiểu các đơn hàng hay không.
Hãy xáo trộn khi mỗi hàng là một trường hợp độc lập: một đơn hàng đã chốt, một tài khoản đã rời bỏ, một phiếu hỗ trợ đã được phân loại. Đừng xáo trộn khi câu hỏi là một bài toán dự báo.
Hãy giữ thứ tự thời gian khi dự báo. Huấn luyện trên các tháng trước và kiểm tra trên các tháng sau. Xáo trộn sẽ để mô hình nhìn thấy tương lai rồi gọi đó là năng lực.
Trường văn bản cần lọc theo tần suất
Phiếu hỗ trợ và mô tả sản phẩm bùng nổ thành hàng nghìn token. Trong cùng quy trình của Google, bạn loại các token xuất hiện ít hơn hai lần, giữ 20.000 đặc trưng token hàng đầu và xếp hạng phần còn lại bằng điểm mức độ quan trọng dựa trên kiểm định F. Một token chỉ xuất hiện một lần thường là lỗi gõ hoặc một SKU đơn lẻ, không phải mẫu hình đáng để dành một cột.
Sau khi chia, hãy khớp mọi ánh xạ chỉ trên dữ liệu huấn luyện, rồi áp dụng ánh xạ đã cố định đó cho tập kiểm định. Tính lại bộ từ vựng hoặc danh sách danh mục trên các hàng giữ lại là một cách khác để làm lộ đáp án vào khâu chuẩn bị dữ liệu.
Điền giá trị thiếu mà không làm lệch kết quả
Tần suất một trường bị bỏ trống, và việc quyết định có cần trường đó hay không, sẽ quyết định cách xử lý. Các mức dưới đây là quy tắc kinh nghiệm để làm việc, không phải quy luật. Một mô hình rủi ro chịu quản lý có thể không cho phép loại bỏ những hàng mà một dự báo bán lẻ có thể bỏ qua.
Tỷ lệ thiếu dữ liệu | Mức độ quan trọng của đặc trưng | Hành động |
|---|---|---|
Dưới 5% | Bất kỳ | Loại bỏ các dòng đó nếu vẫn còn đủ dữ liệu |
5% đến 30% | Thấp | Loại bỏ đặc trưng |
5% đến 30% | Cao | Điền khuyết chỉ từ các dòng huấn luyện |
Trên 30% | Cao | Điền khuyết, thêm cột cờ đánh dấu thiếu dữ liệu và tìm hiểu vì sao trường này bị bỏ trống |
Trên 30% | Thấp | Loại bỏ đặc trưng |
Một vài ô chi phí bị trống trong một tệp đơn hàng vốn đầy đủ chính là dòng đầu tiên. Xóa những dòng đó ít gây hại hơn việc tự bịa ra một mức giá. Một trường khảo sát ít dùng nằm ở nhóm giữa không đáng để điền bằng phỏng đoán, nên bạn bỏ cột đó. Thời gian gắn bó (tenure), mà bạn dùng cho bài toán rời bỏ (churn), thì giữ lại và ước lượng giá trị.
Hướng dẫn chuẩn bị dữ liệu cho phân cụm của Google nêu ba lựa chọn thực tế: xóa các mẫu chứa giá trị thiếu, xóa đặc trưng, hoặc dự đoán giá trị thiếu từ dữ liệu khác. Khi chỗ trống hiếm, việc xóa dòng có thể hợp lý. Khi chỗ trống xuất hiện thường xuyên, bạn thường nên bỏ đặc trưng hoặc điền khuyết.
Dự đoán chỗ trống thay vì dán một hằng số
Với trường số, hãy huấn luyện một mô hình hồi quy trên các dòng đã có giá trị, rồi ước lượng các ô trống. Ví dụ, tuổi khách hàng bị thiếu có thể được ước lượng từ thu nhập và thời gian gắn bó, thay vì thay bằng một mức trung bình chung của cả công ty. Cách này tận dụng những mối quan hệ mà bạn đã tin cậy.
Giá trị đơn hàng thường lệch phải. Một vài đơn bán buôn lớn kéo giá trị trung bình lên, nên điền bằng trung bình khiến giỏ hàng thông thường trông giàu hơn thực tế. Trung vị nằm cùng nhóm đơn hàng điển hình và ít dịch chuyển hơn khi có một hóa đơn số lượng lớn xuất hiện. Hãy so sánh thống kê tóm tắt trước và sau khi điền. Nếu chênh lệch lớn, phương pháp đó đang viết lại thực tế kinh doanh chứ không phải vá một lỗ hổng.
Với biến phân loại, hãy gán nhãn Unknown cho ô trống. Chỗ trống thường chính là tín hiệu: một quy trình thanh toán không ghi nhận khu vực, hoặc một sản phẩm không có mã nhà cung cấp. Biến điều đó thành một mức thực sự giúp giữ lại dòng dữ liệu và cho mô hình biết trường này bị bỏ trống có chủ đích.
Dữ liệu trống thường xuyên không hiếm trong vận hành. Một nghiên cứu năm 2025 về dữ liệu tiêu thụ nước không đầy đủ mô tả một bộ dữ liệu tòa nhà gồm 33.888 bản ghi theo giờ từ tháng 2/2019 đến tháng 12/2023, với giá trị thiếu ở 20% số giờ. Mức này nằm trong khoảng mà việc xóa hàng loạt các dòng sẽ làm mất quá nhiều lịch sử (nghiên cứu).
Chỉ khớp bộ điền khuyết trên các dòng huấn luyện. Hướng dẫn về dữ liệu thiếu của ELECTE trình bày chi tiết hơn các lựa chọn điền khuyết, nếu bạn muốn xem lại về phương pháp chứ không phải về thứ tự thực hiện.
Mã hóa biến phân loại và xây dựng đặc trưng hữu ích
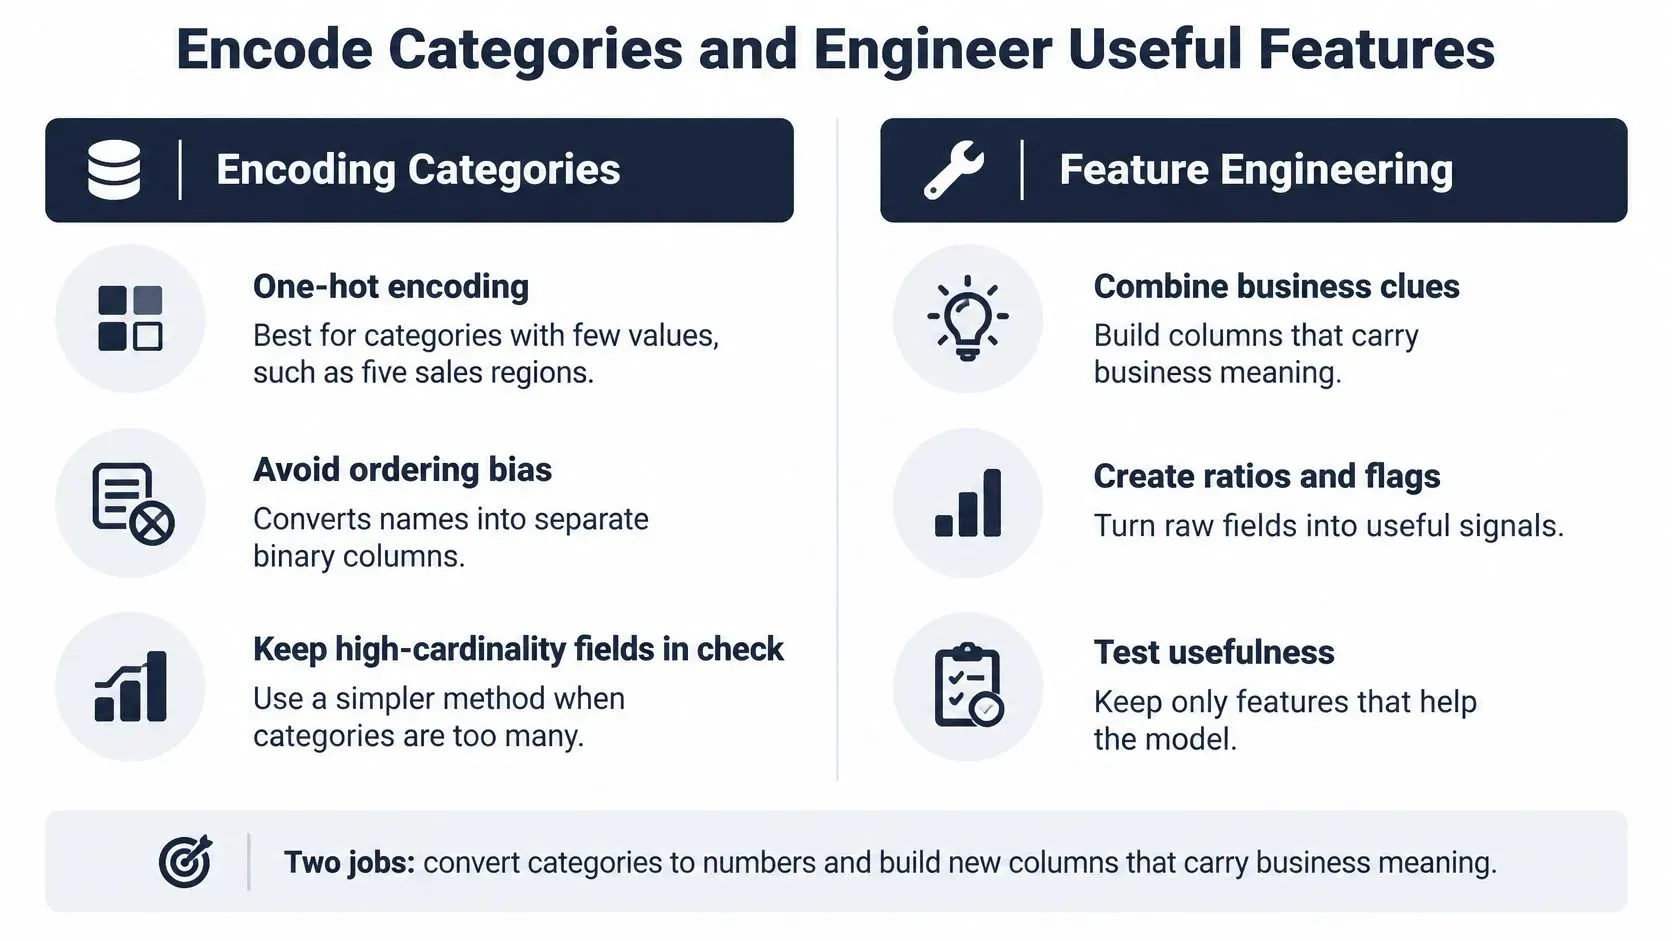
Có hai việc ở đây. Chuyển các nhãn thành số mà mô hình dùng được, và tạo các cột trả lời một câu hỏi kinh doanh mà các trường thô không trả lời được.
Mã hóa mà không tạo ra thứ hạng giả
Mã hóa one-hot phù hợp với biến phân loại có ít giá trị, chẳng hạn năm khu vực bán hàng. Mỗi khu vực trở thành một cột có/không riêng, và không khu vực nào "lớn hơn" khu vực khác.
Mã hóa thứ tự phù hợp khi có một thứ tự thật, chẳng hạn kích cỡ S, M và L. Các con số khớp với thứ hạng mà doanh nghiệp vốn đã dùng.
Đừng gán 1, 2, 3 cho các tên không có thứ tự như kênh bán hàng hay thành phố. Mô hình sẽ coi mã cao hơn là "nhiều hơn" về một điều gì đó. Thứ hạng giả này sau đó biểu hiện thành một hệ số sai nhưng đầy tự tin. Khi một trường có hàng trăm mức, one-hot tạo ra một bảng rất rộng. Hãy gộp các mức hiếm vào Other trước khi mã hóa, và chỉ học cách gộp này trên các dòng huấn luyện.
Các cột trả lời một câu hỏi kinh doanh
Hãy xây một danh sách ngắn gắn với một quyết định cụ thể, thay vì đổ vào mọi tỷ lệ mà bạn có thể nghĩ ra.
- Tỷ suất lợi nhuận:
(price − cost) / pricecho biết một đợt khuyến mãi có còn bù được giá vốn hay không, điều mà riêng doanh thu không cho thấy. - Số ngày kể từ lần mua cuối: một đợt rà soát tỷ lệ khách rời bỏ cần mức độ gần đây của giao dịch, chứ không cần thêm một bản sao của mã khách hàng.
- Thứ trong tuần và tháng: hoạt động lập kế hoạch nhu cầu cần biết các đợt tăng đột biến vào thứ Sáu và các tháng theo mùa vụ vốn ẩn trong một dấu thời gian đầy đủ.
- Trung bình trượt 7 ngày: số lượng bán mỗi ngày dao động mạnh. Trung bình theo tuần cho thấy nhu cầu có đang tăng hay không.
- Tỷ lệ tồn kho trên doanh số: người quản lý kho nhận ra tình trạng thiếu hàng đang hình thành sớm hơn so với khi chỉ nhìn số lượng tồn thô.
Tôi sẽ bắt đầu với mười đến mười lăm đặc trưng gắn với đúng một quyết định đó. Hãy bỏ một cột trong cặp có tương quan trên 0,95, vì cột thứ hai chỉ lặp lại cột đầu. Ghi ý nghĩa nghiệp vụ bên cạnh tên cột trong từ điển dữ liệu. Nếu bảng mã hóa hoặc trung bình trượt được học trên toàn bộ tệp, kể cả những dòng bạn định giữ lại để kiểm tra, thì bạn lặp lại đúng lỗi rò rỉ dữ liệu mà bạn đã chặn ở bước chia tập.
Chuẩn hóa thang đo số và xử lý ngoại lai
Một giá trị cực đoan không mặc nhiên là lỗi. Một đơn hàng 40 đơn vị từ tài khoản B2B là một giao dịch thật. Hãy gắn cờ để nó không chi phối giá trị trung bình, và giữ nó trong lịch sử. Còn đơn giá 100.000 do gõ nhầm thay cho 1.000 là lỗi nhập liệu. Hãy sửa lại chữ số, đừng "xử lý" nó như thể đó là nhu cầu.
Kiểm tra giá trị cực đoan trước khi xóa
Hai cách kiểm tra phối hợp với nhau rất tốt. Quy tắc 1,5 × khoảng tứ phân vị đánh dấu các điểm nằm xa phần giữa của cột. Kiểm tra theo nghiệp vụ thì hỏi liệu giá trị đó có thể tồn tại hay không: tồn kho âm, ngày nằm trong thập kỷ tới, mức giảm giá lớn hơn giá bán. Hãy xác minh trước. Sau đó giới hạn ở bách phân vị thứ 1 và thứ 99, áp dụng phép biến đổi logarit cho doanh thu lệch, hoặc thêm một cờ và giữ nguyên số gốc để phục vụ báo cáo.
Một đơn hàng số lượng lớn mà bạn xóa là doanh thu bạn sẽ không bao giờ dự báo được nữa. Một lỗi gõ mà bạn giữ lại sẽ trở thành mức giá mà mô hình tin rằng khách hàng sẽ trả.
Hãy chạy lại bảng thống kê tóm tắt sau khi giới hạn giá trị. Tâm của cột hầu như không nên thay đổi. Nếu trung vị nhảy mạnh, nghĩa là việc giới hạn đang làm quá nhiều và bạn nên xem lại các dòng dữ liệu nguồn.
Bộ chuẩn hóa nào phù hợp với đặc điểm dữ liệu
Chuẩn hóa thang đo giúp một cột có đơn vị lớn, như doanh thu hằng năm, không lấn át một cột có đơn vị nhỏ, như số đơn vị mỗi đơn hàng. Tài liệu về tiền xử lý của Scikit-learn nêu rằng StandardScaler căn giữa từng đặc trưng theo trung bình của tập huấn luyện và co giãn theo phương sai, và cách này có thể hoạt động kém khi có nhiều ngoại lai. RobustScaler là lựa chọn thay thế trực tiếp, dùng các ước lượng bền vững hơn cho tâm và biên độ.
Đặc điểm dữ liệu | Bộ chuẩn hóa | Lý do phù hợp |
|---|---|---|
Phân bố gần đối xứng, ít giá trị cực đoan | StandardScaler | Căn giữa theo trung bình và co giãn theo phương sai |
Nhiều ngoại lai, chẳng hạn các đơn hàng số lượng lớn thỉnh thoảng xuất hiện | RobustScaler | Dùng trung vị và khoảng tứ phân vị, vốn chịu được giá trị cực đoan |
Giá trị cần nằm trong một khoảng cố định, chẳng hạn điểm đánh giá từ 1 đến 5 | MinMaxScaler | Đưa giá trị về khoảng 0-1 mà không làm thay đổi hình dạng phân bố |
Chỉ fit bộ scaler trên dữ liệu huấn luyện, sau đó áp dụng chính phép fit đó cho tập validation. Nếu fit lại trên tập dữ liệu đã tách riêng, các dòng validation có giá trị cực đoan sẽ quyết định thang đo. Để tìm hiểu kỹ hơn cách phát hiện giá trị cực đoan trước khi chọn cách xử lý, hãy xem hướng dẫn về giá trị ngoại lai của ELECTE.
Tự động hóa quy trình và kiểm tra đầu ra
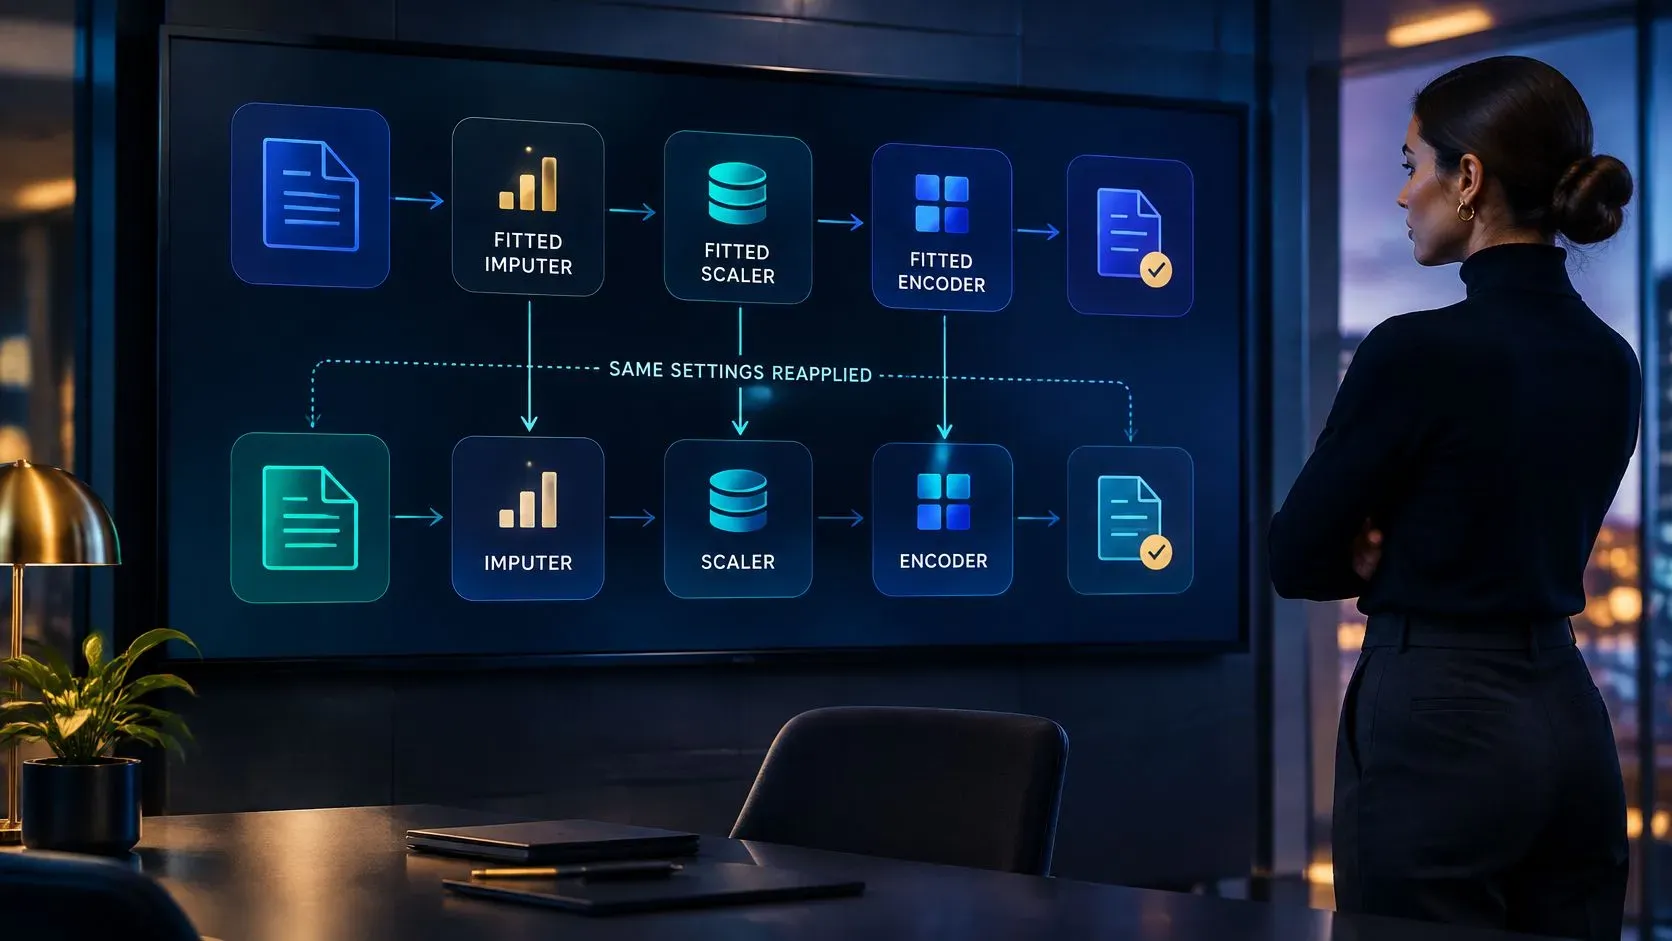
Một tệp đã làm sạch chỉ lưu trong một notebook có thể lệch dần giữa các lần chạy. Một tệp mới có thể nhận giá trị điền khuyết, cách mã hóa danh mục hoặc thang đo khác, khiến bảng điều khiển thay đổi dù hoạt động kinh doanh thực tế không đổi.
Một pipeline giữ các bộ điền khuyết, bộ mã hóa và bộ chuẩn hóa đã khớp cùng nhau, rồi áp dụng đúng các phép biến đổi đó cho tệp mới. Hãy khớp các bước này chỉ bằng phần dữ liệu huấn luyện. Áp dụng các thiết lập đã khớp cho dữ liệu kiểm định và kiểm thử mà không tính lại. Bài viết của IBM về rò rỉ dữ liệu giải thích vì sao việc khớp các bước tiền xử lý trên cả dữ liệu huấn luyện lẫn kiểm thử có thể làm rò rỉ thông tin vào quá trình đánh giá.
Những việc cần kiểm tra sau mỗi lần chạy
Một tác vụ chạy thành công chỉ xác nhận rằng quy trình đã chạy. Hãy kiểm tra xem đầu ra có còn khớp với nguồn và với các quy tắc bạn đã đặt hay không:
- Số dòng: đối chiếu tệp đã tải với bản xuất, có tính đến các bản ghi trùng lặp đã được ghi log.
- Tỷ lệ giá trị rỗng theo cột: hãy kiểm tra khi tỷ lệ này tăng đột ngột, vì có thể một trường dữ liệu nguồn đã ngừng được gửi về.
- Khoảng giá trị: kiểm tra xem giá, số lượng và ngày tháng có còn nằm trong giới hạn cho phép hay không.
- Danh mục mới: chuyển một khu vực hoặc SKU chưa từng thấy vào một nhóm đã định sẵn, thay vì loại bỏ mà không thông báo.
Để xem các ví dụ thực tế về kiểm định dữ liệu, hãy tham khảo cách áp dụng những bước kiểm tra này cho các tệp dữ liệu doanh nghiệp. Hãy coi kết quả tự động là ước tính, và rà soát thủ công vài chu kỳ đầu tiên trước khi dùng chúng để kích hoạt cảnh báo.
ELECTE, nền tảng phân tích dữ liệu ứng dụng AI dành cho các doanh nghiệp đang tăng trưởng, kết nối với phần mềm kế toán hoặc một tệp tải lên và thực hiện phân tích dữ liệu cũng như dự báo mà không cần đến nhà phân tích. Khách hàng tiết kiệm hơn 10 giờ mỗi tuần nhờ tự động hóa phân tích tài chính. Lợi ích đó phụ thuộc vào việc dùng các bước đã được huấn luyện (fit) mà bạn có thể bảo vệ trong buổi rà soát, thay vì tính lại chúng ở mỗi lần tải lên.
Trong tuần này, hãy lấy một tập dữ liệu và chạy qua bảng bảy dòng, rồi đánh dấu những bước vẫn đang làm thủ công. Hãy tự động hóa một bước lặp lại, nhưng vẫn giữ các quyết định cần phán đoán, chẳng hạn bản ghi trùng so với đơn đặt lại thật, hay lỗi gõ so với đơn hàng số lượng lớn, ở chế độ rà soát cho đến khi các quy tắc ổn định.
ELECTE kết nối với dữ liệu kế toán hoặc tệp bạn tải lên, chuẩn bị dữ liệu và biến chúng thành các bản dự báo và báo cáo để bạn cùng nhóm rà soát. Nếu bạn muốn các bước tiền xử lý dữ liệu này được áp dụng đồng nhất ở mỗi lần tải, hãy truy cập ELECTE và xem nền tảng vận hành quy trình đó trên chính số liệu của bạn.
Bình luận
Chưa có bình luận nào — hãy bắt đầu cuộc trò chuyện.