Etapele preprocesării datelor: cum să curățați datele de afaceri
Aflați care sunt etapele preprocesării datelor care transformă înregistrările de afaceri dezordonate în informații fiabile, cu exemple pentru IMM-uri. Vedeți cum le automatizează ELECTE.
Ați extras un export de vânzări care pare finalizat. Comenzile, costurile și datele umplu foaia. Apoi o prognoză ajunge pe biroul șefului de finanțe, iar valoarea medie a comenzii a crescut brusc, deși nimic nu s-a schimbat în catalog.
Un astfel de salt este adesea o eroare de preprocesare, nu o schimbare în comportamentul de cumpărare. Dacă completați prețurile lipsă în timp ce facturile duplicate sunt încă în fișier sau dacă scalați întregul extras înainte de a pune deoparte vreun rând, modelul învață lucruri pe care nu ar trebui să le știe încă. Majoritatea articolelor prezintă etapele preprocesării datelor ca tehnici separate, pe care le puteți aplica în orice ordine. Tocmai ordinea este cea care umflă rezultatele.
Mai jos găsiți secvența pe care o recomand atunci când un analist răspunde de un fișier de afaceri activ. Veți primi o ordine de lucru, pragurile pe care le tratez ca puncte de plecare, nu ca legi, și o metodă de a bloca fiecare setare ajustată, astfel încât următoarea încărcare de date să urmeze același parcurs.
Șapte etape de preprocesare a datelor, în ordinea corectă
Un export de vânzări poate părea complet și totuși să ascundă rânduri de facturi duplicate, costuri unitare necompletate și date stocate în două formate. Dacă remediați aceste probleme în ordinea greșită, fiecare medie ulterioară le moștenește.
Orice etapă care învață o valoare din date trebuie să ruleze după împărțire. O medie, o mediană sau un interval de scalare calculate pe întregul fișier permit rândurilor de validare să influențeze antrenarea. Scorul pare atunci mai bun decât va fi modelul pe comenzile lunii viitoare.
Etapa | Ce faceți | Este gata când |
|---|---|---|
1. Profilare și curățare | Verificați numărul de rânduri, tipurile de date și ratele de valori nule; eliminați duplicatele exacte; standardizați datele calendaristice și etichetele | Tabel de bază curat, cu o singură etichetă pentru fiecare categorie |
2. Împărțirea datelor | Amestecați rândurile, apoi împărțiți-le în seturi de antrenare și de validare | Există două seturi și nu s-a calculat încă nicio setare învățată |
3. Tratarea valorilor lipsă | Eliminați rândurile, eliminați variabila sau imputați folosind doar datele de antrenare | Fiecare câmp este complet sau golurile lui sunt marcate |
4. Codificare și ingineria variabilelor | Convertiți categoriile în numere; construiți rapoarte, componente de timp și medii mobile | Un tabel de variabile pregătit pentru model, cu coloane documentate |
5. Tratarea valorilor extreme | Verificați valorile extreme, apoi plafonați-le, transformați-le sau marcați-le | Valorile extreme sunt explicate, nu presupuse |
6. Scalarea variabilelor numerice | Ajustați un scalator pe datele de antrenare și aplicați-l pe datele de validare | Coloanele numerice se încadrează în intervale comparabile |
7. Blocarea fluxului de procesare | Salvați fiecare transformare ajustată, astfel încât datele noi să urmeze același parcurs | O rulare repetabilă, care funcționează la fiecare nouă încărcare de date |
Să spunem că un retailer are 12.000 de linii de comandă, dintre care 900 sunt rânduri de facturi duplicate. Dacă imputați prețurile lipsă înainte de a elimina aceste duplicate, aceeași factură este numărată de două ori, iar media se îndepărtează de lista de prețuri.
Regulă practică: Terminați rândul la care lucrați înainte de a calcula ceva de care are nevoie rândul următor.
Suprapuneți fișierul pe care îl aveți deschis peste cele șapte rânduri. Primul rând pe care nu l-ați terminat este singurul la care merită să lucrați astăzi.
Profilarea și curățarea datelor de business brute
Profilarea este o trecere de o oră pe care un manager o poate încheia înainte ca cineva să deschidă un model. Păstrați fișierul brut neatins și scrieți fiecare modificare într-un jurnal de curățare, astfel încât un responsabil financiar să vadă de ce s-a schimbat un total.
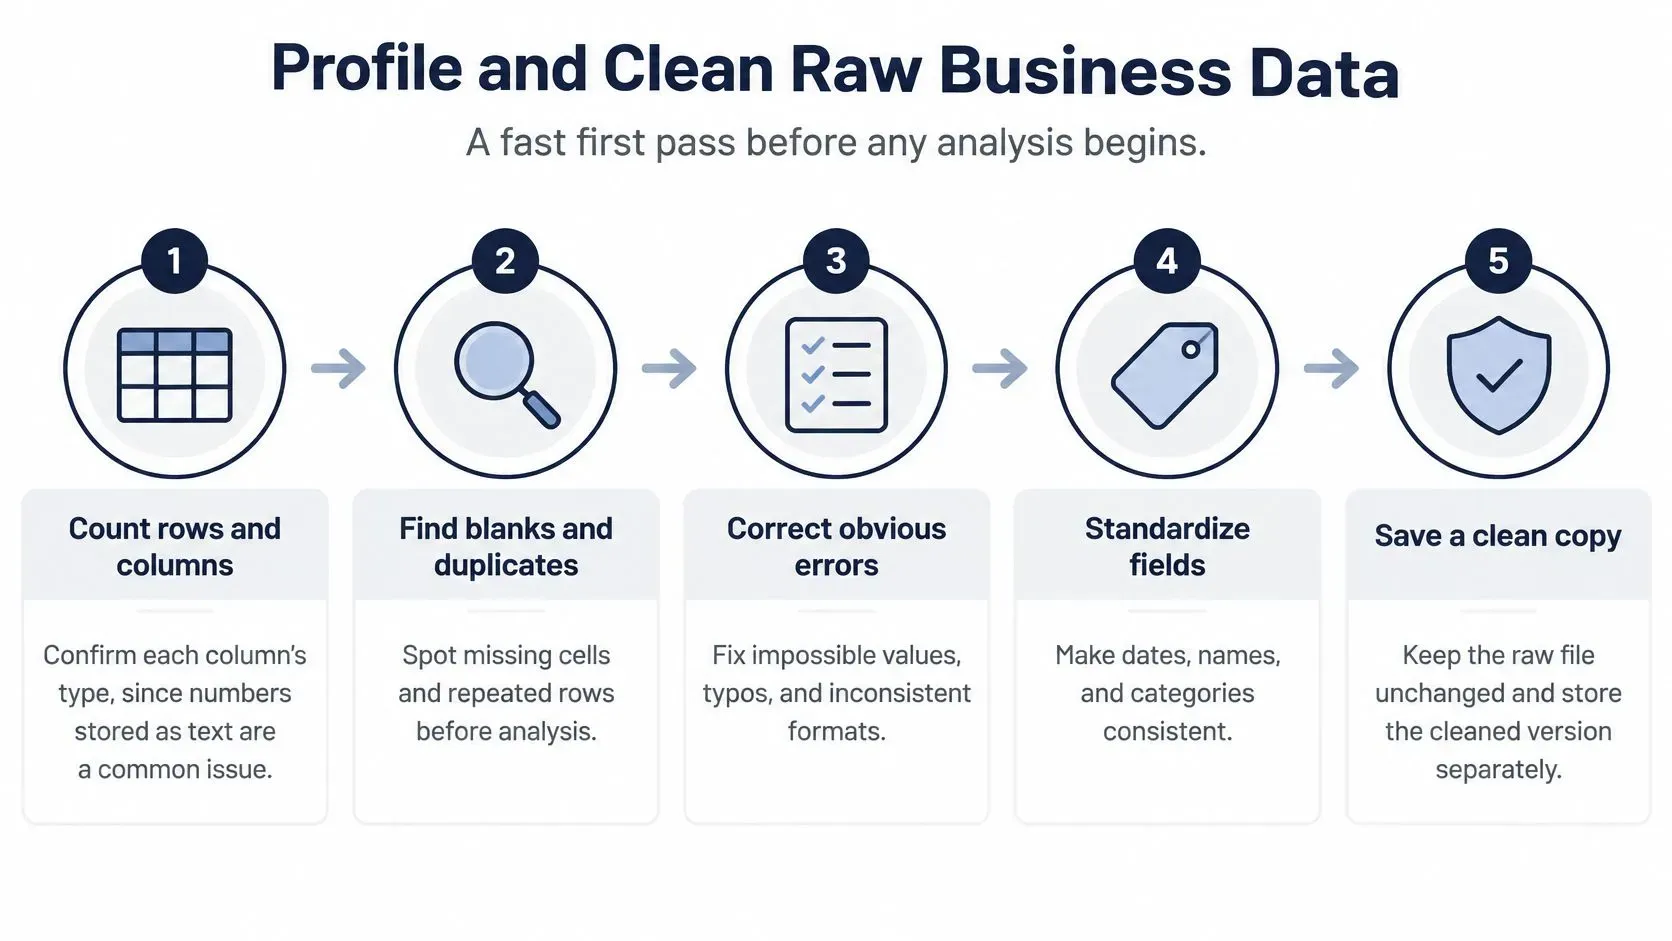
- Numărați rândurile și coloanele, apoi confirmați tipul fiecăreia. Un cost stocat ca text nu se va aduna și nu va da o eroare vizibilă. Convertiți-l înainte de a vă baza pe un total.
- Calculați rata de valori nule pentru fiecare coloană. O coloană cu peste 30% celule goale trece la regulile pentru valori lipsă, nu la o completare rapidă. Eu aș elimina o coloană complet doar când golurile depășesc 50% și câmpul nu este necesar pentru decizie.
- Eliminați duplicatele exacte, nu pe cele asemănătoare. Potriviți după numărul facturii, dată și sumă, luate împreună. O a doua comandă cu un alt ID de linie este o vânzare reală. Ștergerea ei pentru că se potrivesc clientul și ziua este greșeala care subestimează veniturile.
- Normalizați formatele într-o singură trecere. Un singur model de dată, o singură monedă pe coloană și fără spații în plus în coduri. Formatele mixte împart un produs în două serii și strică orice îmbinare ulterioară.
- Standardizați etichetele categoriilor.
UK,U.K.șiUnited Kingdomreprezintă o singură piață. Patru variante de scriere pentru o linie de produse într-un export de e-commerce pe trei ani fac același rău. Alegeți o etichetă și mapați restul la ea.
Să spunem că același export stochează datele comenzilor ca 2024-03-01 într-un an și ca 01/03/2024 în altul. Până când ambele devin un singur model, un grafic lunar numără martie de două ori sau o omite.
Ce protejează jurnalul și eliminarea datelor personale
Jurnalul de curățare este un tabel scurt: coloană, regulă, rânduri modificate, persoană, dată. Când finanțele întreabă de ce a scăzut martie anul trecut, indicați regula pentru duplicate în loc să reconstruiți fișierul din memorie.
Înainte ca fișierul să ajungă la orice platformă de analiză, eliminați numele clienților, adresele de e-mail și datele de plată. Nu aveți nevoie de ele pentru a prognoza cererea, iar lăsarea lor în extras creează o problemă de confidențialitate pe care un model nu o poate repara.
Dacă vă doriți o a doua părere despre cum arată „bine” pentru extrasele comerciale, analizele Pipecorn despre calitatea datelor de vânzări sunt o listă de verificare utilă pentru identificatori, completitudine și consecvență. Folosiți-le pentru a decide ce coloane merită păstrate, apoi reveniți la pragul ratei de valori nule de mai sus.
Împărțiți datele înainte de orice învățare
Împărțirea este un gard. Nimic care estimează o statistică nu are ce căuta pe fișierul întreg.
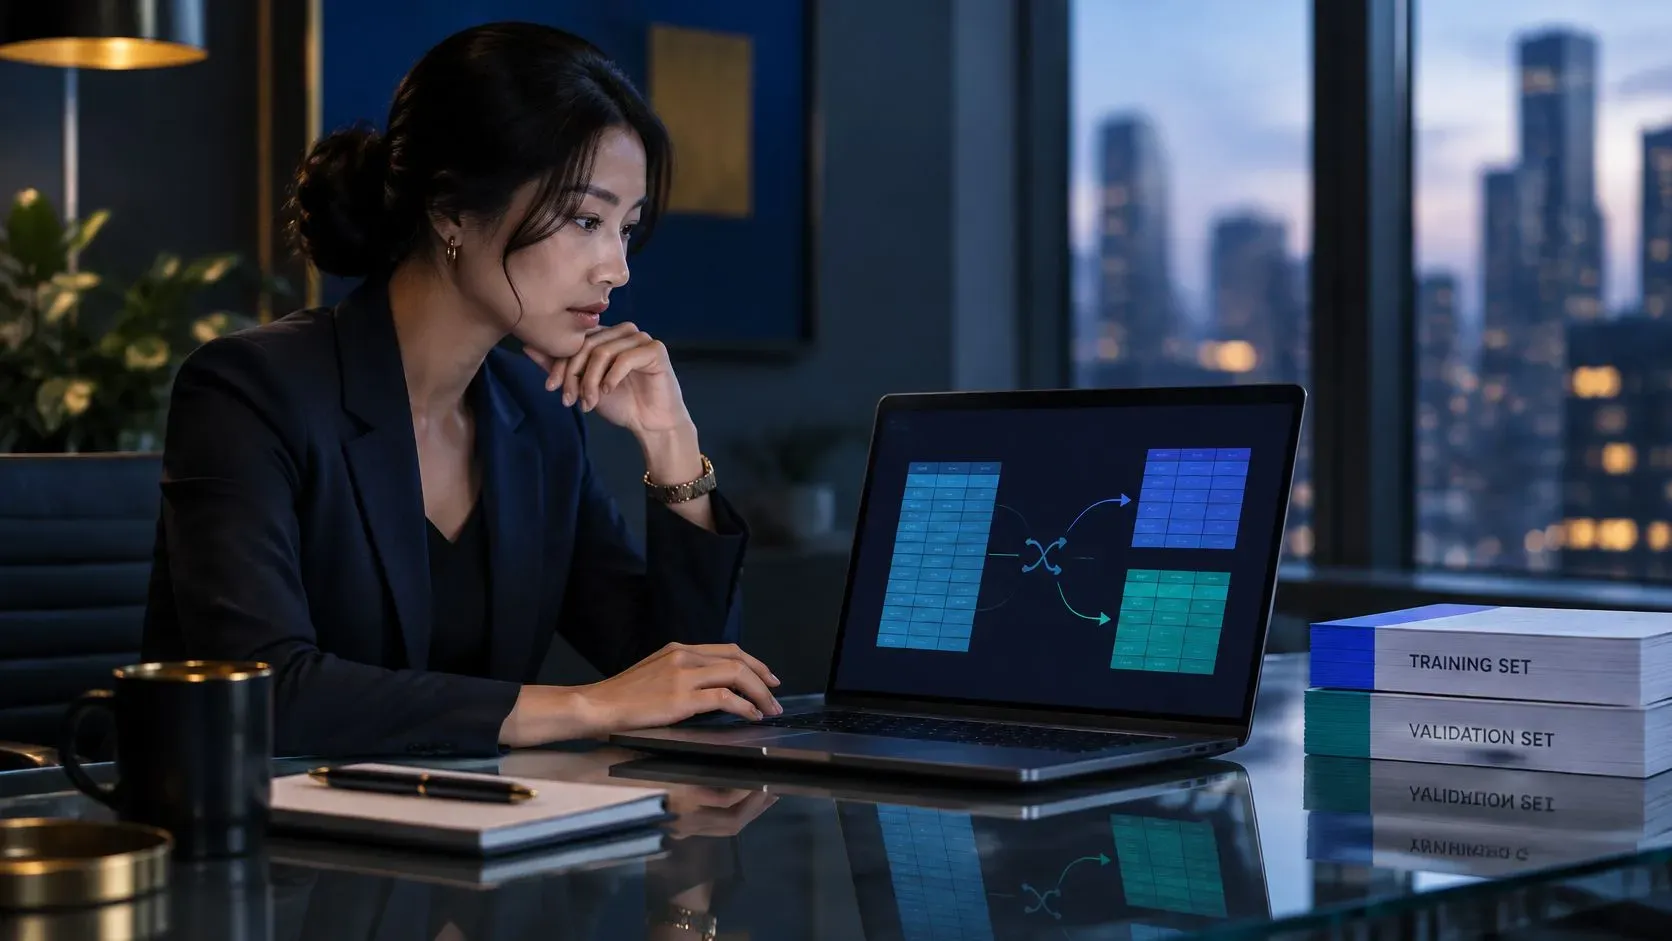
Pentru clasificarea supervizată a textelor, ghidul Google pentru clasificarea textelor recomandă amestecarea înainte de împărțire, deoarece păstrarea ordinii inițiale poate introduce o părtinire în ambele seturi. După amestecare, o împărțire tipică pune 80% dintre exemple în antrenare și 20% în validare. Aceleași transformări se aplică apoi ambelor seturi, dar numai după ce au fost învățate pe rândurile de antrenare.
De ce minte un fișier de vânzări sortat
Exporturile sosesc adesea sortate după dată, regiune sau client. Dacă împărțiți un astfel de fișier de sus în jos, antrenați pe 2023 și validați pe finalul lui 2024. Scorul urmărește atunci calendarul, calendarul promoțiilor sau structura unei singure regiuni. Nu vă spune dacă modelul a înțeles comenzile.
Amestecați când fiecare rând este un caz independent: o comandă încheiată, un cont pierdut, un tichet clasificat. Nu amestecați când întrebarea este o prognoză.
Păstrați ordinea în timp pentru prognoze. Antrenați pe lunile anterioare și testați pe lunile ulterioare. O amestecare ar lăsa modelul să vadă viitorul și să numească asta abilitate.
Câmpurile de text necesită o tăiere după frecvență
Tichetele de suport și descrierile de produse se transformă în mii de tokeni. În același flux de lucru Google, eliminați tokenii care apar de mai puțin de două ori, păstrați primele 20.000 de caracteristici de tip token și ordonați ce rămâne cu un scor de importanță bazat pe testul F. Un token care apare o singură dată este de obicei o greșeală de scriere sau un SKU unic, nu un tipar care merită o coloană.
După împărțire, ajustați fiecare mapare doar pe datele de antrenare, apoi aplicați acea mapare înghețată pe validare. Recalcularea unui vocabular sau a unei liste de categorii pe rândurile rezervate este o altă cale prin care răspunsul se scurge în pregătirea datelor.
Completați valorile lipsă fără a distorsiona rezultatele
Cât de des este gol un câmp și dacă decizia are nevoie de acel câmp stabilesc acțiunea. Intervalele de mai jos sunt o regulă practică, nu o lege. Un model de risc reglementat poate refuza eliminarea unor rânduri pe care o prognoză de retail și le poate permite.
Pondere valori lipsă | Importanța variabilei | Acțiune |
|---|---|---|
Sub 5% | Oricare | Elimină acele rânduri dacă rămân suficiente date |
5% – 30% | Scăzută | Elimină variabila |
5% – 30% | Ridicată | Imputează folosind doar rândurile de antrenare |
Peste 30% | Ridicată | Imputează, adaugă o coloană-indicator pentru valori lipsă și investighează de ce câmpul este gol |
Peste 30% | Scăzută | Elimină variabila |
Câteva costuri necompletate într-un fișier de comenzi altfel complet reprezintă primul rând. Ștergerea acestor linii face mai puțin rău decât inventarea unui preț. Un câmp de sondaj folosit rar, din banda de mijloc, nu merită o completare cu o simplă presupunere, așa că This coloana dispare. Vechimea clientului, pe care o folosești pentru analiza abandonului, rămâne și o estimezi.
Ghidul Google despre pregătirea datelor pentru clustering menționează trei opțiuni practice: eliminarea exemplelor care conțin valori lipsă, eliminarea variabilei sau prezicerea valorilor lipsă pe baza altor date. Lipsurile rare pot justifica ștergerea rândurilor. Lipsurile frecvente înseamnă, de obicei, că elimini variabila sau o imputezi.
Prezice valoarea lipsă în loc să lipești o constantă
Pentru un câmp numeric, antrenează o regresie pe rândurile în care valoarea există, apoi estimează valorile lipsă. Vârsta lipsă a unui client, de exemplu, poate fi estimată din venit și vechime, în loc să fie înlocuită cu o singură medie la nivel de companie. Astfel folosești relații în care deja ai încredere.
Valoarea comenzii este asimetrică. Câteva comenzi mari de la angrosiști trag în sus media, așa că o completare cu media face coșurile obișnuite să pară mai valoroase decât sunt. Mediana rămâne aproape de comanda tipică și se mișcă mai puțin atunci când apare o factură de volum mare. Compară statisticile descriptive înainte și după completare. O schimbare mare arată că metoda rescrie afacerea, nu doar astupă o gaură.
La categorii, etichetează valoarea lipsă cu Unknown. Lipsa este adesea chiar semnalul: o finalizare a comenzii care nu a captat regiunea sau un produs fără cod de furnizor. Transformarea ei într-un nivel real păstrează rândul și arată modelului căGol-ul din câmp are un sens.
Valorile lipsă frecvente nu sunt o raritate în operațiuni. Un studiu din 2025 despre date incomplete privind consumul de apă descrie un set de date pentru clădiri cu 33.888 de înregistrări orare, din februarie 2019 până în decembrie 2023, cu valori lipsă în 20% dintre ore, adică în banda în care eliminarea în bloc a rândurilor ar arunca prea mult din istoric (studiul).
Antrenează imputatorul doar pe rândurile de antrenare. Ghidul ELECTE despre datele lipsă detaliază mai mult opțiunile de imputare, dacă vrei o a doua trecere asupra metodei, nu asupra ordinii.
Codifică categoriile și creează variabile utile
Aici sunt două sarcini. Transformă etichetele în numere pe care modelul le poate folosi și construiește coloane care răspund unei întrebări de business la care câmpurile brute nu răspund.
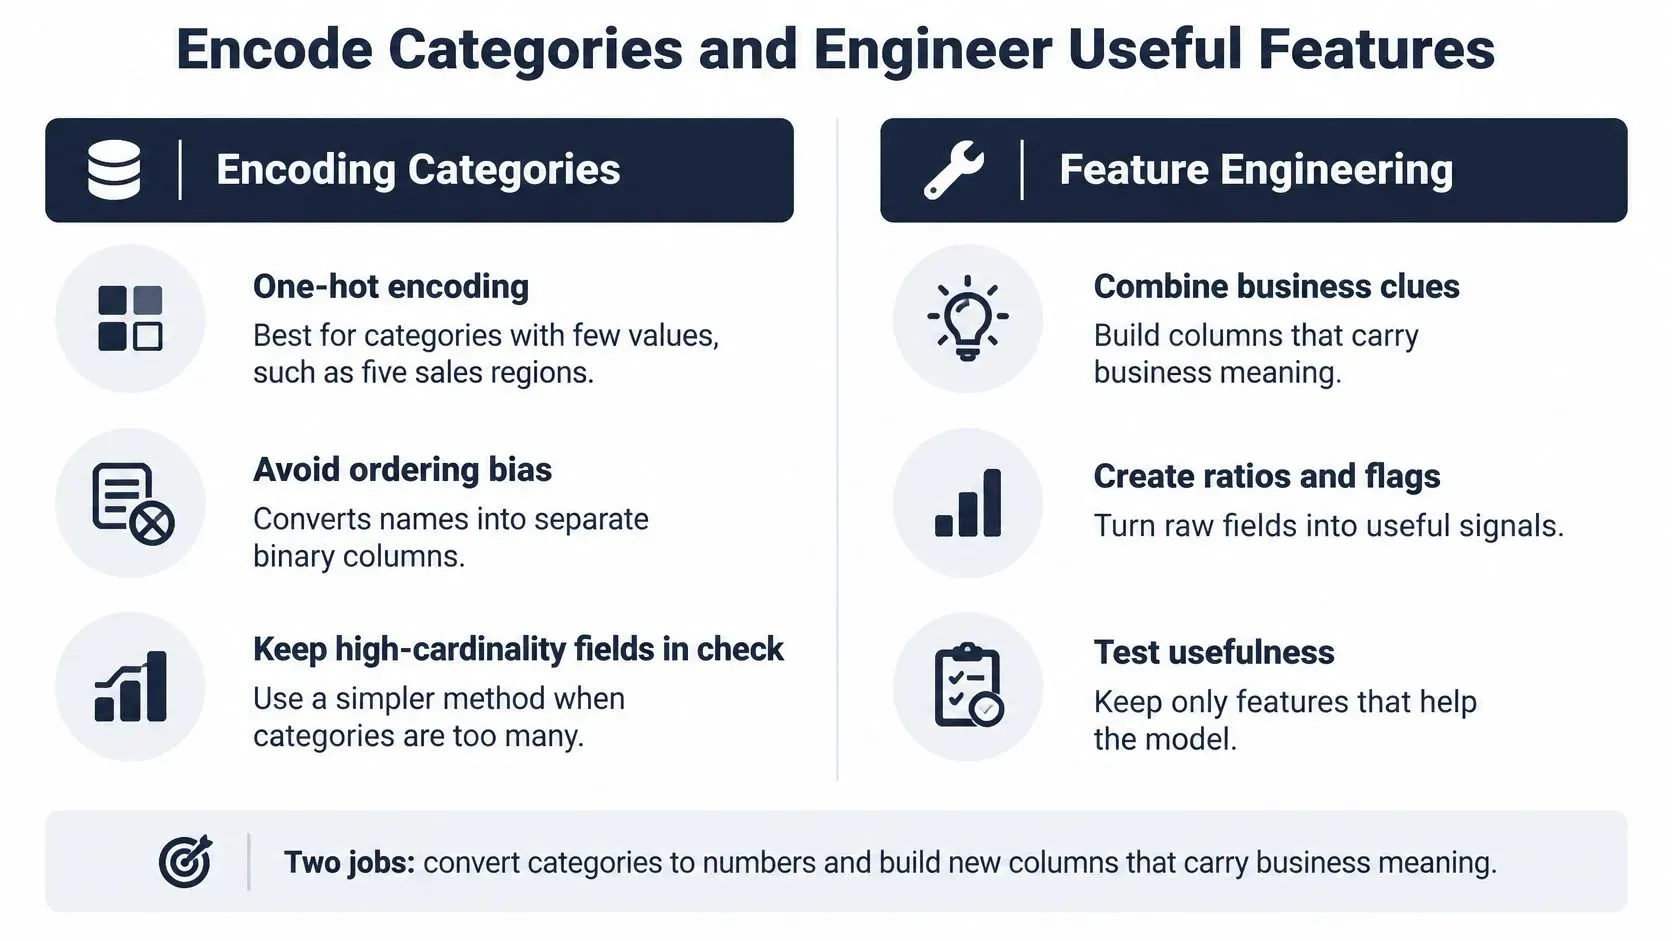
Codificare fără un clasament fals
Codificarea one-hot se potrivește categoriilor cu puține valori, precum cinci regiuni de vânzări. Fiecare regiune devine propria coloană da/nu, iar nicio regiune nu este „mai mare” decât alta.
Codificarea ordinală se potrivește unei ordini reale, precum mărimile S, M și L. Numerele corespund unui clasament pe care afacerea îl folosește deja.
Nu atribui 1, 2, 3 unor nume fără ordine, precum canalul sau orașul. Modelul va trata un cod mai mare ca însemnând mai mult din ceva. Acel clasament fals apare mai târziu sub forma unui coeficient sigur pe el, dar greșit. Când un câmp are sute de niveluri, one-hot creează un tabel foarte lat. Grupează nivelurile rare în Other înainte de codificare și învață această grupare doar pe rândurile de antrenare.
Coloane care răspund unei întrebări de business
Construiește o listă scurtă, legată de o singură decizie, nu o grămadă cu toate rapoartele pe care le poți scrie.
- Procentul de marjă:
(price − cost) / pricearată dacă o promoție încă acoperă costul, lucru pe care veniturile singure nu îl arată. - Zile de la ultima achiziție: o analiză a pierderii de clienți are nevoie de recență, nu de încă o copie a ID-ului clientului.
- Ziua săptămânii și luna: planificarea cererii ține cont de vârfurile de vineri și de lunile sezoniere ascunse într-un timestamp complet.
- Media mobilă pe 7 zile: unitățile zilnice fluctuează mult. Media pe o săptămână arată dacă cererea crește.
- Raportul stoc-vânzări: un manager de inventar observă mai devreme un deficit în formare decât îi permite un simplu stoc disponibil.
Aș începe cu zece până la cincisprezece caracteristici legate de acea singură decizie. Elimină una dintre coloane când două coloane corelează peste 0,95, pentru că a doua o repetă pe prima. Scrie sensul de business lângă numele coloanei în dicționarul de date. O hartă de codificare sau o medie mobilă învățate pe întregul fișier, inclusiv pe rândurile pe care voiai să le păstrezi separat, repetă scurgerea de date pe care ai blocat-o deja la împărțire.
Scalează numerele și gestionează valorile extreme
O valoare extremă nu este automat o greșeală. O comandă de 40 de unități de la un cont B2B este o vânzare reală. Marchează-o ca să nu domine o medie și las-o în istoric. Un preț unitar de 100.000 introdus în loc de 1.000 este o eroare de introducere. Corectează cifra, nu o "trata" ca pe cerere.
Verifică valoarea extremă înainte să o ștergi
Două verificări funcționează bine împreună. Regula 1,5 × intervalul intercuartilic marchează punctele aflate departe de mijlocul coloanei. O verificare de domeniu întreabă dacă valoarea poate exista: stoc negativ, o dată din deceniul următor, un discount mai mare decât prețul de vânzare. Verifică mai întâi. Apoi limitează la percentilele 1 și 99, aplică o transformare logaritmică la veniturile asimetrice sau adaugă un indicator și păstrează valoarea brută pentru raportare.
O comandă en-gros pe care o ștergi este venit pe care nu îl vei mai putea prognoza. O greșeală de tastare pe care o păstrezi devine un preț pe care modelul crede că îl vor plăti clienții.
Rulează din nou sumarul după limitare. Centrul coloanei ar trebui să se miște foarte puțin. Dacă mediana sare, limita face prea mult și ar trebui să te uiți din nou la rândurile sursă.
Ce scaler se potrivește profilului
Scalarea împiedică o coloană în unități mari, cum ar fi venitul anual, să o acopere pe una în unități mici, cum ar fi unitățile pe comandă. Documentația de preprocesare Scikit-learn arată că StandardScaler centrează fiecare caracteristică pe media setului de antrenare și o scalează după varianță, iar rezultatele pot fi slabe când există multe valori extreme. RobustScaler este alternativa directă care folosește estimări mai rezistente ale centrului și ale intervalului.
Profilul datelor | Scaler | De ce se potrivește |
|---|---|---|
Aproximativ simetric, puține valori extreme | StandardScaler | Centrează pe medie și scalează după varianță |
Valori extreme numeroase, de exemplu comenzi en-gros ocazionale | RobustScaler | Folosește mediana și intervalul intercuartilic, care rezistă extremelor |
Valorile necesită un interval fix, de exemplu note de la 1 la 5 | MinMaxScaler | Mapează valorile între 0 și 1 fără a le schimba forma |
Ajustați scaler-ul (fit) doar pe datele de antrenare, apoi aplicați acel fit pe setul de validare. Reajustarea pe setul de test rezervat lasă rândurile extreme din validare să stabilească scala. Pentru o privire mai atentă asupra identificării valorilor extreme înainte de a alege un tratament, consultați ghidul ELECTE despre valori aberante.
Automatizează pipeline-ul și verifică rezultatele
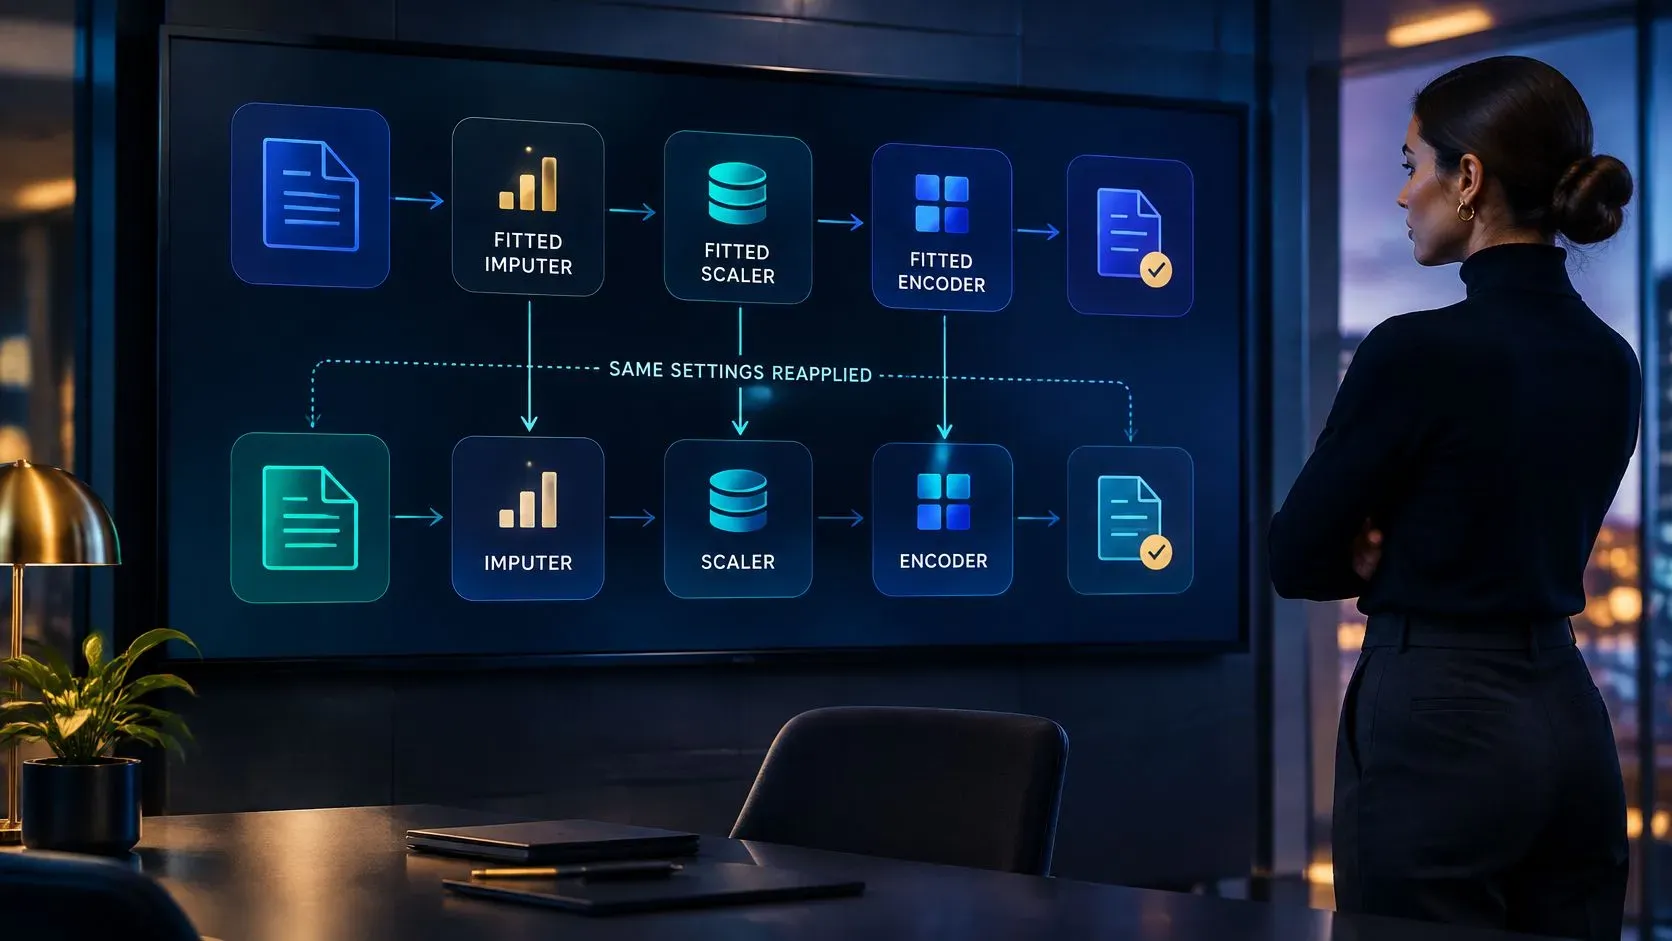
Un fișier curățat, păstrat într-un singur notebook, poate deriva de la o rulare la alta. Un fișier nou poate primi altă valoare de imputare, altă codificare a categoriilor sau altă scală, iar un dashboard se poate schimba chiar dacă afacerea de fond nu s-a schimbat.
Un pipeline păstrează împreună imputerul, encoderul și scalerul ajustate, apoi aplică aceleași transformări fișierelor noi. Ajustează acești pași folosind doar partiția de antrenare. Aplică setările ajustate pe datele de validare și de test fără a le recalcula. Nota IBM despre scurgerea de date explică de ce ajustarea pașilor de preprocesare pe datele de antrenare și de test la un loc poate scurge informații în evaluare.
Verificări după fiecare rulare
Un job reușit confirmă doar că procesul a rulat. Verifică dacă rezultatul se potrivește în continuare cu sursa și cu regulile pe care le-ai stabilit:
- Numărul de rânduri: reconciliați fișierul încărcat cu exportul, ținând cont de duplicatele înregistrate în jurnal.
- Rata de valori nule pe coloană: investigați o creștere bruscă, care poate însemna că un câmp din sursă nu mai este primit.
- Intervalele de valori: verificați că prețurile, cantitățile și datele rămân în limitele acceptate.
- Categorii noi: direcționați o regiune sau un SKU nou către un grup definit, în loc să le eliminați fără notificare.
Pentru exemple practice de validare a datelor, vedeți cum se aplică aceste verificări fișierelor de business. Tratați rezultatele automate drept estimări și revizuiți manual primele cicluri înainte de a le folosi pentru a declanșa alerte.
ELECTE, o platformă de analiză a datelor bazată pe AI pentru companii aflate în creștere, se conectează la software-ul de contabilitate sau la un fișier încărcat și realizează analiza datelor și previziuni fără să necesite un analist. Clienții economisesc peste 10 ore pe săptămână prin automatizarea analizei financiare. Acest ajutor depinde de utilizarea unor pași calibrați pe care îi puteți justifica într-o revizuire, în loc să îi recalculați la fiecare încărcare.
Săptămâna aceasta, luați un set de date și parcurgeți-l prin tabelul cu șapte rânduri, marcând pașii care sunt încă manuali. Automatizați un pas repetat, dar păstrați sub revizuire deciziile care cer discernământ, precum un duplicat față de o reaprovizionare reală sau o greșeală de tastare față de o comandă în volum mare, până când regulile devin stabile.
ELECTE se conectează la datele dvs. contabile sau la un fișier încărcat, le pregătește și le transformă în previziuni și rapoarte pe care le puteți analiza împreună cu echipa. Dacă doriți ca acești pași de preprocesare a datelor să fie aplicați identic la fiecare încărcare, vizitați ELECTE și vedeți cum rulează platforma acest flux pe cifrele dvs.
Comentarii
Niciun comentariu încă — începe conversația.