Stappen voor datapreprocessing: zo maak je bedrijfsdata schoon
Ontdek de stappen voor datapreprocessing waarmee rommelige bedrijfsgegevens betrouwbare inzichten opleveren, met voorbeelden voor mkb-bedrijven. Zie hoe ELECTE ze automatiseert.
Je hebt een verkoopexport opgehaald die er af uitziet. Orders, kosten en datums vullen het werkblad. Dan komt er een forecast op het bureau van de financieel manager te liggen en blijkt de gemiddelde orderwaarde gestegen, terwijl er niets in de catalogus is veranderd.
Die stijging is vaak een preprocessingfout en geen verandering in koopgedrag. Als je lege prijzen invult terwijl dubbele facturen nog in het bestand staan, of als je het hele extract schaalt voordat je rijen apart zet, leert het model feiten die het nog niet mag kennen. De meeste artikelen presenteren stappen voor datapreprocessing als losse technieken die je in willekeurige volgorde toepast. Juist de volgorde blaast resultaten op.
Hieronder staat de volgorde die ik aanraad wanneer een analist een actief bedrijfsbestand beheert. Je krijgt een uitvoervolgorde, de drempelwaarden die ik als uitgangspunt zie en niet als wet, en een manier om elke gefitte instelling vast te leggen, zodat de volgende dataload hetzelfde pad volgt.
Zeven stappen voor datapreprocessing in de juiste volgorde
Een verkoopexport kan er compleet uitzien en toch dubbele factuurregels, lege eenheidskosten en datums in twee formaten verbergen. Ruim je die problemen in de verkeerde volgorde op, dan erft elk later gemiddelde ze mee.
Elke stap die een getal uit de data leert, moet na de split worden uitgevoerd. Een gemiddelde, een mediaan of een schaalbereik dat op het volledige bestand is berekend, laat validatierijen de training beïnvloeden. De score ziet er dan sterker uit dan het model volgende maand op nieuwe orders zal zijn.
Stap | Wat je doet | Klaar wanneer |
|---|---|---|
1. Profileren en opschonen | Controleer aantallen rijen, datatypen en null-percentages; verwijder exacte duplicaten; standaardiseer datums en labels | Schone basistabel met één label per categorie |
2. De data splitsen | Schud de rijen en verdeel ze in een trainingsset en een validatieset | Er zijn twee sets en er zijn nog geen geleerde instellingen berekend |
3. Ontbrekende waarden afhandelen | Verwijder rijen, verwijder het kenmerk of vul aan (imputatie) met alleen trainingsdata | Elk veld is compleet of de gaten zijn gemarkeerd |
4. Coderen en features ontwikkelen | Zet categorieën om in getallen; bouw ratio's, tijdcomponenten en voortschrijdende gemiddelden | Een modelklare featuretabel met gedocumenteerde kolommen |
5. Uitschieters behandelen | Controleer extreme waarden en begrens, transformeer of markeer ze | Extreme waarden zijn verklaard, niet geraden |
6. Numerieke features schalen | Fit een scaler op trainingsdata en pas die toe op validatiedata | Numerieke kolommen liggen in vergelijkbare bereiken |
7. De pipeline vastleggen | Sla elke gefitte transformatie op, zodat nieuwe data hetzelfde pad volgt | Een herhaalbare run die bij elke nieuwe dataload werkt |
Stel dat een retailer 12.000 orderregels heeft, waaronder 900 dubbele factuurrijen. Als je ontbrekende prijzen invult voordat je die duplicaten verwijdert, telt dezelfde factuur dubbel mee en wijkt het gemiddelde af van de prijslijst.
Praktische regel: Maak de rij waar je mee bezig bent af voordat je iets berekent wat de volgende rij nodig heeft.
Leg het bestand dat je nu open hebt naast die zeven rijen. De eerste rij die je nog niet hebt afgerond is de enige die vandaag aandacht verdient.
Ruwe bedrijfsdata profileren en opschonen
Profileren is een klus van een uur die een manager kan afronden voordat iemand een model opent. Laat het ruwe bestand ongewijzigd en leg elke aanpassing vast in een opschoonlogboek, zodat een financieel verantwoordelijke kan zien waarom een totaal is verschoven.
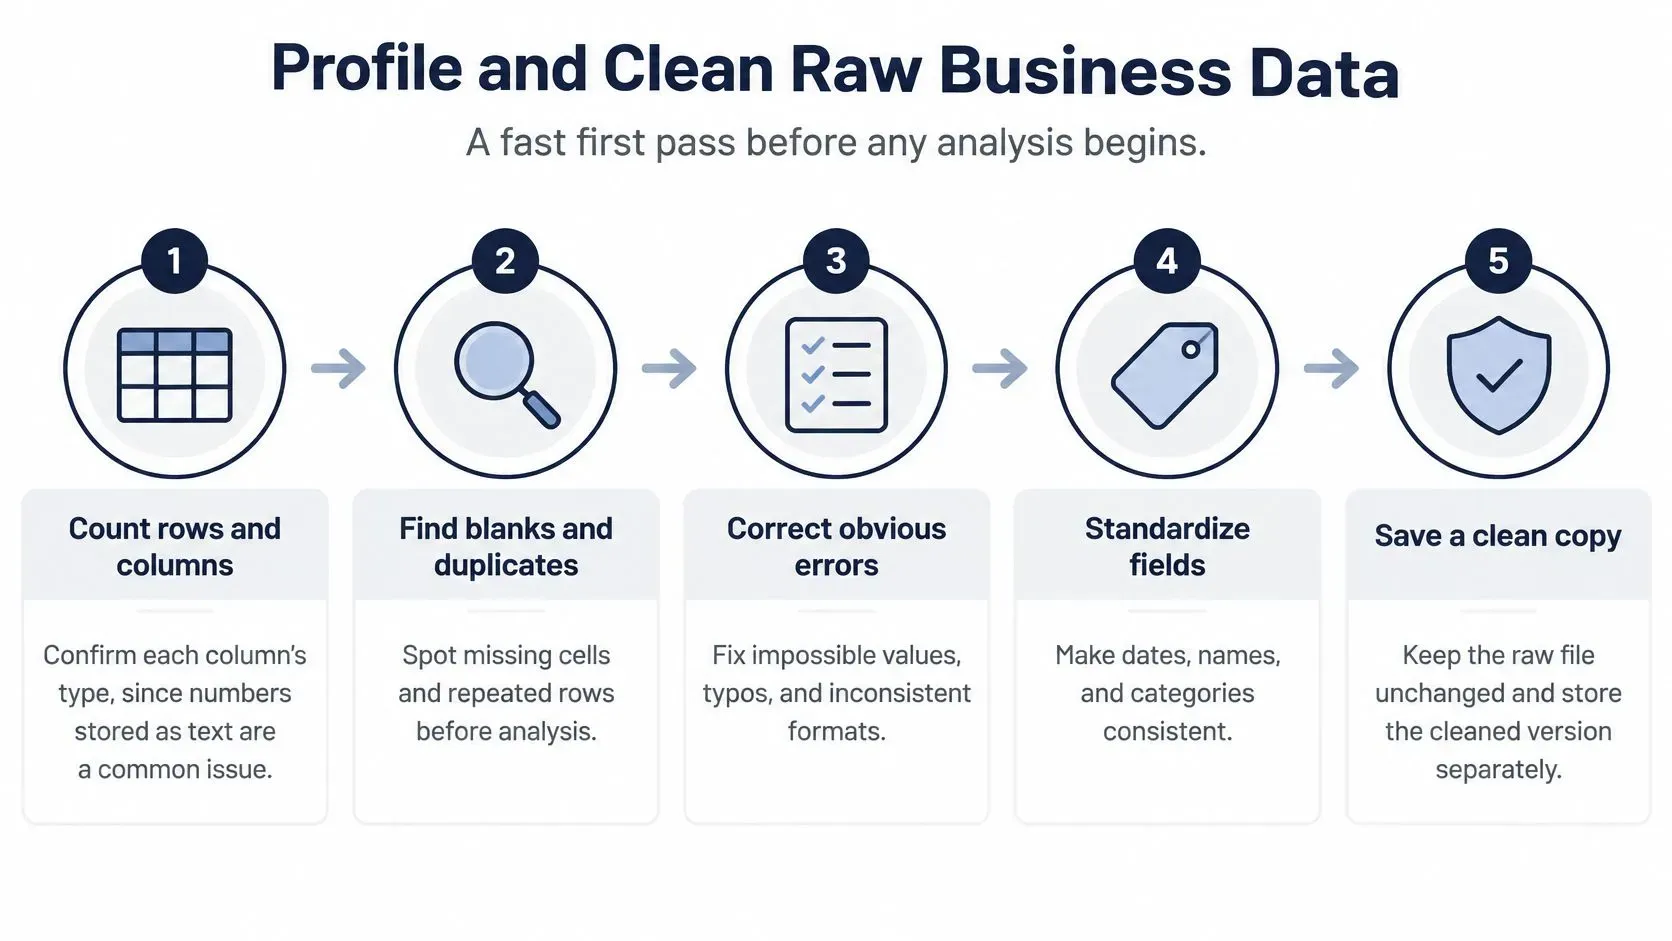
- Tel rijen en kolommen en controleer dan elk type. Een kostenbedrag dat als tekst is opgeslagen telt niet op, en geeft ook geen duidelijke foutmelding. Zet het om voordat je een totaal vertrouwt.
- Bereken het percentage lege waarden per kolom. Een kolom met meer dan 30% lege cellen gaat naar de regels voor ontbrekende waarden in plaats van naar een snelle invulling. Ik zou een kolom alleen volledig schrappen als meer dan 50% leeg is en het veld niet nodig is voor de beslissing.
- Verwijder exacte duplicaten, geen gelijkenissen. Vergelijk op factuurnummer, datum en bedrag samen. Een tweede order met een ander regel-ID is een echte verkoop. Die verwijderen omdat klant en dag overeenkomen is de misstap die de omzet te laag laat uitvallen.
- Normaliseer formaten in één keer. Eén datumnotatie, één valuta per kolom en geen losse spaties in codes. Gemengde formaten splitsen één product in twee reeksen en breken elke latere koppeling.
- Standaardiseer categorielabels.
UK,U.K.enUnited Kingdomzijn één markt. Vier schrijfwijzen van één productlijn in een e-commerce-export van drie jaar richten dezelfde schade aan. Kies één label en wijs de rest daaraan toe.
Stel dat diezelfde export orderdatums in het ene jaar opslaat als 2024-03-01 en in een ander jaar als 01/03/2024. Zolang beide niet in één notatie staan, telt een maandgrafiek maart dubbel of laat die maand weg.
Wat het logboek en de privacyfilter beschermen
Het opschoonlogboek is een korte tabel: kolom, regel, aantal gewijzigde rijen, persoon, datum. Als finance vraagt waarom vorige maart kleiner werd, wijs je naar de duplicatenregel in plaats van het bestand uit je geheugen te reconstrueren.
Haal klantnamen, e-mailadressen en betaalgegevens weg voordat het bestand in een analyseplatform terechtkomt. Je hebt ze niet nodig om de vraag te voorspellen, en als ze in de extractie blijven staan, ontstaat er een privacyprobleem dat een model niet meer kan herstellen.
Wil je een second opinion over hoe "goed" eruitziet voor commerciële extracties, dan vormen de inzichten over verkoopdatakwaliteit van Pipecorn een nuttige checklist voor identificatoren, volledigheid en consistentie. Gebruik ze om te bepalen welke kolommen het behouden waard zijn en ga dan terug naar de bovenstaande afkap op basis van lege waarden.
Splits de data voordat er iets wordt geleerd
De splitsing is een hek. Niets wat een statistiek schat, hoort op het volledige bestand te draaien.
Voor gesuperviseerde tekstclassificatie raadt de tekstclassificatiegids van Google aan om voor de splitsing te schudden, omdat de oorspronkelijke volgorde beide sets kan vertekenen. Na het schudden gaat bij een gebruikelijke splitsing 80% van de voorbeelden naar training en 20% naar validatie. Dezelfde transformaties gelden dan voor beide sets, maar pas nadat ze op de trainingsrijen zijn geleerd.
Waarom een gesorteerd verkoopbestand liegt
Exports komen vaak gesorteerd binnen op datum, regio of klant. Splits je zo'n bestand van boven naar beneden, dan train je op 2023 en valideer je op eind 2024. De score volgt dan de kalender, een promotiekalender of de mix van één regio. Ze zegt niet of het model de orders heeft begrepen.
Schud wanneer elke rij een zelfstandig geval is: een gesloten order, een vertrokken account, een geclassificeerd ticket. Schud niet wanneer de vraag een voorspelling is.
Behoud de tijdsvolgorde bij voorspellen. Train op eerdere maanden en test op latere maanden. Door te schudden zou het model de toekomst zien en dat vaardigheid noemen.
Tekstvelden hebben een frequentiegrens nodig
Supporttickets en productbeschrijvingen exploderen in duizenden tokens. In dezelfde workflow van Google laat je tokens weg die minder dan twee keer voorkomen, houd je de top 20.000 tokenkenmerken en rangschik je wat overblijft met een belangrijkheidsscore op basis van een F-toets. Een token dat één keer voorkomt is meestal een typfout of een eenmalige SKU, geen patroon dat een kolom waard is.
Leer na de splitsing elke koppeling alleen op trainingsdata en pas die vaste koppeling daarna toe op validatie. Een vocabulaire of categorielijst opnieuw berekenen op de achtergehouden rijen is een andere manier om het antwoord in de voorbereiding te laten lekken.
Ontbrekende waarden invullen zonder de resultaten te vertekenen
Hoe vaak een veld leeg is, en of de beslissing dat veld nodig heeft, bepaalt de aanpak. De onderstaande bandbreedtes zijn een praktische vuistregel, geen wet. Een gereguleerd risicomodel mag misschien geen rijen weglaten die een retailvoorspelling wel kan missen.
Aandeel ontbrekend | Belang van de feature | Actie |
|---|---|---|
Onder 5% | Elk | Verwijder die rijen als er genoeg data overblijft |
5% tot 30% | Laag | Verwijder de feature |
5% tot 30% | Hoog | Imputeer alleen op basis van trainingsrijen |
Boven 30% | Hoog | Imputeer, voeg een kolom met een vlag voor ontbrekende waarden toe en onderzoek waarom het veld leeg is |
Boven 30% | Laag | Verwijder de feature |
Een handvol lege kostenvelden in een verder complete orderfile is de eerste rij. Die regels verwijderen doet minder pijn dan een prijs verzinnen. Een zelden gebruikt enquêteveld in de middencategorie is een ingevulde gok niet waard, dus de kolom gaat eruit. Looptijd (tenure), die je voor churn gebruikt, blijft staan en die schat je.
Googles richtlijnen voor clustering over het voorbereiden van data noemen drie praktische opties: voorbeelden met ontbrekende waarden verwijderen, de feature verwijderen of de ontbrekende waarden voorspellen uit andere data. Zeldzame gaten kunnen het verwijderen van rijen rechtvaardigen. Frequente gaten betekenen meestal dat je de feature weglaat of imputeert.
Voorspel het gat in plaats van een constante in te vullen
Train voor een numeriek veld een regressie op rijen waar de waarde wel bestaat en schat daarmee de lege waarden. Een ontbrekende klantleeftijd kun je bijvoorbeeld schatten op basis van inkomen en looptijd, in plaats van die te vervangen door één gemiddelde voor het hele bedrijf. Zo gebruik je verbanden die je al vertrouwt.
Orderwaarde is scheef verdeeld. Een paar grote groothandelsorders trekken het gemiddelde omhoog, waardoor invullen met het gemiddelde gewone winkelmandjes rijker doet lijken dan ze zijn. De mediaan ligt bij de typische order en verschuift minder als er één bulkfactuur binnenkomt. Vergelijk samenvattende statistieken voor en na het invullen. Een grote verschuiving betekent dat de methode de business herschrijft in plaats van een gat te dichten.
Geef bij categorieën de lege waarde het label Unknown. Het gat is vaak juist het signaal: een checkout die de regio nooit heeft vastgelegd, of een product zonder leverancierscode. Als je dat een echt niveau maakt, blijft de rij behouden en ziet het model dat het veld bewust leeg was.
Frequente lege waarden zijn in de praktijk niet zeldzaam. Een studie uit 2025 over onvolledige waterverbruiksdata beschrijft een gebouwdataset met 33.888 uurrecords van februari 2019 tot en met december 2023, met ontbrekende waarden in 20% van de uren. Dat valt in de categorie waarin het blind verwijderen van rijen te veel historie weggooit (de studie).
Fit de imputer alleen op trainingsrijen. De gids van ELECTE over ontbrekende data bespreekt de keuzes voor imputatie uitgebreider, als je nog een keer naar de methode wilt kijken, niet naar de volgorde.
Categorieën coderen en bruikbare features bouwen
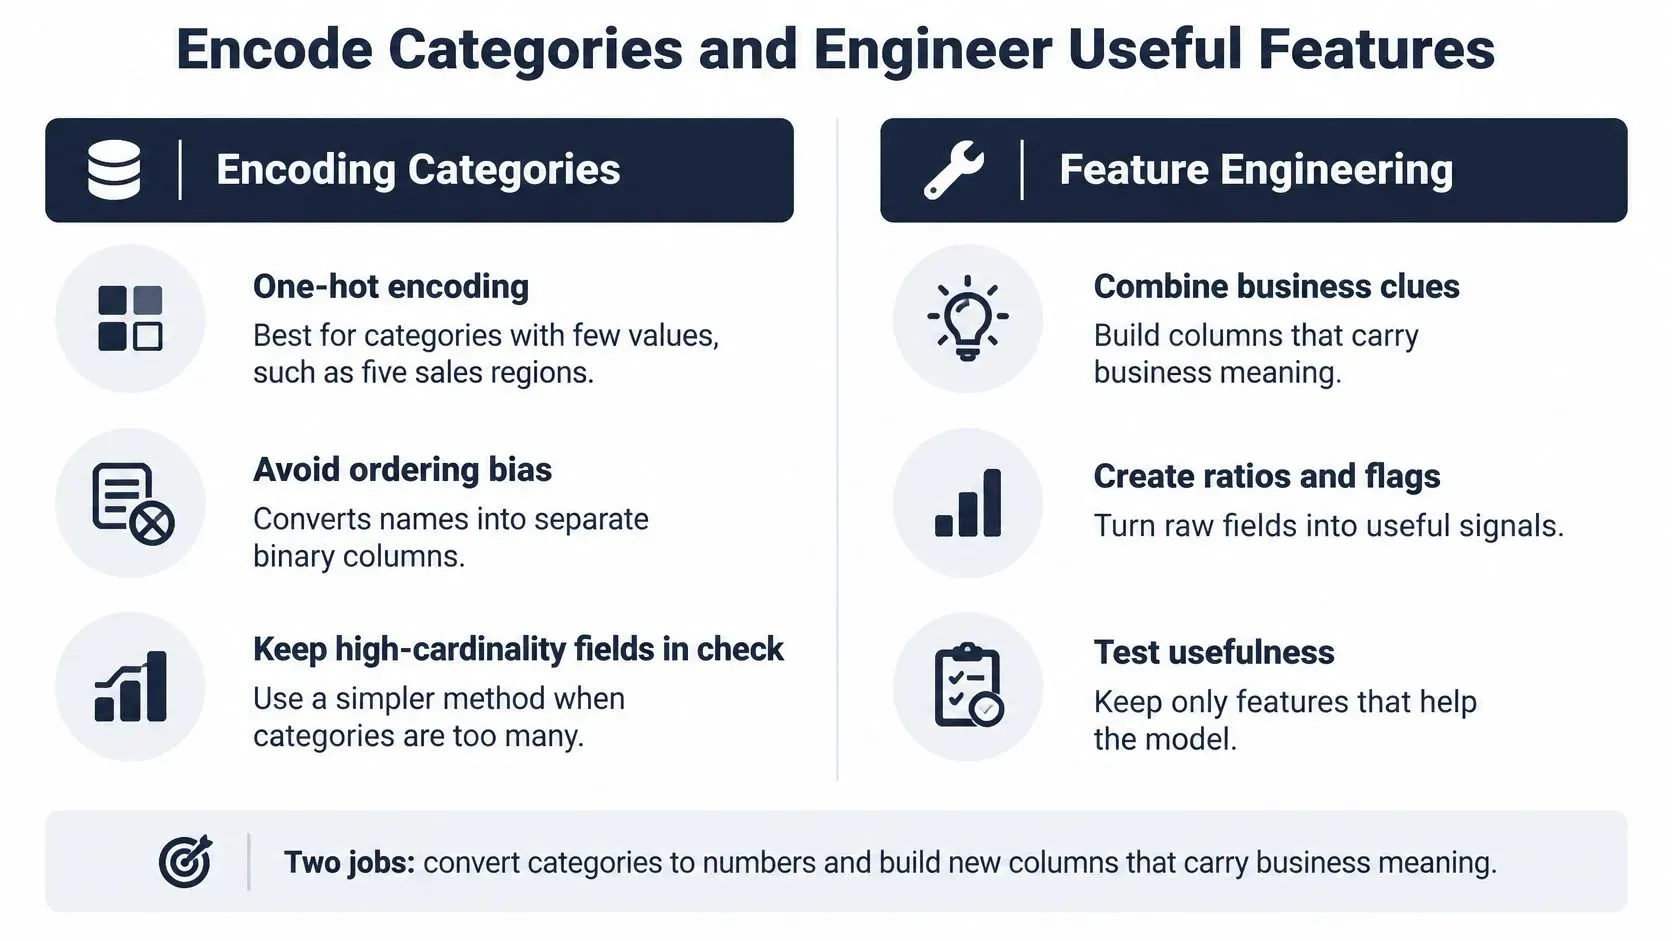
Hier horen twee taken. Zet labels om in getallen die het model kan gebruiken, en bouw kolommen die een zakelijke vraag beantwoorden die de ruwe velden niet beantwoorden.
Coderen zonder valse rangorde
One-hot-encoding past bij categorieën met weinig waarden, zoals vijf verkoopregio's. Elke regio wordt een eigen ja-of-nee-kolom, en geen enkele regio is "groter" dan een andere.
Ordinale codering past bij een echte volgorde, zoals de maten S, M en L. De getallen sluiten aan bij een rangorde die de organisatie al hanteert.
Geef geen 1, 2, 3 aan ongeordende namen zoals kanaal of stad. Het model behandelt een hogere code als meer van iets. Die valse rangorde komt later terug als een stellige, verkeerde coëfficiënt. Heeft een veld honderden niveaus, dan levert one-hot een heel brede tabel op. Groepeer zeldzame niveaus in Other voordat je codeert, en leer die groepering alleen op trainingsrijen.
Kolommen die een zakelijke vraag beantwoorden
Bouw een korte lijst die aan één beslissing is gekoppeld, geen stortplaats van elke ratio die je kunt bedenken.
- Margepercentage:
(price − cost) / pricelaat zien of een promotie nog boven de kostprijs uitkomt, iets wat omzet alleen niet kan. - Dagen sinds laatste aankoop: voor een churnanalyse heb je recency nodig, niet nog een kopie van het klant-ID.
- Dag van de week en maand: vraagplanning let op vrijdagpieken en seizoensmaanden die verborgen zitten in een volledige tijdstempel.
- Voortschrijdend 7-daags gemiddelde: dagelijkse aantallen schommelen sterk. Een weekgemiddelde laat zien of de vraag stijgt.
- Voorraad-verkoopratio: een voorraadbeheerder ziet een tekort eerder ontstaan dan met een kale voorraadtelling mogelijk is.
Ik zou beginnen met tien tot vijftien features die aan die ene beslissing zijn gekoppeld. Laat één van een paar kolommen vallen wanneer ze met meer dan 0,95 correleren, omdat de tweede kolom de eerste herhaalt. Zet de zakelijke betekenis naast de kolomnaam in de datadictionary. Een encoding map of voortschrijdend gemiddelde die is geleerd op het volledige bestand, inclusief rijen die je apart wilde houden, herhaalt het lek dat je bij de split al had afgedicht.
Schaal getallen en beheers uitschieters
Een extreme waarde is niet automatisch een fout. Een bestelling van 40 stuks van een B2B-klant is een echte verkoop. Markeer die zodat hij een gemiddelde niet domineert, en laat hem in de historie staan. Een stukprijs van 100.000 die is getypt in plaats van 1.000 is een invoerfout. Corrigeer het cijfer, behandel het niet als vraag.
Controleer de extreme waarde voordat je hem verwijdert
Twee controles werken goed samen. De 1,5 × interkwartielafstand-regel markeert punten ver van het midden van de kolom. Een domeincontrole vraagt of de waarde kan bestaan: negatieve voorraad, een datum in het volgende decennium, een korting hoger dan de verkoopprijs. Verifieer eerst. Kap daarna af op het 1e en 99e percentiel, pas een logtransformatie toe op scheef verdeelde omzet, of voeg een vlag toe en bewaar het ruwe getal voor rapportage.
Een bulkorder die je verwijdert, is omzet die je nooit meer voorspelt. Een typefout die je bewaart, wordt een prijs waarvan het model denkt dat klanten die betalen.
Draai de samenvatting opnieuw na het afkappen. Het midden van de kolom mag nauwelijks verschuiven. Als de mediaan springt, doet de afkapping te veel werk en moet je de bronrijen opnieuw bekijken.
Welke scaler past bij het profiel
Schalen voorkomt dat een kolom met grote eenheden, zoals jaaromzet, een kolom met kleine eenheden, zoals stuks per bestelling, overstemt. In de preprocessingdocumentatie van Scikit-learn staat dat StandardScaler elke feature centreert op het gemiddelde van de trainingsset en schaalt op basis van de variantie, en dat dit slecht kan presteren als er veel uitschieters zijn. RobustScaler is het alternatief dat robuustere schattingen van centrum en spreiding gebruikt.
Dataprofiel | Scaler | Waarom het past |
|---|---|---|
Grofweg symmetrisch, weinig extreme waarden | StandardScaler | Centreert op het gemiddelde en schaalt op variantie |
Veel uitschieters, zoals incidentele bulkorders | RobustScaler | Gebruikt mediaan en interkwartielafstand, die bestand zijn tegen extremen |
Waarden hebben een vast bereik nodig, zoals beoordelingen van 1 tot 5 | MinMaxScaler | Zet waarden om naar 0-1 zonder hun vorm te veranderen |
Fit de scaler alleen op de trainingsdata en pas die fit vervolgens toe op de validatiedata. Als je opnieuw fit op de achtergehouden set, bepalen extreme validatierijen de schaal. Wil je beter leren hoe je uitschieters herkent voordat je een aanpak kiest? Lees dan de gids van ELECTE over uitschieters.
Automatiseer de pipeline en controleer de output
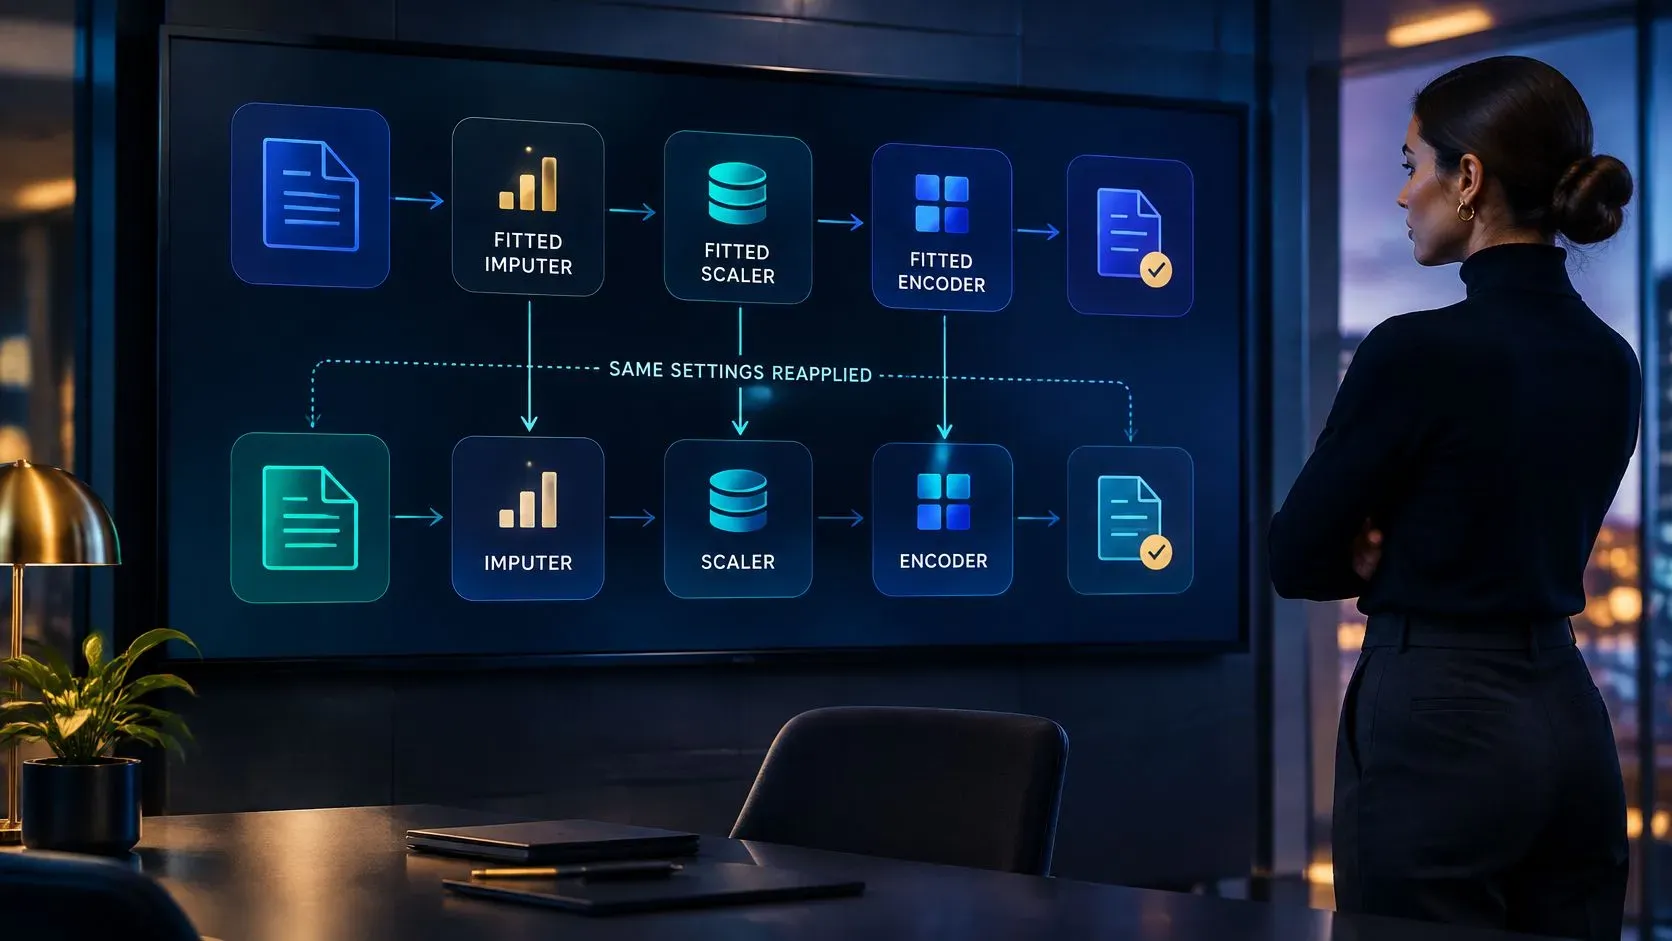
Een opgeschoond bestand in één notebook kan tussen runs gaan afwijken. Een nieuw bestand kan een andere imputatiewaarde, categorie-encoding of schaal krijgen, waardoor een dashboard verandert terwijl het onderliggende bedrijf niet is veranderd.
Een pipeline houdt de gefitte imputer, encoder en scaler bij elkaar en past dezelfde transformaties toe op nieuwe bestanden. Fit die stappen alleen op de trainingspartitie. Pas de gefitte instellingen toe op validatie- en testdata zonder ze opnieuw te berekenen. De uitleg van IBM over data leakage legt uit waarom het fitten van preprocessingstappen op zowel trainings- als testdata informatie kan laten lekken naar de evaluatie.
Controles na elke run
Een geslaagde job bevestigt alleen dat het proces is gedraaid. Controleer of de output nog overeenkomt met de bron en met de regels die je hebt vastgesteld:
- Aantal rijen: vergelijk het geladen bestand met de export en houd rekening met gelogde duplicaten.
- Percentage lege waarden per kolom: onderzoek een plotselinge stijging; die kan betekenen dat een bronveld niet meer binnenkomt.
- Waardebereiken: controleer of prijzen, aantallen en datums binnen de toegestane grenzen blijven.
- Nieuwe categorieën: stuur een onbekende regio of SKU naar een vaste categorie in plaats van die zonder melding weg te laten.
Bekijk voor praktische voorbeelden van datavalidatie hoe deze controles werken op bedrijfsbestanden. Behandel geautomatiseerde resultaten als schattingen en controleer de eerste cycli handmatig voordat je ze gebruikt om meldingen te activeren.
ELECTE, een AI-gestuurd data-analyseplatform voor groeiende bedrijven, koppelt aan boekhoudsoftware of een geüpload bestand en voert data-analyse en voorspellingen uit zonder dat u een analist nodig hebt. Klanten besparen meer dan 10 uur per week door financiële analyses te automatiseren. Die hulp werkt alleen als u ingestelde stappen gebruikt die u in een review kunt verdedigen, in plaats van ze bij elke upload opnieuw te berekenen.
Neem deze week één dataset door de tabel met zeven rijen en markeer welke stappen nog handmatig zijn. Automatiseer een stap die zich herhaalt, maar laat beoordelingskwesties, zoals een duplicaat versus een echte herbestelling of een typefout versus een grootbestelling, onder controle totdat de regels stabiel zijn.
ELECTE koppelt uw boekhoudgegevens of een bestandsupload, bereidt ze voor en zet ze om in voorspellingen en rapporten die u met uw team kunt beoordelen. Wilt u dat deze stappen voor datavoorbewerking bij elke upload op dezelfde manier worden toegepast, ga dan naar ELECTE en zie hoe het platform dit traject uitvoert op uw eigen cijfers.
Reacties
Nog geen reacties — start het gesprek.