Fasi di preprocessing dei dati: come pulire i dati aziendali
Scopri le fasi di preprocessing dei dati che trasformano record aziendali disordinati in analisi affidabili, con esempi per le PMI. Guarda come ELECTE le automatizza.
Hai estratto un export delle vendite che sembra completo. Ordini, costi e date riempiono il foglio. Poi una previsione arriva sulla scrivania del responsabile finanziario e il valore medio degli ordini è balzato in alto, anche se nel catalogo non è cambiato nulla.
Quel salto è spesso un errore di preprocessing, non un cambiamento negli acquisti. Compilare i prezzi mancanti quando nel file ci sono ancora fatture duplicate, o scalare l'intero estratto prima di mettere da parte alcune righe, insegna al modello fatti che non dovrebbe ancora conoscere. La maggior parte delle guide presenta le fasi di preprocessing dei dati come tecniche separate, applicabili in qualsiasi ordine. Ma è proprio l'ordine a gonfiare i risultati.
Di seguito trovi la sequenza che consiglio quando un analista gestisce un file aziendale in uso. Avrai un ordine di esecuzione, le soglie che considero punti di partenza e non regole fisse, e un modo per bloccare ogni impostazione calcolata, così che il caricamento dati successivo segua lo stesso percorso.
Sette fasi di preprocessing dei dati nell'ordine giusto
Un export delle vendite può sembrare completo e nascondere comunque righe di fattura duplicate, costi unitari vuoti e date salvate in due formati. Se risolvi questi problemi nell'ordine sbagliato, ogni media successiva li eredita.
Ogni passaggio che ricava un numero dai dati deve essere eseguito dopo la suddivisione. Una media, una mediana o un intervallo di scala calcolati sull'intero file permettono alle righe di validazione di influenzare l'addestramento. Il punteggio appare così più alto di quanto il modello otterrà sugli ordini del mese prossimo.
Fase | Cosa fai | Quando è completata |
|---|---|---|
1. Profilazione e pulizia | Controlli numero di righe, tipi di dati e percentuale di valori nulli; elimini i duplicati esatti; uniformi date ed etichette | Tabella di base pulita, con una sola etichetta per categoria |
2. Suddivisione dei dati | Mescoli le righe, poi le dividi in set di addestramento e di validazione | Esistono due set e non è stata ancora calcolata alcuna impostazione appresa |
3. Gestione dei valori mancanti | Elimini le righe, elimini la variabile oppure imputi usando solo i dati di addestramento | Ogni campo è completo o le sue lacune sono segnalate |
4. Codifica e feature engineering | Converti le categorie in numeri; costruisci rapporti, componenti temporali e medie mobili | Una tabella di feature pronta per il modello, con colonne documentate |
5. Trattamento degli outlier | Verifichi i valori estremi, poi li limiti, li trasformi o li segnali | I valori estremi sono spiegati, non ipotizzati |
6. Scalatura delle feature numeriche | Addestri uno scaler sui dati di addestramento e lo applichi ai dati di validazione | Le colonne numeriche hanno intervalli confrontabili |
7. Blocco della pipeline | Salvi ogni trasformazione calcolata, così i nuovi dati seguono lo stesso percorso | Un'esecuzione ripetibile che funziona a ogni nuovo caricamento di dati |
Supponiamo che un rivenditore abbia 12.000 righe d'ordine, comprese 900 righe di fattura duplicate. Se imputi i prezzi mancanti prima di eliminare quei duplicati, conti due volte la stessa fattura e la media si discosta dal listino.
Regola pratica: finisci la riga su cui stai lavorando prima di calcolare qualcosa che serve alla riga successiva.
Confronta il file che hai aperto con quelle sette righe. La prima riga che non hai ancora completato è l'unica su cui vale la pena intervenire oggi.
Analizzare e pulire i dati aziendali grezzi
Il profiling è un'analisi di un'ora che un manager può completare prima che qualcuno apra un modello. Lascia intatto il file grezzo e annota ogni modifica in un registro di pulizia, così un responsabile finanziario può capire perché un totale è cambiato.
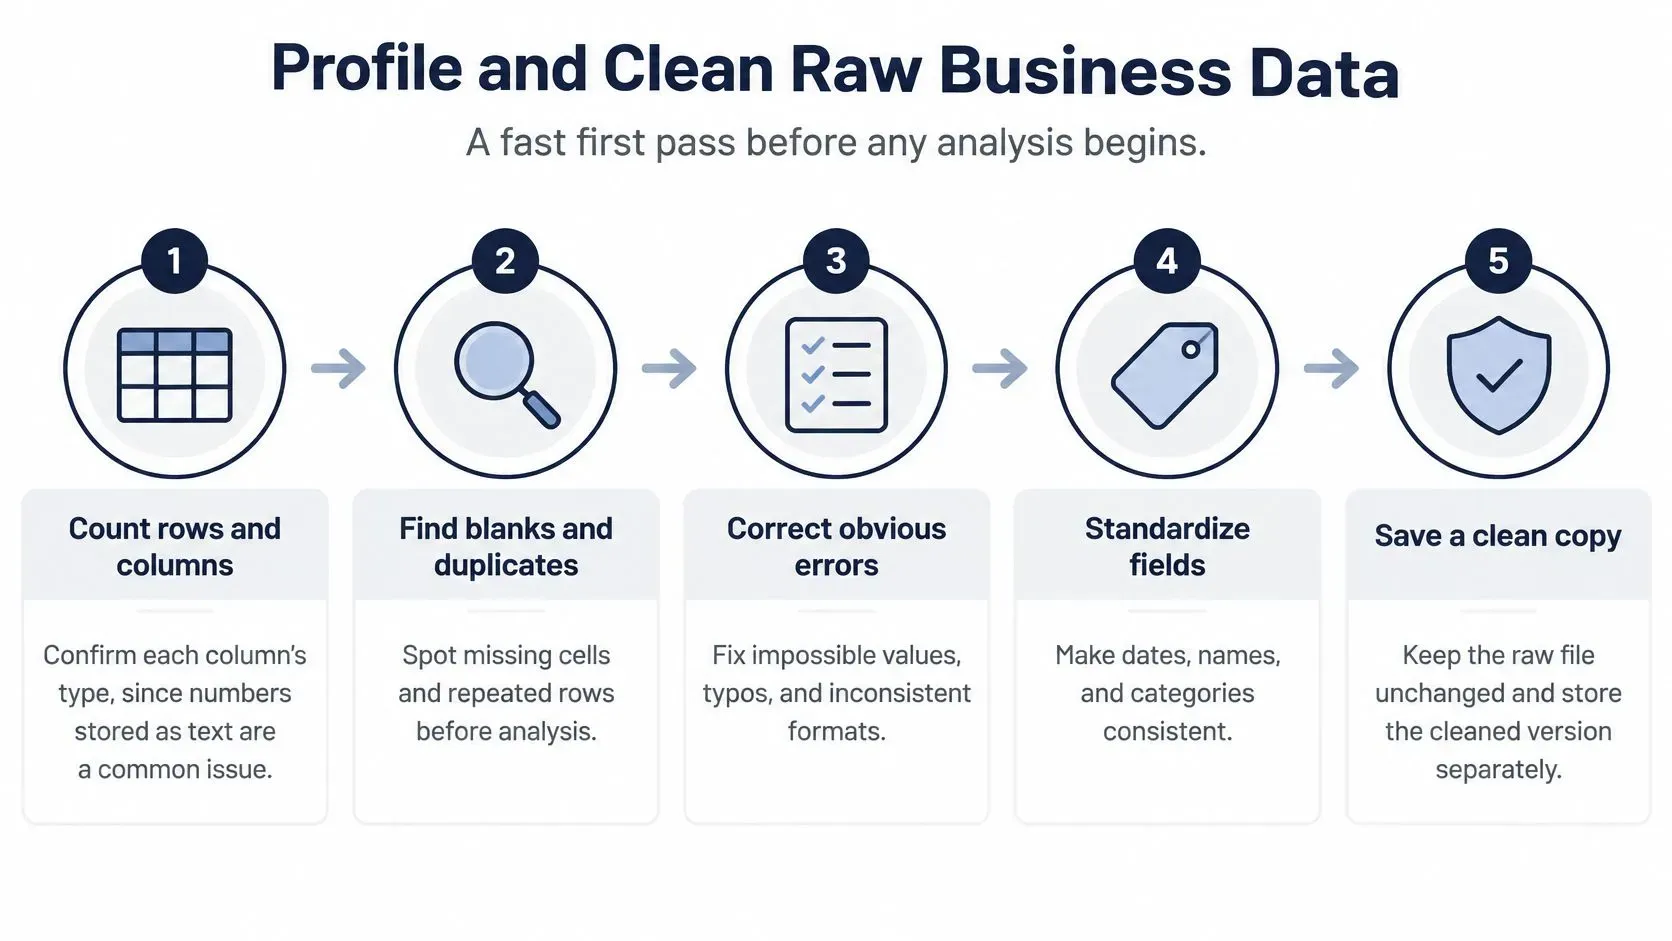
- Conta righe e colonne, poi verifica il tipo di ciascuna. Un costo salvato come testo non si somma, e non genera errori evidenti. Convertilo prima di fidarti di un totale.
- Calcola la percentuale di valori nulli per ogni colonna. Una colonna con oltre il 30% di celle vuote passa alle regole sui valori mancanti, non a un riempimento veloce. Eliminerei una colonna del tutto solo quando i vuoti superano il 50% e il campo non serve alla decisione.
- Rimuovi i duplicati esatti, non quelli simili. Usa come criterio insieme numero di fattura, data e importo. Un secondo ordine con un ID di riga diverso è una vendita reale. Eliminarlo perché cliente e giorno coincidono è l'errore che porta a sottostimare il fatturato.
- Normalizza i formati in un unico passaggio. Un solo formato di data, una sola valuta per colonna e nessuno spazio superfluo nei codici. Formati misti dividono un prodotto in due serie e compromettono qualsiasi join successivo.
- Uniforma le etichette delle categorie.
UK,U.K.eUnited Kingdomsono un solo mercato. Quattro grafie della stessa linea di prodotto in un export e-commerce di tre anni causano lo stesso danno. Scegli un'etichetta e mappa le altre.
Ipotizza che lo stesso export salvi le date degli ordini come 2024-03-01 in un anno e 01/03/2024 in un altro. Finché i due formati non diventano uno solo, un grafico mensile conta due volte marzo oppure lo perde.
Cosa proteggono il registro e il taglio sulla privacy
Il registro di pulizia è una tabella breve: colonna, regola, righe modificate, persona, data. Quando la finanza chiede perché marzo dell'anno scorso si è ridotto, indichi la regola sui duplicati invece di ricostruire il file a memoria.
Prima che il file arrivi a qualsiasi piattaforma di analisi, rimuovi nomi dei clienti, email e dati di pagamento. Non ti servono per prevedere la domanda, e lasciarli nell'estrazione crea un problema di privacy che nessun modello può risolvere.
Se vuoi un secondo parere su cosa significhi "buono" per le estrazioni commerciali, gli approfondimenti di Pipecorn sulla qualità dei dati di vendita sono una checklist utile per identificatori, completezza e coerenza. Usali per decidere quali colonne vale la pena tenere, poi torna al taglio sul tasso di nulli descritto sopra.
Dividere i dati prima di qualsiasi apprendimento
La divisione è una barriera. Nulla che stimi una statistica deve usare il file completo.
Per la classificazione supervisionata di testi, la guida di Google alla classificazione del testo raccomanda di mescolare i dati prima della divisione, perché mantenere l'ordine originale può distorcere entrambi gli insiemi. Dopo il rimescolamento, una divisione tipica assegna l'80% degli esempi all'addestramento e il 20% alla validazione. Le stesse trasformazioni si applicano poi a entrambi gli insiemi, ma solo dopo essere state apprese sulle righe di addestramento.
Perché un file di vendite ordinato inganna
Gli export spesso arrivano ordinati per data, area geografica o cliente. Se dividi quel file dall'alto verso il basso, addestri il modello sul 2023 e lo validi su fine 2024. Il punteggio segue allora il calendario, il calendario promozionale o la composizione di una singola regione. Non ti dice se il modello ha capito gli ordini.
Mescola i dati quando ogni riga è un caso indipendente: un ordine chiuso, un account perso, un ticket classificato. Non farlo quando la domanda riguarda una previsione.
Per le previsioni mantieni l'ordine temporale. Addestra sui mesi precedenti e testa su quelli successivi. Un rimescolamento permetterebbe al modello di vedere il futuro e di farlo passare per abilità.
I campi di testo richiedono un taglio per frequenza
I ticket di assistenza e le descrizioni dei prodotti si espandono in migliaia di token. Nello stesso flusso di lavoro di Google, si scartano i token che compaiono meno di due volte, si tengono le prime 20.000 feature di token e si ordina ciò che resta con un punteggio di importanza basato sul test F. Un token che compare una sola volta di solito è un refuso o uno SKU isolato, non uno schema che meriti una colonna.
Dopo la divisione, calcola ogni mappatura solo sui dati di addestramento, poi applica quella mappatura fissa alla validazione. Ricalcolare un vocabolario o un elenco di categorie sulle righe escluse è un altro modo per far trapelare la risposta nella preparazione.
Compilare i valori mancanti senza distorcere i risultati
L'azione da compiere dipende da quanto spesso un campo è vuoto e dal fatto che la decisione abbia bisogno di quel campo. Le fasce qui sotto sono una regola pratica, non una legge. Un modello di rischio regolamentato può rifiutarsi di eliminare righe che una previsione retail può permettersi di perdere.
Quota di valori mancanti | Importanza della feature | Azione |
|---|---|---|
Sotto il 5% | Qualsiasi | Elimina quelle righe se restano dati sufficienti |
Dal 5% al 30% | Bassa | Elimina la feature |
Dal 5% al 30% | Alta | Imputa usando solo le righe di training |
Oltre il 30% | Alta | Imputa, aggiungi una colonna indicatrice di valore mancante e indaga perché il campo è vuoto |
Oltre il 30% | Bassa | Elimina la feature |
Una manciata di costi vuoti in un file ordini per il resto completo corrisponde alla prima riga. Eliminare quelle righe fa meno danni che inventare un prezzo. Un campo di un sondaggio usato di rado, nella fascia intermedia, non vale un valore inserito a tentativi, quindi la colonna viene eliminata. L'anzianità cliente, che usi per il churn, resta e la stimi.
Le indicazioni di Google sulla preparazione dei dati per il clustering indicano tre opzioni pratiche: rimuovere gli esempi con valori mancanti, rimuovere la feature oppure prevedere i valori mancanti a partire da altri dati. Se i vuoti sono rari, eliminare le righe può essere giustificato. Se sono frequenti, di solito si elimina la feature o la si imputa.
Prevedi il valore mancante invece di incollare una costante
Per un campo numerico, addestra una regressione sulle righe in cui il valore esiste, poi stima i vuoti. L'età mancante di un cliente, per esempio, si può stimare da reddito e anzianità invece di sostituirla con un'unica media aziendale. In questo modo sfrutti relazioni di cui ti fidi già.
Il valore degli ordini è asimmetrico. Pochi grandi scontrini all'ingrosso spingono in alto la media, quindi riempire con la media fa sembrare i carrelli normali più ricchi di quanto siano. La mediana resta vicina all'ordine tipico e si sposta meno quando arriva una fattura all'ingrosso. Confronta le statistiche descrittive prima e dopo l'imputazione. Uno scostamento ampio significa che il metodo sta riscrivendo il business, non tappando un buco.
Per le categorie, etichetta il vuoto come Unknown. Spesso il vuoto è il segnale: un checkout che non ha mai raccolto la regione, o un prodotto senza codice fornitore. Trasformarlo in un livello vero mantiene la riga e mostra al modello che il campo era vuoto di proposito.
I vuoti frequenti non sono rari nelle operations. Uno studio del 2025 su dati incompleti di consumo idrico descrive un dataset di edifici con 33.888 record orari da febbraio 2019 a dicembre 2023, con valori mancanti nel 20% delle ore: una fascia in cui eliminare tutte le righe farebbe perdere troppo storico (lo studio).
Adatta l'imputer solo sulle righe di training. La guida di ELECTE ai dati mancanti approfondisce le scelte di imputazione, se vuoi un secondo passaggio sul metodo, non sull'ordine.
Codifica le categorie e crea feature utili
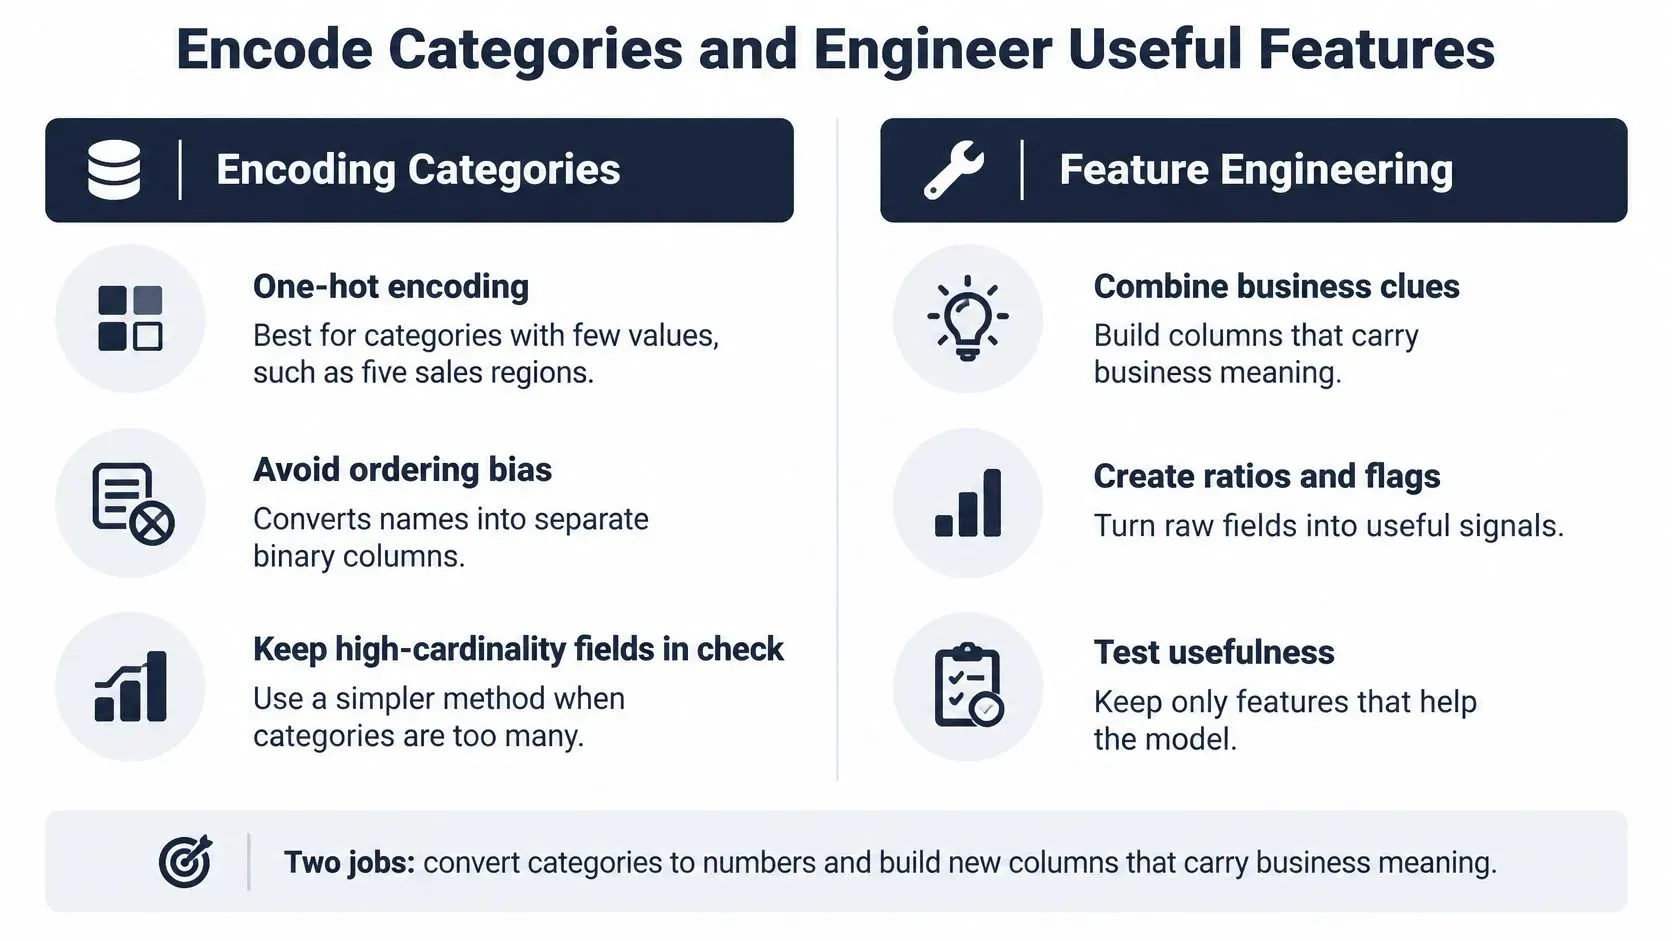
Qui ci sono due compiti. Trasformare le etichette in numeri che il modello può usare e costruire colonne che rispondano a una domanda di business a cui i campi grezzi non rispondono.
Codifica senza una classifica fittizia
La codifica one-hot è adatta a categorie con pochi valori, come cinque regioni di vendita. Ogni regione diventa una colonna sì/no, e nessuna regione è "più grande" di un'altra.
La codifica ordinale è adatta a un ordine reale, come le taglie S, M e L. I numeri riflettono una classifica che l'azienda usa già.
Non assegnare 1, 2, 3 a nomi senza ordine, come canale o città. Il modello tratterà un codice più alto come "più di qualcosa". Quella falsa classifica emerge poi come un coefficiente sicuro ma sbagliato. Quando un campo ha centinaia di livelli, la codifica one-hot crea una tabella molto larga. Raggruppa i livelli rari in Other prima di codificare e ricava quel raggruppamento solo dalle righe di training.
Colonne che rispondono a una domanda di business
Costruisci un elenco breve legato a una sola decisione, non un cumulo di ogni rapporto che riesci a calcolare.
- Percentuale di margine:
(price − cost) / priceindica se una promozione copre ancora i costi, cosa che il solo fatturato non mostra. - Giorni dall'ultimo acquisto: un'analisi del churn ha bisogno della recency, non di un'ulteriore copia dell'ID cliente.
- Giorno della settimana e mese: la pianificazione della domanda deve vedere i picchi del venerdì e i mesi stagionali nascosti in un timestamp completo.
- Media mobile a 7 giorni: le unità giornaliere oscillano molto. La media settimanale mostra se la domanda sta crescendo.
- Rapporto scorte/vendite: chi gestisce l'inventario vede formarsi una carenza prima di quanto permetta il semplice conteggio delle giacenze.
Partirei da dieci-quindici feature legate a quella singola decisione. Elimina una colonna di una coppia quando la correlazione supera 0,95, perché la seconda ripete la prima. Scrivi il significato di business accanto al nome della colonna nel dizionario dei dati. Una mappa di codifica o una media mobile calcolata sull'intero file, comprese le righe che volevi tenere da parte, ripete la fuga di dati che avevi già bloccato al momento della suddivisione.
Scalare i numeri e gestire gli outlier
Un valore estremo non è automaticamente un errore. Un ordine da 40 unità di un cliente B2B è una vendita reale. Segnalalo in modo che non domini una media, e lascialo nello storico. Un prezzo unitario di 100.000 digitato al posto di 1.000 è un errore di inserimento. Correggi la cifra, non trattarlo come domanda.
Verifica il valore estremo prima di eliminarlo
Due controlli funzionano bene insieme. La regola di 1,5 × scarto interquartile individua i punti lontani dal centro della colonna. Un controllo di dominio chiede se il valore può esistere: scorte negative, una data nel prossimo decennio, uno sconto superiore al prezzo di vendita. Prima verifica. Poi limita ai percentili 1° e 99°, applica una trasformazione logaritmica al fatturato asimmetrico, oppure aggiungi un flag e conserva il valore originale per il reporting.
Un ordine all'ingrosso che elimini è fatturato che non saprai più prevedere. Un errore di battitura che conservi diventa un prezzo che il modello crede i clienti pagheranno.
Riesegui il riepilogo dopo il limite. Il centro della colonna dovrebbe muoversi appena. Se la mediana salta, il limite sta incidendo troppo e conviene riguardare le righe di origine.
Quale scaler si adatta al profilo
La scalatura impedisce a una colonna in unità grandi, come il fatturato annuo, di sovrastare una colonna in unità piccole, come le unità per ordine. La documentazione sul preprocessing di Scikit-learn osserva che StandardScaler centra ogni feature sulla media del training set e la scala in base alla varianza, e che può funzionare male in presenza di molti outlier. RobustScaler è l'alternativa pronta all'uso che impiega stime più resistenti di centro e intervallo.
Profilo dei dati | Scaler | Perché è adatto |
|---|---|---|
Distribuzione più o meno simmetrica, pochi valori estremi | StandardScaler | Centra sulla media e scala in base alla varianza |
Outlier marcati, come ordini all'ingrosso occasionali | RobustScaler | Usa mediana e scarto interquartile, che resistono ai valori estremi |
I valori richiedono un intervallo fisso, come le valutazioni da 1 a 5 | MinMaxScaler | Porta i valori tra 0 e 1 senza cambiarne la forma |
Addestra lo scaler solo sui dati di training, poi applica lo stesso fit al set di validazione. Rifare il fit sul set escluso dall'addestramento permette alle righe estreme della validazione di determinare la scala. Per approfondire come individuare i valori estremi prima di scegliere un trattamento, consulta la guida di ELECTE agli outlier.
Automatizzare la pipeline e verificarne gli output
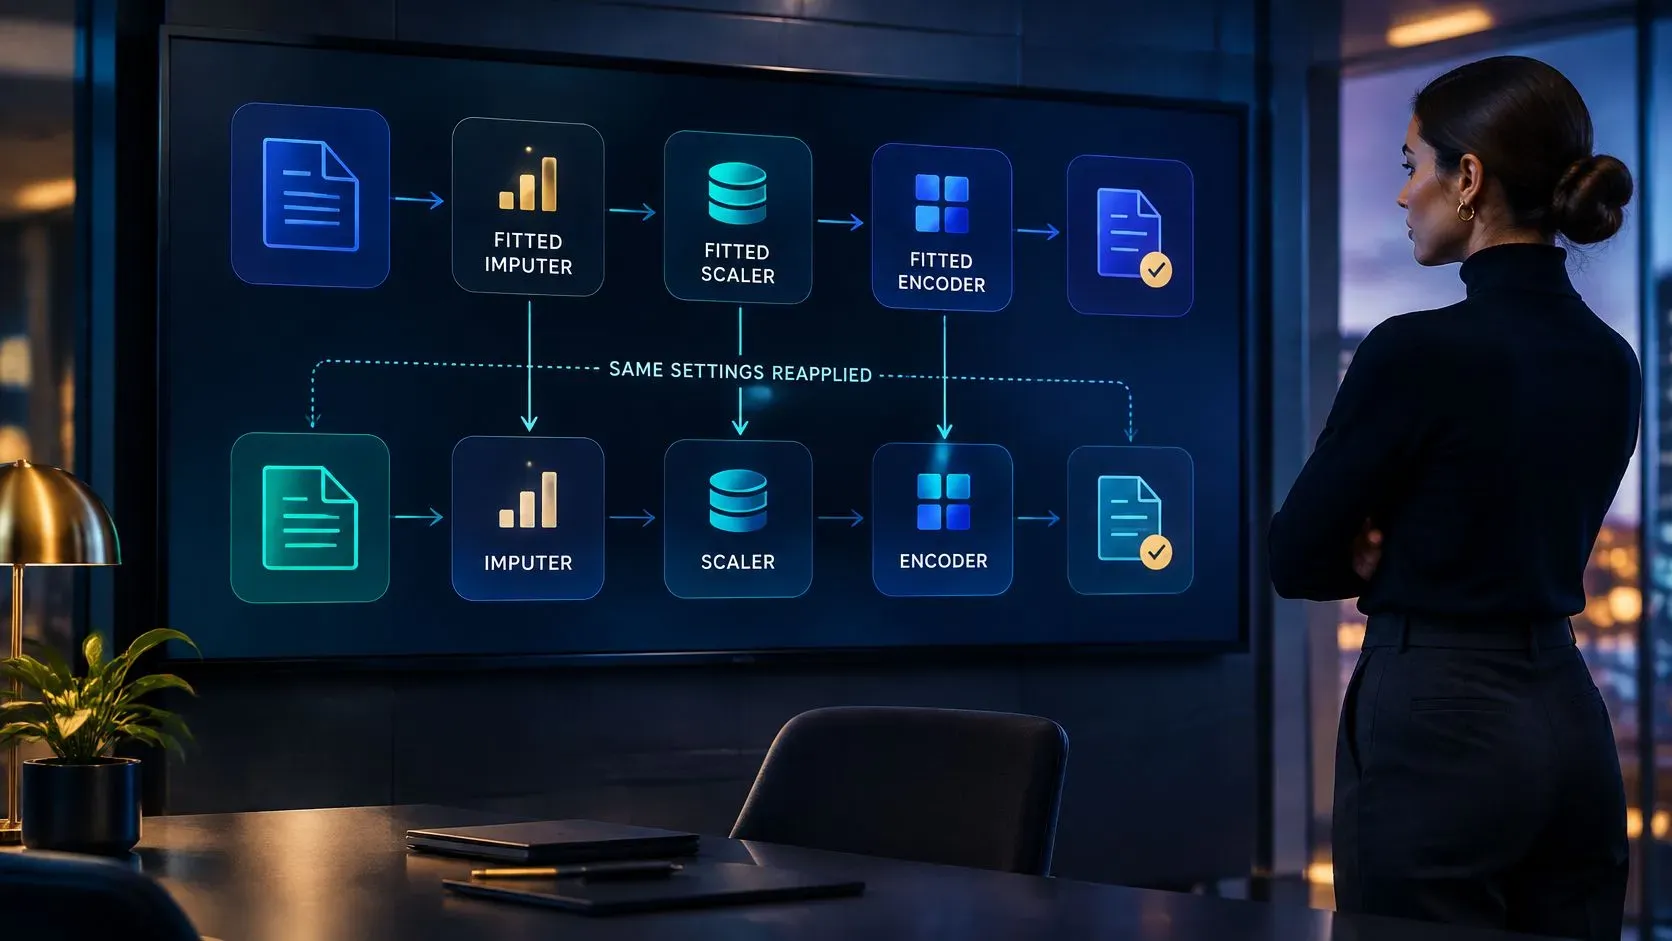
Un file pulito salvato in un solo notebook può variare da un'esecuzione all'altra. Un nuovo file può ricevere un valore di imputazione, una codifica delle categorie o una scala diversi, e la dashboard cambia anche se il business non è cambiato.
Una pipeline mantiene insieme imputer, encoder e scaler già addestrati, poi applica le stesse trasformazioni ai nuovi file. Addestra questi passaggi solo sulla partizione di training. Applica le impostazioni ottenute ai dati di validazione e di test senza ricalcolarle. La nota di IBM sul data leakage spiega perché addestrare i passaggi di preprocessing sui dati di training e di test insieme può far trapelare informazioni nella valutazione.
Controlli dopo ogni esecuzione
Un job riuscito conferma solo che il processo è stato eseguito. Verifica se l'output corrisponde ancora alla fonte e alle regole che hai definito:
- Conteggio delle righe: riconcilia il file caricato con l'esportazione, tenendo conto dei duplicati registrati.
- Percentuale di valori nulli per colonna: indaga su un aumento improvviso, che potrebbe indicare che un campo della fonte ha smesso di arrivare.
- Intervalli di valori: verifica che prezzi, quantità e date restino entro i limiti accettati.
- Nuove categorie: indirizza una regione o uno SKU mai visto verso un gruppo definito, invece di scartarlo senza avviso.
Per esempi pratici di validazione dei dati, scopri come questi controlli si applicano ai file aziendali. Considera i risultati automatici come stime e verifica manualmente i primi cicli prima di usarli per attivare gli alert.
ELECTE, una piattaforma di analisi dati basata su AI per le aziende in crescita, si collega al software di contabilità o a un file caricato ed esegue analisi dei dati e previsioni senza bisogno di un analista. I clienti risparmiano oltre 10 ore a settimana automatizzando l'analisi finanziaria. Questo aiuto dipende dall'uso di passaggi calibrati che puoi difendere in una revisione, invece di ricalcolarli a ogni caricamento.
Questa settimana, prendi un dataset e fallo passare attraverso la tabella in sette righe, segnando quali passaggi sono ancora manuali. Automatizza un passaggio ripetuto, ma mantieni sotto revisione le decisioni che richiedono giudizio, come un duplicato rispetto a un vero riordine o un errore di battitura rispetto a un ordine all'ingrosso, finché le regole non sono stabili.
ELECTE si collega ai tuoi dati contabili o a un file caricato, li prepara e li trasforma in previsioni e report che puoi rivedere con il tuo team. Se vuoi che questi passaggi di preelaborazione dei dati siano applicati allo stesso modo a ogni caricamento, visita ELECTE e scopri come la piattaforma esegue il percorso sui tuoi numeri.
Commenti
Ancora nessun commento — inizia tu la conversazione.