Veri Ön İşleme Adımları: İş Verileri Nasıl Temizlenir
Dağınık iş kayıtlarını güvenilir içgörülere dönüştüren veri ön işleme adımlarını KOBİ örnekleriyle öğrenin. ELECTE'nin bunları nasıl otomatikleştirdiğini görün.
Bitmiş gibi görünen bir satış dışa aktarımı çektiniz. Siparişler, maliyetler ve tarihler sayfayı dolduruyor. Sonra finans sorumlusunun masasına bir tahmin geliyor ve katalogda hiçbir şey değişmediği halde ortalama sipariş değeri ffırlamış.
Bu sıçrama çoğu zaman satın alma davranışındaki bir değişiklikten değil, bir ön işleme hatasından kaynaklanır. Dosyada yinelenen faturalar dururken boş fiyatları doldurmak ya da hiçbir satırı ayırmadan tüm dışa aktarımı ölçeklemek, modele henüz görmemesi gereken bilgileri öğretir. Çoğu yazı veri ön işleme adımlarını istediğiniz sırayla uygulayabileceğiniz ayrı teknikler olarak sıralar. Sonuçları şişiren şey ise tam da sıradır.
Aşağıda, bir analist canlı bir iş dosyasının sorumluluğunu üstlendiğinde önerdiğim sırayı bulacaksınız. Ayrıca kesin kural değil, başlangıç noktası saydığım eşikleri ve her uyarlanmış ayarı kilitlemenin bir yolunu göreceksiniz; böylece sonraki veri yüklemesi de aynı yolu izler.
Doğru Sırayla Yedi Veri Ön İşleme Adımı
Bir satış dışa aktarımı eksiksiz görünebilir ve yine de yinelenen fatura satırlarını, boş birim maliyetlerini ve iki farklı biçimde saklanan tarihleri gizleyebilir. Bu sorunları yanlış sırayla temizlerseniz sonraki her ortalama bunları devralır.
Veriden bir sayı öğrenen her adım, bölmeden sonra çalıştırılmalıdır. Tüm dosya üzerinde hesaplanan bir ortalama, medyan veya ölçekleme aralığı, doğrulama satırlarının eğitimi etkilemesine yol açar. Bu durumda skor, modelin gelecek ayın siparişlerindeki gerçek performansından daha güçlü görünür.
Adım | Ne Yapılır | Ne Zaman Hazır |
|---|---|---|
1. Profil çıkarma ve temizleme | Satır sayılarını, veri türlerini ve boş değer oranlarını kontrol edin; birebir aynı kayıtları silin; tarihleri ve etiketleri standartlaştırın | Her kategori için tek etiket içeren temiz bir temel tablo |
2. Veriyi bölme | Satırları karıştırın, ardından eğitim ve doğrulama kümelerine ayırın | İki küme oluşmuştur ve henüz öğrenilmiş hiçbir ayar hesaplanmamıştır |
3. Eksik değerleri ele alma | Satırları silin, özelliği silin veya yalnızca eğitim verisini kullanarak değer atayın | Her alan eksiksizdir ya da boşlukları işaretlenmiştir |
4. Kodlama ve özellik mühendisliği | Kategorileri sayılara dönüştürün; oranlar, zaman bileşenleri ve hareketli ortalamalar oluşturun | Sütunları belgelenmiş, modele hazır bir özellik tablosu |
5. Aykırı değerleri işleme | Uç değerleri doğrulayın, ardından sınırlayın, dönüştürün veya işaretleyin | Uç değerler tahmin edilmez, açıklanır |
6. Sayısal özellikleri ölçekleme | Ölçekleyiciyi eğitim verisine uyarlayın ve doğrulama verisine uygulayın | Sayısal sütunlar karşılaştırılabilir aralıklardadır |
7. İş akışını kilitleme | Uyarlanmış her dönüşümü kaydedin; böylece yeni veriler aynı yolu izler | Her yeni veri yüklemesinde çalışan tekrarlanabilir bir süreç |
Diyelim ki bir perakendecinin 12.000 sipariş satırı var ve bunların 900'ü yinelenen fatura satırı. Bu yinelenenleri silmeden önce eksik fiyatlara değer atarsanız aynı faturayı iki kez saymış olursunuz ve ortalama fiyat listesinden uzaklaşır.
Pratik kural: Bir sonraki satırın ihtiyaç duyacağı hiçbir şeyi hesaplamadan önce üzerinde çalıştığınız satırı bitirin.
Açık olan dosyanızı bu yedi satırla eşleştirin. Henüz tamamlamadığınız ilk satır, bugün dokunmaya değer tek satırdır.
Ham İş Verilerini Profilleyin ve Temizleyin
Profilleme, bir yöneticinin kimse bir model açmadan önce bitirebileceği bir saatlik bir geçiştir. Ham dosyayı olduğu gibi bırakın ve yaptığınız her değişikliği bir temizleme günlüğüne yazın; böylece bir finans sorumlusu bir toplamın neden değiştiğini görebilir.
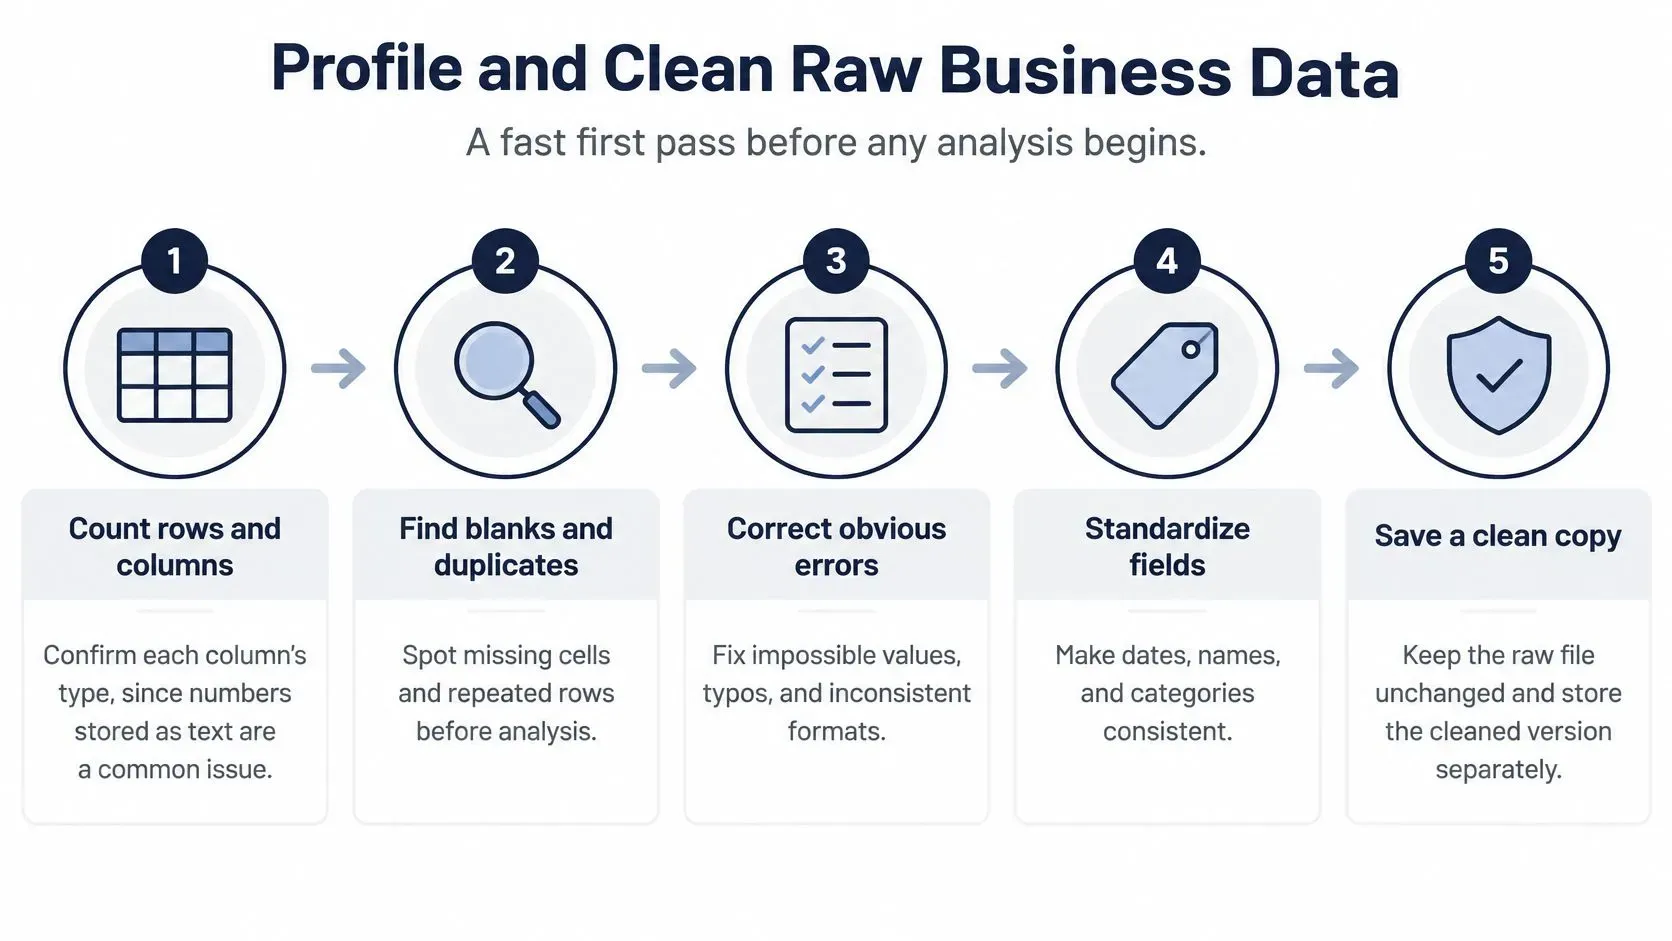
- Satır ve sütun sayısını sayın, ardından her türü doğrulayın. Metin olarak saklanan bir maliyet toplanmaz ve bunu açıkça belli etmez. Bir toplama güvenmeden önce onu dönüştürün.
- Her sütunda boş değer oranını hesaplayın. %30'un üzerinde boş olan sütun, hızlı bir doldurma yerine eksik değer kurallarına gider. Bir sütunu tümüyle ancak boşluklar %50'yi aştığında ve alan karar için gerekli olmadığında çıkarırdım.
- Benzerlerini değil, birebir kopyaları silin. Fatura numarası, tarih ve tutarı birlikte eşleştirin. Farklı bir kalem kimliğine sahip ikinci bir sipariş gerçek bir satıştır. Müşteri ve gün aynı diye onu silmek, geliri eksik gösteren hatadır.
- Biçimleri tek geçişte normalleştirin. Tek bir tarih deseni, sütun başına tek bir para birimi ve kodlarda fazladan boşluk olmaması. Karışık biçimler tek bir ürünü iki seriye böler ve sonraki her birleştirmeyi bozar.
- Kategori etiketlerini standartlaştırın.
UK,U.K.veUnited Kingdomtek bir pazardır. Üç yıllık bir e-ticaret dışa aktarımında tek bir ürün hattının dört farklı yazımı aynı zararı verir. Bir etiket seçin ve diğerlerini ona eşleyin.
Diyelim ki bu dışa aktarım sipariş tarihlerini bir yıl 2024-03-01, başka bir yıl 01/03/2024 olarak saklıyor. İkisi tek bir desene dönüşene kadar aylık bir grafik Mart'ı iki kez sayar ya da hiç saymaz.
Günlük ve gizlilik kesintisi neyi korur
Temizleme günlüğü kısa bir tablodur: sütun, kural, değişen satır sayısı, kişi, tarih. Finans geçen Mart'ın neden küçüldüğünü sorduğunda, dosyayı hafızadan yeniden kurmak yerine kopya kuralını gösterirsiniz.
Dosya herhangi bir analiz platformuna ulaşmadan önce müşteri adlarını, e-postaları ve ödeme bilgilerini çıkarın. Talebi tahmin etmek için bunlara ihtiyacınız yok; çıktıda bırakmak ise bir modelin geri alamayacağı bir gizlilik sorunu yaratır.
Ticari dışa aktarımlar için "iyi" verinin neye benzediğine dair ikinci bir görüş isterseniz, Pipecorn'un satış verisi kalitesi içgörüleri tanımlayıcılar, eksiksizlik ve tutarlılık için yararlı bir kontrol listesidir. Hangi sütunları tutmaya değeceğine karar vermek için kullanın, sonra yukarıdaki boş değer oranı kesintisine dönün.
Öğrenme Başlamadan Önce Veriyi Bölün
Bölme bir çittir. Bir istatistik tahmin eden hiçbir şey tam dosyada yer almamalıdır.
Denetimli metin sınıflandırması için Google'ın metin sınıflandırma kılavuzu, bölmeden önce karıştırmayı önerir; çünkü özgün sırayı korumak her iki kümeyi de yanlı hale getirebilir. Karıştırmadan sonra tipik bir bölmede örneklerin %80'i eğitime, %20'si doğrulamaya ayrılır. Aynı dönüşümler sonra her iki kümeye de uygulanır, ancak yalnızca eğitim satırlarından öğrenildikten sonra.
Sıralı bir satış dosyası neden yanıltır
Dışa aktarımlar çoğu zaman tarihe, bölgeye veya müşteriye göre sıralı gelir. Bu dosyayı yukarıdan aşağıya bölerseniz 2023 ile eğitir, 2024'ün sonuyla doğrularsınız. Skor o zaman takvimi, bir promosyon takvimini veya tek bir bölgenin dağılımını izler. Modelin siparişleri anlayıp anlamadığını söylemez.
Her satır bağımsız bir vakaysa karıştırın: kapanmış bir sipariş, kaybedilmiş bir hesap, sınıflandırılmış bir talep. Soru bir tahminse karıştırmayın.
Tahmin için zaman sırasını koruyun. Önceki aylarla eğitin, sonraki aylarla test edin. Karıştırma, modelin geleceği görmesine izin verir ve buna beceri denir.
Metin alanları için sıklık kesintisi gerekir
Destek talepleri ve ürün açıklamaları binlerce belirtece dönüşür. Aynı Google iş akışında, iki kereden az geçen belirteçleri atar, en iyi 20.000 belirteç özelliğini tutar ve kalanları F-testi tabanlı bir önem skoruyla sıralarsınız. Bir kez görünen belirteç genellikle bir yazım hatası ya da tek seferlik bir SKU'dur; bir sütunu hak eden bir örüntü değildir.
Bölmeden sonra her eşlemeyi yalnızca eğitim verisinde öğrenin, ardından bu donmuş eşlemeyi doğrulamaya uygulayın. Ayrılmış satırlarda bir kelime dağarcığını veya kategori listesini yeniden hesaplamak, cevabı hazırlığa sızdırmanın başka bir yoludur.
Sonuçları Çarpıtmadan Eksik Değerleri Doldurun
Bir alanın ne sıklıkla boş olduğu ve kararın o alana ihtiyaç duyup duymadığı, eylemi belirler. Aşağıdaki aralıklar bir kanun değil, pratik bir temel kuraldır. Düzenlemeye tabi bir risk modeli, bir perakende tahmininin göze alabileceği satırları silmeyi reddedebilir.
Eksik Oranı | Özellik Önemi | Yapılacak İşlem |
|---|---|---|
%5'in altı | Herhangi | Yeterli veri kalıyorsa bu satırları silin |
%5 ile %30 arası | Düşük | Özelliği çıkarın |
%5 ile %30 arası | Yüksek | Yalnızca eğitim satırlarından doldurun |
%30'un üzeri | Yüksek | Doldurun, eksik göstergesi sütunu ekleyin ve alanın neden boş olduğunu araştırın |
%30'un üzeri | Düşük | Özelliği çıkarın |
Birinci satır, aksi halde eksiksiz bir sipariş dosyasında birkaç boş maliyet değeridir. Bu satırları silmek, uydurma bir fiyat girmekten daha az zarar verir. Orta banttaki, nadiren kullanılan bir anket alanı tahmini bir değerle doldurmaya değmez; bu yüzden sütun çıkarılır. Kayıp analizinde kullandığınız müşteri kıdemi ise kalır ve tahmin edilerek doldurulur.
Google'ın veri hazırlamaya ilişkin kümeleme rehberi üç pratik seçenek sunar: eksik değer içeren örnekleri kaldırmak, özelliği kaldırmak veya eksik değerleri diğer verilerden tahmin etmek. Seyrek boşluklar satır silmeyi haklı çıkarabilir. Sık görülen boşluklarda ise genellikle özelliği çıkarırsınız ya da değerleri doldurursunuz.
Sabit bir değer yapıştırmak yerine boşluğu tahmin edin
Sayısal bir alan için, değerin mevcut olduğu satırlarda bir regresyon modeli eğitin, ardından boşlukları tahmin edin. Örneğin eksik müşteri yaşı, tüm şirket için tek bir ortalamayla değiştirilmek yerine gelir ve kıdemden tahmin edilebilir. Bu yöntem, zaten güvendiğiniz ilişkileri kullanır.
Sipariş tutarı çarpık dağılır. Birkaç büyük toptan satış fişi ortalamayı yukarı çeker; bu yüzden ortalamayla doldurma, sıradan sepetleri olduğundan daha zengin gösterir. Medyan tipik siparişin yanında durur ve tek bir toplu fatura geldiğinde daha az oynar. Doldurmadan önce ve sonra özet istatistikleri karşılaştırın. Büyük bir kayma, yöntemin bir boşluğu yamamak yerine işi yeniden yazdığı anlamına gelir.
Kategorilerde boşluğu Unknown olarak etiketleyin. Boşluk çoğu zaman sinyalin kendisidir: bölgeyi hiç kaydetmeyen bir ödeme akışı ya da tedarikçi kodu olmayan bir ürün. Bunu gerçek bir düzeye dönüştürmek satırı korur ve modele alanın kasıtlı olarak boş olduğunu gösterir.
Operasyonlarda sık boşluklar nadir değildir. 2025 tarihli, eksik su tüketimi verilerini ele alan bir çalışma, Şubat 2019'dan Aralık 2023'e uzanan 33.888 saatlik kayıttan oluşan bir bina veri setini anlatır; saatlerin %20'sinde değerler eksiktir. Bu oran, topluca satır silmenin geçmiş verinin çok büyük bölümünü çöpe atacağı banda denk gelir (çalışma).
Doldurucuyu (imputer) yalnızca eğitim satırlarına uydurun. Sıralamadan çok yöntem üzerine ikinci bir okuma yapmak isterseniz, ELECTE'nin eksik veri rehberi doldurma seçeneklerini daha ayrıntılı anlatır.
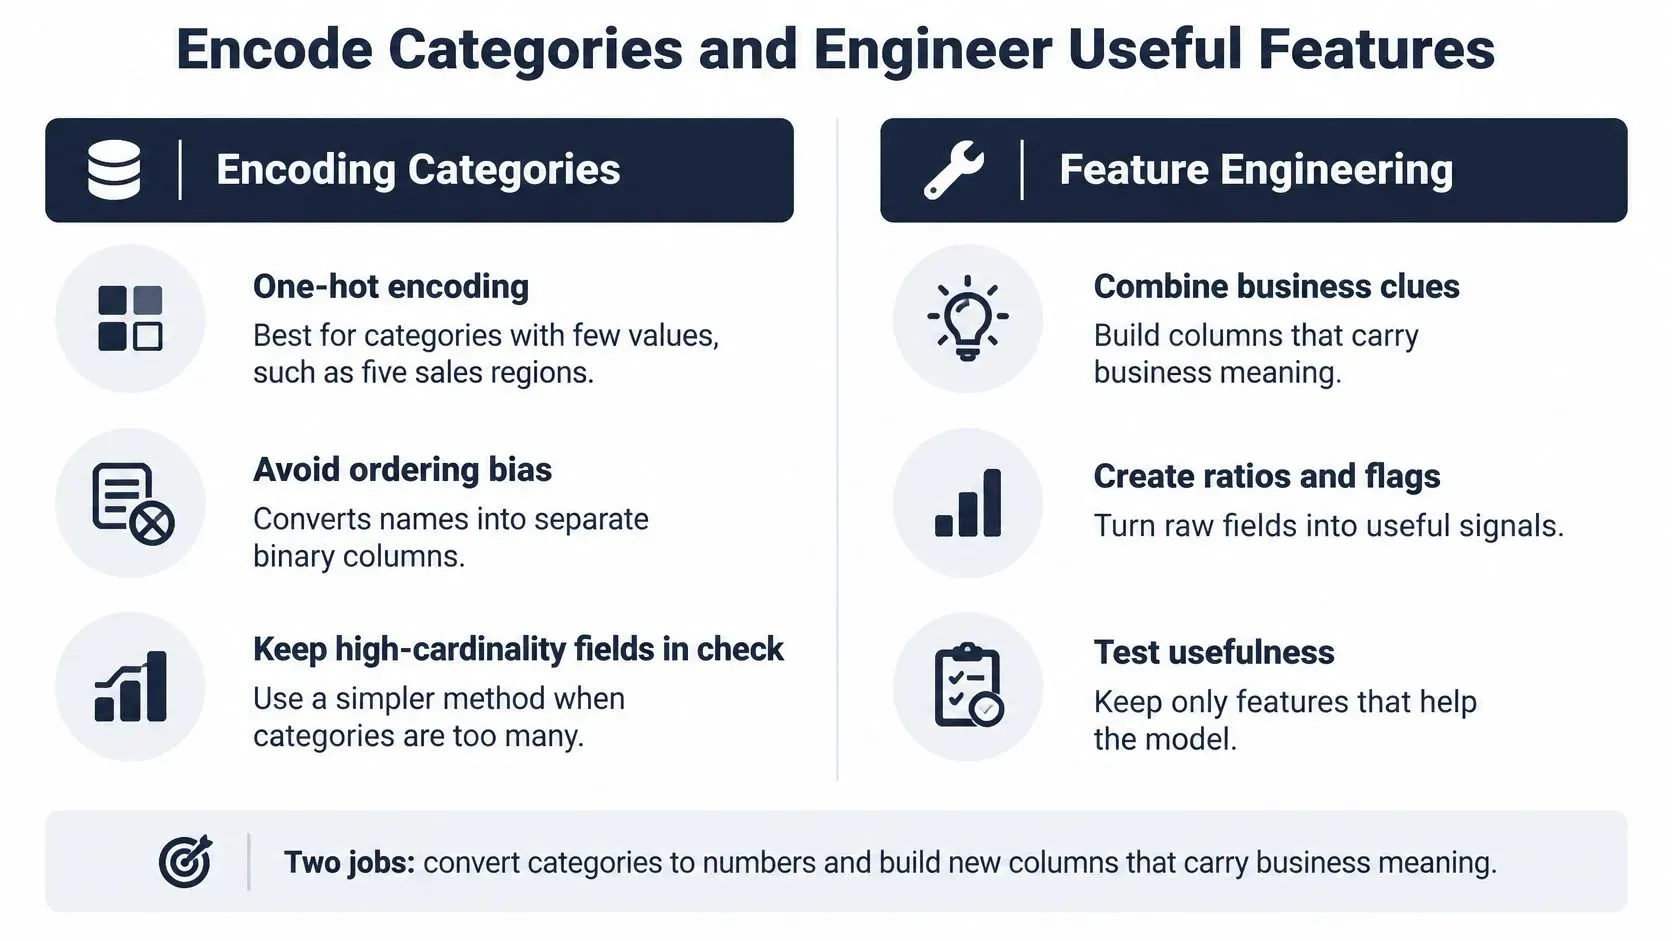
Kategorileri Kodlayın ve Faydalı Özellikler Üretin
Burada iki iş var. Etiketleri modelin kullanabileceği sayılara çevirin ve ham alanların yanıtlamadığı bir iş sorusunu yanıtlayan sütunlar oluşturun.
Sahte sıralama yaratmadan kodlama
One-hot kodlama, beş satış bölgesi gibi az değerli kategorilere uygundur. Her bölge kendi evet/hayır sütununa dönüşür ve hiçbir bölge diğerinden "büyük" sayılmaz.
Ordinal kodlama, S, M ve L bedenleri gibi gerçek bir sıraya uygundur. Sayılar, işletmenin zaten kullandığı bir sıralamayla örtüşür.
Kanal veya şehir gibi sırasız adlara 1, 2, 3 atamayın. Model, yüksek bir kodu daha fazla bir şey olarak ele alır. Bu yanlış sıralama sonradan, kendinden emin ama yanlış bir katsayı olarak karşınıza çıkar. Bir alanın yüzlerce düzeyi varsa one-hot kodlama çok geniş bir tablo oluşturur. Kodlamadan önce nadir düzeyleri Other altında toplayın ve bu gruplamayı yalnızca eğitim satırlarından öğrenin.
Bir iş sorusunu yanıtlayan sütunlar
Yazabildiğiniz her oranı yığmayın; tek bir karara bağlı kısa bir liste oluşturun.
- Marj yüzdesi:
(price − cost) / price, bir promosyonun maliyeti hâlâ karşılayıp karşılamadığını gösterir; yalnızca gelir bunu göstermez. - Son satın alımdan bu yana geçen gün sayısı: müşteri kaybı analizi için müşteri kimliğinin bir kopyası daha değil, son etkileşimin ne kadar yakın olduğu gerekir.
- Haftanın günü ve ay: talep planlaması, tam zaman damgasının içinde gizli kalan cuma zirvelerini ve mevsimsel ayları dikkate alır.
- 7 günlük hareketli ortalama: günlük satış adetleri dalgalanır. Haftalık ortalama, talebin artıp artmadığını gösterir.
- Stok/satış oranı: stok yöneticisi, ham eldeki stok sayısına bakarken göremeyeceği bir tedarik sıkıntısını daha erken fark eder.
O tek karara bağlı on ila on beş özellikle başlamanızı öneririm. Sütunlar arasındaki korelasyon 0,95'in üzerindeyse birini çıkarın; çünkü ikinci sütun birincisini tekrar eder. Veri sözlüğünde sütun adının yanına iş anlamını yazın. Ayırmayı planladığınız satırlar dahil tüm dosya üzerinde öğrenilen bir kodlama haritası ya da hareketli ortalama, bölme aşamasında zaten engellediğiniz sızıntıyı yeniden yaratır.
Sayıları Ölçeklendirin, Aykırı Değerleri Dizginleyin
Uç bir değer otomatik olarak hata değildir. Bir B2B hesabından gelen 40 adetlik sipariş gerçek bir satıştır. Ortalamaya hâkim olmasın diye işaretleyin, ancak geçmişte bırakın. 1.000 yerine yanlışlıkla yazılmış 100.000 birim fiyat ise bir giriş hatasıdır. Rakamı düzeltin, onu talep olarak "işlemeyin".
Silmeden önce uç değeri kontrol edin
İki kontrol birlikte iyi çalışır. 1,5 × çeyrekler açıklığı (IQR) kuralı, sütunun ortasından uzak noktaları işaretler. Alan kontrolü ise değerin var olup olamayacağını sorar: negatif stok, önümüzdeki on yıla ait bir tarih, satış fiyatından yüksek bir indirim. Önce doğrulayın. Sonra 1. ve 99. yüzdelik dilimlerde sınırlandırın, çarpık gelire logaritmik dönüşüm uygulayın ya da bir işaret ekleyip ham sayıyı raporlama için saklayın.
Sildiğiniz toplu sipariş, bir daha asla tahmin edemeyeceğiniz gelirdir. Tuttuğunuz bir yazım hatası ise modelin müşterilerin ödeyeceğini sandığı bir fiyata dönüşür.
Sınırlandırmadan sonra özeti yeniden çalıştırın. Sütunun merkezi neredeyse hiç oynamamalı. Medyan sıçrıyorsa sınırlandırma fazla iş yapıyordur ve kaynak satırlara yeniden bakmalısınız.
Hangi ölçekleyici profile uyar
Ölçekleme, yıllık gelir gibi büyük birimli bir sütunun, sipariş başına adet gibi küçük birimli bir sütunu bastırmasını önler. Scikit-learn'in ön işleme dokümantasyonu, StandardScaler'ın her özelliği eğitim kümesi ortalamasına göre merkezlediğini ve varyansa göre ölçeklediğini, çok sayıda aykırı değer olduğunda kötü performans verebildiğini belirtir. RobustScaler, merkez ve aralık için daha dirençli tahminler kullanan, doğrudan yerine geçebilecek seçenektir.
Veri Profili | Ölçekleyici | Neden Uygun |
|---|---|---|
Yaklaşık simetrik, az sayıda uç değer | StandardScaler | Ortalamaya göre merkezler, varyansa göre ölçekler |
Yoğun aykırı değerler, örneğin ara sıra gelen toplu siparişler | RobustScaler | Uç değerlere dayanıklı olan medyan ve çeyrekler açıklığını kullanır |
Değerlerin sabit bir aralıkta olması gerekir, örneğin 1 ile 5 arası puanlar | MinMaxScaler | Değerleri şekillerini değiştirmeden 0-1 aralığına eşler |
Ölçekleyiciyi (scaler) yalnızca eğitim verisine uydurun, ardından bu uyumu doğrulama verisine uygulayın. Ölçekleyiciyi ayrılmış (held-out) veri kümesi üzerinde yeniden uydurursanız, doğrulama kümesindeki uç değerli satırlar ölçeği belirlemeye başlar. Bir işlem seçmeden önce uç değerleri nasıl tespit edeceğinizi daha yakından görmek için ELECTE’nin aykırı değerler rehberine göz atın.
Boru Hattını Otomatikleştirin ve Çıktılarını Kontrol Edin
Tek bir not defterinde saklanan temizlenmiş dosya, çalıştırmalar arasında kayabilir. Yeni bir dosya farklı bir doldurma değeri, kategori kodlaması ya da ölçek alabilir; bu da iş altyapısı değişmemiş olsa bile panonun değişmesine yol açar.
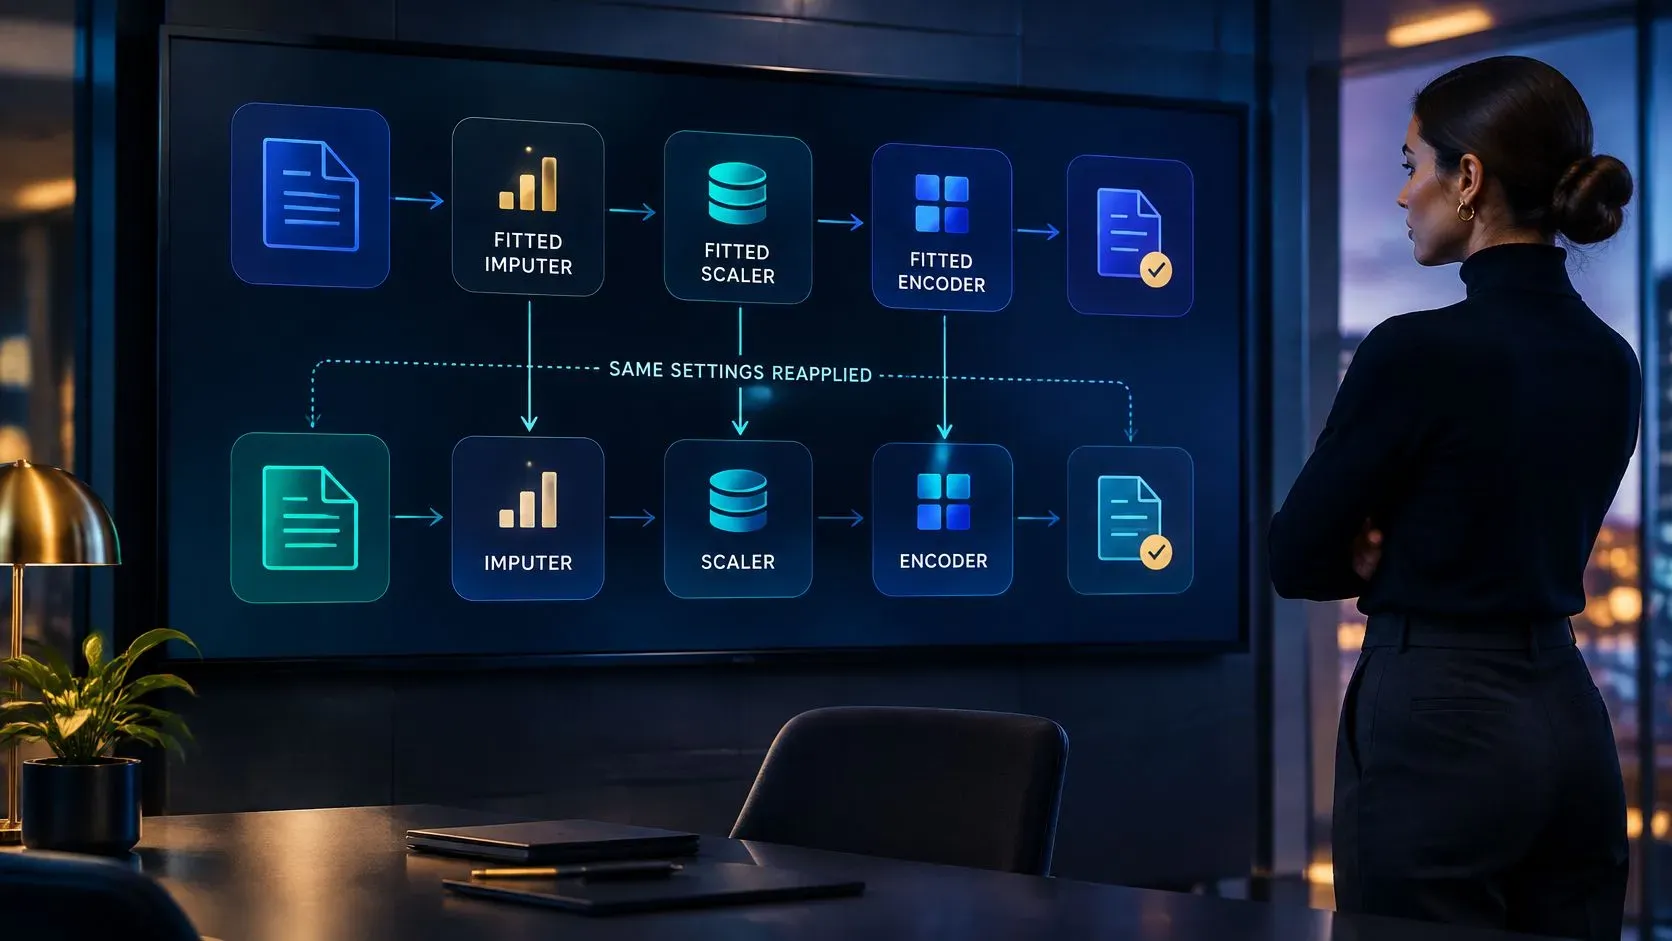
Bir boru hattı, fit edilmiş doldurucuyu, kodlayıcıyı ve ölçekleyiciyi bir arada tutar, ardından aynı dönüşümleri yeni dosyalara uygular. Bu adımları yalnızca eğitim bölümünü kullanarak fit edin. Fit edilmiş ayarları doğrulama ve test verisine yeniden hesaplamadan uygulayın. IBM'in veri sızıntısı üzerine notu, ön işleme adımlarını eğitim ve test verisinin tamamı üzerinde fit etmenin değerlendirmeye nasıl bilgi sızdırabileceğini açıklar.
Her çalıştırmadan sonra kontroller
Başarılı bir iş yalnızca sürecin çalıştığını doğrular. Çıktının hâlâ kaynakla ve belirlediğiniz kurallarla uyuşup uyuşmadığını kontrol edin:
- Satır sayıları: yüklenen dosyayı dışa aktarımla karşılaştırın ve kaydedilen yinelenen kayıtları hesaba katın.
- Sütun başına boş değer oranı: ani bir artışı inceleyin; bu, bir kaynak alanın artık gelmediği anlamına gelebilir.
- Değer aralıkları: fiyatların, miktarların ve tarihlerin kabul edilen sınırlar içinde kaldığını kontrol edin.
- Yeni kategoriler: daha önce görülmemiş bir bölgeyi veya SKU'yu haber vermeden silmek yerine tanımlı bir gruba yönlendirin.
Veri doğrulamaya ilişkin pratik örnekler için, bu kontrollerin iş dosyalarına nasıl uygulandığını inceleyin. Otomatik çıktıları tahmin olarak değerlendirin ve bunlarla uyarı tetiklemeden önce ilk birkaç döngüyü elle gözden geçirin.
Büyüyen şirketler için yapay zekâ destekli bir veri analitiği platformu olan ELECTE, muhasebe yazılımına veya yüklenen bir dosyaya bağlanır ve analist gerektirmeden veri analizi ve tahmin çalıştırır. Müşteriler finansal analizi otomatikleştirerek haftada 10+ saat tasarruf eder. Bu destek, her yüklemede yeniden hesaplamak yerine bir incelemede savunabileceğiniz, eğitilmiş adımlar kullanmaya bağlıdır.
Bu hafta bir veri setini yedi satırlık tablodan geçirin ve hangi adımların hâlâ elle yapıldığını işaretleyin. Tekrarlanan bir adımı otomatikleştirin, ancak yinelenen kayıt ile gerçek bir yeniden sipariş ya da yazım hatası ile toplu sipariş gibi yargı gerektiren durumları, kurallar oturana kadar incelemede tutun.
ELECTE muhasebe verilerinizi veya yüklediğiniz dosyayı bağlar, hazırlar ve ekibinizle birlikte inceleyebileceğiniz tahminlere ve raporlara dönüştürür. Bu veri ön işleme adımlarının her yüklemede aynı şekilde uygulanmasını istiyorsanız ELECTE sayfasını ziyaret edin ve platformun bu süreci kendi rakamlarınız üzerinde nasıl çalıştırdığını görün.
Yorumlar
Henüz yorum yok — konuşmayı başlatın.