Etapy wstępnego przetwarzania danych: jak oczyścić dane biznesowe
Poznaj etapy wstępnego przetwarzania danych, które zamieniają chaotyczne rekordy biznesowe w wiarygodne wnioski, z przykładami dla MŚP. Zobacz, jak ELECTE je automatyzuje.
Pobierasz eksport sprzedaży, który wygląda na gotowy. Arkusz wypełniają zamówienia, koszty i daty. Potem prognoza trafia na biurko szefa finansów, a średnia wartość zamówienia skoczyła, mimo że w katalogu nic się nie zmieniło.
Taki skok to często błąd przetwarzania wstępnego, a nie zmiana zachowań kupujących. Uzupełnianie pustych cen, gdy w pliku wciąż są zduplikowane faktury, albo skalowanie całego eksportu, zanim odłożysz część wierszy, uczy model faktów, których nie powinien jeszcze znać. Większość opracowań przedstawia etapy wstępnego przetwarzania danych jako osobne techniki, które można stosować w dowolnej kolejności. To właśnie kolejność zawyża wyniki.
Poniżej znajdziesz sekwencję, którą polecam, gdy analityk odpowiada za działający plik biznesowy. Dostaniesz kolejność działań, progi, które traktuję jako punkt wyjścia, a nie prawo, oraz sposób na zablokowanie każdego dopasowanego ustawienia, tak aby kolejne ładowanie danych przebiegało tą samą ścieżką.
Siedem etapów przetwarzania wstępnego danych we właściwej kolejności
Eksport sprzedaży może wyglądać na kompletny, a mimo to ukrywać zduplikowane wiersze faktur, puste koszty jednostkowe i daty zapisane w dwóch formatach. Jeśli usuniesz te problemy w złej kolejności, każda kolejna średnia je odziedziczy.
Każdy krok, który uczy się liczby na podstawie danych, musi działać po podziale. Średnia, mediana lub zakres skalowania policzone na całym pliku pozwalają wierszom walidacyjnym wpływać na zbiór treningowy. Wynik wygląda wtedy lepiej, niż model poradzi sobie z zamówieniami w przyszłym miesiącu.
Etap | Co robisz | Gotowe, gdy |
|---|---|---|
1. Profilowanie i czyszczenie | Sprawdzasz liczbę wierszy, typy danych i odsetek wartości pustych; usuwasz dokładne duplikaty; ujednolicasz daty i etykiety | Masz czystą tabelę bazową z jedną etykietą na kategorię |
2. Podział danych | Mieszasz wiersze, a następnie dzielisz je na zbiór treningowy i walidacyjny | Istnieją dwa zbiory i nie obliczono jeszcze żadnych dopasowanych ustawień |
3. Obsługa brakujących wartości | Usuwasz wiersze, usuwasz cechę albo uzupełniasz braki, korzystając wyłącznie z danych treningowych | Każde pole jest kompletne lub jego braki są oznaczone |
4. Kodowanie i inżynieria cech | Zamieniasz kategorie na liczby; tworzysz wskaźniki, składniki czasu i średnie kroczące | Masz tabelę cech gotową dla modelu, z udokumentowanymi kolumnami |
5. Obsługa wartości odstających | Weryfikujesz wartości skrajne, a potem je ograniczasz, przekształcasz lub oznaczasz | Wartości skrajne są wyjaśnione, a nie zgadywane |
6. Skalowanie cech numerycznych | Dopasowujesz skaler na danych treningowych i stosujesz go do danych walidacyjnych | Kolumny numeryczne mają porównywalne zakresy |
7. Zablokowanie potoku | Zapisujesz każde dopasowane przekształcenie, aby nowe dane przechodziły tą samą ścieżką | Powtarzalny przebieg, który działa przy każdym nowym ładowaniu danych |
Załóżmy, że sklep ma 12 000 pozycji zamówień, w tym 900 zduplikowanych wierszy faktur. Jeśli uzupełnisz brakujące ceny przed usunięciem tych duplikatów, ta sama faktura zostanie policzona dwa razy, a średnia odbiegnie od cennika.
Praktyczna zasada: Zakończ pracę nad bieżącym wierszem, zanim policzysz cokolwiek, czego potrzebuje następny.
Przyłóż plik, który masz teraz otwarty, do tych siedmiu wierszy. Pierwszy wiersz, którego jeszcze nie skończyłeś, to jedyny, którym warto się dziś zająć.
Profilowanie i czyszczenie surowych danych biznesowych
Profilowanie to godzinny przegląd, który menedżer może zakończyć, zanim ktokolwiek otworzy model. Zachowaj surowy plik bez zmian, a każdą modyfikację zapisuj w dzienniku czyszczenia, aby dyrektor finansowy widział, dlaczego zmieniła się dana suma.
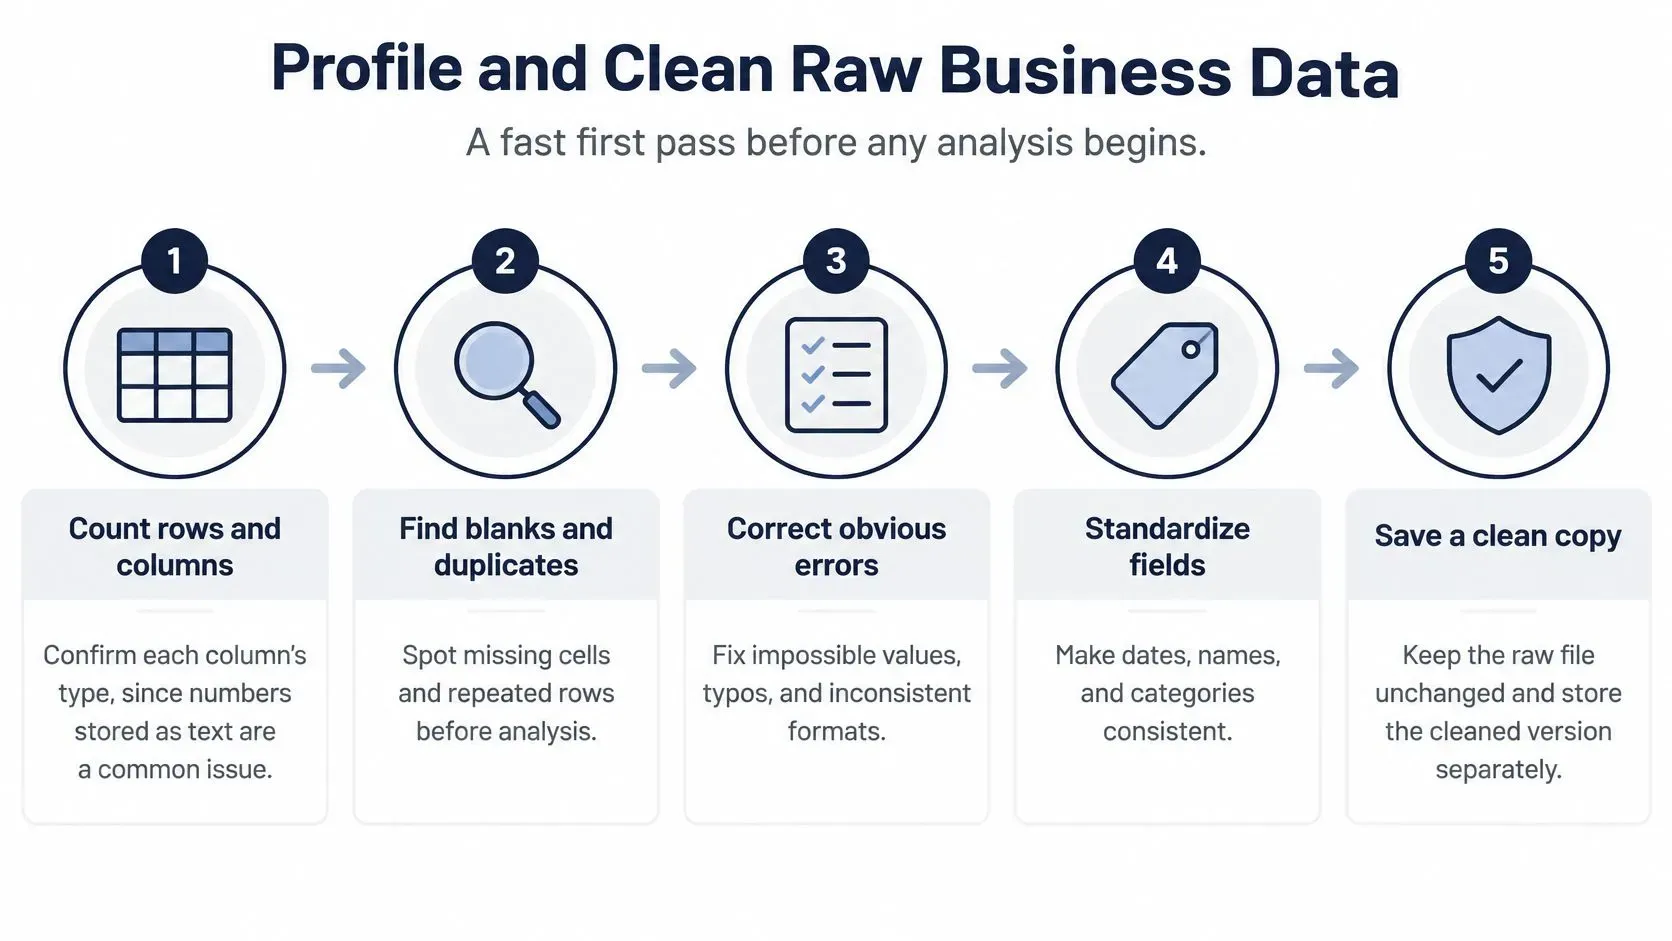
- Policz wiersze i kolumny, a potem potwierdź typ każdej z nich. Koszt zapisany jako tekst nie zsumuje się i nie zgłosi tego wyraźnym błędem. Przekonwertuj go, zanim zaufasz sumie.
- Oblicz odsetek braków w każdej kolumnie. Kolumna z ponad 30% pustych pól trafia pod reguły dla brakujących wartości, a nie pod szybkie uzupełnienie. Całą kolumnę usunąłbym tylko wtedy, gdy braki przekraczają 50%, a pole nie jest potrzebne do podjęcia decyzji.
- Usuwaj dokładne duplikaty, a nie rekordy tylko podobne. Dopasowuj jednocześnie numer faktury, datę i kwotę. Drugie zamówienie z innym identyfikatorem pozycji to prawdziwa sprzedaż. Usunięcie go tylko dlatego, że zgadzają się klient i dzień, to błąd, który zaniża przychody.
- Ujednolić formaty w jednym przebiegu. Jeden wzorzec daty, jedna waluta w kolumnie i żadnych zbędnych spacji w kodach. Mieszane formaty dzielą jeden produkt na dwie serie i psują każde późniejsze łączenie danych.
- Ujednolić etykiety kategorii.
UK,U.K.iUnited Kingdomto jeden rynek. Cztery pisownie jednej linii produktowej w trzyletnim eksporcie z e-commerce robią tę samą szkodę. Wybierz jedną etykietę i przypisz do niej pozostałe.
Załóżmy, że ten eksport zapisuje daty zamówień jako 2024-03-01 w jednym roku i 01/03/2024 w innym. Dopóki oba zapisy nie zostaną sprowadzone do jednego wzorca, miesięczny wykres podwoi marzec albo go pominie.
Co chronią dziennik i usuwanie danych osobowych
Dziennik czyszczenia to krótka tabela: kolumna, reguła, liczba zmienionych wierszy, osoba, data. Gdy dział finansów zapyta, dlaczego zeszły marzec się skurczył, wskażesz regułę duplikatów zamiast odtwarzać plik z pamięci.
Zanim plik trafi na jakąkolwiek platformę analityczną, usuń imiona i nazwiska klientów, adresy e-mail i dane płatnicze. Nie są potrzebne do prognozowania popytu, a pozostawienie ich w wyciągu tworzy problem z prywatnością, którego nie naprawi żaden model.
Jeśli chcesz poznać drugą opinię o tym, jak wygląda „dobry” wyciąg danych handlowych, wnioski Pipecorn o jakości danych sprzedażowych to przydatna lista kontrolna dotycząca identyfikatorów, kompletności i spójności. Użyj ich, by zdecydować, które kolumny warto zachować, a potem wróć do wspomnianego wyżej progu braków.
Podziel dane, zanim zacznie się jakakolwiek nauka
Podział to ogrodzenie. Nic, co szacuje jakąkolwiek statystykę, nie powinno działać na pełnym pliku.
W przypadku nadzorowanej klasyfikacji tekstu przewodnik Google dotyczący klasyfikacji tekstu zaleca przetasowanie danych przed podziałem, ponieważ zachowanie pierwotnej kolejności może zniekształcić oba zbiory. Po przetasowaniu typowy podział przydziela 80% przykładów do zbioru treningowego i 20% do walidacyjnego. Te same transformacje stosuje się potem do obu zbiorów, ale dopiero po tym, jak zostaną wyuczone na wierszach treningowych.
Dlaczego posortowany plik sprzedaży kłamie
Eksporty często przychodzą posortowane według daty, regionu lub klienta. Jeśli podzielisz taki plik od góry do dołu, trenujesz na danych z 2023 roku, a walidujesz na końcówce 2024. Wynik odzwierciedla wtedy kalendarz, kalendarz promocji albo strukturę jednego regionu. Nie mówi, czy model zrozumiał zamówienia.
Tasuj dane, gdy każdy wiersz jest niezależnym przypadkiem: zamkniętym zamówieniem, utraconym kontem, sklasyfikowanym zgłoszeniem. Nie tasuj, gdy pytanie dotyczy prognozy.
Do prognozowania zachowaj kolejność czasową. Trenuj na wcześniejszych miesiącach, a testuj na późniejszych. Przetasowanie pozwoliłoby modelowi zobaczyć przyszłość i uznać to za umiejętność.
Pola tekstowe wymagają odcięcia według częstości
Zgłoszenia do wsparcia i opisy produktów rozrastają się do tysięcy tokenów. W tym samym procesie Google odrzuca się tokeny występujące mniej niż dwa razy, zachowuje się 20 000 najlepszych cech tokenowych, a pozostałe szereguje według oceny ważności opartej na teście F. Token, który pojawia się raz, to zwykle literówka lub jednorazowy SKU, a nie wzorzec wart osobnej kolumny.
Po podziale dopasuj wszystkie mapowania wyłącznie na danych treningowych, a następnie zastosuj to zamrożone mapowanie do walidacji. Ponowne obliczanie słownika lub listy kategorii na zatrzymanych wierszach to kolejny sposób na przeciek odpowiedzi do przygotowania danych.
Uzupełnianie brakujących wartości bez zniekształcania wyników
O działaniu decyduje to, jak często pole jest puste i czy decyzja go potrzebuje. Poniższe przedziały to praktyczna reguła, a nie prawo. Regulowany model ryzyka może nie pozwolić na usunięcie wierszy, które prognoza sprzedaży detalicznej może pominąć.
Odsetek braków | Ważność cechy | Działanie |
|---|---|---|
Poniżej 5% | Dowolna | Usuń te wiersze, jeśli zostanie wystarczająco dużo danych |
5% do 30% | Niska | Usuń cechę |
5% do 30% | Wysoka | Uzupełnij na podstawie samych wierszy treningowych |
Powyżej 30% | Wysoka | Uzupełnij, dodaj kolumnę znacznika braku i sprawdź, dlaczego pole jest puste |
Powyżej 30% | Niska | Usuń cechę |
Kilka pustych pól kosztu w kompletnym skądinąd pliku zamówień to pierwszy wiersz tabeli. Usunięcie tych linii szkodzi mniej niż zmyślanie ceny. Rzadko używane pole ankiety w środkowym przedziale nie jest warte domyślnego uzupełnienia, więc kolumnę się usuwa. Staż klienta, którego używasz do analizy rezygnacji, zostaje i go szacujesz.
Wskazówki Google dotyczące przygotowania danych do klasteryzacji wymieniają trzy praktyczne opcje: usunięcie przykładów z brakującymi wartościami, usunięcie cechy albo przewidzenie brakujących wartości na podstawie innych danych. Rzadkie braki mogą uzasadniać usuwanie wierszy. Częste braki zwykle oznaczają, że usuwasz cechę albo ją uzupełniasz.
Przewiduj lukę zamiast wklejać stałą
Dla pola liczbowego wytrenuj regresję na wierszach, w których wartość istnieje, a potem oszacuj braki. Brakujący wiek klienta można na przykład oszacować na podstawie dochodu i stażu, zamiast zastępować go jedną średnią dla całej firmy. Wykorzystujesz wtedy zależności, którym już ufasz.
Wartość zamówienia ma rozkład skośny. Kilka dużych transakcji hurtowych podnosi średnią, więc uzupełnienie średnią sprawia, że zwykłe koszyki wyglądają na zasobniejsze, niż są. Mediana leży przy typowym zamówieniu i mniej się zmienia, gdy pojawi się jedna duża faktura. Porównaj statystyki opisowe przed uzupełnieniem i po nim. Duża zmiana oznacza, że metoda przepisuje biznes, zamiast łatać dziurę.
W przypadku kategorii oznacz puste pole jako Unknown. Luka często sama jest sygnałem: kasa, która nie zapisała regionu, albo produkt bez kodu dostawcy. Zamiana tego w pełnoprawny poziom zachowuje wiersz i pokazuje modelowi, że pole było puste nieprzypadkowo.
Częste braki w operacjach to norma. Jedno badanie z 2025 roku o niekompletnych danych zużycia wody opisuje zbiór budynku z 33 888 godzinnymi rekordami od lutego 2019 do grudnia 2023, z brakami w 20% godzin. To przedział, w którym masowe usuwanie wierszy odrzuciłoby zbyt dużo historii (badanie).
Dopasuj imputer wyłącznie na wierszach treningowych. Przewodnik ELECTE o brakujących danych omawia wybór metod uzupełniania dokładniej, jeśli chcesz jeszcze raz przejrzeć samą metodę, a nie kolejność kroków.
Koduj kategorie i twórz użyteczne cechy
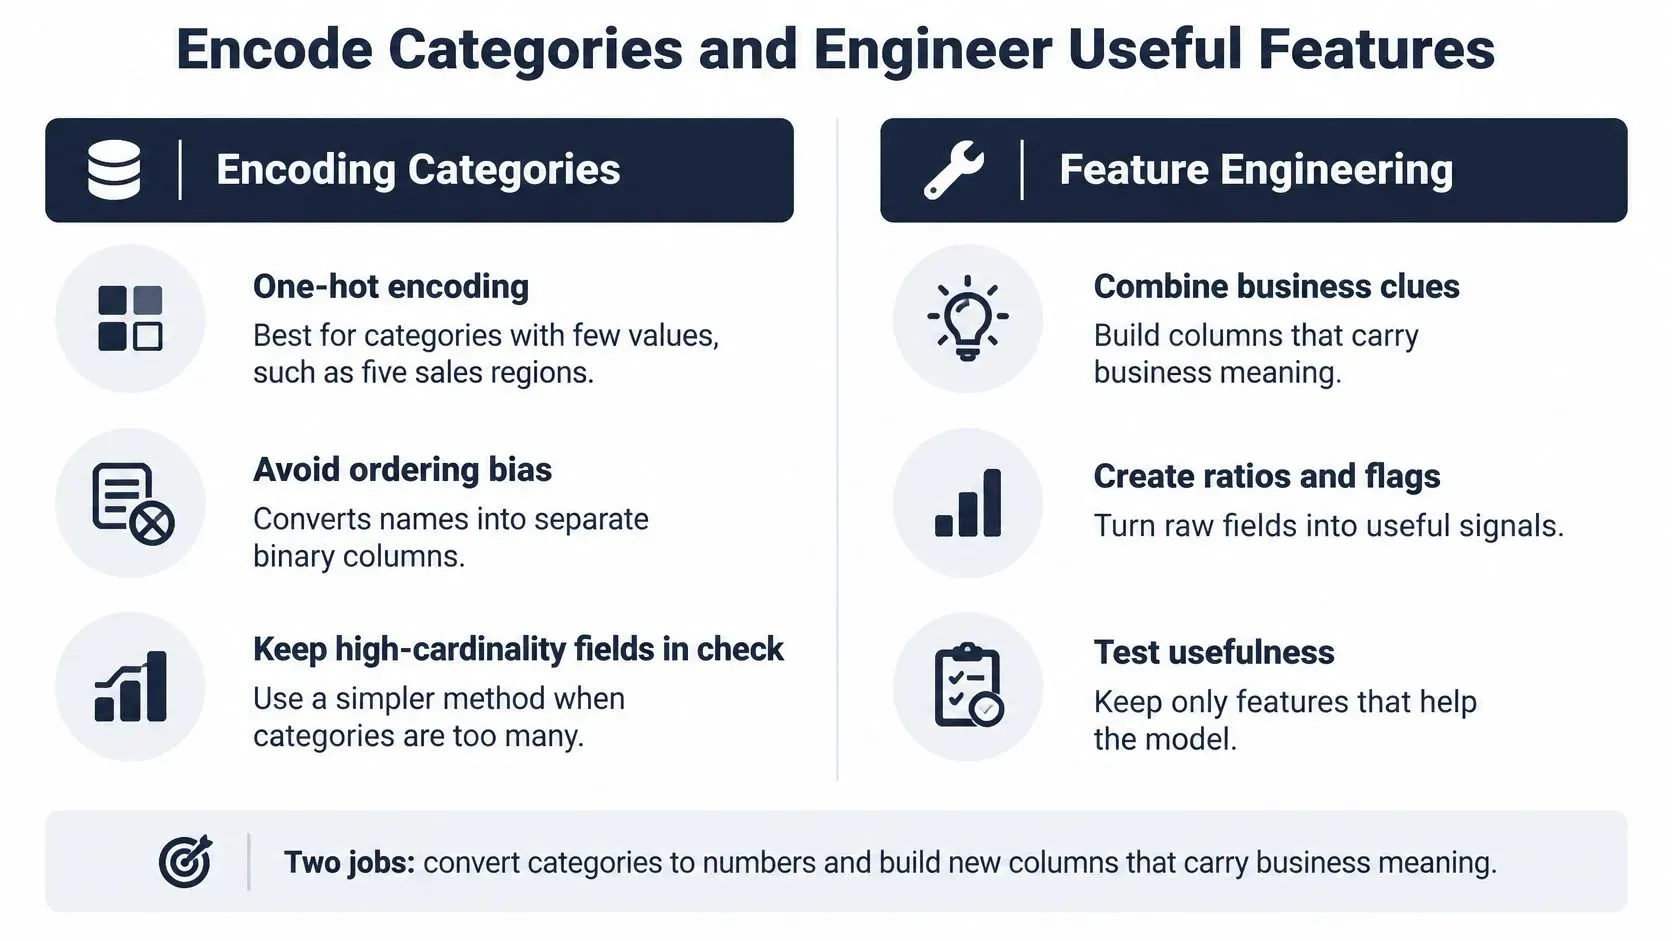
Są tu dwa zadania. Zamień etykiety na liczby, których model może użyć, i zbuduj kolumny odpowiadające na pytanie biznesowe, na które surowe pola nie odpowiadają.
Kodowanie bez fałszywej hierarchii
Kodowanie one-hot pasuje do kategorii o niewielu wartościach, np. pięciu regionów sprzedaży. Każdy region staje się osobną kolumną tak/nie i żaden region nie jest „większy” od innego.
Kodowanie porządkowe pasuje do prawdziwej kolejności, np. rozmiarów S, M i L. Liczby odpowiadają rankingowi, którego biznes już używa.
Nie przypisuj 1, 2, 3 nieuporządkowanym nazwom, takim jak kanał czy miasto. Model uzna wyższy kod za „więcej” czegoś. Ta fałszywa hierarchia wychodzi później jako pewny siebie, błędny współczynnik. Gdy pole ma setki poziomów, one-hot tworzy bardzo szeroką tabelę. Zgrupuj rzadkie poziomy w Other przed kodowaniem i ucz się tego grupowania wyłącznie na wierszach treningowych.
Kolumny, które odpowiadają na pytanie biznesowe
Zbuduj krótką listę powiązaną z jedną decyzją, a nie zrzut każdego wskaźnika, jaki potrafisz wymyślić.
- Procent marży:
(price − cost) / pricepokazuje, czy promocja nadal pokrywa koszt, czego sam przychód nie ujawni. - Liczba dni od ostatniego zakupu: analiza odejść klientów wymaga informacji o tym, kiedy klient ostatnio kupił, a nie kolejnej kopii identyfikatora klienta.
- Dzień tygodnia i miesiąc: planowanie popytu uwzględnia piątkowe szczyty i sezonowe miesiące ukryte w pełnym znaczniku czasu.
- Średnia krocząca z 7 dni: dzienna sprzedaż w sztukach mocno się waha. Średnia tygodniowa pokazuje, czy popyt rośnie.
- Wskaźnik zapasów do sprzedaży: menedżer ds. zapasów zauważa rodzący się niedobór wcześniej, niż pozwala na to surowy stan magazynowy.
Zacząłbym od dziesięciu do piętnastu cech powiązanych z tą jedną decyzją. Jeśli korelacja dwóch kolumn przekracza 0,95, usuń jedną z nich, bo druga powtarza pierwszą. W słowniku danych zapisz znaczenie biznesowe obok nazwy kolumny. Mapa kodowania lub średnia krocząca wyuczona na całym pliku, w tym na wierszach, które miały zostać odłożone na bok, powtarza wyciek, przed którym zabezpieczyłeś już podział danych.
Skaluj liczby i opanuj wartości odstające
Wartość skrajna nie zawsze jest błędem. Zamówienie na 40 sztuk od klienta B2B to realna sprzedaż. Oznacz je flagą, żeby nie zaburzało średniej, i zostaw w historii. Cena jednostkowa 100 000 wpisana zamiast 1000 to błąd wprowadzania. Popraw cyfrę, zamiast „traktować” ją jako popyt.
Sprawdź wartość skrajną, zanim ją usuniesz
Dobrze działają razem dwa sprawdzenia. Reguła 1,5 × rozstęp międzykwartylowy wyznacza punkty oddalone od środka kolumny. Kontrola merytoryczna pyta, czy taka wartość może w ogóle wystąpić: ujemny stan magazynowy, data za dziesięć lat, rabat wyższy niż cena sprzedaży. Najpierw zweryfikuj. Potem przytnij wartości do 1. i 99. percentyla, zastosuj transformację logarytmiczną do skośnych przychodów albo dodaj flagę i zachowaj surową liczbę do raportowania.
Zamówienie hurtowe, które usuniesz, to przychód, którego już nigdy nie zaprognozujesz. Literówka, którą zostawisz, staje się ceną, jaką według modelu zapłacą klienci.
Po przycięciu uruchom podsumowanie ponownie. Środek kolumny powinien przesunąć się minimalnie. Jeśli mediana mocno skacze, przycięcie robi za dużo i warto ponownie przyjrzeć się wierszom źródłowym.
Który skaler pasuje do profilu danych
Skalowanie sprawia, że kolumna w dużych jednostkach, np. roczny przychód, nie zagłusza kolumny w małych jednostkach, np. liczby sztuk w zamówieniu. Dokumentacja preprocessingu scikit-learn wskazuje, że StandardScaler centruje każdą cechę na średniej ze zbioru treningowego i skaluje ją według wariancji oraz że może działać słabo, gdy jest wiele wartości odstających. RobustScaler to zamiennik, który używa bardziej odpornych estymatorów środka i zakresu.
Profil danych | Skaler | Dlaczego pasuje |
|---|---|---|
Rozkład w przybliżeniu symetryczny, mało wartości skrajnych | StandardScaler | Centruje na średniej i skaluje według wariancji |
Wiele wartości odstających, np. okazjonalne zamówienia hurtowe | RobustScaler | Używa mediany i rozstępu międzykwartylowego, które są odporne na wartości skrajne |
Wartości muszą mieścić się w stałym zakresie, np. oceny od 1 do 5 | MinMaxScaler | Mapuje wartości na przedział 0–1 bez zmiany ich kształtu |
Dopasuj skaler wyłącznie na danych treningowych, a następnie zastosuj to dopasowanie do danych walidacyjnych. Ponowne dopasowanie na zbiorze wydzielonym sprawia, że skrajne wiersze walidacyjne wpływają na skalę. Jeśli chcesz dokładniej przyjrzeć się wykrywaniu wartości skrajnych, zanim wybierzesz sposób ich traktowania, zobacz przewodnik ELECTE po wartościach odstających.
Zautomatyzuj pipeline i sprawdzaj jego wyniki
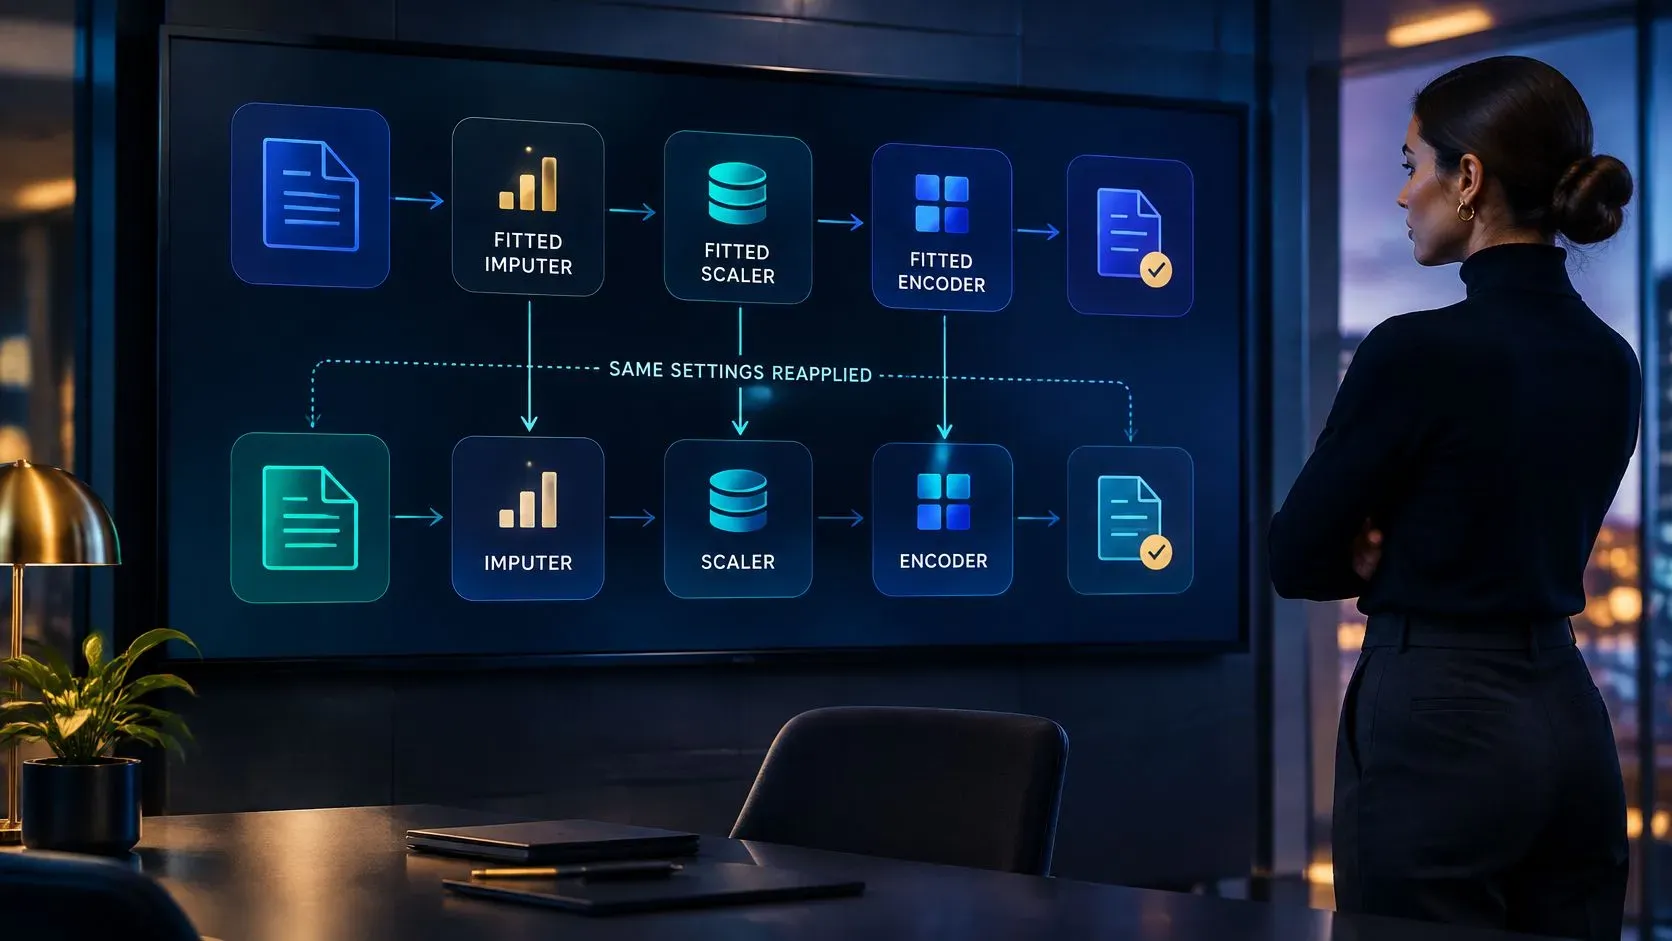
Oczyszczony plik zapisany w jednym notebooku może się rozjeżdżać między kolejnymi uruchomieniami. Nowy plik może dostać inną wartość imputacji, inne kodowanie kategorii lub inną skalę, przez co dashboard się zmieni, choć sam biznes pozostał taki sam.
Pipeline przechowuje razem dopasowany imputer, enkoder i skaler, a potem stosuje te same przekształcenia do nowych plików. Dopasuj te kroki wyłącznie na partycji treningowej. Zastosuj dopasowane ustawienia do danych walidacyjnych i testowych bez ponownego przeliczania. Artykuł IBM o wycieku danych wyjaśnia, dlaczego dopasowywanie kroków preprocessingu na danych treningowych i testowych łącznie może przenieść informacje do oceny modelu.
Kontrole po każdym uruchomieniu
Udane zadanie potwierdza tylko, że proces się wykonał. Sprawdź, czy wynik nadal zgadza się ze źródłem i ustalonymi regułami:
- Liczba wierszy: uzgodnij wczytany plik z eksportem, uwzględniając zapisane w logu duplikaty.
- Odsetek wartości pustych w kolumnie: zbadaj nagły wzrost, który może oznaczać, że pole źródłowe przestało docierać.
- Zakresy wartości: sprawdź, czy ceny, ilości i daty mieszczą się w dopuszczalnych granicach.
- Nowe kategorie: nieznany region lub SKU kieruj do zdefiniowanej kategorii zbiorczej, zamiast po cichu go pomijać.
Aby zobaczyć praktyczne przykłady walidacji danych, sprawdź, jak te kontrole sprawdzają się w plikach biznesowych. Traktuj wyniki automatyczne jako szacunki, a pierwsze kilka cykli przejrzyj ręcznie, zanim użyjesz ich do wyzwalania alertów.
ELECTE, platforma analityki danych oparta na AI dla rozwijających się firm, łączy się z oprogramowaniem księgowym lub wczytanym plikiem i przeprowadza analizę danych oraz prognozy bez udziału analityka. Klienci oszczędzają ponad 10 godzin tygodniowo dzięki automatyzacji analiz finansowych. Ta pomoc zależy od stosowania dopasowanych kroków, które da się obronić podczas przeglądu, zamiast przeliczania ich przy każdym wczytaniu danych.
W tym tygodniu przeprowadź jeden zbiór danych przez tabelę z siedmioma wierszami i zaznacz, które kroki nadal wykonujesz ręcznie. Zautomatyzuj powtarzalny krok, ale decyzje wymagające oceny, takie jak duplikat a rzeczywiste ponowne zamówienie albo literówka a zamówienie hurtowe, zostaw do przeglądu, dopóki reguły się nie ustabilizują.
ELECTE łączy się z Twoimi danymi księgowymi lub wczytanym plikiem, przygotowuje je i zamienia w prognozy oraz raporty, które możesz omówić z zespołem. Jeśli chcesz, aby te kroki przygotowania danych były stosowane tak samo przy każdym wczytaniu, odwiedź ELECTE i zobacz, jak platforma przeprowadza cały proces na Twoich własnych liczbach.
Komentarze
Brak komentarzy — zacznij rozmowę.