Previsión de la demanda en el comercio minorista: métodos, datos y beneficios
Descubre cómo funciona la previsión de la demanda en el comercio minorista, qué métodos utilizar, qué datos necesita y cómo reducir las roturas de stock y el sobrestock con mejores planes de inventario.

Una rotura de stock suele atribuirse al proveedor. La mayoría de las veces empieza mucho más cerca. Un estudio de inventario minorista presentado en la conferencia de Bangladés 2025 de la IEOM Society indica que entre el 51 % y el 73 % de las roturas de stock en supermercados se originan dentro de la propia operación minorista, y que entre las principales causas figuran las previsiones inexactas (incluida la subestimación de la demanda) y los errores de pedido.
Ese hallazgo cambia el enfoque del trabajo. La previsión de la demanda en el comercio minorista no es una competición por elegir el algoritmo más avanzado. Es una disciplina operativa: extraer señales de demanda fiables de datos que las roturas de stock y las promociones ya han distorsionado, adaptar el método a cómo se vende cada producto y conectar el resultado con puntos de reposición que un comprador usará el lunes por la mañana.
Esta guía recorre el ciclo completo. Verás qué debe producir la previsión, qué datos de entrada pesan más, cómo se comparan seis métodos habituales según la situación del comercio, por qué los productos de baja rotación necesitan otra arquitectura, cómo el acopio por parte de los clientes y los cambios de canal inflan el efecto aparente de las promociones, qué métrica de error conviene usar para cada decisión y una comprobación de cinco pasos para hacer antes de tu próximo ciclo de compras.
Qué significa la previsión de la demanda en la tienda
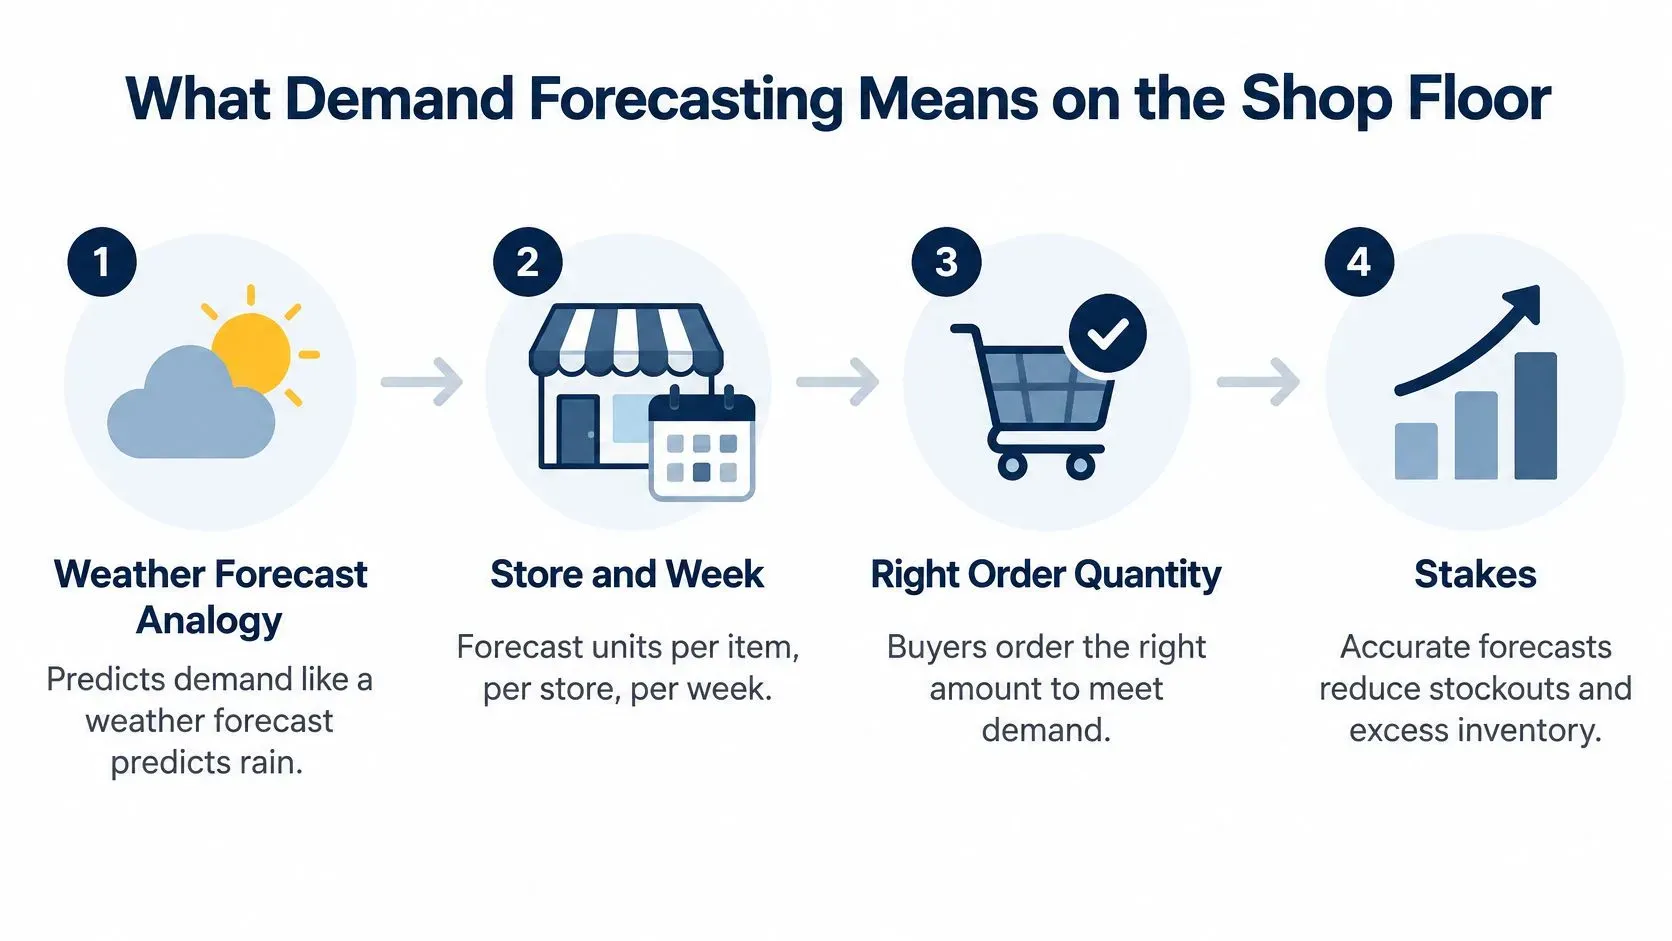
Una previsión meteorológica gana confianza cuando es local y precisa en el tiempo: la probabilidad de lluvia en tu ciudad el martes por la tarde basta para decidir si llevas paraguas. La previsión de la demanda hace el mismo trabajo para el inventario. Estima cuántas unidades de un artículo concreto comprarán los clientes en una tienda concreta durante una semana concreta, para que el comprador pida la cantidad correcta y no una simplemente plausible.
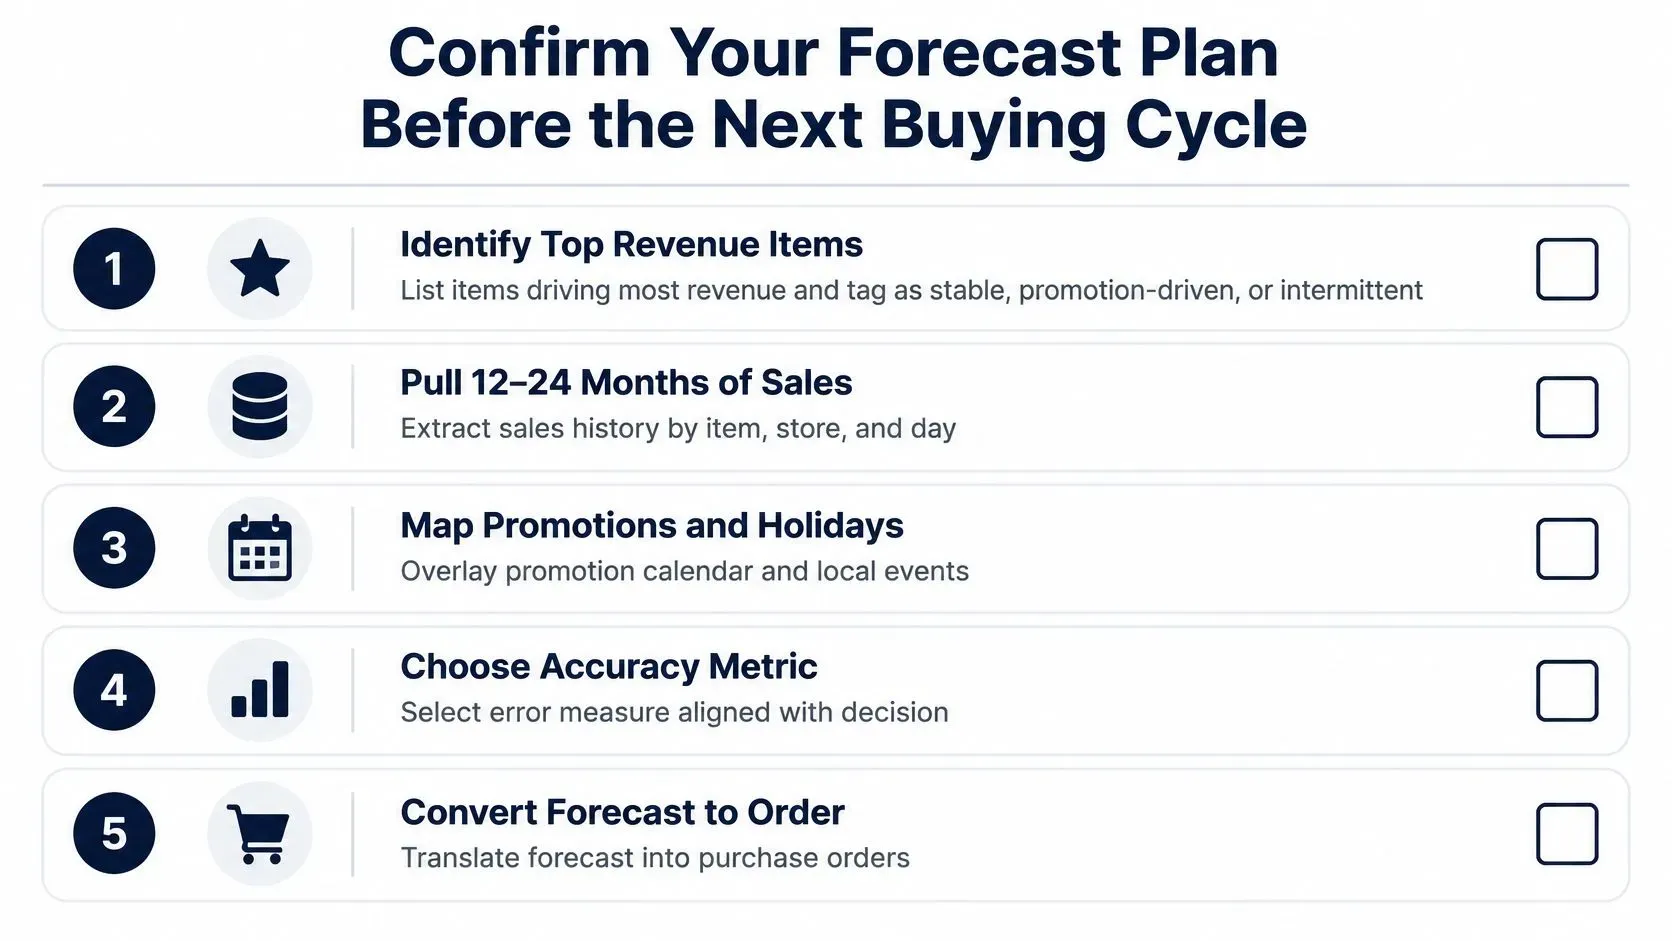
Los cinco pasos siguientes resumen toda la idea, desde la predicción hasta la orden de compra que debería desencadenar.
El objetivo es la demanda, no la cifra de ventas que la caja registró por casualidad. Un cero anotado mientras el lineal de champú estaba vacío es demanda censurada; un pico promocional puede estar adelantado de la quincena siguiente o robado a una tienda cercana. Los promedios por categoría y los informes mensuales ocultan esos problemas por artículo y tienda, así que la señal debe mantenerse granular y actualizarse con frecuencia.
El ciclo de trabajo es el siguiente:
- Recopila el historial de ventas y stock por artículo, tienda y día, incluidos los días en que un lineal estuvo vacío.
- Limpia y alinea los datos: una sola unidad de medida, un solo calendario y ninguna fila duplicada cuando el sistema de una tienda corrige una semana.
- Ajusta y prevé la demanda por artículo y tienda, con la granularidad que exija tu decisión de pedido.
- Traduce la previsión en pedidos y stock de seguridad, usando los plazos de entrega y el nivel de servicio que has prometido.
- Mide los errores y ajusta, artículo por artículo, en lugar de una vez al año al preparar el presupuesto.
Cada paso protege frente a uno de tres costes. Si prevés de menos, pierdes ventas que no se recuperan, porque el cliente compra el sustituto o se va. Si prevés de más, el dinero queda inmovilizado en stock que habrá que rebajar. Si aciertas más o menos la cantidad pero fallas en el momento, pagas por ambos lados: sobrecostes de transporte en el pedido urgente y almacenamiento del excedente.
La regla que más dinero ahorra: una previsión solo se justifica cuando una regla de reposición actúa sobre ella. Una cifra perfecta en un informe no cambia nada en el lineal.
Los datos de entrada y por qué las roturas de stock los distorsionan
Antes de comparar modelos, mira qué entra en ellos. Los datos que más mejoran la precisión en el comercio minorista son previsibles y poco llamativos, y a muchos equipos les faltan dos o tres.
- Historial de ventas por artículo, tienda y día. Cualquier nivel más agregado oculta las semanas de promoción y los picos de fin de semana que contienen la señal.
- Inventario disponible y duración de las roturas de stock. Sin ellos no puedes distinguir una semana tranquila de un lineal vacío.
- Precios y profundidad del descuento. Una rebaja del 10 % y una del 30 % no generan la misma curva de respuesta, así que guarda el precio de lineal que paga el cliente, no el precio de tarifa.
- El calendario promocional, incluida la ubicación en expositores y la publicidad destacada.
- Festivos y eventos locales. Una verbena escolar a dos calles mueve más agua embotellada que un festivo nacional.
- El clima, sobre todo en las categorías de frescos, de temporada y de jardinería.
- Los precios de la competencia, siempre que puedas observarlos de forma consistente.
- Plazos de entrega de los proveedores y retrasos, que determinan cuánta cobertura necesitas.
Por qué un lineal vacío registra un falso cero
Supón que tu champú vende de media 40 unidades a la semana y el lineal queda vacío durante tres días. Esos días registran cero ventas. Un modelo entrenado con ese historial aprende que la demanda cae cada vez que se agota el inventario, justo lo contrario de la realidad. Los clientes que no encontraron nada no cambiaron de opinión; compraron en otro sitio.
Los retrasos de los proveedores, la reposición lenta y tus propias decisiones de pedido censuran las ventas exactamente igual. El modelo no puede distinguir una venta perdida de un interés perdido, y seguirá pidiendo de menos el artículo que antes se agota.
El fallo está bien documentado. Una revisión de 2026 sobre aprendizaje automático en la previsión minorista identifica los conjuntos de datos incompletos, los flujos de datos fragmentados, los cambios en el comportamiento de los clientes, las promociones, las reacciones de la competencia y la estacionalidad como causas de modelos sesgados y frágiles. La misma revisión cita una encuesta a 661 profesionales del inventario en la que el 51 % a veces seguía adelante con previsiones que ya consideraba poco fiables porque no había una alternativa mejor, mientras que los cambios en aranceles y política comercial (19 %) y las oscilaciones de la inflación o de los precios de las materias primas (17 %) figuraban entre los mayores factores de perturbación.
La solución en cuatro pasos, por orden
- Marque cada día de rotura de stock en el historial de ventas, indicando las horas o los días en que el artículo no estuvo disponible.
- Estime las ventas perdidas de esos días a partir de artículos comparables de la misma tienda y la misma semana.
- Etiquete cada período como disponible o restringido antes de iniciar cualquier entrenamiento.
- Entrene con el historial ajustado y compare los resultados en semanas reservadas para validación, nunca en las semanas que haya corregido.
Para la mayoría de las pymes, este trabajo mejora la precisión más que cambiar de algoritmo. Un modelo solo puede aprender lo que contiene el registro; si el registro dice que la demanda se desplomó durante una rotura de stock, una arquitectura más sofisticada simplemente aprende lo equivocado más rápido. Nuestra guía de ELECTE sobre integración de múltiples fuentes explica cómo reunir los datos de ventas, stock y promociones en una única tabla utilizable.
Comparativa de métodos de previsión según la situación del comercio
No existe un método mejor, solo el método que se adapta a cada situación. La tabla siguiente es la comparación que me gustaría tener fijada sobre una mesa de planificación.
Método | Mejor situación en retail | Datos que necesita | Punto fuerte | A tener en cuenta |
|---|---|---|---|---|
Media móvil o suavizado exponencial | Artículos estables y de alto volumen | 1-2 años de ventas semanales | Sencillo, económico y fácil de explicar | No detecta promociones ni cambios estacionales |
Modelos estacionales como SARIMA | Artículos con ciclos semanales o anuales claros | Historial de dos o más temporadas | Capta la tendencia y la estacionalidad | Tiene dificultades con miles de series a la vez |
Métodos de la familia Croston | SKU intermitentes y de baja rotación | Historial de ventas con muchos periodos en cero | Separa la frecuencia de las ventas de su tamaño | Mala elección para productos de venta constante |
Regresión con variables de promoción y precio | Categorías impulsadas por promociones | Calendario de promociones e historial de precios | Muestra cómo mueve la demanda cada factor | Falla cuando hay pocas promociones |
Ensambles de árboles como XGBoost o LightGBM | Grandes carteras de artículo-tienda | Ventas, calendario, promociones y precios | Aprende a partir de muchas series relacionadas | Requiere datos limpios y monitorización continua |
Ensambles híbridos LSTM-XGBoost | Cadenas multicategoría con abundantes señales | 36 meses de datos de punto de venta y promociones | Redujo el error porcentual absoluto medio en un 28,6 % de promedio a un horizonte de cuatro semanas en un estudio con 14 organizaciones de retail | Más costoso de construir y de explicar |
El patrón que hay detrás de las filas importa más que cualquier fila por separado. Una revisión científica con revisión por pares sobre la investigación en previsión para retail indica que los modelos globales de aprendizaje automático, entre ellos las redes neuronales feed-forward y recurrentes, los árboles de regresión con gradient boosting y los random forests, suelen superar a los modelos independientes de series temporales y de regresión cuando los minoristas prevén grandes conjuntos de series de ventas. La ventaja crece con el tamaño del portafolio: miles de combinaciones artículo-tienda en las que cada producto tiene una demanda escasa, intermitente, estacional o sensible a las promociones.
Cómo se ve la comparación en una cadena real
Imagine una cadena regional con 40 tiendas. Los artículos básicos con ventas semanales estables usan suavizado exponencial, porque un responsable de categoría puede leer el número y cuestionarlo. La ropa de temporada con ocho promociones al año usa un modelo de gradient boosting entrenado con todas las tiendas a la vez, porque el historial de una sola tienda es demasiado corto para aprender una curva de descuento.
La revisión también deja claro que los métodos más antiguos no están obsoletos. Su rendimiento sigue siendo competitivo con conjuntos de datos más pequeños, productos estables y situaciones en las que importan más la interpretabilidad y la escasez de datos que el último punto de precisión.
La moderación da resultado. Una evaluación de 2026 sobre la demanda del retail en EE. UU. con el conjunto de datos M5, que abarca 25 940 series artículo-tienda en cinco ventanas móviles de 28 días, redujo el error porcentual absoluto ponderado medio de 0,9006 con una referencia seasonal-naive a 0,7022 con un modelo LightGBM que usa la demanda histórica, una mejora de alrededor del 22 %. Añadir variables comerciales y operativas solo llegó a 0,6979, y los indicadores macroeconómicos con retardo, a 0,6978, una mejora de aproximadamente el 0,02 %.
Construya primero la línea base. Un número seasonal-naive o de suavizado exponencial que se obtiene en una tarde le dice si el modelo de aprendizaje automático justificó su complejidad. Ejecute ambos sobre las mismas semanas reservadas para validación y quédese con el ganador.
La elección del modelo debe seguir la escala y la estructura del portafolio, no si el método es más nuevo. Ese único principio le ahorrará más dinero que cualquier búsqueda de hiperparámetros.
Los productos de baja rotación y la demanda escasa necesitan su propio modelo
Algunos productos no tienen un nivel de demanda. Tienen eventos de demanda. Un repuesto que se vende cuatro veces al año, una variante de cola larga en e-commerce, una combinación tienda-SKU que mueve dos unidades al mes: los modelos estacionales estándar los manejan mal, y el motivo es estructural.
Los ceros y las ventas positivas provienen de dos procesos distintos. Que ocurra una venta es una pregunta. De qué tamaño es cuando ocurre es otra. Los métodos tipo Croston las estiman por separado, por eso funcionan bien con datos de retail llenos de ceros. Un benchmark de previsión en retail sobre demanda intermitente reporta para Croston un WAPE del 93,15 % y un MASE de 0,9852, por delante de las alternativas naive y SARIMAX con las que se comparó. Lea ese WAPE como un resultado relativo en una serie llena de ceros, no como una buena puntuación de precisión en términos absolutos.
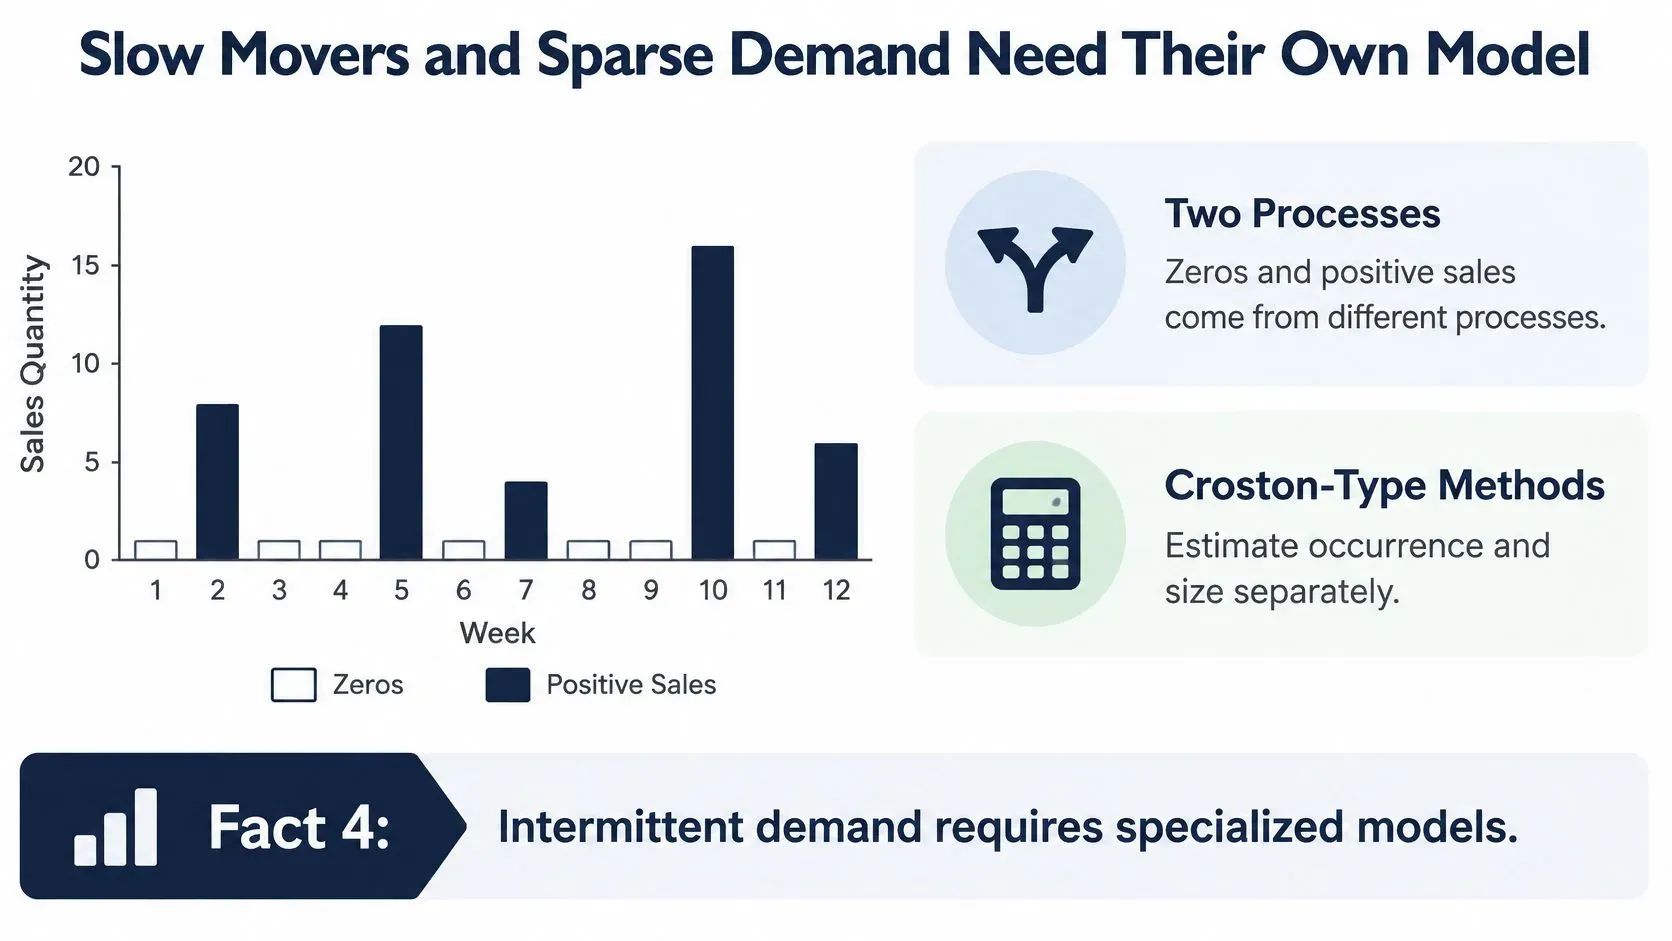
El modo de fallo es concreto y caro. Un modelo de regresión o estacional estándar ve una racha de ceros y concluye que la demanda es baja y estable, así que fija el stock de seguridad en consecuencia. Entonces el producto de baja rotación que se vende en ráfagas impredecibles se agota, mientras el artículo muerto acumula tres meses de cobertura. Un error cuesta una venta; el otro cuesta efectivo y espacio en estantería.
Hay una segunda lección en el mismo terreno. Un benchmark sobre datos de ventas con demanda intermitente, observaciones faltantes y frecuente rotación del surtido encontró que los modelos localizados basados en árboles obtuvieron el mejor resultado entre los enfoques probados, con XGBoost logrando el menor error cuadrático medio reportado, de 4,833. La conclusión no es «use XGBoost en todas partes». Es que, cuando los productos rotan rápido, los modelos construidos por familia de producto pueden superar a un único modelo generalizado obligado a promediar patrones incompatibles.
Cómo asignar cada serie a un modelo
- Clasifique antes de modelar. Calcule el intervalo medio de demanda y el coeficiente de variación al cuadrado de la demanda distinta de cero para cada serie. El primero es el intervalo típico, en periodos, entre ventas; el segundo mide cuánto oscila el tamaño de esas ventas de una a otra.
- Dirija las series intermitentes a modelos de la familia Croston, de tipo hurdle o de ocurrencia-tamaño.
- Envíe los artículos estables y de alto volumen a modelos estacionales o de aprendizaje automático, que es donde les corresponde estar.
- Revise la clasificación cada trimestre. Los artículos cambian de categoría a medida que envejecen, se descontinúan o despegan, y una regla de asignación que nunca se vuelve a ejecutar se degrada.
Mantenga la clasificación en una tabla que pueda consultar. Cuando un responsable de categoría pregunte por qué un producto se prevé con un método extraño, la respuesta deben ser dos números, no un encogimiento de hombros.
Promociones, acopio y cambios de canal
Las semanas promocionales no son semanas normales, y mezclarlas con la línea base corrompe ambas. Modele la demanda base y los efectos de las promociones como cosas separadas y después sume ambas.
Una comparación de enfoques de previsión en retail encontró que los ensambles de árboles de decisión superaban a la regresión lineal, a la regresión lineal penalizada y a los métodos de árboles de regresión para la demanda diaria a nivel de cadena cuando los SKU tenían más de cinco promociones históricas. Cinco es el umbral útil en ese resultado. Por debajo no hay suficientes ejemplos para que un modelo aprenda cómo la profundidad del descuento, el momento de la promoción y las interacciones con el calendario del producto mueven la demanda, así que una regularización más fuerte o una referencia más simple hace menos daño que un modelo flexible que persigue ruido.
Dé al modelo variables explícitas: estado de la promoción, porcentaje de descuento, ubicación en exhibición, cercanía a festivos y demanda posterior a la promoción con retardo. Esta última suele omitirse, pero es la variable que captura la caída.
La caída que nadie prevé
Imagina que un descuento del 30 % en champú impulsa las ventas durante una semana y, después, las ventas se quedan por debajo de la tendencia durante dos semanas. Los clientes hicieron acopio; no compraron más a lo largo del trimestre. Trata toda la ventana de tres semanas como una única unidad de análisis. El error del periodo promocionado te dice si pediste lo suficiente. El error posterior a la promoción te dice si pediste de más para el resto del mes. Si se evalúan por separado, se ven ambas decisiones. Si se evalúan juntas, los dos errores se compensan y el informe parece limpio aunque te hayas equivocado en las dos.
La investigación sobre el ciclo de vida promocional señala que los trabajos previos suelen pasar por alto la fase posterior a la promoción, en la que la demanda cae porque los clientes acumularon producto durante la campaña, e indica que los métodos de aprendizaje automático pueden mejorar las previsiones a lo largo de todo el ciclo de vida y no solo durante la promoción.
El canal añade una segunda capa de ilusión. Un estudio sobre promociones multicanal en un supermercado regional de Brasil estimó un desplazamiento de la demanda del 11,23 % de las tiendas físicas hacia el canal online y del 19,34 % en sentido inverso, mientras que las promociones coordinadas redujeron la canibalización en un 30,04 %. Los incentivos de fidelización generaron el mayor aumento medido, del 3,5 %. Si prevés cada canal por separado, contarás dos veces una demanda que simplemente cambió de dirección.
Después, somete la evaluación a cuatro reglas:
- Evalúa por separado los periodos con y sin promoción, para que una buena semana no oculte un mal mes.
- Compara con una base de incremento (base-lift) o una referencia causal similar; de lo contrario, solo estás midiendo lo bien que el modelo aprendió el volumen.
- Evalúa por SKU y por frecuencia de promoción, porque el umbral de cinco promociones cambia lo que puedes esperar.
- Mantén activa una variable rezagada posterior a la promoción para que el modelo pueda expresar la caída en lugar de sorprenderse con ella.
Si los descuentos están devorando tu margen, nuestra guía para proteger los márgenes durante las campañas de descuento aborda el lado de los precios del mismo problema.
Cómo medir la precisión y convertir las previsiones en pedidos
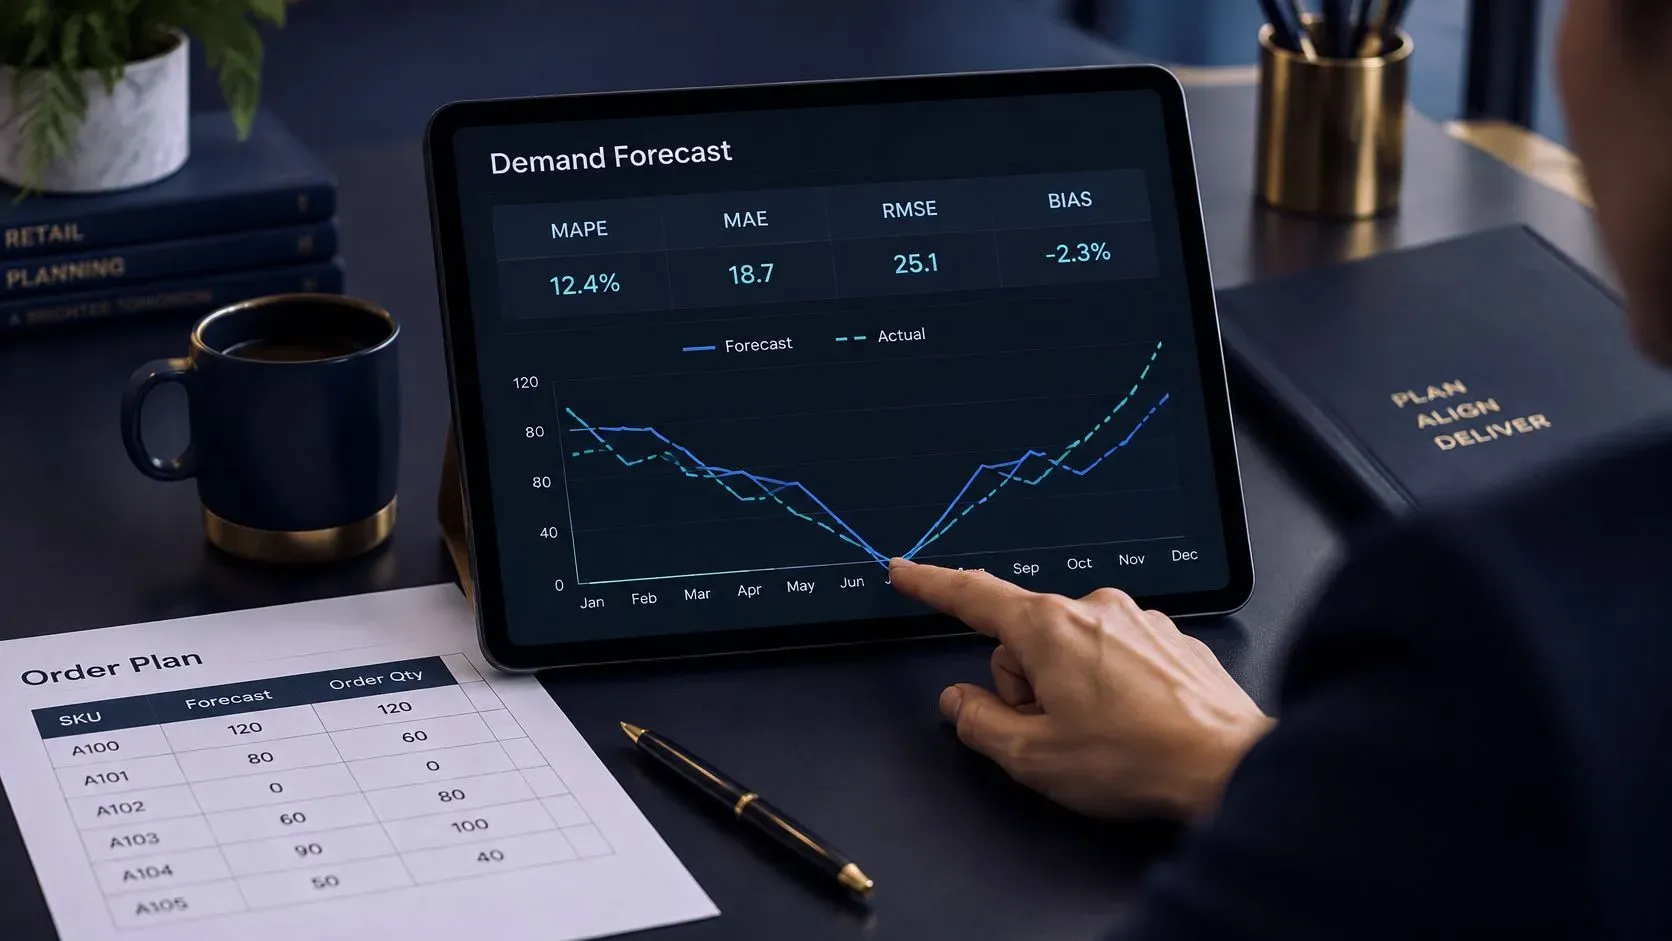
Elige la métrica después de elegir la decisión. Cada medida responde a una pregunta distinta y oculta algo diferente.
Métrica | Úsala cuando | Ten en cuenta |
|---|---|---|
WAPE (error porcentual absoluto ponderado) | Compares la precisión entre artículos de distinto tamaño | Da más peso a los artículos de mayor volumen |
MASE (error absoluto escalado medio) | Compares modelos en series intermitentes o con muchos ceros | Necesita una referencia ingenua para interpretarse bien |
MAPE (error porcentual absoluto medio) | Informes sencillos sobre artículos estables y de alto volumen | Inestable o indefinido cuando la demanda real es cero |
Sesgo | Detectar una sobreprevisión o infraprevisión sistemática | Los errores que se compensan pueden ocultarlo si no se lee por periodo |
Nivel de servicio | Comprobar si la previsión protege la disponibilidad en el lineal | Depende de los parámetros de reposición, no solo de la previsión |
Los errores porcentuales fallan con los productos de baja rotación. Cuando la demanda real es cero, el denominador es cero y la métrica se dispara o se excluye del promedio, y ambos resultados favorecen al modelo. Informa del WAPE o de un error escalado junto con el sesgo y el nivel de servicio, y léelos por segmento en lugar de como una sola cifra para todo el catálogo.
De un número a un punto de reposición
Una previsión se convierte en pedido mediante una aritmética que cualquiera del equipo puede comprobar. La demanda esperada durante el plazo de entrega, más un stock de seguridad dimensionado según tu nivel de servicio objetivo, da el punto de reposición.
Supongamos que una tienda espera vender 40 unidades durante un plazo de entrega del proveedor de cinco días y mantiene un colchón de 10 unidades. El punto de reposición es de 50 unidades. Cuando el stock disponible más el pedido en curso baja a 50, se lanza el pedido. Si el comprador pide cuando llega a 40 porque nunca se acordó el colchón, el estante se queda vacío el primer día que el camión se retrasa.
Dos rutinas ayudan a mantener la disciplina. Configure alertas de excepción para cuando el error de previsión de un artículo supere su umbral durante dos o más periodos consecutivos, de modo que alguien revise el artículo y no solo el panel. Haga una revisión mensual del sesgo por categoría para detectar sobreestimaciones o subestimaciones sistemáticas que los errores individuales por artículo compensan entre sí.
Una previsión estadísticamente precisa puede causar faltantes si el momento del pedido, la frecuencia de revisión o el stock de seguridad están mal calibrados. Revise la previsión y las reglas de reposición juntas, o seguirá corrigiendo lo que no es.
Nuestra guía de ELECTE sobre analítica de datos de stock profundiza en cómo conectar las posiciones de stock con las cifras en las que se basan los compradores.
Confirme su plan de previsión antes del próximo ciclo de compras
Antes de hacer el siguiente pedido, confirme que el proceso de previsión se ajusta a los productos y a las decisiones que debe respaldar. Cinco comprobaciones hacen que el plan sea práctico:
- Clasifique su surtido. Identifique los artículos que generan la mayor parte de sus ingresos y clasifíquelos como estables, impulsados por promociones o intermitentes. Para el resto puede bastar una regla más sencilla.
- Revise el historial de ventas. Extraiga de 12 a 24 meses de ventas por artículo, tienda y día, y marque los días con rotura de stock. Si solo dispone de 12 meses, utilice los datos, pero espere un error mayor.
- Pruebe frente a una línea base. Defina una línea base estacional y compare modelos más complejos en semanas reservadas para validación. El resultado de M5 mencionado arriba muestra por qué un modelo más complejo debe ganarse su lugar.
- Defina la rutina de medición. Elija una métrica para cada decisión y mantenga su umbral y su frecuencia de revisión constantes entre ciclos.
- Revise los fallos repetidos. Vuelva a comprobar los puntos de reposición de los artículos con errores de previsión recurrentes antes de hacer el pedido.
ELECTE aplica seis métodos de previsión a los datos del usuario, los puntúa entre sí y selecciona el más preciso. Su calculadora gratuita de punto de reposición ayuda a calcular el punto de reposición de cada artículo.
Las previsiones reducen el riesgo, pero no pueden contemplar todos los cambios. Un modelo puede pasar por alto el lanzamiento de un producto nuevo o una promoción sin historial de ventas comparable. Mantenga una rutina de revisión junto con la previsión para que los compradores puedan reaccionar cuando la demanda real difiera del plan.
ELECTE conecta datos de ventas, stock y promociones, compara seis métodos de previsión con los datos disponibles y presenta previsiones, precisión y excepciones en paneles visuales que los equipos pueden compartir. Si es minorista y quiere evaluar previsiones de demanda junto con sus propios datos de ventas, visite ELECTE.
Comentarios
Aún no hay comentarios — inicia la conversación.