Vraagvoorspelling voor retail: methoden, data en voordelen
Ontdek hoe vraagvoorspelling voor retail werkt, welke methoden u kunt gebruiken, welke data u nodig hebt en hoe u met betere voorraadplannen out-of-stocks en overvoorraad terugdringt.

Een out-of-stock wordt meestal aan de leverancier geweten. Meestal begint het probleem dichter bij huis. Een retailvoorraadstudie, gepresenteerd op de Bangladesh-conferentie van de IEOM Society in 2025, laat zien dat 51% tot 73% van de out-of-stocks in supermarkten ontstaat binnen de retailorganisatie zelf, waarbij onnauwkeurige voorspellingen (waaronder onderschatte vraag) en bestelfouten tot de belangrijkste oorzaken horen.
Die bevinding verandert het perspectief. Vraagvoorspelling voor retail is geen wedstrijd om het meest geavanceerde algoritme te kiezen. Het is een operationele discipline: eerlijke vraagsignalen halen uit data die door out-of-stocks en promoties al vertekend is, de methode afstemmen op hoe elk product verkoopt en de uitkomst koppelen aan bestelpunten waar een inkoper maandagochtend echt mee werkt.
Deze gids behandelt de hele cyclus. U ziet wat de voorspelling moet opleveren, welke input het zwaarst weegt, hoe zes veelgebruikte methoden zich per retailsituatie verhouden, waarom langzaam lopende artikelen een andere opzet nodig hebben, hoe hamsteren en kanaalverschuivingen het promotie-effect schijnbaar opblazen, welke foutmaat u voor welke beslissing kunt vertrouwen en een controle in vijf stappen voor uw volgende inkoopronde.
Wat vraagvoorspelling betekent op de winkelvloer
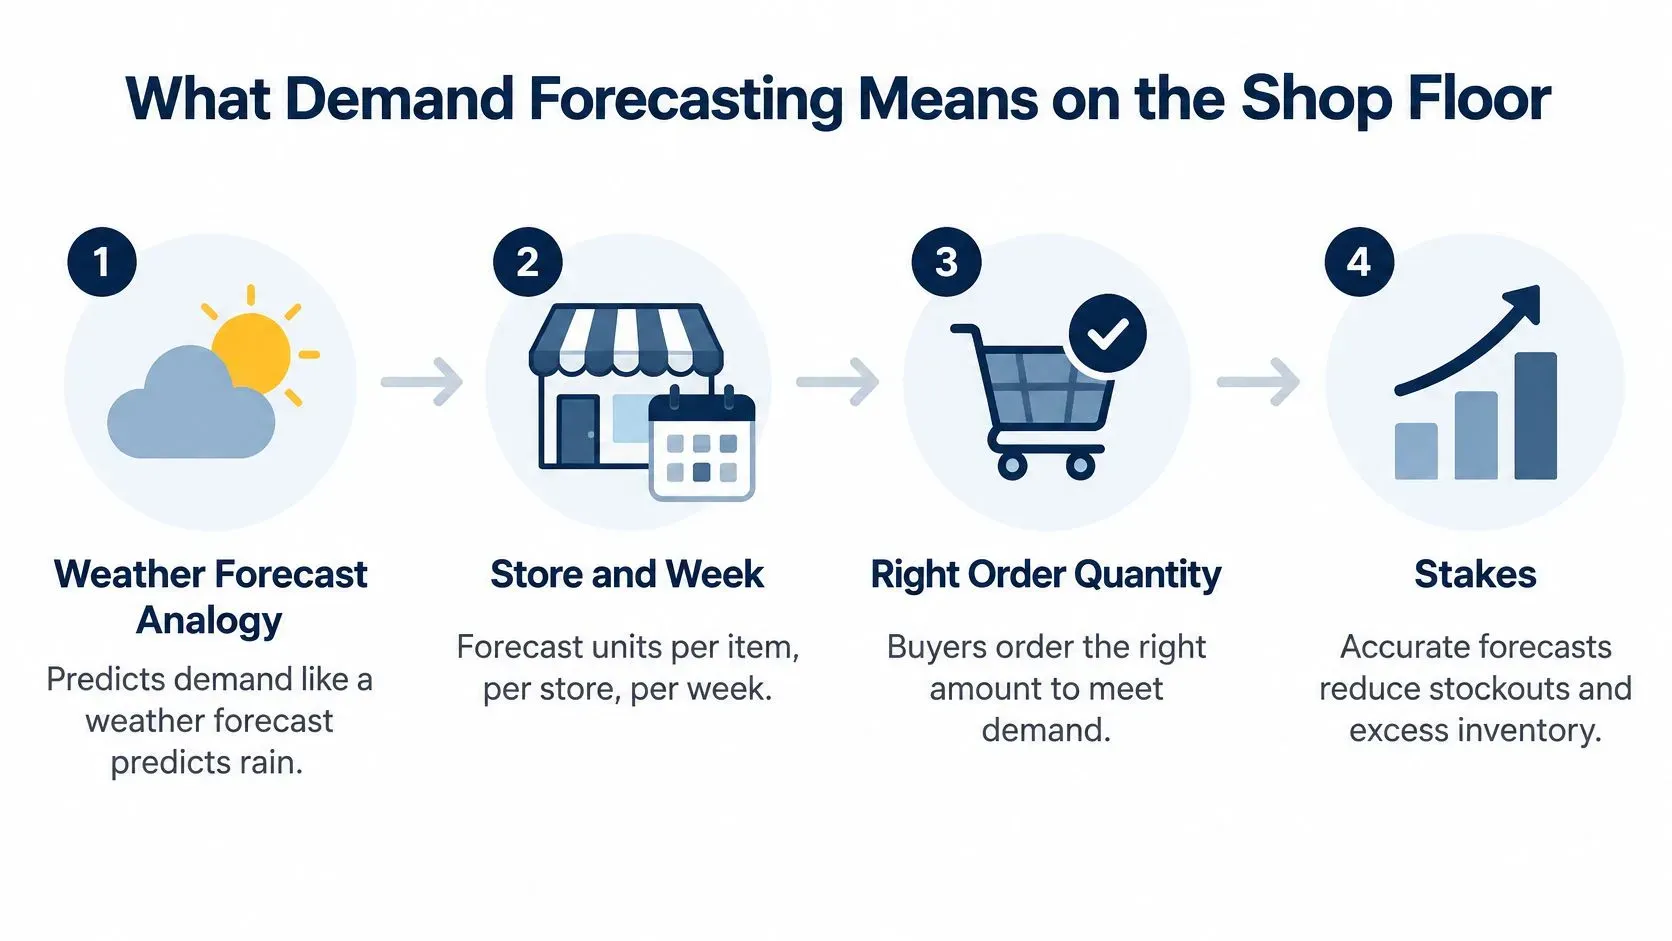
Een weersvoorspelling wordt betrouwbaar als ze lokaal en getimed is: de kans op regen in uw stad dinsdagmiddag is genoeg om te beslissen of u een paraplu meeneemt. Vraagvoorspelling doet hetzelfde voor voorraad. Ze schat hoeveel eenheden van een bepaald artikel klanten in een bepaalde week in een bepaalde winkel kopen, zodat een inkoper de juiste hoeveelheid bestelt in plaats van een aannemelijke.
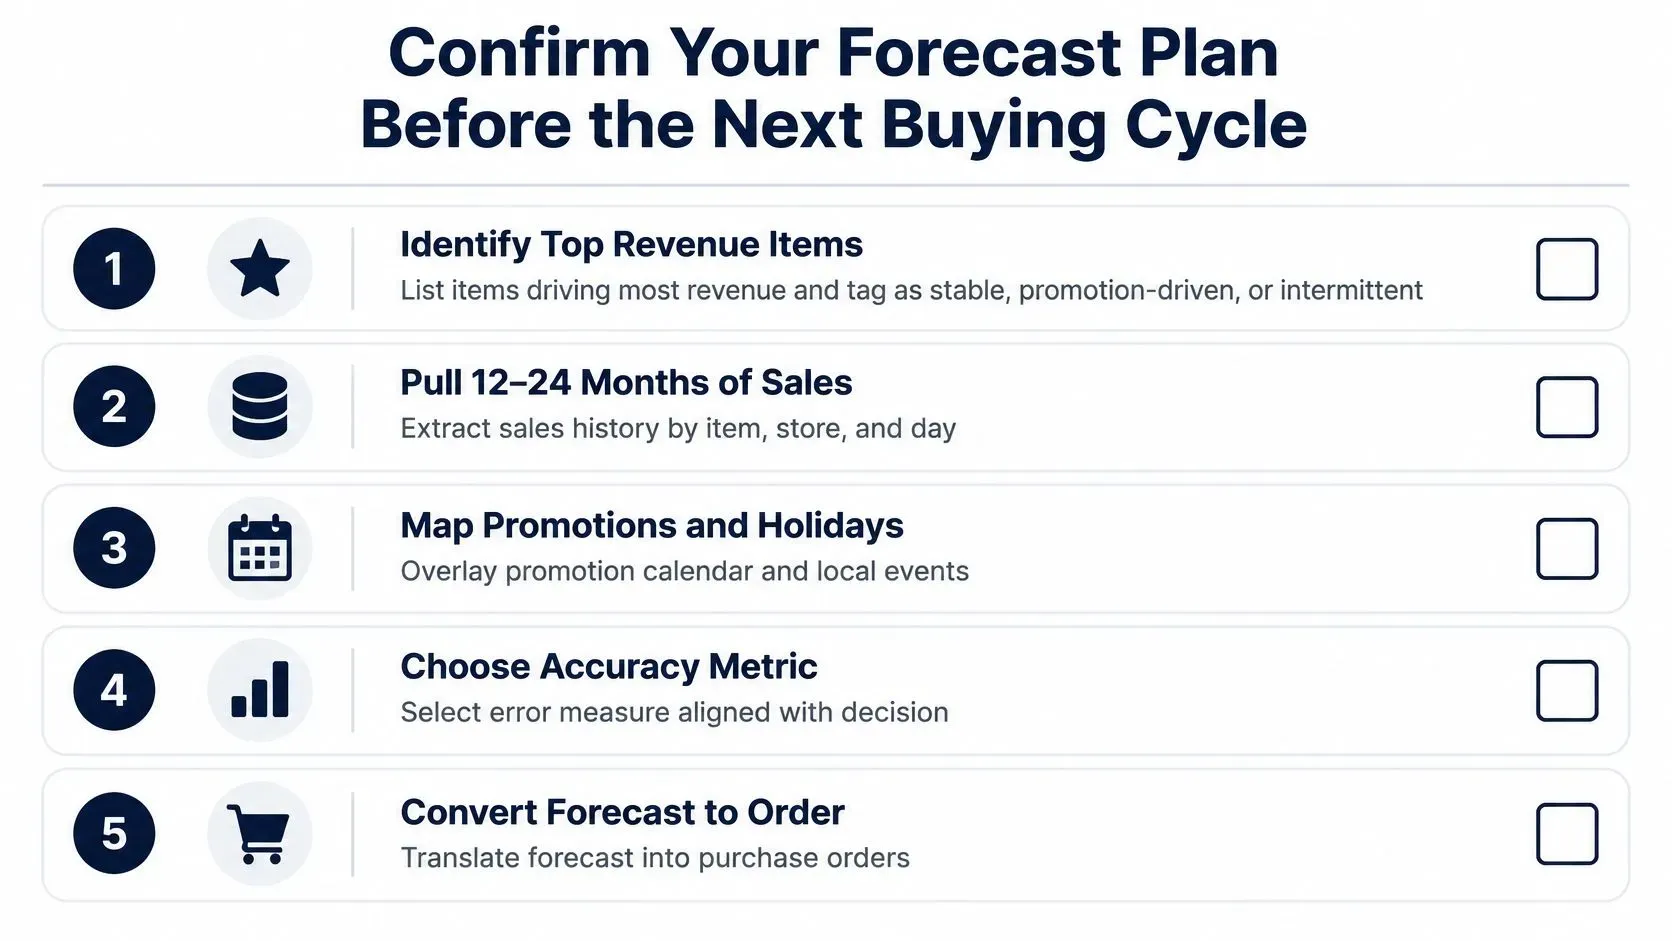
De vijf stappen hieronder vormen het hele idee in het klein, van de voorspelling tot de inkooporder die erop moet volgen.
Het doel is vraag, niet het verkoopcijfer dat de kassa toevallig registreerde. Een nul die genoteerd is terwijl het shampooschap leeg was, is afgekapte vraag; een promotiepiek kan zijn voorgetrokken uit de komende twee weken of weggehaald bij een winkel in de buurt. Categoriegemiddelden en maandrapporten verbergen die problemen per artikel en winkel, dus het signaal moet gedetailleerd blijven en vaak worden ververst.
De werkcyclus ziet er zo uit:
- Verzamel verkoop- en voorraadhistorie per artikel, winkel en dag, inclusief de dagen dat een schap leeg was.
- Maak schoon en stem af: één maateenheid, één kalender, geen dubbele rijen wanneer een winkelsysteem een week herberekent.
- Pas modellen toe en voorspel de vraag per artikel en winkel, op het detailniveau dat uw bestelbeslissing vereist.
- Vertaal de voorspelling naar bestellingen en veiligheidsvoorraad, op basis van levertijden en het servicelevel dat u hebt beloofd.
- Meet fouten en stuur bij, per artikel, in plaats van eens per jaar bij de begroting.
Elke stap beschermt tegen een van drie kostenposten. Voorspelt u te laag, dan mist u verkopen die u niet terugkrijgt, omdat de klant het alternatief koopt of vertrekt. Voorspelt u te hoog, dan zit geld vast in voorraad die in prijs moet zakken. Is de hoeveelheid ongeveer goed maar de timing fout, dan betaalt u dubbel: toeslagen op spoedtransport voor de haastbestelling en opslagkosten voor het overschot.
De regel die het meeste geld bespaart: een voorspelling verdient zichzelf pas terug als een aanvulregel erop reageert. Een perfect getal in een rapport verandert niets in het schap.
De data-input en waarom out-of-stocks die vertekenen
Kijk voordat u modellen vergelijkt eerst naar wat erin gaat. De input die de nauwkeurigheid in retail het meest verbetert, is voorspelbaar en weinig spannend, en veel teams missen er twee of drie van.
- Verkoophistorie per artikel, winkel en dag. Alles grover verbergt de promotieweken en weekendpieken die het signaal dragen.
- Actuele voorraad en duur van out-of-stocks. Zonder die gegevens ziet u het verschil niet tussen een rustige week en een leeg schap.
- Prijzen en kortingsdiepte. Een korting van 10% en een van 30% geven niet dezelfde responscurve, dus sla de schapprijs op die klanten betalen, niet de catalogusprijs.
- De promotiekalender, inclusief displayplaatsing en folderadvertenties.
- Feestdagen en lokale evenementen. Een schoolfeest twee straten verderop zet meer flessen water om dan een nationale feestdag.
- Weer, vooral voor verse, seizoens- en tuincategorieën.
- Concurrentieprijzen, waar u die consistent kunt waarnemen.
- Levertijden van leveranciers en leveringsvertragingen, die bepalen hoeveel dekking u nodig hebt.
Waarom een leeg schap een valse nul schrijft
Stel dat uw shampoo gemiddeld 40 stuks per week verkoopt en het schap drie dagen leeg staat. Die dagen registreren nul verkopen. Een model dat op die historie is getraind, leert dat de vraag daalt zodra de voorraad op is, het tegenovergestelde van de waarheid. Klanten die niets vonden, bedachten zich niet; ze gingen elders heen.
Leveranciersvertragingen, trage aanvulling en uw eigen bestelkeuzes beperken de verkopen op precies dezelfde manier. Het model kan een gemiste verkoop niet onderscheiden van gebrek aan interesse en zal het artikel dat het snelst uitverkocht raakt, blijven onderbestellen.
Dit probleem is goed gedocumenteerd. Een review uit 2026 over machine learning in retailvoorspelling noemt onvolledige datasets, versnipperde datapijplijnen, veranderend klantgedrag, promoties, reacties van concurrenten en seizoenspatronen als oorzaken van vertekende, fragiele modellen. Dezelfde review citeert een enquête onder 661 voorraadprofessionals, waarin 51% soms doorging met voorspellingen die ze zelf al onbetrouwbaar vonden omdat er geen beter alternatief was, terwijl wijzigingen in tarieven en handelsbeleid (19%) en inflatie of schommelingen in grondstofprijzen (17%) tot de grootste verstoringen behoorden.
De oplossing in vier stappen, op volgorde
- Markeer elke dag met een stockout in de verkoophistorie, met de uren of dagen waarop het artikel niet beschikbaar was.
- Schat de gemiste omzet voor die dagen op basis van vergelijkbare artikelen in dezelfde winkel en dezelfde week.
- Label elke periode als beschikbaar of beperkt, voordat een trainingsrun begint.
- Train op de gecorrigeerde historie en vergelijk de resultaten op achtergehouden weken, nooit op de weken die je hebt aangepast.
Voor de meeste mkb-bedrijven verbetert dit werk de nauwkeurigheid meer dan een ander algoritme. Een model kan alleen leren wat in de data staat; als de data zegt dat de vraag instortte tijdens een stockout, leert een geavanceerdere architectuur het verkeerde gewoon sneller. Onze ELECTE-gids over integratie van meerdere bronnen beschrijft de basis om verkoop-, voorraad- en promotiedata in één bruikbare tabel samen te brengen.
Prognosemethoden vergeleken per retailsituatie
Er bestaat geen beste methode, alleen een methode die bij de situatie past. De onderstaande tabel is de vergelijking die ik boven een planningsbureau zou willen hebben hangen.
Methode | Beste retailsituatie | Benodigde data | Sterk punt | Let op |
|---|---|---|---|---|
Voortschrijdend gemiddelde of exponentiële afvlakking | Stabiele artikelen met hoog volume | 1-2 jaar aan wekelijkse verkoopcijfers | Eenvoudig, goedkoop en makkelijk uit te leggen | Mist promoties en seizoensverschuivingen |
Seizoensmodellen zoals SARIMA | Artikelen met duidelijke wekelijkse of jaarlijkse cycli | Historie van twee of meer seizoenen | Vangt trend en seizoenspatroon op | Heeft moeite met duizenden reeksen tegelijk |
Methoden uit de Croston-familie | Sporadisch verkopende, langzaam bewegende SKU's | Verkoophistorie met veel nulperiodes | Scheidt hoe vaak een verkoop plaatsvindt van de omvang ervan | Verkeerde keuze voor constant verkopende artikelen |
Regressie met promotie- en prijskenmerken | Categorieën die door promoties worden gedreven | Promotiekalender en prijshistorie | Laat zien hoe elke factor de vraag beïnvloedt | Werkt niet goed als promoties schaars zijn |
Boomensembles zoals XGBoost of LightGBM | Grote portfolio's van artikel-winkelcombinaties | Verkoop, kalender, promoties en prijzen | Leert over veel verwante reeksen heen | Vereist schone data en continue monitoring |
Hybride LSTM-XGBoost-ensembles | Ketens met meerdere categorieën en rijke signalen | 36 maanden kassadata en promotiedata | Verlaagde de gemiddelde absolute procentuele fout gemiddeld met 28,6% op een horizon van vier weken in één onderzoek onder 14 retailorganisaties | Zwaarder om te bouwen en uit te leggen |
Het patroon achter de rijen zegt meer dan elke afzonderlijke rij. Een peerreviewed overzichtsstudie over onderzoek naar retailforecasting meldt dat globale machine-learningmodellen, waaronder feed-forward en recurrente neurale netwerken, gradient-boosted regressiebomen en random forests, vaak beter presteren dan afzonderlijke tijdreeks- en regressiemodellen wanneer retailers grote verzamelingen verkoopreeksen voorspellen. Het voordeel groeit met de omvang van het assortiment: duizenden combinaties van artikel en winkel, waarbij de vraag naar individuele producten schaars, intermitterend, seizoensgebonden of gevoelig voor promoties is.
Hoe de vergelijking eruitziet in een echte keten
Stel u een regionale keten met 40 winkels voor. Basisartikelen met een stabiele wekelijkse verkoop krijgen exponentiële afvlakking, omdat een categoriemanager het getal kan lezen en erover kan discussiëren. Seizoenskleding met acht promoties per jaar krijgt een gradient-boosted model dat over alle winkels tegelijk is getraind, omdat de historie van één winkel te dun is om er een kortingscurve uit te leren.
De overzichtsstudie is even duidelijk over het feit dat de oudere methoden niet achterhaald zijn. Ze blijven concurrerend bij kleinere datasets, stabiele producten en situaties waarin interpreteerbaarheid en beperkte data zwaarder wegen dan het laatste procentpunt nauwkeurigheid.
Terughoudendheid loont. Een evaluatie uit 2026 van de Amerikaanse retailvraag op de M5-dataset, met 25.940 reeksen van artikel en winkel over vijf rollende vensters van 28 dagen, bracht de gemiddelde gewogen absolute procentuele fout terug van 0,9006 voor een seasonal-naive benchmark naar 0,7022 met een LightGBM-model op basis van historische vraag, een verbetering van ongeveer 22%. Het toevoegen van retail- en operationele variabelen leverde slechts 0,6979 op, en vertraagde macro-economische indicatoren 0,6978, een winst van ongeveer 0,02%.
Bouw eerst de baseline. Een seasonal-naive of exponentieel afgevlakt getal dat u in een middag maakt, laat zien of het machine-learningmodel zijn complexiteit heeft verdiend. Draai beide op dezelfde achtergehouden weken en houd de winnaar.
De modelkeuze moet de schaal en structuur van het assortiment volgen, niet de vraag of de methode nieuwer is. Dat ene principe bespaart u meer geld dan welke hyperparameterzoektocht dan ook.
Langzame lopers en schaarse vraag hebben een eigen model nodig
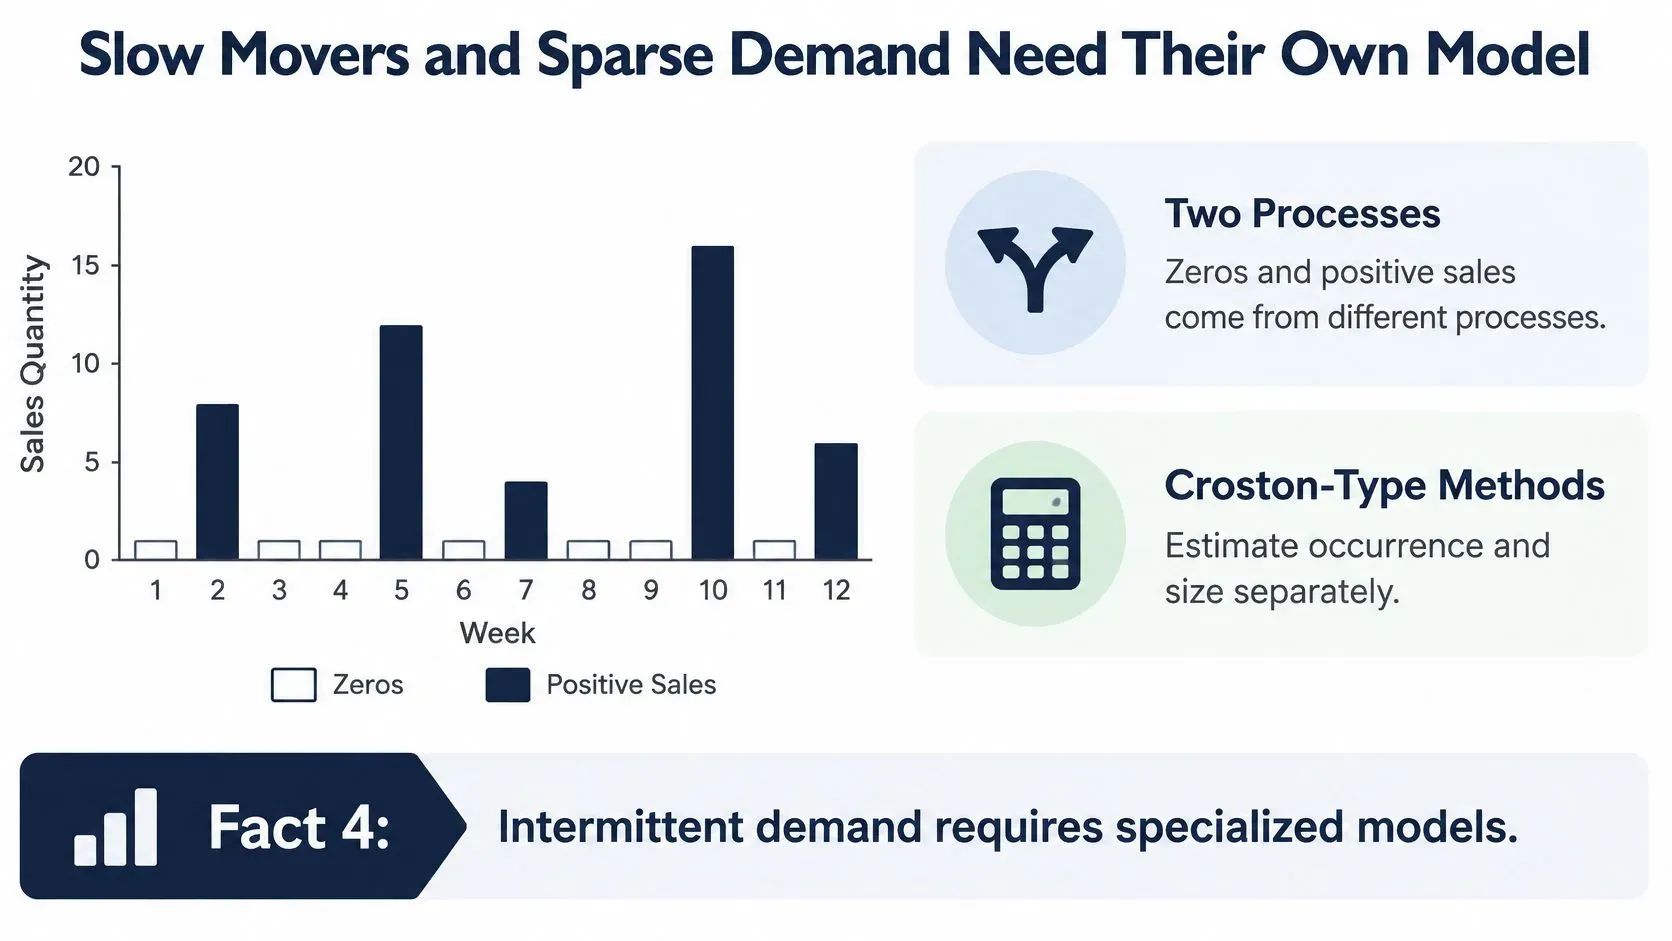
Sommige producten hebben geen vraagniveau. Ze hebben een vraaggebeurtenis. Een reserveonderdeel dat vier keer per jaar verkoopt, een variant uit de lange staart van een webshop, een combinatie van winkel en SKU die twee stuks per maand verkoopt: standaard seizoensmodellen gaan hier slecht mee om, en de reden is structureel.
Nullen en positieve verkopen komen voort uit twee verschillende processen. Of er überhaupt een verkoop plaatsvindt, is één vraag. Hoe groot die is als ze plaatsvindt, is een andere. Methoden van het Croston-type schatten die apart, waardoor ze standhouden bij retaildata vol nullen. Een benchmark voor retailforecasting bij intermitterende vraag meldt voor Croston een WAPE van 93,15% en een MASE van 0,9852, beter dan de naive- en SARIMAX-alternatieven waartegen het is getest. Lees die WAPE als een relatief resultaat op een reeks vol nullen, niet als een goede nauwkeurigheidsscore in absolute zin.
De faalwijze is specifiek en duur. Een standaard regressie- of seizoensmodel ziet een reeks nullen en concludeert dat de vraag laag en stabiel is, en stelt de veiligheidsvoorraad daarop af. De langzame loper die in onvoorspelbare pieken verkoopt, raakt dan uitverkocht terwijl het dode artikel drie maanden dekking heeft. De ene fout kost een verkoop, de andere kost geld en schapruimte.
Er is een tweede les op ditzelfde terrein. Een benchmark op verkoopdata met intermitterende vraag, ontbrekende waarnemingen en een vaak wisselend assortiment vond dat gelokaliseerde boomgebaseerde modellen het best presteerden van de geteste aanpakken, waarbij XGBoost de laagst gerapporteerde root mean square error van 4,833 behaalde. De les is niet "gebruik overal XGBoost". De les is dat bij snel wisselende producten modellen per productfamilie kunnen winnen van één algemeen model dat gedwongen wordt te middelen over onverenigbare patronen.
Zo routeert u een reeks
- Classificeer voordat u modelleert. Bereken voor elke reeks het gemiddelde vraaginterval en de gekwadrateerde variatiecoëfficiënt van de vraag groter dan nul. Het eerste is het typische aantal perioden tussen verkopen; het tweede meet hoe sterk de omvang van die verkopen van verkoop tot verkoop schommelt.
- Routeer intermitterende reeksen naar modellen uit de Croston-familie, hurdle-modellen of modellen voor optreden en omvang.
- Stuur stabiele artikelen met hoog volume naar seizoens- of machine-learningmodellen, waar ze thuishoren.
- Controleer de classificatie elk kwartaal opnieuw. Artikelen verschuiven tussen categorieën naarmate ze ouder worden, uit het assortiment gaan of aanslaan, en een routeringsregel die nooit opnieuw wordt uitgevoerd, verslechtert.
Bewaar de classificatie in een tabel die u kunt inzien. Als een categoriemanager vraagt waarom een product met een vreemde methode wordt voorspeld, moet het antwoord uit twee getallen bestaan, niet uit een schouderophalen.
Promoties, hamsteren en kanaalverschuivingen
Promotieweken zijn geen gewone weken, en ze opnemen in een baseline bederft beide. Modelleer baselinevraag en promotie-effecten als aparte grootheden en tel ze daarna op.
Een vergelijking van aanpakken voor retailforecasting vond dat beslisboomensembles beter presteerden dan lineaire regressie, gepenaliseerde lineaire regressie en regressieboommethoden voor de dagelijkse vraag op ketenniveau wanneer SKU's meer dan vijf historische promoties hadden. Vijf is in dat resultaat de bruikbare drempel. Daaronder zijn er te weinig voorbeelden om een model te laten leren hoe kortingsdiepte, timing van promoties en interacties met de productkalender de vraag beïnvloeden, dus doet sterkere regularisatie of een eenvoudigere benchmark minder schade dan een flexibel model dat ruis najaagt.
Geef het model expliciete features: promotiestatus, kortingspercentage, displayplaatsing, nabijheid van feestdagen en vertraagde vraag na de promotie. Die laatste wordt vaak weggelaten, maar het is juist de feature die de dip vastlegt.
De dip die niemand voorspelt
Stel dat een korting van 30% op shampoo de verkoop een week lang verhoogt, waarna de verkoop twee weken onder de trend blijft. Klanten legden een voorraad aan; ze kochten over het kwartaal niet méér. Behandel het hele venster van drie weken als één analyse-eenheid. De fout in de actieperiode vertelt je of je genoeg hebt besteld. De fout na de actie vertelt je of je de rest van de maand te veel hebt besteld. Als je ze apart scoort, zie je beide beslissingen. Als je ze samen scoort, heffen de twee fouten elkaar op en ziet het rapport er netjes uit, terwijl je beide beslissingen verkeerd had.
Onderzoek naar de levenscyclus van promoties stelt dat eerder werk de fase na de promotie vaak over het hoofd ziet, waarin de vraag daalt omdat klanten tijdens de actie voorraad hebben aangelegd, en meldt dat machine-learningmethoden de voorspellingen over de hele levenscyclus kunnen verbeteren, in plaats van alleen tijdens de promotie zelf.
Het kanaal voegt een tweede laag schijn toe. Een studie naar multichannel-promoties bij een regionale Braziliaanse supermarkt schatte de vraagverschuiving op 11,23% van fysieke winkels naar online en 19,34% in de omgekeerde richting, terwijl gecoördineerde promoties de kannibalisatie met 30,04% verminderden. Loyaliteitsprikkels leverden de grootste gemeten stijging op, namelijk 3,5%. Voorspel je elk kanaal afzonderlijk, dan tel je vraag dubbel die gewoon van adres is veranderd.
Houd de evaluatie daarom aan vier regels:
- Score periodes met en zonder promotie apart, zodat een goede week geen slechte maand kan verbergen.
- Vergelijk met een base-lift of vergelijkbare causale baseline, anders meet je alleen hoe goed het model volume heeft geleerd.
- Evalueer per SKU en per promotiefrequentie, omdat de drempel van vijf promoties verandert wat je mag verwachten.
- Houd een vertraagd feature voor de periode na de promotie actief, zodat het model de dip kan uitdrukken in plaats van erdoor verrast te worden.
Als kortingen je marge opeten, behandelt onze gids over marges beschermen tijdens kortingscampagnes de prijskant van hetzelfde probleem.
Nauwkeurigheid meten en voorspellingen omzetten in bestellingen
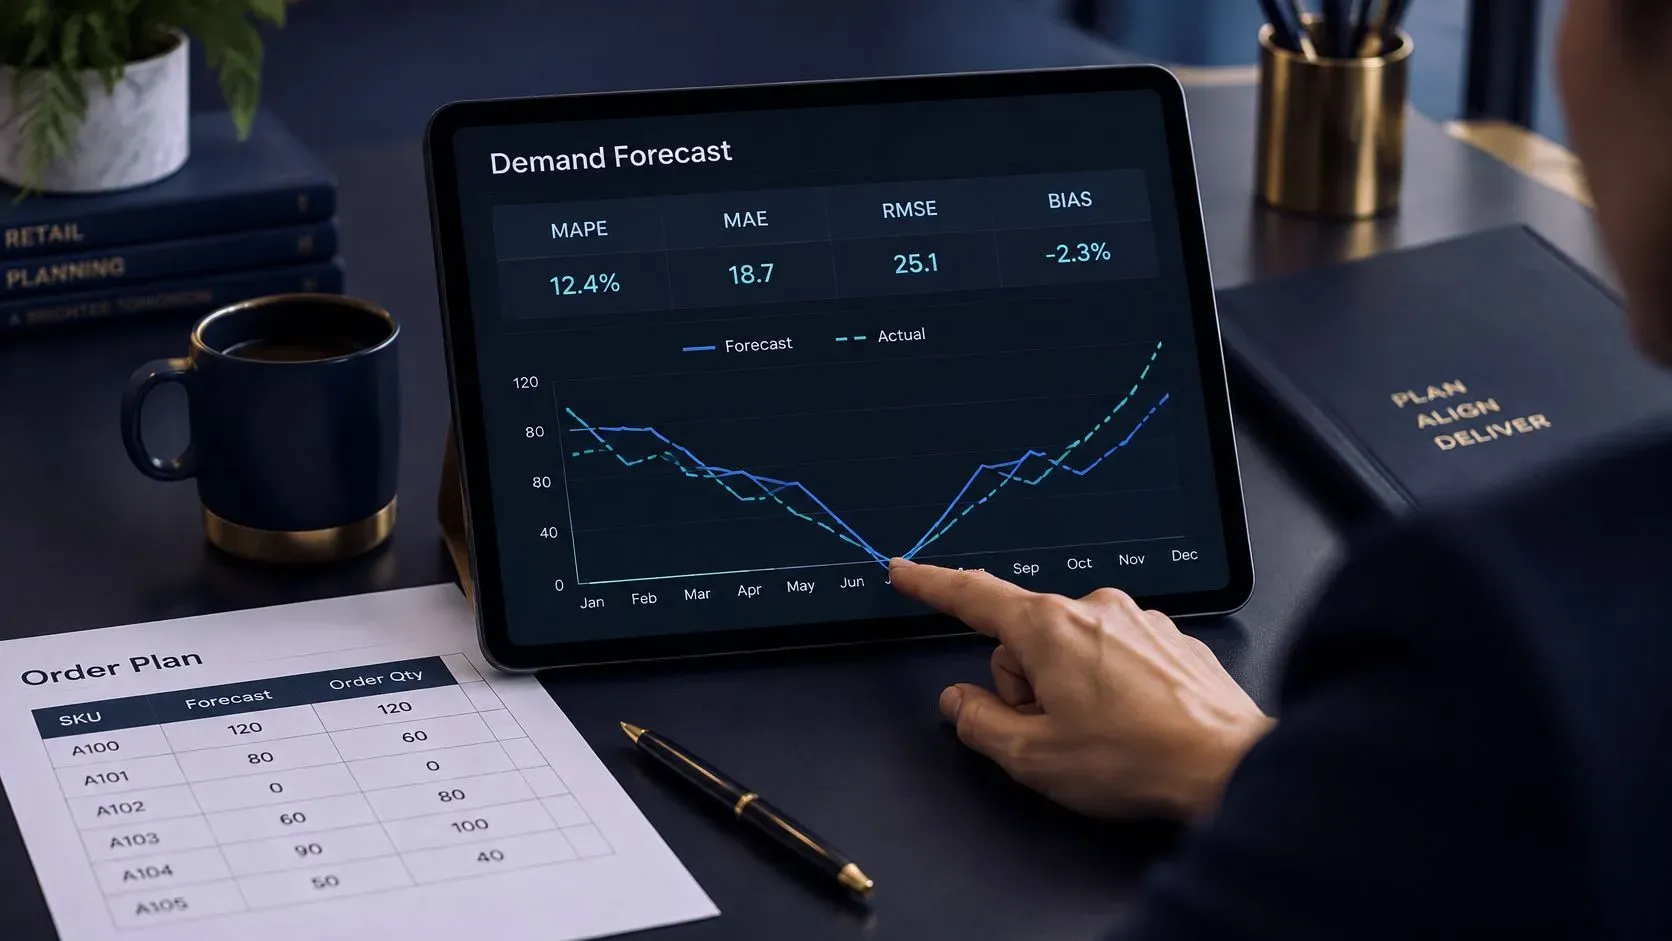
Kies de maatstaf nadat je de beslissing hebt gekozen. Elke maatstaf beantwoordt een andere vraag en verbergt iets anders.
Maatstaf | Gebruik hem wanneer | Let op |
|---|---|---|
WAPE (gewogen absolute procentuele fout) | Je de nauwkeurigheid vergelijkt tussen artikelen van verschillende omvang | Weegt artikelen met een hoog volume het zwaarst |
MASE (gemiddelde absolute geschaalde fout) | Je modellen vergelijkt op intermitterende reeksen of reeksen met veel nullen | Heeft een naïeve benchmark nodig om juist te lezen |
MAPE (gemiddelde absolute procentuele fout) | Je eenvoudig rapporteert over stabiele artikelen met hoog volume | Instabiel of ongedefinieerd als de werkelijke vraag nul is |
Bias | Je systematische over- of onderschatting wilt opsporen | Elkaar compenserende fouten kunnen het verbergen, tenzij je per periode leest |
Serviceniveau | Je controleert of de voorspelling de beschikbaarheid in het schap beschermt | Hangt af van de aanvulinstellingen, niet alleen van de voorspelling |
Procentuele fouten werken niet bij langzame lopers. Als de werkelijke vraag nul is, is de noemer nul en schiet de maatstaf door of wordt hij uit het gemiddelde gehaald, en beide uitkomsten flatteren het model. Rapporteer WAPE of een geschaalde fout naast bias en serviceniveau, en lees ze per segment in plaats van als één getal voor het hele assortiment.
Van getal naar bestelpunt
Een voorspelling wordt een bestelling via rekenwerk dat iedereen in het team kan controleren. De verwachte vraag over de levertijd, plus veiligheidsvoorraad afgestemd op je doelserviceniveau, geeft het bestelpunt.
Stel dat een winkel over een levertijd van vijf dagen van de leverancier 40 stuks verwacht te verkopen en een buffer van 10 stuks aanhoudt. Het bestelpunt is dan 50 stuks. Zodra de voorraad plus de bestelde hoeveelheid daalt tot 50, gaat de bestelling de deur uit. Als de inkoper op 40 bestelt omdat de buffer nooit is afgesproken, is het schap leeg op de eerste dag dat de vrachtwagen te laat is.
Twee routines houden dit scherp. Stel uitzonderingsmeldingen in voor wanneer de voorspelfout van een artikel de drempel twee of meer perioden achter elkaar overschrijdt, zodat iemand naar het artikel kijkt in plaats van naar het dashboard. Voer maandelijks een biascontrole per categorie uit om systematisch te hoge of te lage voorspellingen op te sporen die in de fouten per artikel wegvallen.
Een statistisch nauwkeurige voorspelling kan nog steeds tot tekorten leiden als het bestelmoment, de beoordelingsfrequentie of de veiligheidsvoorraad niet goed is ingesteld. Beoordeel de voorspelling en de aanvulregels samen, anders blijf je het verkeerde probleem oplossen.
In onze ELECTE-gids over voorraaddata-analyse lees je meer over het koppelen van voorraadposities aan de cijfers waarop inkopers handelen.
Controleer je voorspelplan vóór de volgende inkoopronde
Controleer voordat de volgende bestelling wordt geplaatst of het voorspelproces past bij de producten en beslissingen die het moet ondersteunen. Met vijf controles wordt het plan praktisch:
- Deel je assortiment in. Bepaal welke artikelen het grootste deel van je omzet opleveren en classificeer ze als stabiel, promotiegedreven of sporadisch. Voor de rest volstaat mogelijk een eenvoudigere regel.
- Controleer de verkoophistorie. Haal 12 tot 24 maanden verkopen op per artikel, winkel en dag, en markeer dagen met een lege voorraad. Heb je maar 12 maanden, gebruik die data dan wel, maar reken op een grotere fout.
- Test tegen een basislijn. Stel een seizoensgebonden basislijn in en vergelijk uitgebreidere modellen op weken die buiten de trainingsdata zijn gehouden. Het M5-resultaat hierboven laat zien waarom een complexer model zijn plek moet verdienen.
- Stel de meetroutine vast. Kies voor elke beslissing een maatstaf en houd de drempel en de beoordelingsfrequentie in alle cycli gelijk.
- Bekijk terugkerende missers. Controleer de bestelpunten van artikelen met steeds terugkerende voorspelfouten opnieuw voordat je de bestelling plaatst.
ELECTE past zes voorspelmethoden toe op gebruikersdata, vergelijkt ze onderling en kiest de nauwkeurigste. De gratis bestelpuntcalculator helpt het bestelpunt van een afzonderlijk artikel te berekenen.
Voorspellingen verminderen risico's, maar kunnen niet elke verandering voorzien. Een model mist bijvoorbeeld een productlancering of een promotie zonder vergelijkbare verkoophistorie. Houd naast de voorspelling een beoordelingsroutine aan, zodat inkopers kunnen bijsturen wanneer de werkelijke vraag afwijkt van het plan.
ELECTE koppelt verkoop-, voorraad- en promotiedata, vergelijkt zes voorspelmethoden op de beschikbare data en toont voorspellingen, nauwkeurigheid en uitzonderingen in visuele dashboards die teams kunnen delen. Wil je als retailer vraagvoorspellingen naast je eigen verkoopdata beoordelen, kijk dan op ELECTE.
Reacties
Nog geen reacties — start het gesprek.