การพยากรณ์ความต้องการสินค้าสำหรับธุรกิจค้าปลีก: วิธีการ ข้อมูล และประโยชน์
เรียนรู้ว่าการพยากรณ์ความต้องการสินค้าสำหรับธุรกิจค้าปลีกทำงานอย่างไร ควรเลือกใช้วิธีใด ต้องใช้ข้อมูลอะไรบ้าง และจะลดปัญหาสินค้าขาดสต็อกและสต็อกล้นด้วยแผนสินค้าคงคลังที่แม่นยำขึ้นได้อย่างไร

เมื่อสินค้าขาดสต็อก มักมีคนโทษซัพพลายเออร์ แต่ในกรณีส่วนใหญ่ ต้นเหตุอยู่ใกล้ตัวกว่านั้น งานศึกษาด้านสินค้าคงคลังของธุรกิจค้าปลีกที่นำเสนอในการประชุม IEOM Society ประจำปี 2025 ที่บังกลาเทศ ชี้ว่า สินค้าขาดสต็อกในซูเปอร์มาร์เก็ตร้อยละ 51 ถึง 73 มีต้นเหตุมาจากภายในการดำเนินงานของร้านค้าปลีกเอง โดยการพยากรณ์ที่ไม่แม่นยำ (รวมถึงการประเมินความต้องการต่ำเกินไป) และข้อผิดพลาดในการสั่งซื้อเป็นหนึ่งในสาเหตุหลัก
ข้อค้นพบนี้ทำให้มองงานนี้ในมุมใหม่ การพยากรณ์ความต้องการสินค้าสำหรับธุรกิจค้าปลีกไม่ใช่การแข่งขันว่าใครเลือกอัลกอริทึมที่ล้ำสมัยที่สุด แต่เป็นวินัยในการดำเนินงาน คือการดึงสัญญาณความต้องการที่ตรงตามความเป็นจริงออกมาจากข้อมูลที่ถูกบิดเบือนไปแล้วจากสินค้าขาดสต็อกและโปรโมชัน การเลือกวิธีให้เหมาะกับลักษณะการขายของสินค้าแต่ละรายการ และการเชื่อมผลลัพธ์เข้ากับจุดสั่งซื้อซ้ำที่ผู้ซื้อจะใช้งานได้จริงในเช้าวันจันทร์
คู่มือนี้ครอบคลุมวงจรทั้งหมด คุณจะได้เห็นว่าการพยากรณ์ต้องให้ผลลัพธ์อะไร ข้อมูลนำเข้าใดสำคัญที่สุด วิธีทั่วไปทั้งหกวิธีเปรียบเทียบกันอย่างไรในแต่ละสถานการณ์ของธุรกิจค้าปลีก ทำไมสินค้าขายช้าจึงต้องใช้โครงสร้างการพยากรณ์ที่ต่างออกไป การกักตุนสินค้าและการย้ายช่องทางซื้อทำให้ยอดขายที่เพิ่มจากโปรโมชันดูสูงเกินจริงได้อย่างไร ควรเชื่อถือตัวชี้วัดความคลาดเคลื่อนตัวใดสำหรับการตัดสินใจแต่ละแบบ และขั้นตอนตรวจสอบห้าข้อที่ควรทำก่อนรอบการสั่งซื้อครั้งถัดไป
การพยากรณ์ความต้องการสินค้าหมายถึงอะไรในหน้างานจริงของร้านค้า
พยากรณ์อากาศจะน่าเชื่อถือเมื่อระบุพื้นที่และเวลาชัดเจน เช่น โอกาสฝนตกในเมืองของคุณช่วงบ่ายวันอังคาร ก็เพียงพอจะตัดสินใจว่าจะพกร่มหรือไม่ การพยากรณ์ความต้องการสินค้าก็ทำหน้าที่แบบเดียวกันกับสินค้าคงคลัง คือประเมินว่าลูกค้าจะซื้อสินค้ารายการหนึ่งกี่หน่วยในร้านหนึ่งสาขาในสัปดาห์หนึ่ง เพื่อให้ผู้ซื้อสั่งในปริมาณที่ใช่ ไม่ใช่แค่ปริมาณที่ดูสมเหตุสมผล
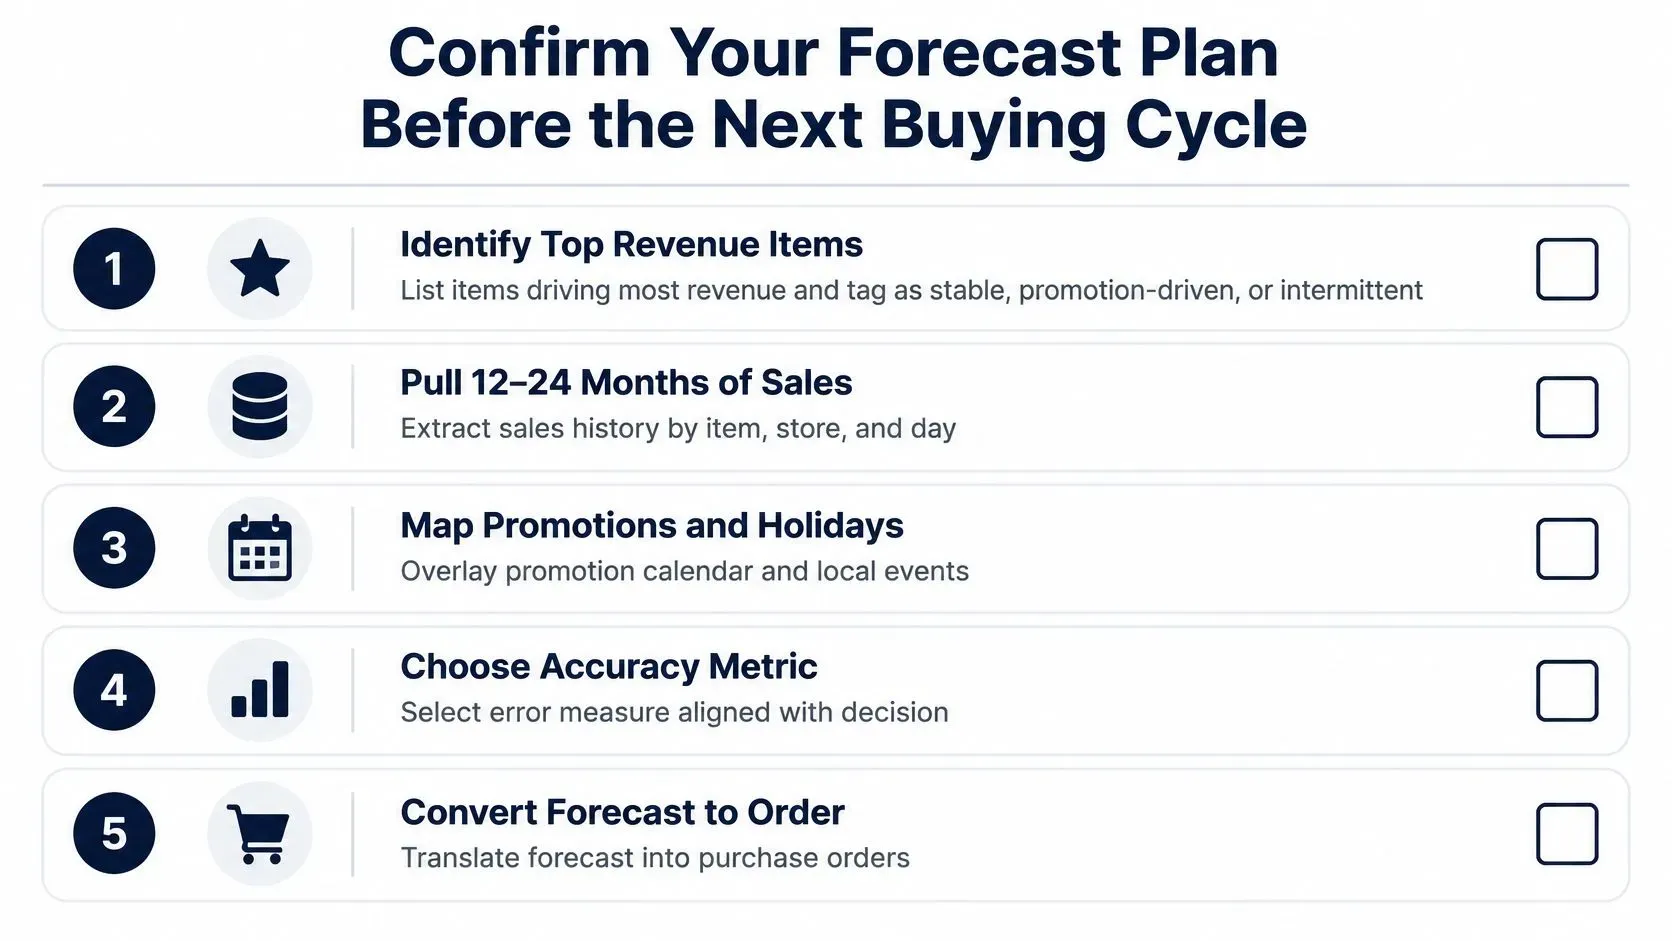
ห้าขั้นตอนด้านล่างคือแนวคิดทั้งหมดในแบบย่อ ตั้งแต่การพยากรณ์ไปจนถึงใบสั่งซื้อที่การพยากรณ์นั้นควรนำไปสู่
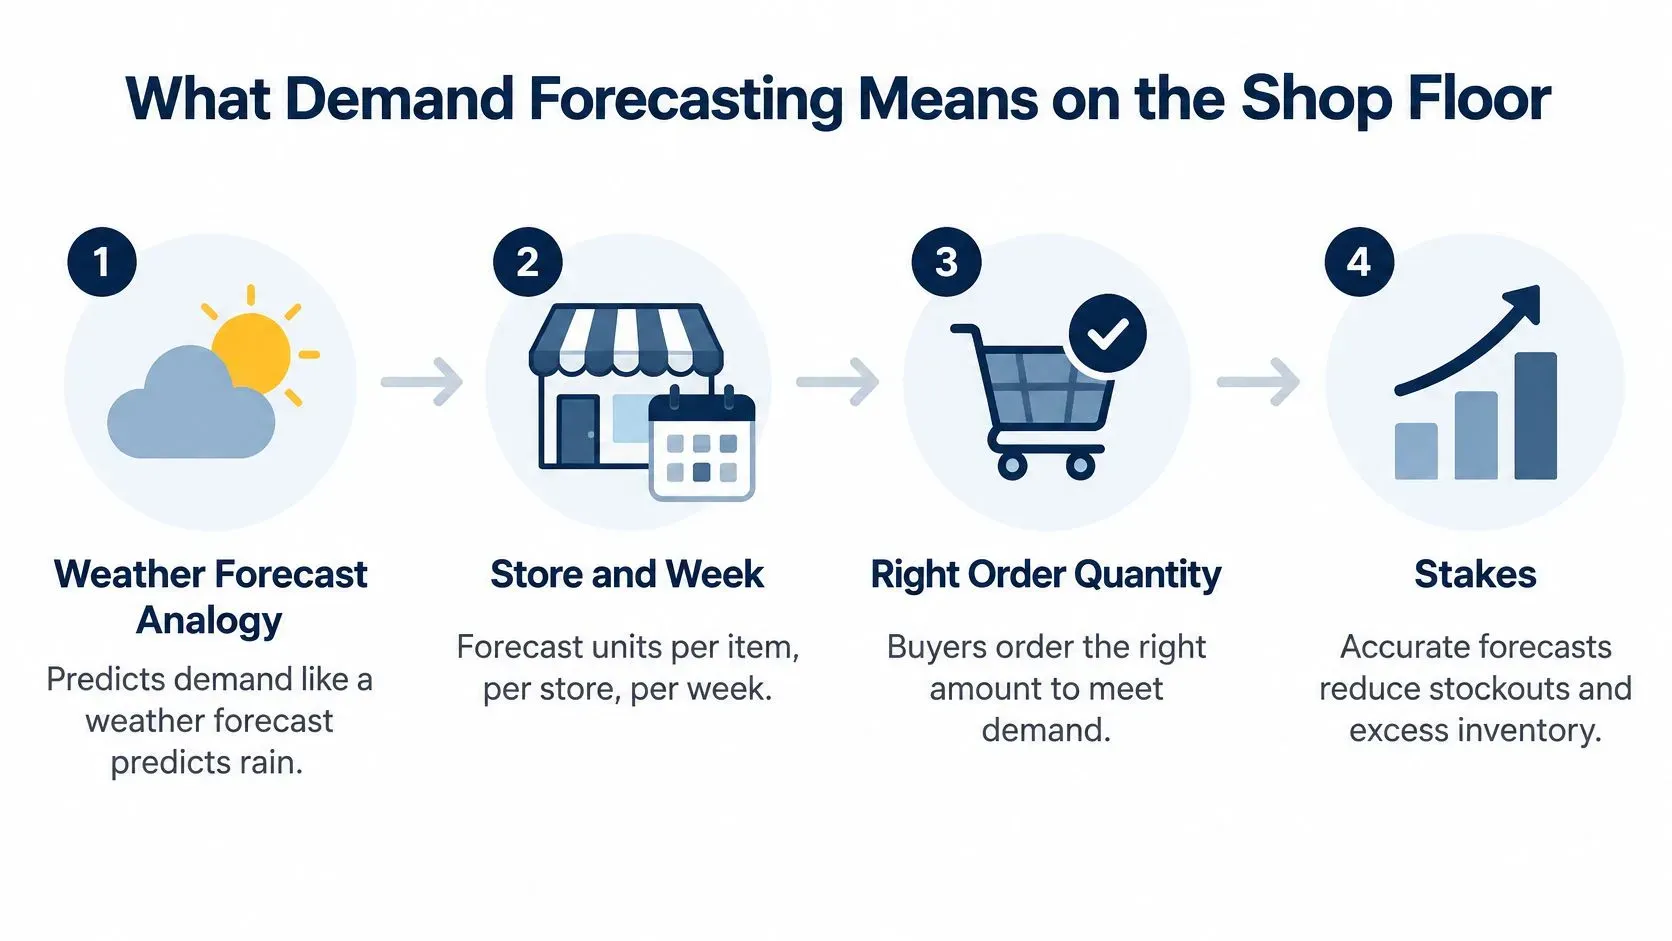
เป้าหมายคือความต้องการสินค้า ไม่ใช่ยอดขายที่เครื่องบันทึกเงินสดบันทึกไว้ตามบังเอิญ ค่าศูนย์ที่บันทึกในช่วงที่ชั้นวางแชมพูว่างเปล่าคือความต้องการที่ถูกตัดทอน ส่วนยอดขายที่พุ่งขึ้นจากโปรโมชันอาจเป็นยอดที่ดึงมาจากสองสัปดาห์ถัดไป หรือดึงมาจากร้านใกล้เคียง ค่าเฉลี่ยระดับหมวดหมู่และรายงานรายเดือนซ่อนปัญหาระดับสินค้าและสาขาเหล่านี้ไว้ ดังนั้นสัญญาณต้องคงความละเอียดและอัปเดตบ่อย
วงจรการทำงานเป็นดังนี้
- รวบรวมประวัติยอดขายและสต็อกแยกตามสินค้า สาขา และวัน รวมถึงวันที่ชั้นวางว่างเปล่า
- ทำความสะอาดและจัดให้สอดคล้องกัน ใช้หน่วยวัดเดียว ปฏิทินเดียว และไม่มีแถวซ้ำเมื่อระบบของสาขาแก้ไขข้อมูลย้อนหลังของสัปดาห์
- ปรับโมเดลและพยากรณ์ความต้องการแยกตามสินค้าและสาขา ในระดับความละเอียดที่การตัดสินใจสั่งซื้อของคุณต้องการ
- แปลงการพยากรณ์เป็นคำสั่งซื้อและสต็อกสำรอง โดยใช้ระยะเวลาการจัดส่งและระดับการให้บริการที่คุณให้คำมั่นไว้
- วัดความคลาดเคลื่อนและปรับปรุงทีละสินค้า แทนที่จะทำปีละครั้งตอนทำงบประมาณ
แต่ละขั้นตอนช่วยป้องกันต้นทุนหนึ่งในสามประเภท หากพยากรณ์ต่ำเกินไป คุณจะเสียยอดขายที่เรียกคืนไม่ได้ เพราะลูกค้าซื้อสินค้าทดแทนหรือเดินจากไป หากพยากรณ์สูงเกินไป เงินสดจะจมอยู่กับสต็อกที่ต้องลดราคาเพื่อระบาย หากปริมาณใกล้เคียงแต่จังหวะเวลาผิด คุณจะเสียทั้งสองทาง คือค่าขนส่งด่วนที่แพงขึ้นสำหรับคำสั่งซื้อเร่งด่วน และค่าจัดเก็บสินค้าส่วนเกิน
กฎที่ช่วยประหยัดเงินได้มากที่สุด: การพยากรณ์จะคุ้มค่าก็ต่อเมื่อมีกฎการเติมสินค้ามาใช้งานตามตัวเลขนั้น ตัวเลขที่สมบูรณ์แบบแต่นอนอยู่ในรายงานไม่ได้เปลี่ยนอะไรบนชั้นวางเลย
ข้อมูลนำเข้า และเหตุผลที่สินค้าขาดสต็อกทำให้ข้อมูลบิดเบือน
ก่อนจะเปรียบเทียบโมเดล ให้ดูก่อนว่าป้อนอะไรเข้าไปบ้าง ข้อมูลนำเข้าที่ส่งผลต่อความแม่นยำในธุรกิจค้าปลีกมากที่สุดนั้นเป็นเรื่องพื้นฐานและไม่หวือหวา แต่หลายทีมยังขาดไปสองถึงสามอย่าง
- ประวัติยอดขายแยกตามสินค้า สาขา และวัน ข้อมูลที่หยาบกว่านี้จะซ่อนสัปดาห์โปรโมชันและช่วงยอดพุ่งในวันหยุดสุดสัปดาห์ ซึ่งเป็นตัวสร้างสัญญาณสำคัญ
- สินค้าคงคลังและระยะเวลาที่สินค้าขาดสต็อก หากไม่มีข้อมูลเหล่านี้ คุณจะแยกไม่ออกว่าสัปดาห์ที่เงียบเป็นเพราะขายน้อยหรือเพราะชั้นวางว่าง
- ราคาและระดับส่วนลด ส่วนลด 10% กับ 30% ไม่ได้ให้เส้นตอบสนองของลูกค้าเหมือนกัน ดังนั้นควรเก็บราคาบนชั้นวางที่ลูกค้าจ่ายจริง ไม่ใช่ราคาป้าย
- ปฏิทินโปรโมชัน รวมถึงตำแหน่งการจัดวางสินค้าและการโฆษณาเด่น
- วันหยุดและกิจกรรมในพื้นที่ งานโรงเรียนห่างไปสองช่วงถนนอาจทำให้น้ำดื่มขายดีกว่าวันหยุดนักขัตฤกษ์เสียอีก
- สภาพอากาศ โดยเฉพาะหมวดสินค้าสด สินค้าตามฤดูกาล และสินค้าสำหรับสวน
- ราคาของคู่แข่ง ในกรณีที่คุณติดตามได้อย่างสม่ำเสมอ
- ระยะเวลารอสินค้าจากซัพพลายเออร์และความล่าช้าในการส่งมอบ ซึ่งเป็นตัวกำหนดว่าคุณต้องมีสต็อกสำรองมากน้อยเพียงใด
เหตุใดชั้นวางว่างจึงสร้างเลขศูนย์ที่เป็นเท็จ
สมมติว่าแชมพูของคุณขายได้เฉลี่ย 40 ชิ้นต่อสัปดาห์ แล้วชั้นวางว่างอยู่สามวัน วันเหล่านั้นจะบันทึกยอดขายเป็นศูนย์ โมเดลที่ฝึกจากประวัตินี้จะเรียนรู้ว่าอุปสงค์ลดลงทุกครั้งที่สินค้าหมด ซึ่งตรงข้ามกับความจริง ลูกค้าที่หาสินค้าไม่เจอไม่ได้เปลี่ยนใจ แต่พวกเขาไปซื้อที่อื่น
ความล่าช้าของซัพพลายเออร์ การเติมสินค้าที่ช้า และการตัดสินใจสั่งซื้อของคุณเอง ก็ตัดยอดขายออกไปในลักษณะเดียวกันทุกประการ โมเดลไม่มีทางแยกได้ว่าเป็นยอดขายที่เสียไปหรือความสนใจที่หายไป และจะสั่งสินค้าที่ขายหมดเร็วที่สุดน้อยเกินไปต่อไปเรื่อย ๆ
ความล้มเหลวนี้มีหลักฐานยืนยันชัดเจน บทความทบทวนปี 2026 เรื่องแมชชีนเลิร์นนิงในการพยากรณ์ธุรกิจค้าปลีก ระบุว่าชุดข้อมูลที่ไม่สมบูรณ์ ไปป์ไลน์ข้อมูลที่กระจัดกระจาย พฤติกรรมลูกค้าที่เปลี่ยนไป โปรโมชัน ปฏิกิริยาของคู่แข่ง และฤดูกาล เป็นสาเหตุของโมเดลที่มีอคติและเปราะบาง บทความเดียวกันอ้างอิงการสำรวจผู้เชี่ยวชาญด้านสินค้าคงคลัง 661 คน ซึ่งร้อยละ 51 เคยดำเนินการตามการพยากรณ์ที่ตนเองเห็นว่าไม่น่าเชื่อถืออยู่แล้วเป็นบางครั้ง เพราะไม่มีทางเลือกที่ดีกว่า ขณะที่การเปลี่ยนแปลงด้านภาษีศุลกากรและนโยบายการค้า (ร้อยละ 19) และความผันผวนของเงินเฟ้อหรือราคาสินค้าโภคภัณฑ์ (ร้อยละ 17) อยู่ในกลุ่มปัจจัยรบกวนที่ใหญ่ที่สุด
วิธีแก้สี่ขั้นตอน เรียงตามลำดับ
- ทำเครื่องหมายทุกวันที่สินค้าหมดในประวัติการขาย พร้อมระบุจำนวนชั่วโมงหรือจำนวนวันที่สินค้าไม่พร้อมขาย
- ประเมินยอดขายที่เสียไปในวันเหล่านั้น จากสินค้าที่เทียบเคียงได้ในร้านเดียวกันและสัปดาห์เดียวกัน
- ติดแท็กแต่ละช่วงเวลาว่าสินค้าพร้อมขายหรือถูกจำกัด ก่อนเริ่มรันการฝึกโมเดลทุกครั้ง
- ฝึกโมเดลด้วยประวัติที่ปรับแล้ว และเปรียบเทียบผลบนสัปดาห์ที่กันไว้ต่างหาก ไม่ใช่บนสัปดาห์ที่คุณแก้ไขข้อมูล
สำหรับ SME ส่วนใหญ่ งานนี้ช่วยเพิ่มความแม่นยำได้มากกว่าการเปลี่ยนอัลกอริทึม โมเดลเรียนรู้ได้เฉพาะสิ่งที่อยู่ในข้อมูลเท่านั้น หากข้อมูลบอกว่าความต้องการดิ่งลงช่วงสินค้าหมด สถาปัตยกรรมที่ซับซ้อนกว่าก็แค่เรียนรู้สิ่งที่ผิดได้เร็วขึ้น คู่มือ ELECTE เรื่องการรวมข้อมูลหลายแหล่งของเราอธิบายระบบเชื่อมต่อที่นำข้อมูลยอดขาย สต็อก และโปรโมชันมารวมไว้ในตารางเดียวที่ใช้งานได้
เปรียบเทียบวิธีพยากรณ์ตามสถานการณ์ของร้านค้าปลีก
ไม่มีวิธีที่ดีที่สุด มีแต่วิธีที่เหมาะกับสถานการณ์ ตารางด้านล่างคือการเปรียบเทียบที่ผมอยากให้ติดไว้เหนือโต๊ะวางแผน
วิธีการ | สถานการณ์ค้าปลีกที่เหมาะที่สุด | ข้อมูลที่ต้องใช้ | จุดแข็ง | ข้อควรระวัง |
|---|---|---|---|---|
ค่าเฉลี่ยเคลื่อนที่ หรือการปรับเรียบแบบเอกซ์โปเนนเชียล | สินค้าที่ขายสม่ำเสมอและมีปริมาณสูง | ยอดขายรายสัปดาห์ 1-2 ปี | เรียบง่าย ต้นทุนต่ำ และอธิบายได้ง่าย | ไม่เห็นผลของโปรโมชันและการเปลี่ยนแปลงตามฤดูกาล |
โมเดลตามฤดูกาล เช่น SARIMA | สินค้าที่มีวัฏจักรรายสัปดาห์หรือรายปีชัดเจน | ข้อมูลย้อนหลังตั้งแต่สองฤดูกาลขึ้นไป | จับแนวโน้มและฤดูกาลได้ | ทำงานได้ไม่ดีเมื่อต้องพยากรณ์อนุกรมเวลานับพันชุดพร้อมกัน |
วิธีในกลุ่ม Croston | SKU ที่ขายเป็นช่วงๆ และเคลื่อนไหวช้า | ประวัติยอดขายที่มีหลายช่วงเวลาที่ไม่มียอดขายเลย | แยกความถี่ของการขายออกจากขนาดของยอดขาย | ไม่เหมาะกับสินค้าที่ขายสม่ำเสมอ |
การถดถอยที่ใช้ตัวแปรโปรโมชันและราคา | หมวดสินค้าที่ขับเคลื่อนด้วยโปรโมชัน | ปฏิทินโปรโมชันและประวัติราคา | แสดงให้เห็นว่าแต่ละปัจจัยส่งผลต่อดีมานด์อย่างไร | ใช้ไม่ได้ผลเมื่อมีโปรโมชันน้อย |
เทรีเอนเซมเบิล เช่น XGBoost หรือ LightGBM | พอร์ตโฟลิโอสินค้า-สาขาขนาดใหญ่ | ยอดขาย ปฏิทิน โปรโมชัน และราคา | เรียนรู้ข้ามอนุกรมเวลาที่เกี่ยวข้องกันได้จำนวนมาก | ต้องใช้ข้อมูลที่สะอาดและการตรวจสอบอย่างต่อเนื่อง |
เอนเซมเบิลแบบผสม LSTM-XGBoost | เครือข่ายหลายหมวดสินค้าที่มีสัญญาณข้อมูลหลากหลาย | ข้อมูลจุดขาย (POS) และโปรโมชัน 36 เดือน | ลดค่าความคลาดเคลื่อนเปอร์เซ็นต์สัมบูรณ์เฉลี่ย (MAPE) ลงเฉลี่ย 28.6% ที่ขอบเขตการพยากรณ์สี่สัปดาห์ในงานศึกษาหนึ่งที่ครอบคลุมองค์กรค้าปลีก 14 แห่ง | สร้างและอธิบายได้ยากกว่า |
รูปแบบที่อยู่เบื้องหลังตัวเลขแต่ละแถวสำคัญกว่าแถวใดแถวหนึ่ง บทวิจารณ์งานวิจัยการพยากรณ์ในธุรกิจค้าปลีกที่ผ่านการพิจารณาโดยผู้ทรงคุณวุฒิ รายงานว่าโมเดลแมชชีนเลิร์นนิงแบบรวมศูนย์ (global model) ซึ่งรวมถึงโครงข่ายประสาทเทียมแบบฟีดฟอร์เวิร์ดและแบบเรกเคอร์เรนต์ ต้นไม้ถดถอยแบบ gradient-boosted และ random forest มักให้ผลดีกว่าโมเดลอนุกรมเวลาและโมเดลถดถอยที่แยกกันสร้าง เมื่อผู้ค้าปลีกพยากรณ์ชุดข้อมูลยอดขายจำนวนมาก ข้อได้เปรียบนี้ยิ่งชัดเมื่อพอร์ตโฟลิโอใหญ่ขึ้น คือสินค้าหลายพันคู่สินค้า-สาขา ซึ่งแต่ละรายการมีอุปสงค์เบาบาง เกิดเป็นช่วงๆ ผันตามฤดูกาล หรือไวต่อโปรโมชัน
การเปรียบเทียบในเชนค้าปลีกจริงหน้าตาเป็นอย่างไร
ลองนึกภาพเชนระดับภูมิภาคที่มี 40 สาขา สินค้าหลักที่ยอดขายรายสัปดาห์สม่ำเสมอใช้ exponential smoothing เพราะผู้จัดการหมวดสินค้าอ่านตัวเลขได้และโต้แย้งได้ ส่วนเสื้อผ้าตามฤดูกาลที่มีโปรโมชันปีละแปดครั้งใช้โมเดล gradient-boosted ที่เทรนจากทุกสาขาพร้อมกัน เพราะประวัติของสาขาเดียวมีน้อยเกินกว่าจะเรียนรู้เส้นโค้งผลของส่วนลดได้
บทวิจารณ์ชิ้นเดียวกันระบุชัดเจนไม่แพ้กันว่าวิธีแบบเดิมยังไม่ล้าสมัย ประสิทธิภาพของวิธีเหล่านี้ยังแข่งขันได้กับชุดข้อมูลขนาดเล็ก สินค้าที่มีอุปสงค์คงที่ และสถานการณ์ที่ความสามารถในการอธิบายผลและข้อมูลที่จำกัดสำคัญกว่าความแม่นยำในจุดทศนิยมสุดท้าย
การรู้จักพอคุ้มค่า การประเมินอุปสงค์ค้าปลีกในสหรัฐฯ ปี 2026 บนชุดข้อมูล M5 ครอบคลุม 25,940 อนุกรมสินค้า-สาขา ใน 5 หน้าต่างเวลา 28 วันแบบเลื่อน ลดค่าเฉลี่ย weighted absolute percentage error จาก 0.9006 ของเกณฑ์เทียบแบบ seasonal-naive เป็น 0.7022 ด้วยโมเดล LightGBM ที่ใช้ข้อมูลอุปสงค์ย้อนหลัง ซึ่งดีขึ้นประมาณ 22% การเพิ่มตัวแปรด้านค้าปลีกและการปฏิบัติการทำได้เพียง 0.6979 และตัวชี้วัดเศรษฐกิจมหภาคแบบล่าช้าทำได้ 0.6978 หรือดีขึ้นราว 0.02%
สร้างเกณฑ์พื้นฐานก่อน ตัวเลขแบบ seasonal-naive หรือ exponential smoothing ที่ใช้เวลาทำเพียงครึ่งวันบอกคุณได้ว่าโมเดลแมชชีนเลิร์นนิงคุ้มกับความซับซ้อนหรือไม่ รันทั้งสองแบบบนสัปดาห์ที่กันไว้ทดสอบชุดเดียวกัน แล้วเลือกตัวที่ชนะ
การเลือกโมเดลควรดูจากขนาดและโครงสร้างของพอร์ตโฟลิโอ ไม่ใช่ดูว่าวิธีไหนใหม่กว่า หลักการข้อเดียวนี้ช่วยประหยัดเงินได้มากกว่าการค้นหาไฮเปอร์พารามิเตอร์ใดๆ
สินค้าขายช้าและอุปสงค์เบาบางต้องใช้โมเดลเฉพาะ
สินค้าบางอย่างไม่มี “ระดับ” อุปสงค์ แต่มี “เหตุการณ์” อุปสงค์ เช่น อะไหล่ที่ขายได้ปีละสี่ครั้ง ตัวเลือกสินค้าในกลุ่มหางยาวของอีคอมเมิร์ซ หรือคู่สาขา-SKU ที่ขายได้เดือนละสองชิ้น โมเดลตามฤดูกาลมาตรฐานรับมือกับสิ่งเหล่านี้ได้ไม่ดี และสาเหตุอยู่ที่โครงสร้างของข้อมูล
ค่าศูนย์กับยอดขายที่เป็นบวกมาจากสองกระบวนการที่ต่างกัน คำถามแรกคือเกิดการขายหรือไม่ อีกคำถามคือเมื่อขายแล้วปริมาณเท่าใด วิธีแบบ Croston ประมาณสองเรื่องนี้แยกกัน จึงทนทานบนข้อมูลค้าปลีกที่เต็มไปด้วยศูนย์ เกณฑ์เปรียบเทียบการพยากรณ์ค้าปลีกสำหรับอุปสงค์ไม่ต่อเนื่อง รายงานว่า Croston ได้ WAPE 93.15% และ MASE 0.9852 ดีกว่าวิธี naive และ SARIMAX ที่นำมาเทียบ ให้อ่านค่า WAPE นี้เป็นผลเชิงเปรียบเทียบบนอนุกรมที่เต็มไปด้วยศูนย์ ไม่ใช่คะแนนความแม่นยำที่ดีในเชิงสัมบูรณ์
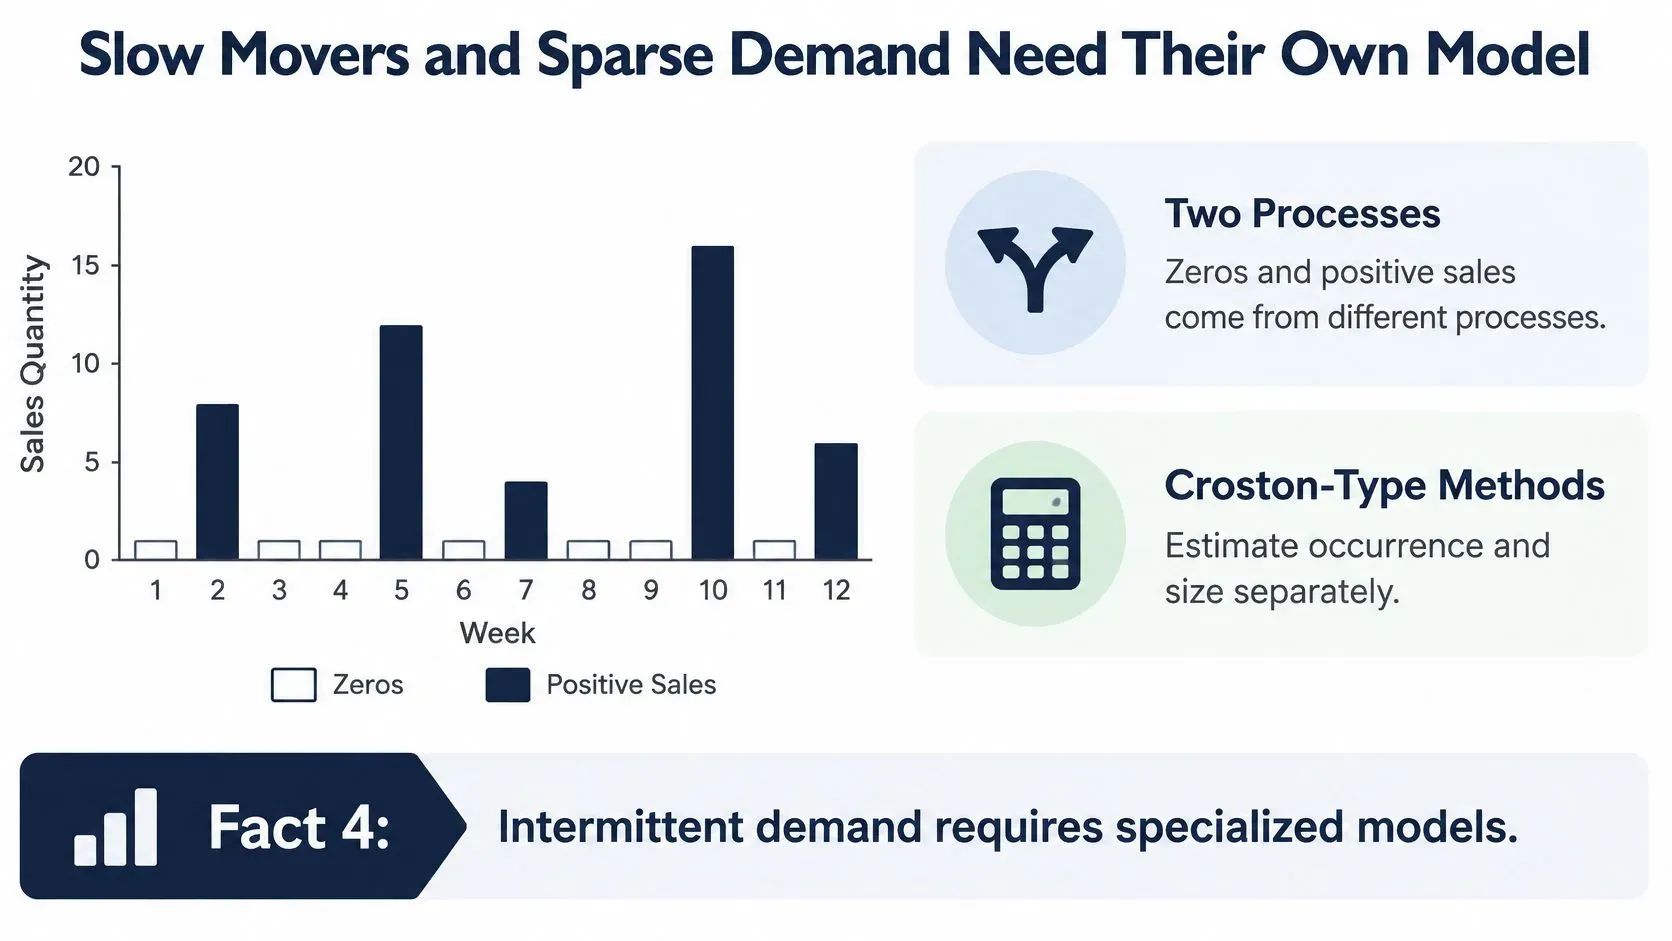
รูปแบบความล้มเหลวนี้เฉพาะเจาะจงและสร้างความเสียหายสูง โมเดลถดถอยหรือโมเดลตามฤดูกาลทั่วไปเห็นข้อมูลที่เป็นศูนย์ต่อเนื่องกันแล้วสรุปว่าอุปสงค์ต่ำและคงที่ จึงกำหนดสต็อกสำรองตามนั้น สินค้าเคลื่อนไหวช้าที่ขายเป็นช่วงสั้นๆ แบบคาดเดาไม่ได้ก็ขาดสต็อก ขณะที่สินค้าที่ไม่มียอดขายเลยกลับมีสต็อกพอสำหรับสามเดือน ข้อผิดพลาดอย่างแรกทำให้เสียยอดขาย อย่างหลังทำให้เสียเงินสดและพื้นที่บนชั้นวาง
ยังมีบทเรียนที่สองในประเด็นเดียวกัน การเปรียบเทียบประสิทธิภาพบนข้อมูลยอดขายที่มีอุปสงค์เป็นช่วงๆ ข้อมูลสังเกตที่ขาดหาย และการหมุนเวียนของกลุ่มสินค้าบ่อยครั้ง พบว่าโมเดลแบบต้นไม้ที่แยกตามกลุ่มย่อยให้ผลดีที่สุดในบรรดาแนวทางที่ทดสอบ โดย XGBoost ให้ค่ารากที่สองของความคลาดเคลื่อนกำลังสองเฉลี่ยต่ำสุดที่รายงานไว้ที่ 4.833 ข้อสรุปไม่ใช่ "ให้ใช้ XGBoost กับทุกอย่าง" แต่คือเมื่อสินค้าหมุนเวียนเร็ว โมเดลที่สร้างแยกตามกลุ่มสินค้าอาจชนะโมเดลเดียวที่ต้องเฉลี่ยรูปแบบซึ่งเข้ากันไม่ได้
วิธีจัดเส้นทางให้แต่ละอนุกรมข้อมูล
- จัดประเภทก่อนสร้างโมเดล คำนวณค่าเฉลี่ยช่วงห่างของอุปสงค์ (Average Demand Interval) และสัมประสิทธิ์การแปรผันกำลังสองของอุปสงค์ที่ไม่เป็นศูนย์ สำหรับทุกอนุกรม ค่าแรกคือช่วงห่างทั่วไประหว่างการขายแต่ละครั้งเป็นจำนวนคาบ ค่าหลังวัดว่าปริมาณการขายแต่ละครั้งแกว่งต่างกันมากเพียงใด
- ส่งอนุกรมแบบเป็นช่วงๆ ไปยังโมเดลตระกูล Croston, โมเดลแบบ hurdle หรือโมเดลการเกิดขึ้น-ขนาด
- ส่งสินค้าที่มียอดขายคงที่และปริมาณสูง ไปยังโมเดลตามฤดูกาลหรือโมเดลแมชชีนเลิร์นนิง ซึ่งเหมาะกับสินค้ากลุ่มนี้
- ตรวจสอบการจัดประเภทใหม่ทุกไตรมาส สินค้าย้ายระหว่างประเภทได้เมื่อมีอายุมากขึ้น เลิกจำหน่าย หรือได้รับความนิยม และกฎการจัดเส้นทางที่ไม่เคยถูกรันซ้ำจะแม่นยำลดลง
เก็บการจัดประเภทไว้ในตารางที่ตรวจสอบได้ เมื่อผู้จัดการหมวดสินค้าถามว่าทำไมสินค้าชิ้นหนึ่งถึงถูกพยากรณ์ด้วยวิธีที่แปลกไป คำตอบควรเป็นตัวเลขสองค่า ไม่ใช่การยักไหล่
โปรโมชัน การกักตุน และการเปลี่ยนช่องทางขาย
สัปดาห์โปรโมชันไม่ใช่สัปดาห์ปกติ และการผสมรวมเข้ากับค่าฐานจะทำให้ทั้งสองอย่างเพี้ยน ควรสร้างโมเดลอุปสงค์ฐานและผลของโปรโมชันแยกกัน แล้วจึงรวมเข้าด้วยกัน
การเปรียบเทียบแนวทางการพยากรณ์ในธุรกิจค้าปลีก พบว่าโมเดลรวมต้นไม้ตัดสินใจทำได้ดีกว่าการถดถอยเชิงเส้น การถดถอยเชิงเส้นแบบมีบทลงโทษ และวิธีต้นไม้ถดถอย สำหรับอุปสงค์รายวันระดับเครือข่ายเมื่อ SKU มีโปรโมชันในอดีตมากกว่าห้าครั้ง เลขห้าคือเกณฑ์ที่เป็นประโยชน์จากผลลัพธ์นี้ ต่ำกว่านั้นตัวอย่างไม่พอให้โมเดลเรียนรู้ว่าความลึกของส่วนลด จังหวะเวลาของโปรโมชัน และปฏิสัมพันธ์กับปฏิทินสินค้าส่งผลต่ออุปสงค์อย่างไร การใช้ regularization ที่แรงขึ้นหรือเกณฑ์เปรียบเทียบที่เรียบง่ายกว่าจึงเสียหายน้อยกว่าโมเดลยืดหยุ่นที่ไล่ตามสัญญาณรบกวน
ป้อนฟีเจอร์ที่ชัดเจนให้โมเดล ได้แก่ สถานะโปรโมชัน เปอร์เซ็นต์ส่วนลด ตำแหน่งการจัดวางสินค้า ความใกล้เคียงกับช่วงวันหยุด และอุปสงค์หลังโปรโมชันแบบ lag ฟีเจอร์สุดท้ายมักถูกละเลย แต่เป็นตัวที่จับช่วงยอดตกได้
ยอดตกที่ไม่มีใครพยากรณ์
สมมติว่าส่วนลดแชมพู 30% ช่วยดันยอดขายขึ้นหนึ่งสัปดาห์ จากนั้นยอดขายต่ำกว่าแนวโน้มต่อเนื่องอีกสองสัปดาห์ เพราะลูกค้ากักตุนสินค้าไว้ ไม่ได้ซื้อเพิ่มตลอดทั้งไตรมาส ให้ถือช่วงสามสัปดาห์ทั้งหมดเป็นหน่วยวิเคราะห์เดียว ความคลาดเคลื่อนในช่วงโปรโมชันบอกว่าคุณสั่งสินค้าพอหรือไม่ ส่วนความคลาดเคลื่อนหลังโปรโมชันบอกว่าคุณสั่งเกินสำหรับช่วงที่เหลือของเดือนหรือเปล่า หากประเมินแยกกัน จะเห็นทั้งสองการตัดสินใจ แต่หากประเมินรวมกัน ความคลาดเคลื่อนทั้งสองจะหักล้างกัน รายงานดูเรียบร้อย ทั้งที่คุณพลาดทั้งสองอย่าง
งานวิจัยเกี่ยวกับวงจรชีวิตของโปรโมชันระบุว่างานก่อนหน้ามักมองข้ามช่วงหลังโปรโมชัน ซึ่งเป็นช่วงที่ความต้องการลดลงเพราะลูกค้ากักตุนสินค้าไว้ระหว่างโปรโมชัน และรายงานว่าวิธีแมชชีนเลิร์นนิงสามารถปรับปรุงการพยากรณ์ได้ตลอดทั้งวงจรชีวิต ไม่ใช่เฉพาะช่วงที่จัดโปรโมชันเท่านั้น
ช่องทางขายเพิ่มภาพลวงตาอีกชั้นหนึ่ง การศึกษาโปรโมชันหลายช่องทางของซูเปอร์มาร์เก็ตระดับภูมิภาคในบราซิลประเมินว่าความต้องการย้ายจากร้านค้าจริงไปออนไลน์ 11.23% และย้ายในทิศทางตรงข้าม 19.34% ขณะที่โปรโมชันที่ประสานกันช่วยลดการแย่งยอดขายกันเอง 30.04% ส่วนสิทธิประโยชน์สำหรับลูกค้าสมาชิกให้ยอดขายเพิ่มสูงสุดที่วัดได้ที่ 3.5% หากพยากรณ์แต่ละช่องทางแยกกัน คุณจะนับความต้องการซ้ำซ้อน ทั้งที่แค่ย้ายที่อยู่
จากนั้นให้ยึดกฎสี่ข้อนี้ในการประเมินผล:
- ให้คะแนนช่วงที่มีโปรโมชันและช่วงที่ไม่มีโปรโมชันแยกกัน เพื่อไม่ให้สัปดาห์ที่ดีบดบังเดือนที่แย่
- เปรียบเทียบกับเส้นฐานแบบ base-lift หรือเส้นฐานเชิงเหตุและผลที่ใกล้เคียงกัน ไม่เช่นนั้นคุณก็แค่วัดว่าโมเดลเรียนรู้ปริมาณได้ดีแค่ไหน
- ประเมินตาม SKU และตามความถี่ของโปรโมชัน เพราะเกณฑ์โปรโมชันห้าครั้งเปลี่ยนสิ่งที่คุณคาดหวังได้
- คงฟีเจอร์ล่าช้าหลังโปรโมชันไว้ เพื่อให้โมเดลแสดงการตกของยอดขายได้ แทนที่จะต้องประหลาดใจกับมัน
หากส่วนลดกำลังกัดกินกำไรของคุณ คู่มือเรื่องการปกป้องอัตรากำไรระหว่างแคมเปญส่วนลดของเราครอบคลุมด้านราคาของปัญหาเดียวกันนี้
การวัดความแม่นยำและการแปลงการพยากรณ์เป็นคำสั่งซื้อ
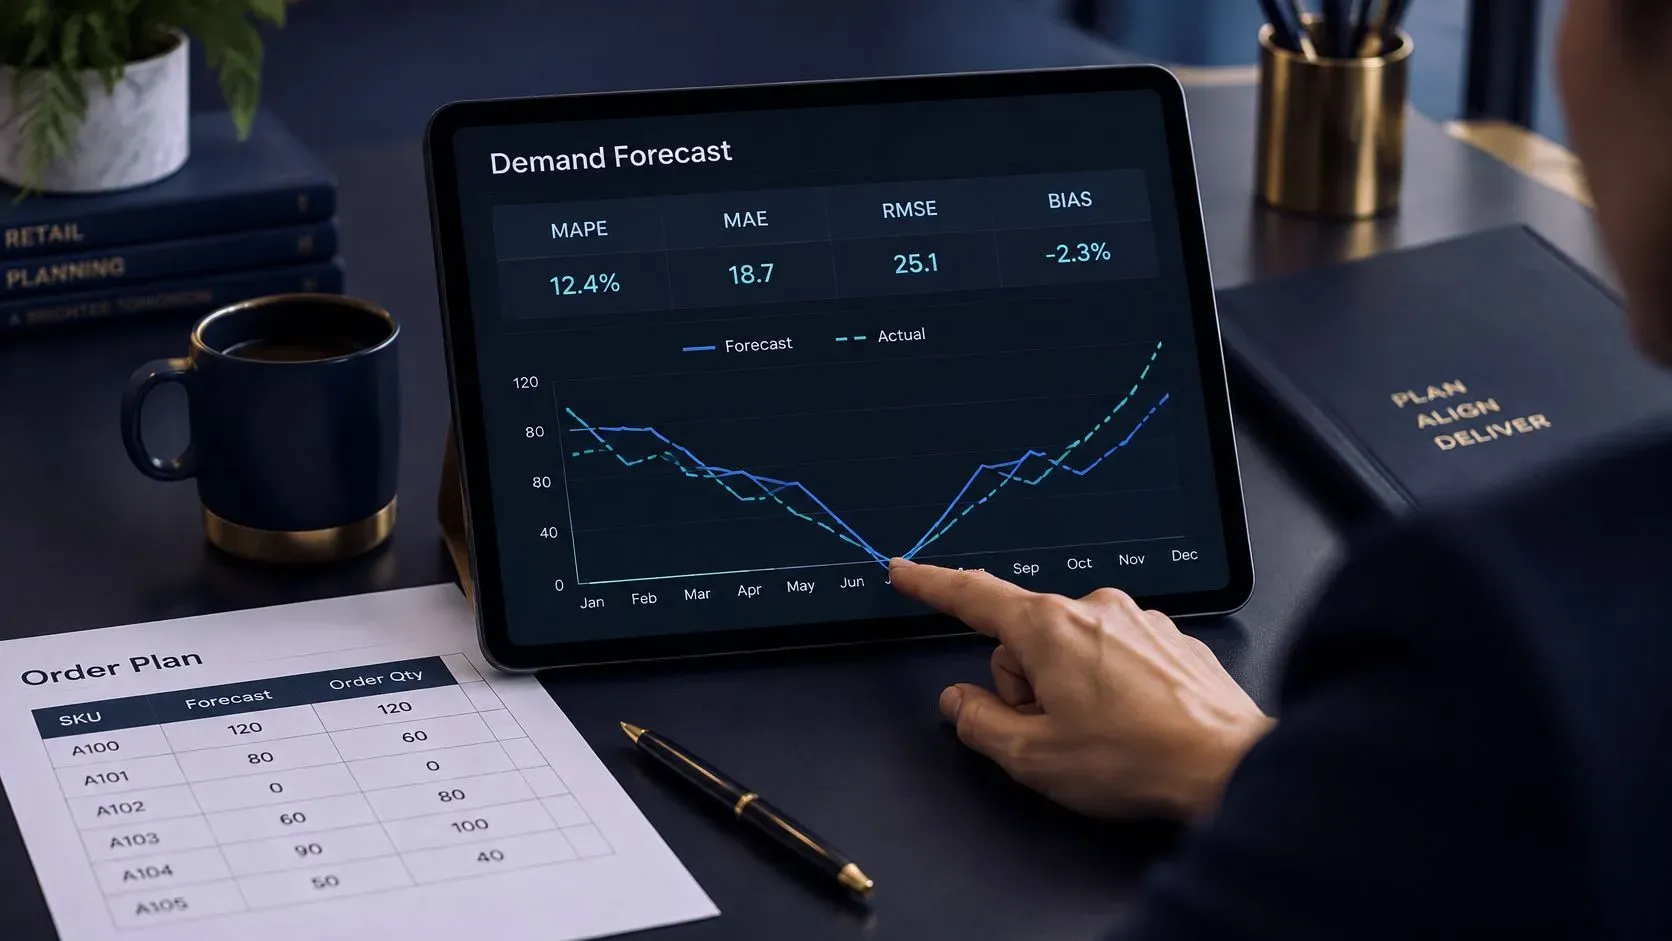
เลือกตัวชี้วัดหลังจากเลือกการตัดสินใจแล้ว แต่ละตัวชี้วัดตอบคำถามต่างกัน และซ่อนสิ่งที่ต่างกันไว้
ตัวชี้วัด | ใช้เมื่อ | ข้อควรระวัง |
|---|---|---|
WAPE (ค่าคลาดเคลื่อนเปอร์เซ็นต์สัมบูรณ์แบบถ่วงน้ำหนัก) | เปรียบเทียบความแม่นยำข้ามสินค้าที่มีขนาดต่างกัน | ให้น้ำหนักกับสินค้าที่มีปริมาณสูงมากที่สุด |
MASE (ค่าคลาดเคลื่อนสัมบูรณ์เฉลี่ยแบบปรับสเกล) | เปรียบเทียบโมเดลกับอนุกรมเวลาที่มีความต้องการไม่ต่อเนื่องหรือมีค่าศูนย์จำนวนมาก | ต้องมีเกณฑ์เปรียบเทียบแบบ naive จึงจะอ่านค่าได้ถูกต้อง |
MAPE (ค่าคลาดเคลื่อนเปอร์เซ็นต์สัมบูรณ์เฉลี่ย) | รายงานแบบเรียบง่ายสำหรับสินค้าที่ขายสม่ำเสมอและมีปริมาณสูง | ไม่เสถียรหรือไม่สามารถคำนวณได้เมื่อความต้องการจริงเป็นศูนย์ |
Bias (ความเอนเอียง) | ตรวจจับการพยากรณ์สูงเกินหรือต่ำเกินอย่างเป็นระบบ | ความคลาดเคลื่อนที่หักล้างกันอาจซ่อนปัญหาไว้ หากไม่ดูแยกตามช่วงเวลา |
ระดับการให้บริการ | ตรวจสอบว่าการพยากรณ์ช่วยรักษาความพร้อมของสินค้าบนชั้นวางหรือไม่ | ขึ้นอยู่กับการตั้งค่าการเติมสินค้า ไม่ได้ขึ้นอยู่กับการพยากรณ์เพียงอย่างเดียว |
ค่าความคลาดเคลื่อนแบบเปอร์เซ็นต์ใช้ไม่ได้กับสินค้าที่ขายช้า เมื่อความต้องการจริงเป็นศูนย์ ตัวหารก็เป็นศูนย์ ตัวชี้วัดจะพุ่งสูงผิดปกติหรือถูกตัดออกจากค่าเฉลี่ย และทั้งสองกรณีทำให้โมเดลดูดีเกินจริง ควรรายงาน WAPE หรือค่าความคลาดเคลื่อนแบบปรับสเกล ควบคู่กับค่าความเอนเอียงและระดับการให้บริการ และอ่านผลแยกตามกลุ่มสินค้า แทนการดูตัวเลขเดียวทั้งแคตตาล็อก
จากตัวเลขสู่จุดสั่งซื้อซ้ำ
การพยากรณ์กลายเป็นคำสั่งซื้อผ่านการคำนวณที่ใครในทีมก็ตรวจสอบได้ นั่นคือความต้องการที่คาดไว้ตลอดช่วงเวลานำส่ง บวกสต็อกสำรองที่กำหนดขนาดตามระดับการให้บริการเป้าหมาย ก็จะได้จุดสั่งซื้อซ้ำ
สมมติร้านค้าคาดว่าจะขายได้ 40 หน่วยในช่วงเวลานำส่งของซัพพลายเออร์ 5 วัน และเก็บสต็อกสำรองไว้ 10 หน่วย จุดสั่งซื้อซ้ำคือ 50 หน่วย เมื่อสินค้าคงคลังรวมกับสินค้าที่สั่งแล้วลดลงถึง 50 ก็ส่งคำสั่งซื้อทันที แต่ถ้าผู้ซื้อสั่งที่ 40 เพราะไม่เคยตกลงเรื่องสต็อกสำรองกัน ชั้นวางก็จะว่างตั้งแต่วันแรกที่รถส่งของมาช้า
มีสองกิจวัตรที่ช่วยให้ระบบน่าเชื่อถือ อย่างแรกคือตั้งการแจ้งเตือนข้อยกเว้นเมื่อความคลาดเคลื่อนของการพยากรณ์รายสินค้าเกินเกณฑ์ตั้งแต่สองช่วงเวลาติดต่อกันขึ้นไป เพื่อให้มีคนมาดูที่ตัวสินค้า ไม่ใช่แค่ดูแดชบอร์ด อย่างที่สองคือตรวจค่าความเอนเอียงรายเดือนตามหมวดหมู่ เพื่อจับการพยากรณ์สูงหรือต่ำเกินไปอย่างเป็นระบบ ซึ่งความคลาดเคลื่อนรายสินค้าจะเฉลี่ยจนมองไม่เห็น
การพยากรณ์ที่แม่นยำทางสถิติก็ยังทำให้เกิดสินค้าขาดได้ หากจังหวะการสั่งซื้อ ความถี่ในการทบทวน หรือสต็อกสำรองถูกปรับไว้ไม่เหมาะสม ควรทบทวนการพยากรณ์และกฎการเติมสินค้าไปพร้อมกัน ไม่เช่นนั้นคุณจะแก้ผิดจุดอยู่เรื่อยไป
คู่มือการวิเคราะห์ข้อมูลสต็อกของ ELECTE อธิบายเพิ่มเติมเกี่ยวกับการเชื่อมโยงสถานะสต็อกกับตัวเลขที่ผู้ซื้อใช้ตัดสินใจ
ยืนยันแผนการพยากรณ์ก่อนรอบการจัดซื้อถัดไป
ก่อนสั่งซื้อครั้งต่อไป ให้ตรวจสอบว่ากระบวนการพยากรณ์เหมาะกับสินค้าและการตัดสินใจที่ต้องรองรับ ห้าข้อตรวจสอบนี้ช่วยให้แผนใช้งานได้จริง:
- คัดแยกกลุ่มสินค้า ระบุสินค้าที่สร้างรายได้ส่วนใหญ่ แล้วจัดประเภทเป็นสินค้าที่ขายสม่ำเสมอ สินค้าที่ขึ้นกับโปรโมชัน หรือสินค้าที่ขายเป็นช่วงๆ สำหรับสินค้าที่เหลือ กฎที่ง่ายกว่าอาจเพียงพอ
- ตรวจสอบประวัติการขาย ดึงยอดขาย 12 ถึง 24 เดือนแยกตามสินค้า สาขา และวัน พร้อมทำเครื่องหมายวันที่สินค้าขาดสต็อก หากมีข้อมูลเพียง 12 เดือน ก็ใช้ได้ แต่ควรคาดว่าความคลาดเคลื่อนจะกว้างขึ้น
- ทดสอบเทียบกับเกณฑ์พื้นฐาน ตั้งเกณฑ์พื้นฐานแบบฤดูกาล แล้วเปรียบเทียบกับโมเดลที่ซับซ้อนกว่าบนสัปดาห์ที่กันไว้ทดสอบ ผล M5 ข้างต้นแสดงว่าทำไมโมเดลที่ซับซ้อนกว่าต้องพิสูจน์คุณค่าของตัวเอง
- กำหนดกิจวัตรการวัดผล เลือกตัวชี้วัดสำหรับแต่ละการตัดสินใจ แล้วคงเกณฑ์และรอบการทบทวนให้สอดคล้องกันทุกรอบ
- ทบทวนความผิดพลาดที่เกิดซ้ำ ตรวจสอบจุดสั่งซื้อซ้ำของสินค้าที่พยากรณ์คลาดเคลื่อนต่อเนื่องอีกครั้งก่อนสั่งซื้อ
ELECTE รันวิธีพยากรณ์หกวิธีบนข้อมูลของผู้ใช้ ให้คะแนนเปรียบเทียบกัน และเลือกวิธีที่แม่นยำที่สุด เครื่องมือคำนวณจุดสั่งซื้อซ้ำแบบฟรีของ ELECTE ช่วยคำนวณจุดสั่งซื้อซ้ำของสินค้าแต่ละรายการ
การพยากรณ์ช่วยลดความเสี่ยง แต่ไม่อาจครอบคลุมทุกการเปลี่ยนแปลง โมเดลอาจพลาดการเปิดตัวสินค้าใหม่ หรือโปรโมชันที่ไม่มีประวัติการขายเทียบเคียง ควรมีกิจวัตรการทบทวนควบคู่กับการพยากรณ์ เพื่อให้ผู้ซื้อตอบสนองได้เมื่อความต้องการจริงต่างจากแผน
ELECTE เชื่อมต่อข้อมูลยอดขาย สต็อก และโปรโมชัน เปรียบเทียบวิธีพยากรณ์ 6 วิธีบนข้อมูลที่มีอยู่ และนำเสนอผลพยากรณ์ ความแม่นยำ และรายการผิดปกติในแดชบอร์ดแบบภาพที่ทีมสามารถแชร์ร่วมกันได้ สำหรับผู้ค้าปลีกที่ต้องการประเมินการพยากรณ์ความต้องการควบคู่กับข้อมูลยอดขายของตนเอง ดูรายละเอียดได้ที่ ELECTE
ความคิดเห็น
ยังไม่มีความคิดเห็น — เริ่มการสนทนาได้เลย