Efterfrågeprognoser för detaljhandeln: metoder, data och fördelar
Lär dig hur efterfrågeprognoser för detaljhandeln fungerar, vilka metoder du bör använda, vilken data som behövs och hur du minskar restnoteringar och överlager med bättre lagerplaner.

En restnotering skylls oftast på leverantören. Oftast börjar problemet närmare hemmet. En lagerstudie inom detaljhandeln som presenterades vid IEOM Societys konferens i Bangladesh 2025 visar att 51 till 73 procent av restnoteringarna i snabbköp har sitt ursprung inom själva butiksverksamheten, där felaktiga prognoser (bland annat underskattad efterfrågan) och beställningsfel hör till de största orsakerna.
Det ändrar synen på arbetet. Efterfrågeprognoser för detaljhandeln handlar inte om att välja den mest avancerade algoritmen. Det är en arbetsdisciplin: att få fram ärliga efterfrågesignaler ur data som restnoteringar och kampanjer redan har förvrängt, att anpassa metoden efter hur varje produkt säljer och att koppla resultatet till beställningspunkter som en inköpare faktiskt använder på måndagsmorgonen.
Den här guiden går igenom hela kedjan. Du får se vad prognosen måste leverera, vilka indata som väger tyngst, hur sex vanliga metoder står sig i olika butikssituationer, varför långsamgående artiklar kräver en annan uppbyggnad, hur hamstring och kanalbyten blåser upp den synliga kampanjeffekten, vilket felmått du ska lita på för vilket beslut, och en kontroll i fem steg att göra inför nästa inköpsomgång.
Vad efterfrågeprognoser betyder ute i butiken
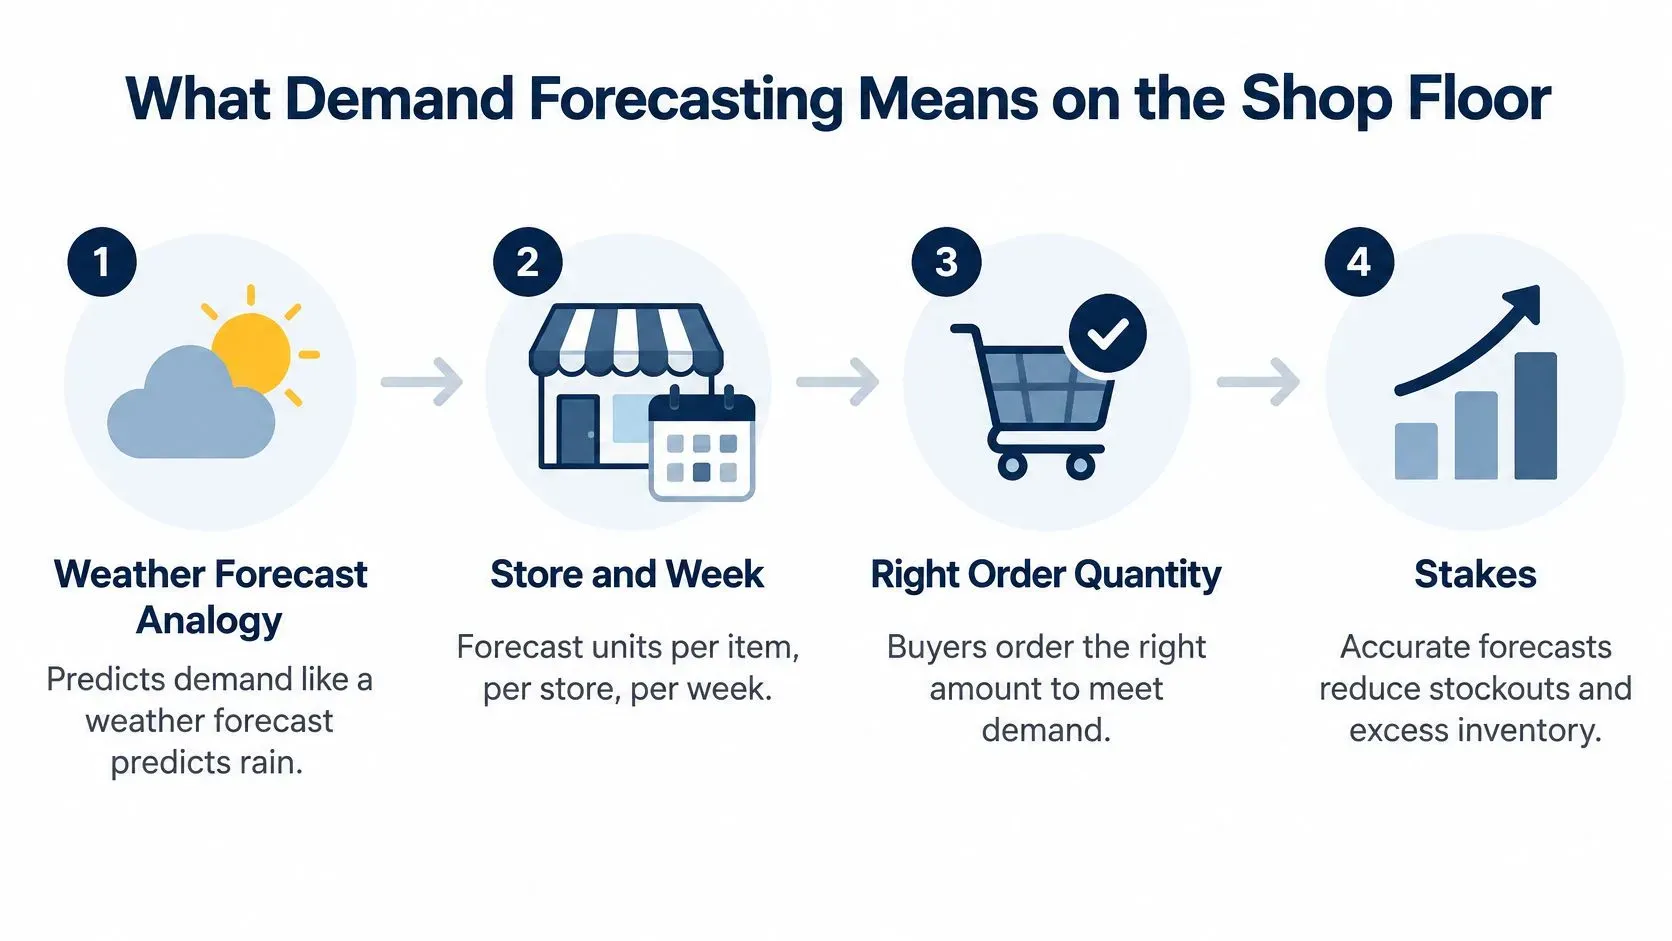
En väderprognos blir trovärdig när den är lokal och tidssatt: risken för regn i din stad på tisdag eftermiddag räcker för att avgöra om du ska ta med paraply. Efterfrågeprognoser gör samma jobb för lagret. De uppskattar hur många enheter av en viss artikel kunderna köper i en viss butik under en viss vecka, så att inköparen beställer rätt kvantitet i stället för en rimlig.
Fem stegen nedan är hela idén i miniatyr, från prognosen till den inköpsorder den ska utlösa.
Målet är efterfrågan, inte den försäljningssiffra som kassan råkade registrera. En nolla som loggades medan schampohyllan var tom är censurerad efterfrågan, och en kampanjtopp kan vara lånad från de närmaste två veckorna eller hämtad från en annan butik i närheten. Kategorimedelvärden och månadsrapporter döljer de här problemen på artikel- och butiksnivå, så signalen måste hållas detaljerad och uppdateras ofta.
Arbetsflödet ser ut så här:
- Samla in försäljnings- och lagerhistorik per artikel, butik och dag, inklusive de dagar då en hylla var tom.
- Rensa och synka den: en måttenhet, en kalender och inga dubbletter när ett butikssystem skriver om en vecka.
- Anpassa modellen och prognostisera efterfrågan per artikel och butik, på den detaljnivå som ditt beställningsbeslut kräver.
- Översätt prognosen till beställningar och säkerhetslager med hjälp av ledtider och den servicenivå du har lovat.
- Mät fel och justera, artikel för artikel, i stället för en gång om året vid budgeten.
Varje steg skyddar mot en av tre kostnader. Prognostiserar du för lågt förlorar du försäljning som inte går att få tillbaka, eftersom kunden köper ersättningsvaran eller går därifrån. Prognostiserar du för högt binds kapital i lager som måste prissänkas. Får du kvantiteten ungefär rätt men tidpunkten fel betalar du åt båda håll, med fraktpåslag på expressbeställningen och lagerkostnad för överskottet.
Regeln som sparar mest pengar: en prognos är bara värd något när en påfyllningsregel agerar på den. Ett perfekt tal i en rapport ändrar ingenting i hyllan.
Dataindata och varför restnoteringar förvränger dem
Innan du jämför modeller bör du titta på vad som går in. De indata som påverkar träffsäkerheten mest i detaljhandeln är förutsägbara och tråkiga, och många team saknar två eller tre av dem.
- Försäljningshistorik per artikel, butik och dag. Allt grövre döljer kampanjveckorna och helgtopparna som bär signalen.
- Lagersaldo och restnoteringens varaktighet. Utan dem kan du inte skilja en lugn vecka från en tom hylla.
- Priser och rabattdjup. En sänkning på 10 % och en på 30 % ger inte samma responskurva, så spara hyllpriset som kunderna betalar, inte listpriset.
- Kampanjkalendern, inklusive displayplacering och annonsering.
- Helgdagar och lokala evenemang. En skolfest två kvarter bort flyttar mer flaskvatten än en nationell helgdag.
- Väder, särskilt för färskvaror, säsongsvaror och trädgårdskategorier.
- Konkurrenternas priser, där du kan observera dem konsekvent.
- Leverantörers ledtider och leveransförseningar, som avgör hur stor täckning du behöver.
Varför en tom hylla skriver en falsk nolla
Säg att ditt schampo i genomsnitt säljer 40 enheter i veckan och att hyllan står tom i tre dagar. De dagarna registreras noll i försäljning. En modell som tränas på den historiken lär sig att efterfrågan faller varje gång lagret tar slut, vilket är raka motsatsen till sanningen. Kunder som inte hittade något ändrade sig inte; de gick någon annanstans.
Leveransförseningar från leverantörer, långsam påfyllning och dina egna beställningsval censurerar försäljningen på exakt samma sätt. Modellen kan inte skilja en förlorad försäljning från ett förlorat intresse, och den fortsätter att underbeställa den artikel som tar slut snabbast.
Problemet är väl belagt. En översikt från 2026 om maskininlärning i prognoser för detaljhandeln pekar ut ofullständiga dataset, fragmenterade datakedjor, förändrat kundbeteende, kampanjer, konkurrenters reaktioner och säsongsvariation som orsaker till skeva och sköra modeller. Samma översikt hänvisar till en enkät med 661 lagerproffs där 51 % ibland gick vidare med prognoser som de redan ansåg vara opålitliga eftersom inget bättre alternativ fanns, medan tull- och handelspolitiska förändringar (19 %) samt inflation eller svängningar i råvarupriser (17 %) hörde till de största störningsmomenten.
Åtgärden i fyra steg, i ordning
- Flagga varje dag med slutsåld vara i försäljningshistoriken, med antal timmar eller dagar som varan inte fanns tillgänglig.
- Uppskatta den förlorade försäljningen för dessa dagar utifrån jämförbara varor i samma butik och vecka.
- Märk varje period som tillgänglig eller begränsad innan någon träningskörning startar.
- Träna på den justerade historiken och jämför resultaten på undanhållna veckor, aldrig på de veckor du har korrigerat.
För de flesta små och medelstora företag förbättrar det här arbetet träffsäkerheten mer än ett byte av algoritm. En modell kan bara lära sig det som finns i datan. Om datan säger att efterfrågan rasade under en slutsåld period lär sig en mer avancerad arkitektur bara det felaktiga snabbare. Vår ELECTE-guide till integration av flera datakällor går igenom grunderna för att samla försäljnings-, lager- och kampanjdata i en användbar tabell.
Prognosmetoder jämförda efter detaljhandelssituation
Det finns ingen bästa metod, bara en metod som passar situationen. Tabellen nedan är den jämförelse jag själv skulle vilja ha uppsatt ovanför ett planeringsbord.
Metod | Bäst lämpad i detaljhandeln när | Data som krävs | Styrka | Att se upp med |
|---|---|---|---|---|
Glidande medelvärde eller exponentiell utjämning | Stabila artiklar med hög volym | 1–2 års veckoförsäljning | Enkel, billig och lätt att förklara | Missar kampanjer och säsongsskiftningar |
Säsongsmodeller som SARIMA | Artiklar med tydliga vecko- eller årscykler | Historik över två eller fler säsonger | Fångar både trend och säsongsvariation | Har svårt att hantera tusentals tidsserier samtidigt |
Metoder i Croston-familjen | Intermittenta, långsamt rörliga artiklar (SKU:er) | Försäljningshistorik med många perioder utan försäljning | Skiljer på hur ofta en försäljning sker och hur stor den är | Fel val för artiklar med jämn försäljning |
Regression med kampanj- och prisvariabler | Kampanjdrivna kategorier | Kampanjkalender och prishistorik | Visar hur varje drivkraft påverkar efterfrågan | Fungerar dåligt när kampanjerna är få |
Trädensembler som XGBoost eller LightGBM | Stora sortiment över artiklar och butiker | Försäljning, kalender, kampanjer och priser | Lär sig över många relaterade tidsserier | Kräver rena data och löpande övervakning |
Hybrida LSTM-XGBoost-ensembler | Kedjor med flera kategorier och rika signaler | 36 månaders kassadata och kampanjdata | Minskade det genomsnittliga absoluta procentuella felet (MAPE) med i snitt 28,6 % på fyra veckors horisont i en studie av 14 detaljhandelsorganisationer | Tyngre att bygga och förklara |
Mönstret bakom raderna säger mer än någon enskild rad. En peer review-granskad översikt av forskning om prognoser inom detaljhandeln visar att globala maskininlärningsmodeller, bland annat feed-forward- och rekurrenta neurala nätverk, gradientboostade regressionsträd och random forests, ofta presterar bättre än separata tidsserie- och regressionsmodeller när handlare prognostiserar stora mängder försäljningsserier. Fördelen ökar med sortimentets storlek: tusentals kombinationer av artikel och butik där enskilda produkter har glesa, intermittenta, säsongsberoende eller kampanjkänsliga efterfrågemönster.
Så ser jämförelsen ut i en verklig kedja
Tänk dig en regional kedja med 40 butiker. Basvaror med jämn veckoförsäljning får exponentiell utjämning, eftersom en kategorichef kan läsa siffran och argumentera mot den. Säsongskläder med åtta kampanjer per år får en gradientboostad modell som tränas på alla butiker samtidigt, eftersom en enskild butiks historik är för tunn för att lära sig en rabattkurva.
Översikten är lika tydlig med att de äldre metoderna inte är föråldrade. De förblir konkurrenskraftiga på mindre datamängder, stabila produkter och i situationer där tolkbarhet och begränsad data väger tyngre än den sista procentenheten av noggrannhet.
Återhållsamhet lönar sig. En utvärdering från 2026 av efterfrågan i amerikansk detaljhandel på M5-datasetet, som omfattade 25 940 serier av artikel och butik över fem rullande 28-dagarsfönster, sänkte det genomsnittliga viktade absoluta procentuella felet från 0,9006 för en säsongsnaiv referensmodell till 0,7022 med en LightGBM-modell som använde historisk efterfrågan, en förbättring på cirka 22 %. Att lägga till detaljhandels- och driftsvariabler gav bara 0,6979, och eftersläpande makroekonomiska indikatorer gav 0,6978, en vinst på ungefär 0,02 %.
Bygg baslinjen först. En säsongsnaiv eller exponentiellt utjämnad siffra som tar en eftermiddag att ta fram visar om maskininlärningsmodellen förtjänade sin komplexitet. Kör båda på samma undanhållna veckor och behåll vinnaren.
Modellvalet bör följa sortimentets storlek och struktur, inte om metoden är nyare. Den principen sparar mer pengar än någon hyperparametersökning.
Långsamgående artiklar och gles efterfrågan behöver en egen modell
Vissa produkter har ingen efterfrågenivå. De har en efterfrågehändelse. En reservdel som säljs fyra gånger per år, en långsvansvariant i e-handeln, en kombination av butik och artikelnummer som rör sig två enheter i månaden: vanliga säsongsmodeller hanterar dessa dåligt, och orsaken är strukturell.
Nollor och positiv försäljning kommer från två olika processer. Om en försäljning över huvud taget sker är en fråga. Hur stor den blir när den sker är en annan. Croston-liknande metoder skattar dessa var för sig, vilket är varför de fungerar på detaljhandelsdata med många nollor. En benchmark för prognoser i detaljhandeln med intermittent efterfrågan redovisar Croston med WAPE 93,15 % och MASE 0,9852, före de naiva och SARIMAX-alternativ som testades. Läs den WAPE-siffran som ett relativt resultat på en serie full av nollor, inte som ett bra noggrannhetsvärde i absolut mening.
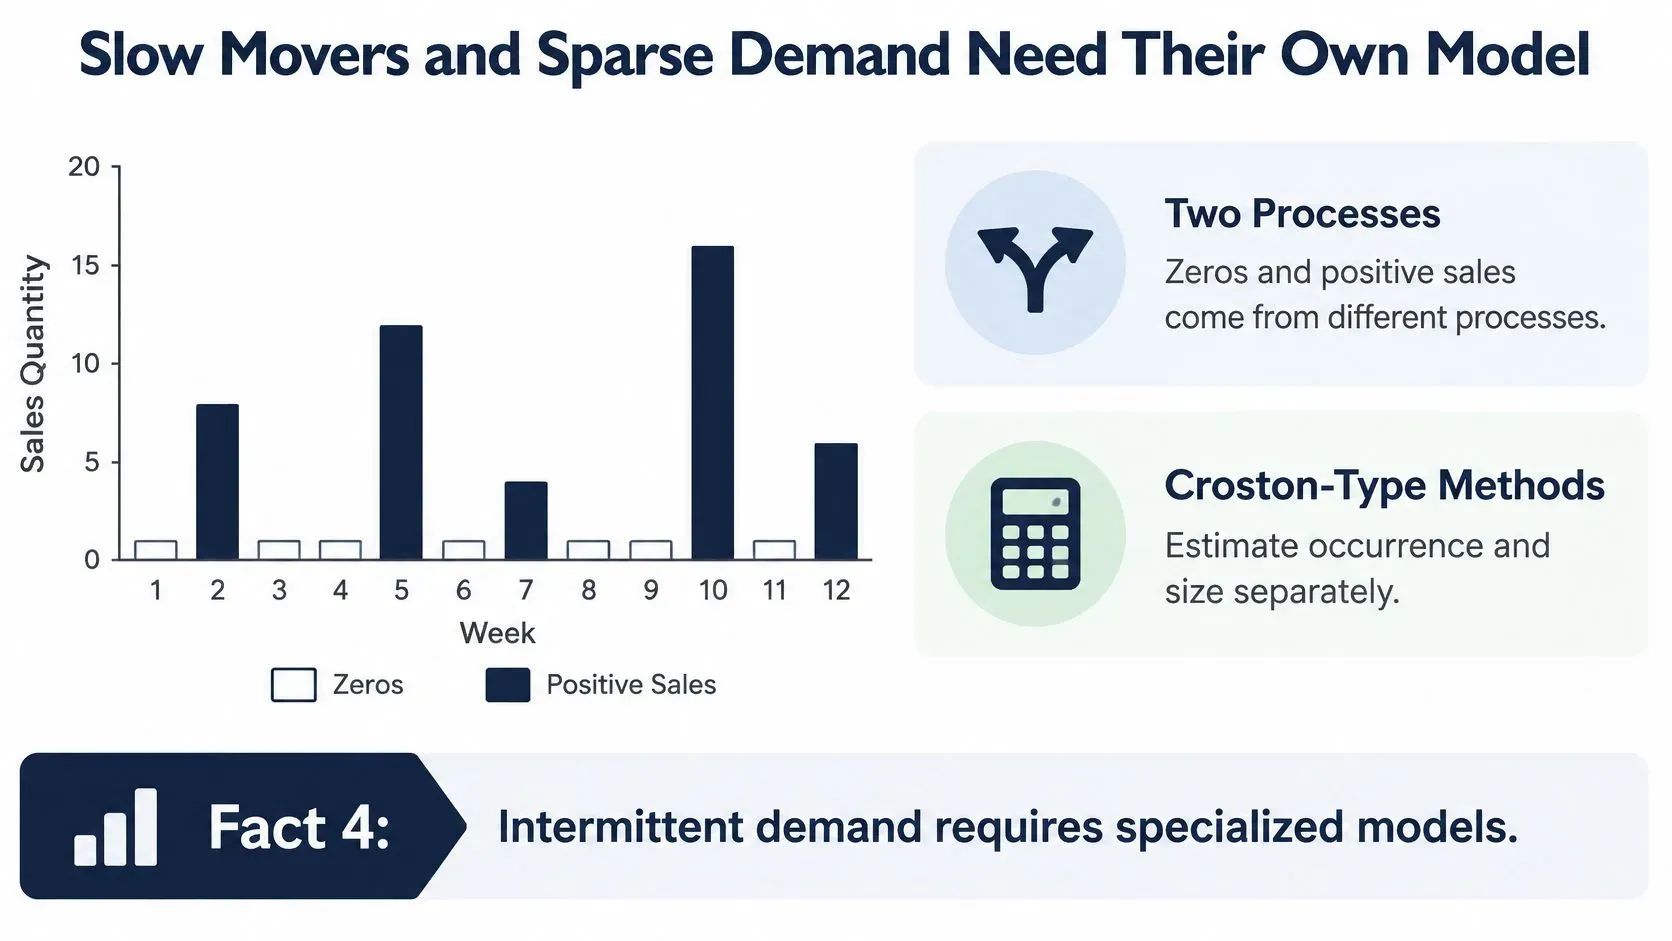
Felet är specifikt och dyrt. En vanlig regressions- eller säsongsmodell ser en följd av nollor och drar slutsatsen att efterfrågan är låg och jämn, så den sätter säkerhetslagret därefter. Den långsamgående artikeln som säljer i oförutsägbara skov blir då slutsåld medan den döda artikeln har tre månaders täckning. Det ena felet kostar en försäljning, det andra kostar kapital och hyllplats.
Det finns en andra lärdom inom samma område. En benchmark på försäljningsdata med intermittent efterfrågan, saknade observationer och ofta förändrat sortiment fann att lokaliserade trädbaserade modeller presterade bäst bland de testade ansatserna, där XGBoost uppnådde det lägsta rapporterade kvadratiska medelfelet (RMSE) på 4,833. Slutsatsen är inte att man ska använda XGBoost överallt. Den är att när produkter byts ut snabbt kan modeller byggda per produktfamilj slå en generell modell som tvingas ta medelvärdet av oförenliga mönster.
Så styr du en serie till rätt modell
- Klassificera innan du modellerar. Beräkna det genomsnittliga efterfrågeintervallet och den kvadrerade variationskoefficienten för efterfrågan som inte är noll för varje serie. Det första är det typiska avståndet i perioder mellan försäljningar; det andra mäter hur mycket storleken på försäljningarna varierar från en försäljning till nästa.
- Styr intermittenta serier till modeller i Croston-familjen, hurdle-modeller eller modeller för förekomst och storlek.
- Skicka stabila artiklar med hög volym till säsongsmodeller eller maskininlärningsmodeller, där de hör hemma.
- Kontrollera klassificeringen varje kvartal. Artiklar flyttar mellan kategorier när de åldras, utgår eller slår igenom, och en styrregel som aldrig körs om försämras.
Spara klassificeringen i en tabell som går att granska. När en kategorichef frågar varför en produkt prognostiseras med en udda metod ska svaret vara två siffror, inte en axelryckning.
Kampanjer, hamstring och kanalskiften
Kampanjveckor är inte vanliga veckor, och att blanda in dem i en baslinje förstör båda. Modellera baslinjeefterfrågan och kampanjeffekter som separata delar och addera dem sedan.
En jämförelse av ansatser för prognoser i detaljhandeln fann att ensembler av beslutsträd presterade bättre än linjär regression, penaliserad linjär regression och regressionsträdmetoder för daglig efterfrågan på kedjenivå när artiklarna hade fler än fem historiska kampanjer. Fem är den användbara gränsen i det resultatet. Under den finns det för få exempel för att en modell ska kunna lära sig hur rabattdjup, kampanjtidpunkt och samspel med produktkalendern påverkar efterfrågan, så starkare regularisering eller en enklare referensmodell gör mindre skada än en flexibel modell som jagar brus.
Ge modellen explicita variabler: kampanjstatus, rabattprocent, displayplacering, närhet till helgdagar och eftersläpande efterfrågan efter kampanjen. Den sista utelämnas ofta, men det är den variabel som fångar dippen.
Dippen som ingen prognostiserar
Säg att en rabatt på 30 % på schampo ökar försäljningen under en vecka, och att försäljningen sedan ligger under trenden i två veckor. Kunderna lade upp lager; de köpte inte mer över kvartalet. Behandla hela treveckorsperioden som en analysenhet. Felet under kampanjperioden visar om du beställde tillräckligt. Felet efter kampanjen visar om du överbeställde för resten av månaden. Poängsätts de var för sig syns båda besluten. Poängsätts de tillsammans tar felen ut varandra, och rapporten ser fin ut trots att du hade fel i båda.
Forskning om kampanjens livscykel konstaterar att tidigare studier ofta förbiser fasen efter kampanjen, då efterfrågan sjunker eftersom kunderna lagrade upp under kampanjen, och rapporterar att maskininlärningsmetoder kan förbättra prognoserna över hela livscykeln, inte bara under själva kampanjen.
Kanalen lägger till ett andra lager av illusion. En studie av flerkanalskampanjer hos en regional brasiliansk stormarknad uppskattade att efterfrågan förflyttades med 11,23 % från fysiska butiker till nätet och 19,34 % i motsatt riktning, medan samordnade kampanjer minskade kannibaliseringen med 30,04 %. Lojalitetsincitament gav den största uppmätta ökningen, 3,5 %. Prognostiserar du varje kanal för sig dubbelräknar du efterfrågan som bara bytt adress.
Låt sedan utvärderingen följa fyra regler:
- Poängsätt kampanjperioder och perioder utan kampanj var för sig, så att en bra vecka inte kan dölja en dålig månad.
- Jämför mot en basnivå med uplift eller en liknande kausal baslinje, annars mäter du bara hur väl modellen lärt sig volym.
- Utvärdera per SKU och per kampanjfrekvens, eftersom gränsen på fem kampanjer förändrar vad du kan förvänta dig.
- Behåll en fördröjd variabel för perioden efter kampanjen så att modellen kan uttrycka nedgången i stället för att överraskas av den.
Om rabatterna äter upp din marginal behandlar vår guide om att skydda marginalerna under rabattkampanjer prissidan av samma problem.
Mät träffsäkerhet och gör om prognoser till beställningar
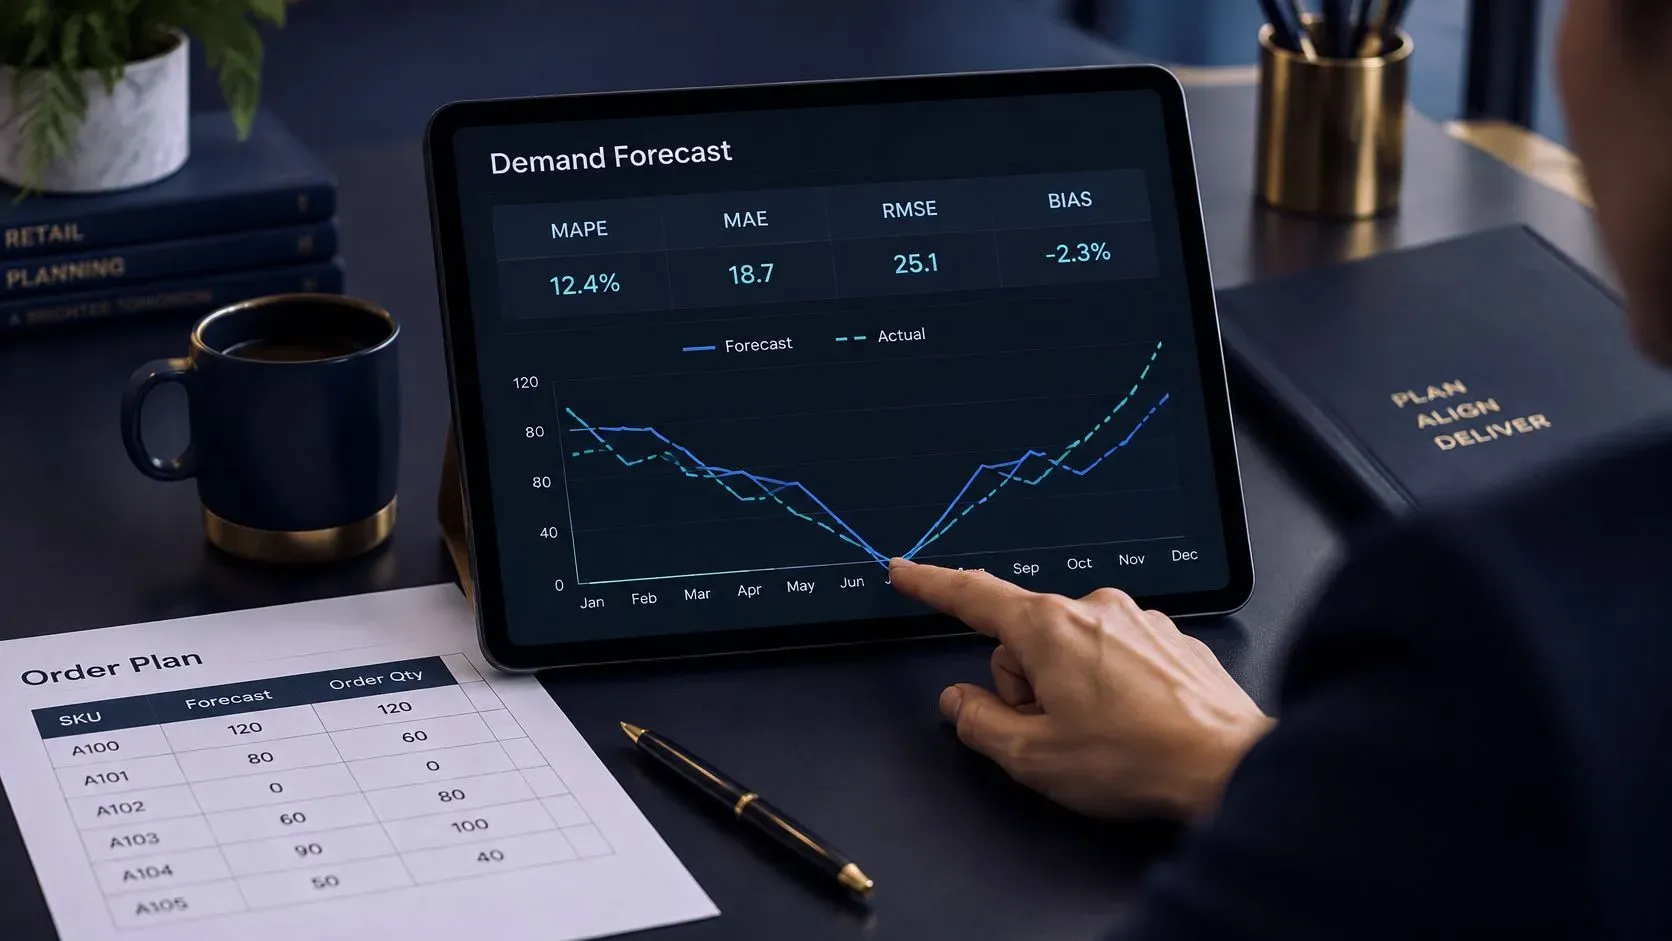
Välj mått först när du har valt beslut. Varje mått besvarar en olika fråga och döljer något olika.
Mått | Använd det när | Se upp med |
|---|---|---|
WAPE (viktat absolut procentfel) | Du jämför träffsäkerhet mellan artiklar av olika storlek | Väger artiklar med hög volym tyngst |
MASE (genomsnittligt absolut skalat fel) | Du jämför modeller på intermittenta serier eller serier med många nollor | Kräver en naiv referens för att tolkas rätt |
MAPE (genomsnittligt absolut procentfel) | Enkel rapportering för stabila artiklar med hög volym | Instabilt eller odefinierat när den faktiska efterfrågan är noll |
Bias | Du vill upptäcka systematiska över- eller underprognoser | Felen kan ta ut varandra och dölja det om du inte läser per period |
Servicenivå | Du kontrollerar om prognosen skyddar tillgängligheten i hyllan | Beror på inställningarna för påfyllning, inte bara på prognosen |
Procentuella fel fungerar dåligt för långsamgående artiklar. När den faktiska efterfrågan är noll blir nämnaren noll, och måttet exploderar eller exkluderas från medelvärdet; båda utfallen smickrar modellen. Redovisa WAPE eller ett skalat fel tillsammans med bias och servicenivå, och läs dem per segment i stället för som ett enda tal för hela sortimentet.
Från ett tal till en beställningspunkt
En prognos blir en beställning genom beräkningar som vem som helst i teamet kan kontrollera. Förväntad efterfrågan under ledtiden, plus ett säkerhetslager dimensionerat efter din målnivå för service, ger beställningspunkten.
Säg att en butik förväntar sig en försäljning på 40 enheter under en leveranstid på fem dagar från leverantören och har en buffert på 10 enheter. Beställningspunkten blir då 50 enheter. När lagersaldot plus inkommande order sjunker till 50 skickas beställningen. Om inköparen beställer vid 40 för att bufferten aldrig avtalades, är hyllan tom redan första dagen lastbilen är sen.
Två rutiner håller detta ärligt. Ställ in undantagslarm som utlöses när prognosfelet för en artikel överskrider din gräns under två eller fler perioder i följd, så att någon tittar på artikeln i stället för på instrumentpanelen. Gör en månatlig bias-kontroll per kategori för att fånga systematisk över- eller underprognostisering som enskilda artikelfel jämnar ut.
En statistiskt träffsäker prognos kan ändå leda till brist om orderTidpunkt, granskningsfrekvens eller säkerhetslager är felkalibrerade. Granska prognosen och påfyllningsreglerna tillsammans, annars fortsätter du att åtgärda fel sak.
Vår ELECTE-guide till lageranalys går djupare in på hur du kopplar lagerpositioner till de siffror som inköpare agerar på.
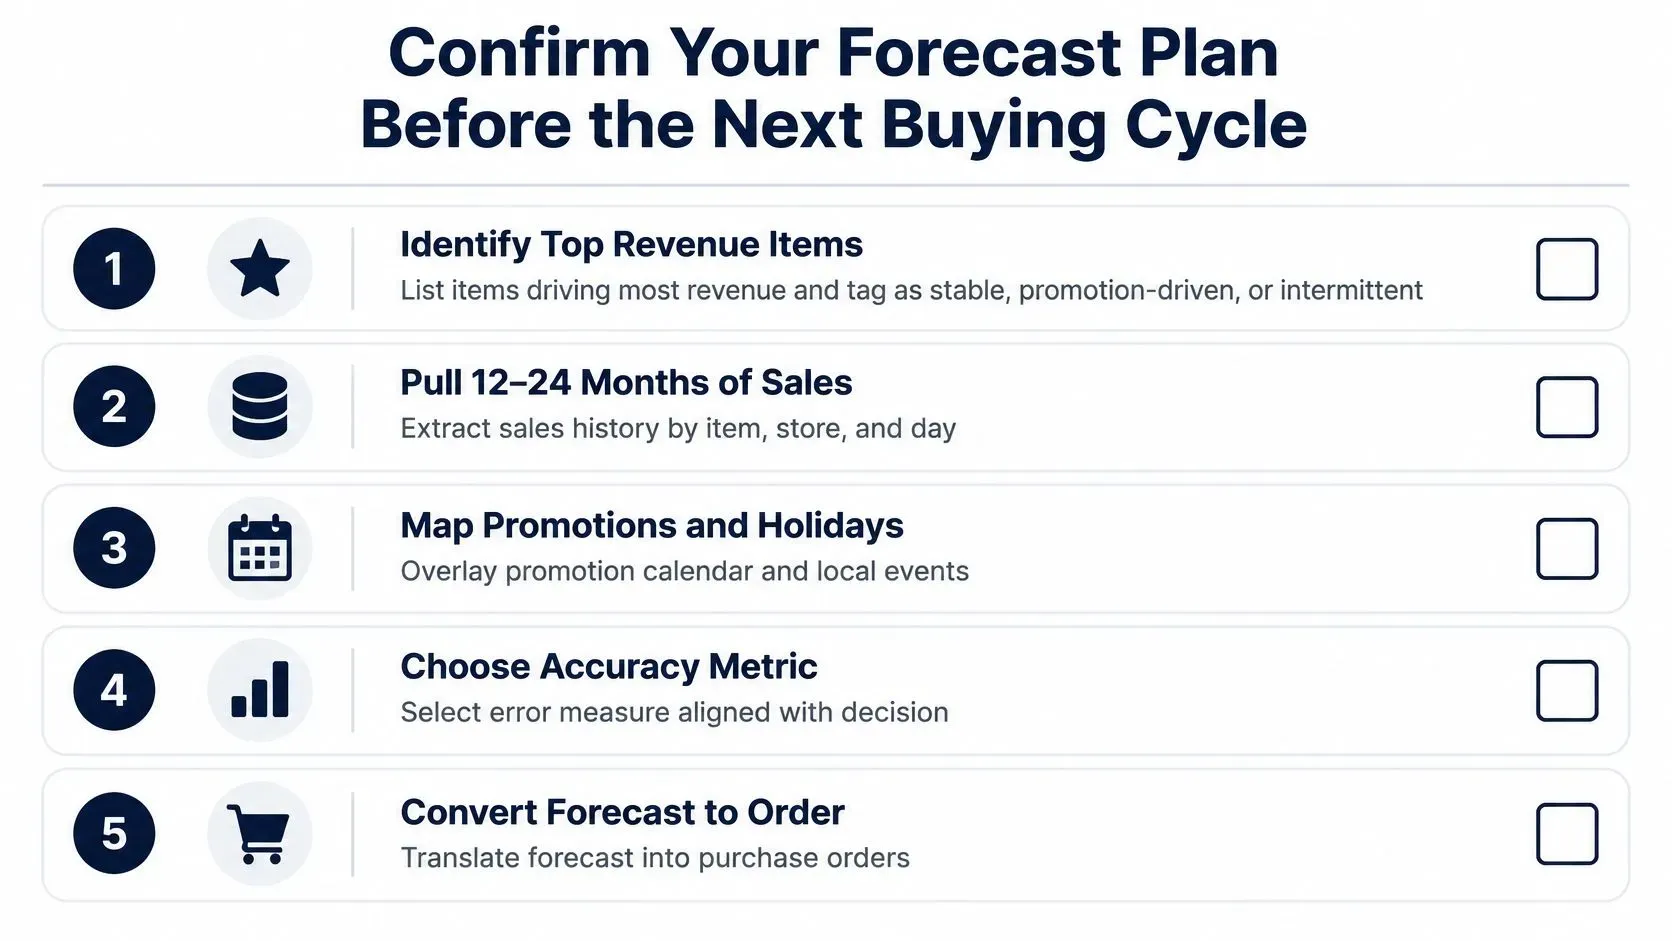
Bekräfta din prognosplan inför nästa inköpsomgång
Innan nästa order läggs bör du bekräfta att prognosprocessen passar de produkter och beslut den ska stödja. Fem kontroller gör planen praktisk:
- Sortera ditt sortiment. Identifiera de artiklar som står för merparten av din omsättning och klassificera dem som stabila, kampanjdrivna eller sporadiska. För resten kan en enklare regel räcka.
- Kontrollera försäljningshistoriken. Hämta 12 till 24 månaders försäljning per artikel, butik och dag, och flagga dagar med slutsålda artiklar. Har du bara 12 månader, använd datan men räkna med större fel.
- Testa mot en baslinje. Sätt en säsongsbaslinje och jämför mer avancerade modeller på veckor som hållits utanför träningen. M5-resultatet ovan visar varför en mer komplex modell måste förtjäna sin plats.
- Fastställ mätrutinen. Välj ett mått för varje beslut och håll sedan dess gränsvärde och granskningsintervall konsekventa mellan omgångarna.
- Granska upprepade missar. Kontrollera beställningspunkterna igen för artiklar med återkommande prognosfel innan du lägger ordern.
ELECTE kör sex prognosmetoder på användarens data, jämför dem med varandra och väljer den mest träffsäkra. Den kostnadsfria kalkylatorn för beställningspunkt hjälper dig att beräkna beställningspunkten för en enskild artikel.
Prognoser minskar risken, men de kan inte ta hänsyn till alla förändringar. En modell kan missa en ny produktlansering eller en kampanj utan jämförbar försäljningshistorik. Behåll en granskningsrutin vid sidan av prognosen så att inköpare kan agera när den faktiska efterfrågan avviker från planen.
ELECTE kopplar ihop försäljnings-, lager- och kampanjdata, jämför sex prognosmetoder på tillgänglig data och visar prognoser, träffsäkerhet och avvikelser i visuella instrumentpaneler som team kan dela. Om du som detaljhandlare vill bedöma efterfrågeprognoser mot din egen försäljningsdata, besök ELECTE.
Kommentarer
Inga kommentarer än — starta konversationen.