Prévision de la demande pour le commerce de détail : méthodes, données et bénéfices
Découvrez comment fonctionne la prévision de la demande dans le commerce de détail, quelles méthodes choisir, quelles données elle exige, et comment réduire les ruptures de stock et les surstocks grâce à de meilleurs plans d'approvisionnement.

On met souvent une rupture de stock sur le dos du fournisseur. Le plus souvent, elle naît plus près de chez soi. Une étude sur les stocks en commerce de détail présentée à la conférence IEOM Society 2025 au Bangladesh indique que 51 % à 73 % des ruptures de stock en supermarché trouvent leur origine au sein même de l'exploitation, les prévisions inexactes (y compris la sous-estimation de la demande) et les erreurs de commande figurant parmi les principales causes.
Ce constat change la manière d'aborder le sujet. La prévision de la demande dans le commerce de détail n'est pas un concours du meilleur algorithme. C'est une discipline opérationnelle : extraire des signaux de demande fiables de données déjà faussées par les ruptures et les promotions, adapter la méthode à la façon dont chaque produit se vend, et relier le résultat à des points de commande qu'un acheteur utilisera dès lundi matin.
Ce guide couvre toute la boucle. Vous verrez ce que la prévision doit produire, quelles données pèsent le plus, comment six méthodes courantes se comparent selon la situation de vente, pourquoi les produits à rotation lente exigent une architecture différente, comment le stockage par les clients et les transferts entre canaux gonflent l'effet apparent des promotions, quelle mesure d'erreur retenir pour quelle décision, et une vérification en cinq étapes à mener avant votre prochain cycle d'achats.
Ce que signifie la prévision de la demande en magasin
Une prévision météo inspire confiance lorsqu'elle est locale et datée : la probabilité de pluie dans votre ville mardi après-midi suffit pour décider de prendre un parapluie. La prévision de la demande remplit le même rôle pour les stocks. Elle estime combien d'unités d'un article précis les clients achèteront dans un magasin précis pendant une semaine précise, afin que l'acheteur commande la bonne quantité plutôt qu'une quantité plausible.
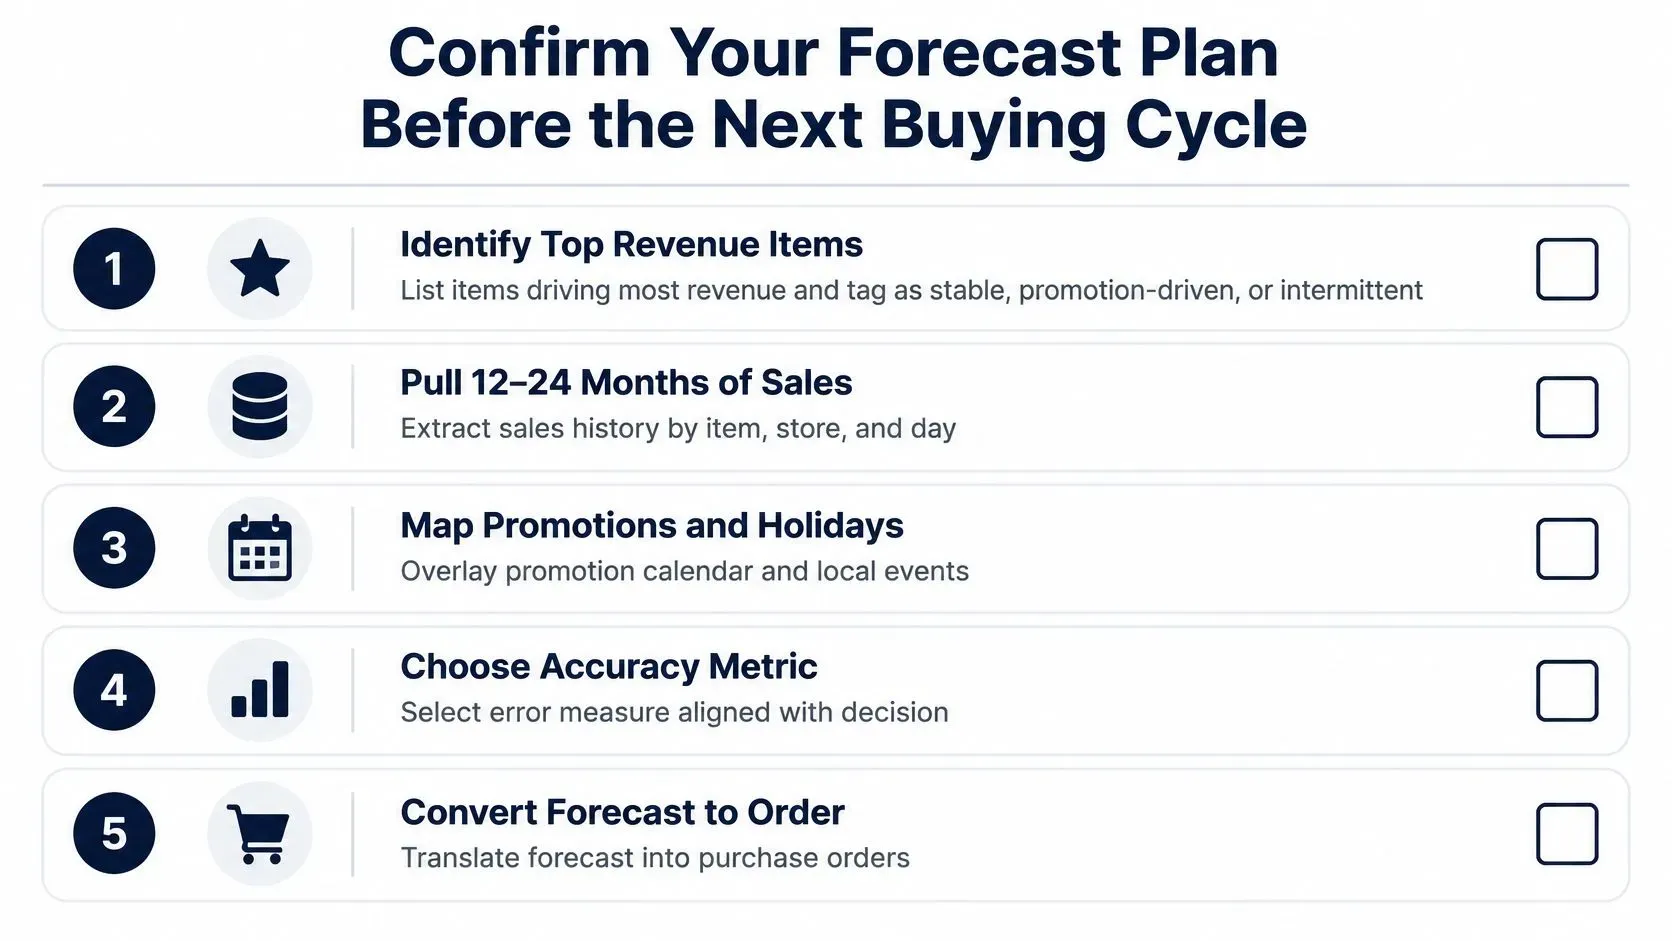
Les cinq étapes ci-dessous résument toute l'idée, de la prévision jusqu'au bon de commande qu'elle doit déclencher.
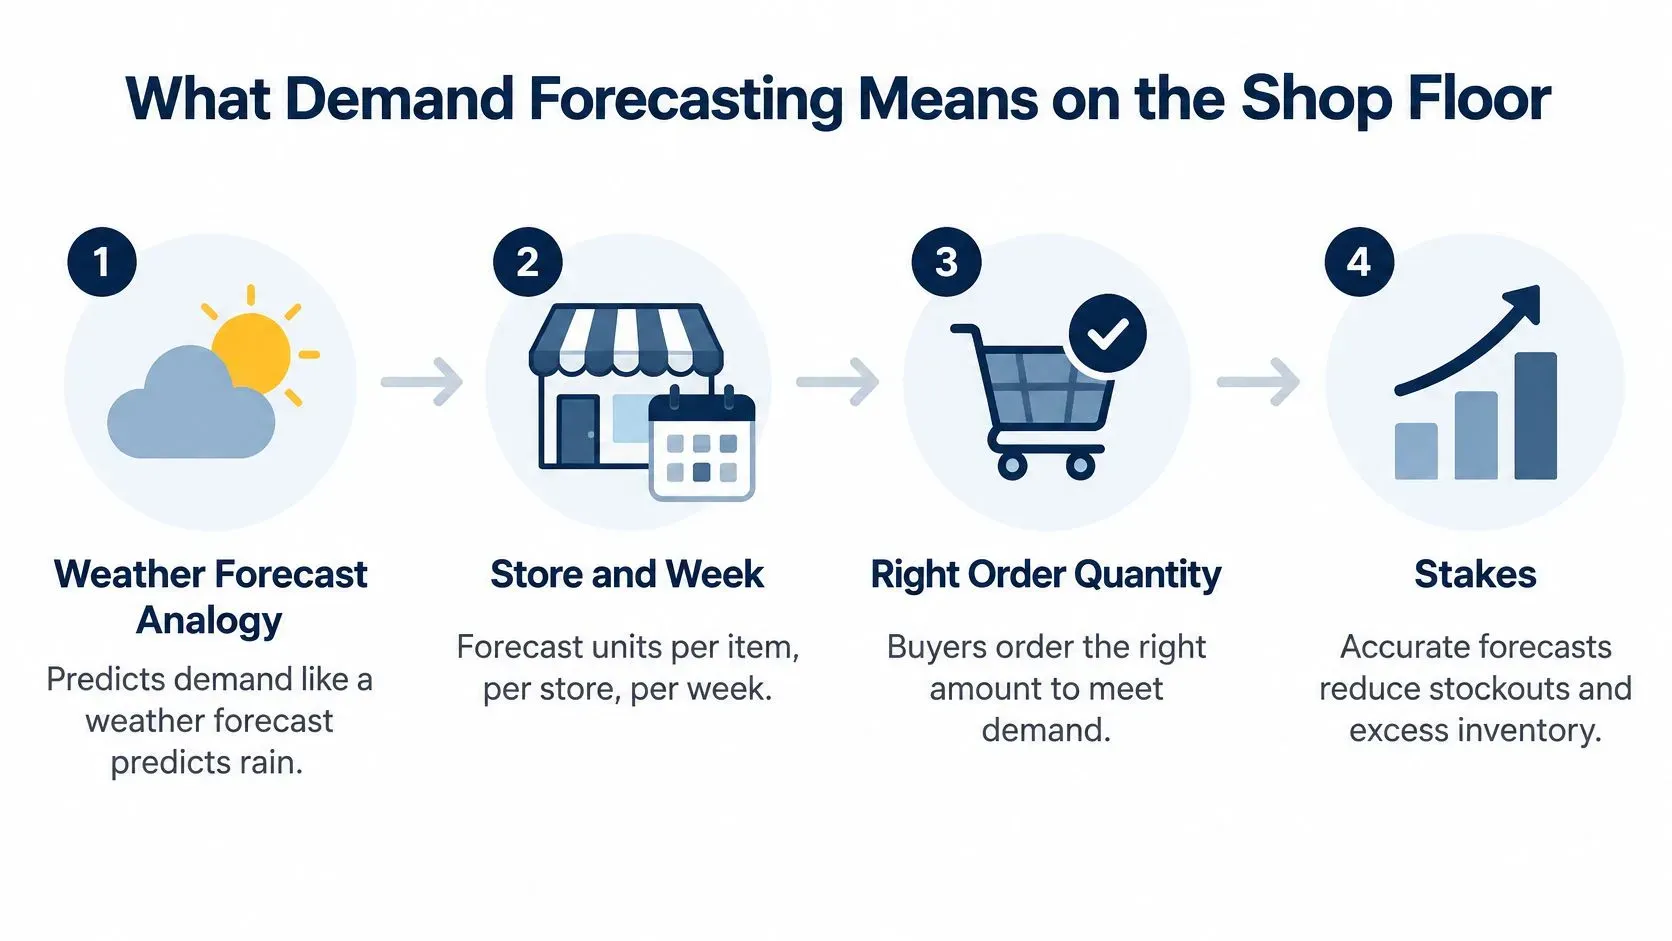
La cible est la demande, pas le total des ventes que la caisse a enregistré. Un zéro enregistré alors que le rayon shampoing était vide est une demande censurée ; un pic promotionnel peut être emprunté aux quinze jours suivants ou détourné d'un magasin voisin. Les moyennes par catégorie et les rapports mensuels masquent ces problèmes propres à chaque article et à chaque magasin : le signal doit donc rester granulaire et être actualisé souvent.
La boucle de travail se présente ainsi :
- Collecter l'historique des ventes et des stocks par article, magasin et jour, y compris les jours où un rayon était vide.
- Nettoyer et aligner les données : une seule unité de mesure, un seul calendrier, aucune ligne en double lorsqu'un système magasin corrige une semaine.
- Ajuster le modèle et prévoir la demande par article et par magasin, à la granularité qu'exige votre décision de commande.
- Traduire la prévision en commandes et en stock de sécurité, en tenant compte des délais d'approvisionnement et du niveau de service promis.
- Mesurer les erreurs et ajuster, article par article, plutôt qu'une fois par an au moment du budget.
Chaque étape protège contre l'un des trois coûts. Sous-prévoyez, et vous perdez des ventes irrécupérables, car le client achète le produit de substitution ou part. Surprévoyez, et de la trésorerie dort dans un stock qu'il faudra démarquer. Si la quantité est à peu près juste mais le calendrier erroné, vous payez des deux côtés : surcoûts de transport sur la commande urgente et stockage du surplus.
La règle qui fait économiser le plus : une prévision ne vaut que si une règle de réapprovisionnement agit dessus. Un chiffre parfait qui dort dans un rapport ne change rien en rayon.
Les données nécessaires et la façon dont les ruptures les faussent
Avant de comparer les modèles, regardez ce qu'on leur fournit. Les données qui améliorent le plus la précision en commerce de détail sont prévisibles et peu glamour, et beaucoup d'équipes en manquent deux ou trois.
- Historique des ventes par article, magasin et jour. Toute granularité plus grossière masque les semaines promotionnelles et les pics du week-end, qui portent le signal.
- Stock disponible et durée des ruptures. Sans eux, impossible de distinguer une semaine calme d'un rayon vide.
- Prix et profondeur des remises. Une remise de 10 % et une remise de 30 % ne produisent pas la même courbe de réponse ; enregistrez donc le prix en rayon réellement payé, pas le prix catalogue.
- Le calendrier promotionnel, y compris l'emplacement des présentoirs et la publicité mise en avant.
- Jours fériés et événements locaux. Une kermesse scolaire à deux rues de là déplace plus d'eau en bouteille qu'un jour férié national.
- La météo, en particulier pour les catégories frais, saisonnières et jardin.
- Les prix des concurrents, partout où vous pouvez les observer de façon régulière.
- Délais fournisseurs et retards de livraison, qui déterminent la couverture nécessaire.
Pourquoi un rayon vide produit un faux zéro
Imaginons que votre shampoing se vende en moyenne à 40 unités par semaine et que le rayon reste vide trois jours. Ces jours-là enregistrent zéro vente. Un modèle entraîné sur cet historique apprend que la demande chute chaque fois que le stock s'épuise, ce qui est l'inverse de la réalité. Les clients qui n'ont rien trouvé n'ont pas changé d'avis ; ils sont allés ailleurs.
Les retards fournisseurs, un réapprovisionnement lent et vos propres choix de commande censurent les ventes exactement de la même manière. Le modèle ne peut pas distinguer une vente perdue d'un désintérêt, et il continuera à sous-commander l'article qui part le plus vite.
Cette défaillance est bien documentée. Une revue de 2026 sur l'apprentissage automatique dans la prévision pour le commerce de détail identifie les jeux de données incomplets, les chaînes de données fragmentées, l'évolution du comportement des clients, les promotions, les réactions des concurrents et la saisonnalité comme causes de modèles biaisés et fragiles. La même revue cite une enquête menée auprès de 661 professionnels des stocks, dans laquelle 51 % ont parfois appliqué des prévisions qu'ils jugeaient déjà peu fiables faute de meilleure option, tandis que les changements de droits de douane et de politique commerciale (19 %) et les variations de l'inflation ou des prix des matières premières (17 %) figuraient parmi les principaux facteurs de perturbation.
La correction en quatre étapes, dans l'ordre
- Signalez chaque jour de rupture de stock dans l'historique des ventes, en indiquant les heures ou les jours pendant lesquels l'article était indisponible.
- Estimez les ventes perdues sur ces jours à partir d'articles comparables du même magasin et de la même semaine.
- Étiquetez chaque période comme disponible ou contrainte avant de lancer tout entraînement.
- Entraînez le modèle sur l'historique corrigé et comparez les résultats sur des semaines mises de côté, jamais sur les semaines que vous avez retouchées.
Pour la plupart des PME, ce travail améliore davantage la précision que de changer d'algorithme. Un modèle ne peut apprendre que ce que contiennent les données ; si elles indiquent que la demande s'est effondrée pendant une rupture de stock, une architecture plus sophistiquée n'apprendra que plus vite la mauvaise leçon. Notre guide ELECTE sur l'intégration multisource décrit l'infrastructure qui permet de réunir les données de ventes, de stock et de promotions dans une seule table exploitable.
Comparaison des méthodes de prévision selon la situation du commerce
Il n'existe pas de meilleure méthode, seulement une méthode adaptée à chaque situation. Le tableau ci-dessous est la comparaison que j'aimerais voir affichée au-dessus d'un bureau de planification.
Méthode | Situation commerciale idéale | Données nécessaires | Point fort | Point de vigilance |
|---|---|---|---|---|
Moyenne mobile ou lissage exponentiel | Articles stables à fort volume | 1 à 2 ans de ventes hebdomadaires | Simple, peu coûteuse et facile à expliquer | Ne voit pas les promotions ni les variations saisonnières |
Modèles saisonniers tels que SARIMA | Articles avec des cycles hebdomadaires ou annuels marqués | Historique d'au moins deux saisons | Capte la tendance et la saisonnalité | Peine à traiter des milliers de séries à la fois |
Méthodes de la famille Croston | Références à demande intermittente et à rotation lente | Historique de ventes avec de nombreuses périodes à zéro | Distingue la fréquence des ventes de leur volume | Mauvais choix pour les articles qui se vendent régulièrement |
Régression avec variables de promotion et de prix | Catégories portées par les promotions | Calendrier promotionnel et historique des prix | Montre comment chaque facteur fait évoluer la demande | Perd en fiabilité quand les promotions sont rares |
Ensembles d'arbres tels que XGBoost ou LightGBM | Larges portefeuilles article-magasin | Ventes, calendrier, promotions et prix | Apprend à partir de nombreuses séries liées | Exige des données propres et un suivi continu |
Ensembles hybrides LSTM-XGBoost | Enseignes multi-catégories disposant de signaux riches | 36 mois de données de point de vente et de promotions | A réduit l'erreur absolue moyenne en pourcentage de 28,6 % en moyenne à un horizon de quatre semaines dans une étude portant sur 14 organisations de distribution | Plus lourd à construire et à expliquer |
Le schéma qui se dégage de l'ensemble des lignes compte plus que chaque ligne prise isolément. Une revue académique à comité de lecture sur la recherche en prévision pour le commerce de détail indique que les modèles de machine learning globaux, notamment les réseaux de neurones feed-forward et récurrents, les arbres de régression à gradient boosté et les forêts aléatoires, surpassent souvent des modèles de séries temporelles et de régression distincts lorsque les distributeurs prévoient de vastes ensembles de séries de ventes. L'avantage augmente avec la taille du portefeuille : des milliers de combinaisons article-magasin où la demande de chaque produit est rare, intermittente, saisonnière ou sensible aux promotions.
À quoi ressemble la comparaison dans une vraie enseigne
Prenons une enseigne régionale de 40 magasins. Les articles de base, aux ventes hebdomadaires régulières, reçoivent un lissage exponentiel, car un responsable de catégorie peut lire le chiffre et le discuter. L'habillement saisonnier, avec huit promotions par an, reçoit un modèle à gradient boosté entraîné sur tous les magasins à la fois, car l'historique d'un seul magasin est trop mince pour en tirer une courbe de réponse à la remise.
La revue est tout aussi claire sur un point : les méthodes plus anciennes ne sont pas obsolètes. Leurs performances restent compétitives sur de petits jeux de données, pour des produits stables, et dans les situations où l'interprétabilité et la rareté des données comptent plus que le dernier point de précision.
La retenue paie. Une évaluation de 2026 sur la demande du commerce de détail américain avec le jeu de données M5, portant sur 25 940 séries article-magasin et cinq fenêtres glissantes de 28 jours, a fait passer l'erreur absolue moyenne pondérée en pourcentage de 0,9006 pour une référence saisonnière naïve à 0,7022 avec un modèle LightGBM utilisant la demande historique, soit une amélioration d'environ 22 %. L'ajout de variables commerciales et opérationnelles n'a atteint que 0,6979, et celui d'indicateurs macroéconomiques décalés 0,6978, soit un gain d'environ 0,02 %.
Construisez d'abord la référence. Un chiffre saisonnier naïf ou de lissage exponentiel, produit en une après-midi, vous dit si le modèle de machine learning a mérité sa complexité. Lancez les deux sur les mêmes semaines de test et gardez le meilleur.
Le choix du modèle doit suivre l'échelle et la structure du portefeuille, non la nouveauté de la méthode. Ce seul principe vous fera économiser plus qu'une recherche d'hyperparamètres.
Les articles à rotation lente et la demande éparse ont besoin de leur propre modèle
Certains produits n'ont pas de niveau de demande. Ils ont des événements de demande. Une pièce détachée vendue quatre fois par an, une variante e-commerce de longue traîne, une combinaison magasin-SKU qui écoule deux unités par mois : les modèles saisonniers standard les traitent mal, pour une raison structurelle.
Les zéros et les ventes positives proviennent de deux processus différents. Savoir si une vente a lieu est une question. Savoir quelle est son ampleur quand elle a lieu en est une autre. Les méthodes de type Croston estiment ces deux éléments séparément, ce qui explique leur bonne tenue sur des données de distribution pleines de zéros. Un benchmark de prévision retail sur la demande intermittente rapporte pour Croston un WAPE de 93,15 % et un MASE de 0,9852, devant les alternatives naïve et SARIMAX testées. Lisez ce WAPE comme un résultat relatif sur une série pleine de zéros, non comme un bon score de précision en valeur absolue.
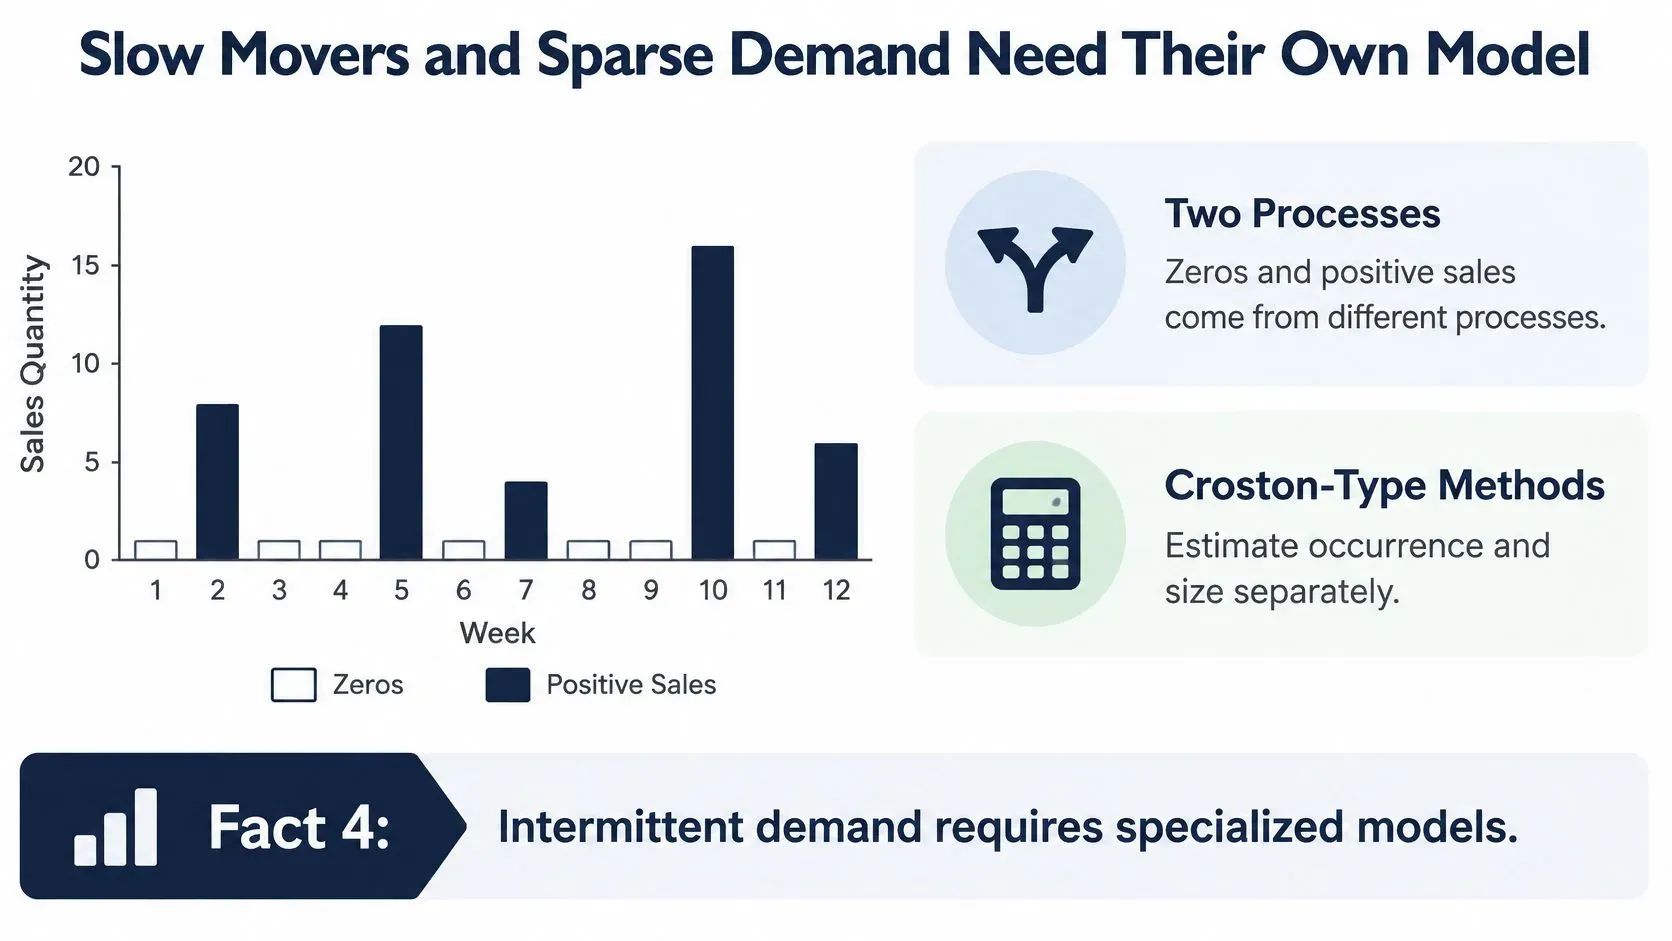
Le mode de défaillance est précis et coûteux. Une régression ou un modèle saisonnier standard voit une suite de zéros et conclut que la demande est faible et stable ; il fixe donc le stock de sécurité en conséquence. L'article à rotation lente, qui se vend par à-coups imprévisibles, tombe alors en rupture pendant que l'article mort immobilise trois mois de couverture. Une erreur coûte une vente, l'autre coûte de la trésorerie et de l'espace en rayon.
Le même terrain offre une deuxième leçon. Un benchmark sur des données de ventes avec demande intermittente, observations manquantes et renouvellement fréquent de l'assortiment a constaté que les modèles à base d'arbres localisés donnaient les meilleurs résultats parmi les approches testées, XGBoost obtenant la plus faible racine de l'erreur quadratique moyenne rapportée, 4,833. Le message n'est pas « utilisez XGBoost partout ». C'est que, lorsque les produits tournent vite, des modèles construits par famille de produits peuvent battre un modèle généraliste obligé de faire la moyenne de comportements incompatibles.
Comment aiguiller une série
- Classez avant de modéliser. Calculez l'intervalle moyen entre demandes et le coefficient de variation au carré de la demande non nulle pour chaque série. Le premier est l'écart typique, en périodes, entre deux ventes ; le second mesure à quel point la taille des ventes varie d'une vente à l'autre.
- Aiguillez les séries intermittentes vers des modèles de la famille Croston, des modèles hurdle ou des modèles occurrence-taille.
- Envoyez les articles stables à fort volume vers des modèles saisonniers ou de machine learning, là où ils ont leur place.
- Revérifiez la classification chaque trimestre. Les articles changent de catégorie en vieillissant, en étant arrêtés ou en décollant, et une règle d'aiguillage jamais relancée se dégrade.
Conservez la classification dans une table consultable. Quand un responsable de catégorie demande pourquoi un produit est prévu avec une méthode inhabituelle, la réponse doit tenir en deux chiffres, pas en un haussement d'épaules.
Promotions, stockage et bascules de canal
Les semaines promotionnelles ne sont pas des semaines ordinaires, et les fondre dans une référence corrompt les deux. Modélisez la demande de base et les effets promotionnels comme deux choses distinctes, puis additionnez-les.
Une comparaison d'approches de prévision pour le commerce de détail a constaté que les ensembles d'arbres de décision surpassaient la régression linéaire, la régression linéaire pénalisée et les méthodes d'arbres de régression pour la demande quotidienne au niveau de l'enseigne lorsque les SKU comptaient plus de cinq promotions historiques. Cinq est le seuil utile dans ce résultat. En dessous, il n'y a pas assez d'exemples pour qu'un modèle apprenne comment la profondeur de la remise, le calendrier de la promotion et les interactions avec le calendrier produit font bouger la demande ; une régularisation plus forte ou une référence plus simple fait alors moins de dégâts qu'un modèle flexible qui court après le bruit.
Donnez au modèle des variables explicites : statut promotionnel, pourcentage de remise, emplacement en rayon, proximité des jours fériés et demande post-promotion décalée. Cette dernière est souvent omise, alors que c'est elle qui capte le creux.
Le creux que personne ne prévoit
Imaginons une remise de 30 % sur les shampooings : les ventes progressent pendant une semaine, puis restent sous la tendance pendant deux semaines. Les clients ont fait des stocks ; ils n'ont pas acheté plus sur le trimestre. Traitez la fenêtre complète de trois semaines comme une seule unité d'analyse. L'erreur sur la période promotionnelle indique si vous avez commandé assez. L'erreur après la promotion indique si vous avez trop commandé pour le reste du mois. Mesurées séparément, les deux décisions apparaissent. Mesurées ensemble, les deux erreurs s'annulent : le rapport paraît propre alors que vous vous êtes trompé deux fois.
Les recherches sur le cycle de vie promotionnel notent que les travaux antérieurs négligent souvent la phase post-promotionnelle, où la demande chute parce que les clients ont constitué des stocks pendant l'opération, et indiquent que les méthodes d'apprentissage automatique peuvent améliorer les prévisions sur l'ensemble du cycle de vie, et pas seulement pendant la promotion elle-même.
Le canal ajoute une deuxième couche d'illusion. Une étude des promotions multicanales dans un supermarché régional brésilien a estimé le déplacement de la demande à 11,23 % des magasins physiques vers le web et à 19,34 % dans le sens inverse, tandis que les promotions coordonnées ont réduit la cannibalisation de 30,04 %. Les incitations de fidélité ont produit la plus forte hausse mesurée, à 3,5 %. Si vous prévoyez chaque canal indépendamment, vous compterez deux fois une demande qui a simplement changé d'adresse.
Appliquez ensuite quatre règles d'évaluation :
- Mesurez séparément les périodes promotionnelles et non promotionnelles, pour qu'une bonne semaine ne masque pas un mauvais mois.
- Comparez à une base de référence de type base-lift ou à un modèle causal similaire, sinon vous mesurez seulement la capacité du modèle à apprendre le volume.
- Évaluez par référence (SKU) et par fréquence de promotion, car le seuil de cinq promotions change ce que vous pouvez attendre.
- Conservez une variable décalée de l'après-promotion pour que le modèle puisse exprimer le creux au lieu d'être pris au dépourvu.
Si les remises rongent votre marge, notre guide pour protéger les marges pendant les campagnes de remises traite le volet tarifaire du même problème.
Mesurer la précision et transformer les prévisions en commandes
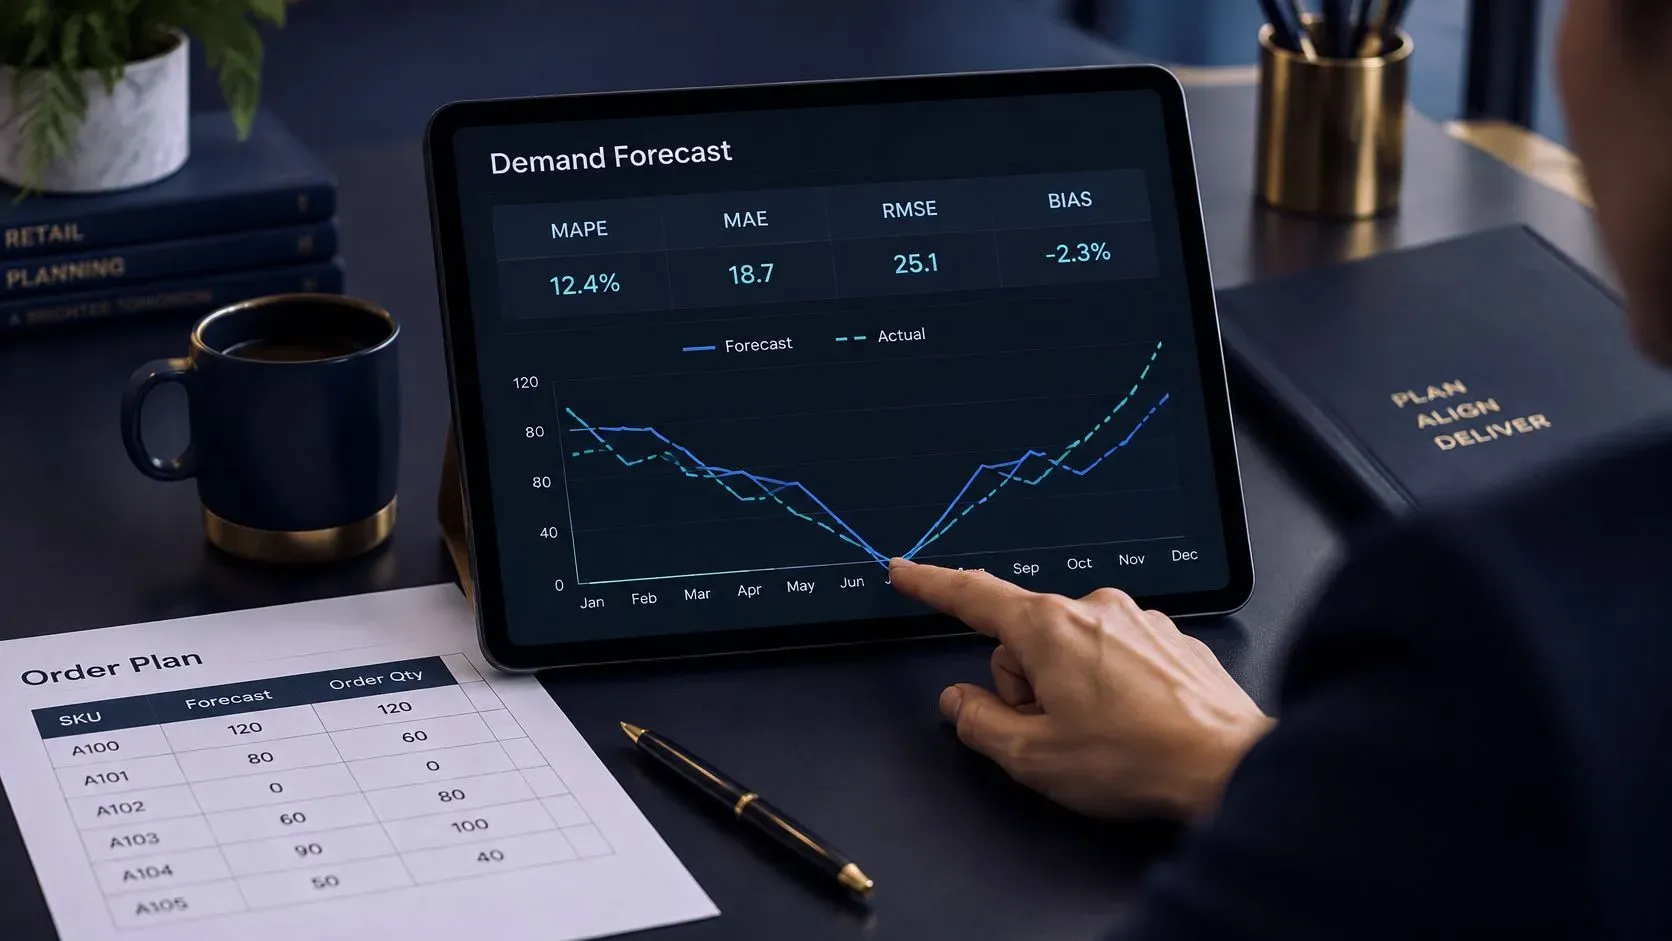
Choisissez la métrique après avoir choisi la décision. Chaque mesure répond à une question différente et cache autre chose.
Métrique | À utiliser quand | Points de vigilance |
|---|---|---|
WAPE (erreur absolue pondérée en pourcentage) | Comparer la précision d'articles de tailles différentes | Donne le plus de poids aux articles à fort volume |
MASE (erreur absolue moyenne mise à l'échelle) | Comparer des modèles sur des séries intermittentes ou avec beaucoup de zéros | Nécessite une référence naïve pour être bien interprétée |
MAPE (erreur absolue moyenne en pourcentage) | Reporting simple sur des articles stables à fort volume | Instable, voire indéfinie, quand la demande réelle est nulle |
Biais | Repérer une sur- ou sous-prévision systématique | Des erreurs qui se compensent peuvent le masquer s'il n'est pas lu par période |
Niveau de service | Vérifier si la prévision protège la disponibilité en rayon | Dépend des paramètres de réapprovisionnement, pas seulement de la prévision |
Les erreurs en pourcentage ne fonctionnent pas sur les articles à faible rotation. Quand la demande réelle est nulle, le dénominateur est nul et la métrique explose ou est exclue de la moyenne, deux cas qui flattent le modèle. Présentez le WAPE ou une erreur mise à l'échelle avec le biais et le niveau de service, et lisez-les par segment plutôt que comme un chiffre unique pour tout le catalogue.
D'un chiffre à un point de commande
Une prévision devient une commande grâce à un calcul que toute l'équipe peut vérifier. La demande attendue pendant le délai d'approvisionnement, plus un stock de sécurité dimensionné selon votre niveau de service cible, donne le point de commande.
Imaginons qu'un magasin prévoie 40 unités sur un délai d'approvisionnement fournisseur de cinq jours et conserve un stock tampon de 10 unités. Le point de commande est donc de 50 unités. Lorsque le stock disponible plus les commandes en cours tombe à 50, la commande part. Si l'acheteur commande à 40 parce que le stock tampon n'a jamais été validé, le rayon se vide dès le premier jour où le camion a du retard.
Deux routines permettent de garder ce processus fiable. Configurez des alertes d'exception lorsque l'erreur de prévision d'un article dépasse votre seuil pendant au moins deux périodes consécutives : quelqu'un examine alors l'article, et pas seulement le tableau de bord. Réalisez chaque mois un contrôle du biais par catégorie pour repérer les sur- ou sous-estimations systématiques que les erreurs individuelles par article masquent en se compensant.
Une prévision statistiquement exacte peut tout de même provoquer des ruptures si le moment des commandes, la fréquence de révision ou le stock de sécurité sont mal calibrés. Examinez ensemble la prévision et les règles de réapprovisionnement, sinon vous continuerez à corriger le mauvais élément.
Notre guide ELECTE d'analyse des données de stock détaille comment relier les niveaux de stock aux chiffres sur lesquels les acheteurs s'appuient pour décider.
Validez votre plan de prévision avant le prochain cycle d'achat
Avant de passer la prochaine commande, vérifiez que le processus de prévision correspond aux produits et aux décisions qu'il doit soutenir. Cinq contrôles rendent le plan concret :
- Triez votre assortiment. Identifiez les articles qui génèrent l'essentiel de votre chiffre d'affaires, puis classez-les en stables, tirés par les promotions ou intermittents. Pour les autres, une règle plus simple peut suffire.
- Vérifiez l'historique des ventes. Extrayez 12 à 24 mois de ventes par article, magasin et jour, et signalez les jours de rupture. Avec seulement 12 mois disponibles, utilisez les données, mais attendez-vous à une erreur plus large.
- Testez face à une référence. Définissez une référence saisonnière et comparez des modèles plus riches sur des semaines mises de côté. Le résultat M5 ci-dessus montre pourquoi un modèle plus complexe doit prouver son utilité.
- Mettez en place la routine de mesure. Choisissez une métrique pour chaque décision, puis gardez son seuil et sa cadence de revue constants d'un cycle à l'autre.
- Analysez les écarts répétés. Revérifiez les points de commande des articles dont les erreurs de prévision reviennent, avant de passer la commande.
ELECTE exécute six méthodes de prévision sur les données de l'utilisateur, les compare entre elles et retient la plus précise. Son calculateur gratuit de point de commande aide à calculer le point de commande d'un article donné.
Les prévisions réduisent le risque, mais elles ne peuvent pas tenir compte de tous les changements. Un modèle peut passer à côté du lancement d'un nouveau produit ou d'une promotion sans historique de ventes comparable. Gardez une routine de revue en complément de la prévision afin que les acheteurs puissent réagir lorsque la demande réelle s'écarte du plan.
ELECTE relie les données de ventes, de stock et de promotions, compare six méthodes de prévision sur les données disponibles, et présente prévisions, précision et exceptions dans des tableaux de bord visuels que les équipes peuvent partager. Si vous évaluez des prévisions de demande à partir de vos propres données de ventes, rendez-vous sur ELECTE.
Commentaires
Aucun commentaire pour l'instant — lancez la conversation.