Прогнозування попиту в роздрібній торгівлі: методи, дані та переваги
Дізнайтеся, як працює прогнозування попиту в роздрібній торгівлі, які методи обрати, які дані потрібні та як скоротити дефіцит і надлишки запасів за допомогою точніших планів.

Дефіцит товару зазвичай списують на постачальника. Найчастіше ж причина ближча. Дослідження роздрібних запасів, представлене на конференції IEOM Society 2025 року в Бангладеш, показує, що від 51% до 73% випадків дефіциту в супермаркетах виникають усередині самої роздрібної операції, а серед головних причин — неточне прогнозування (зокрема занижена оцінка попиту) та помилки в замовленнях.
Цей висновок змінює підхід до роботи. Прогнозування попиту в роздрібній торгівлі — це не змагання за найсучасніший алгоритм. Це операційна дисципліна: витягти достовірні сигнали попиту з даних, які вже спотворили дефіцит і промоакції, підібрати метод під те, як продається кожен товар, і вбудувати результат у точки перезамовлення, якими байєр користуватиметься в понеділок зранку.
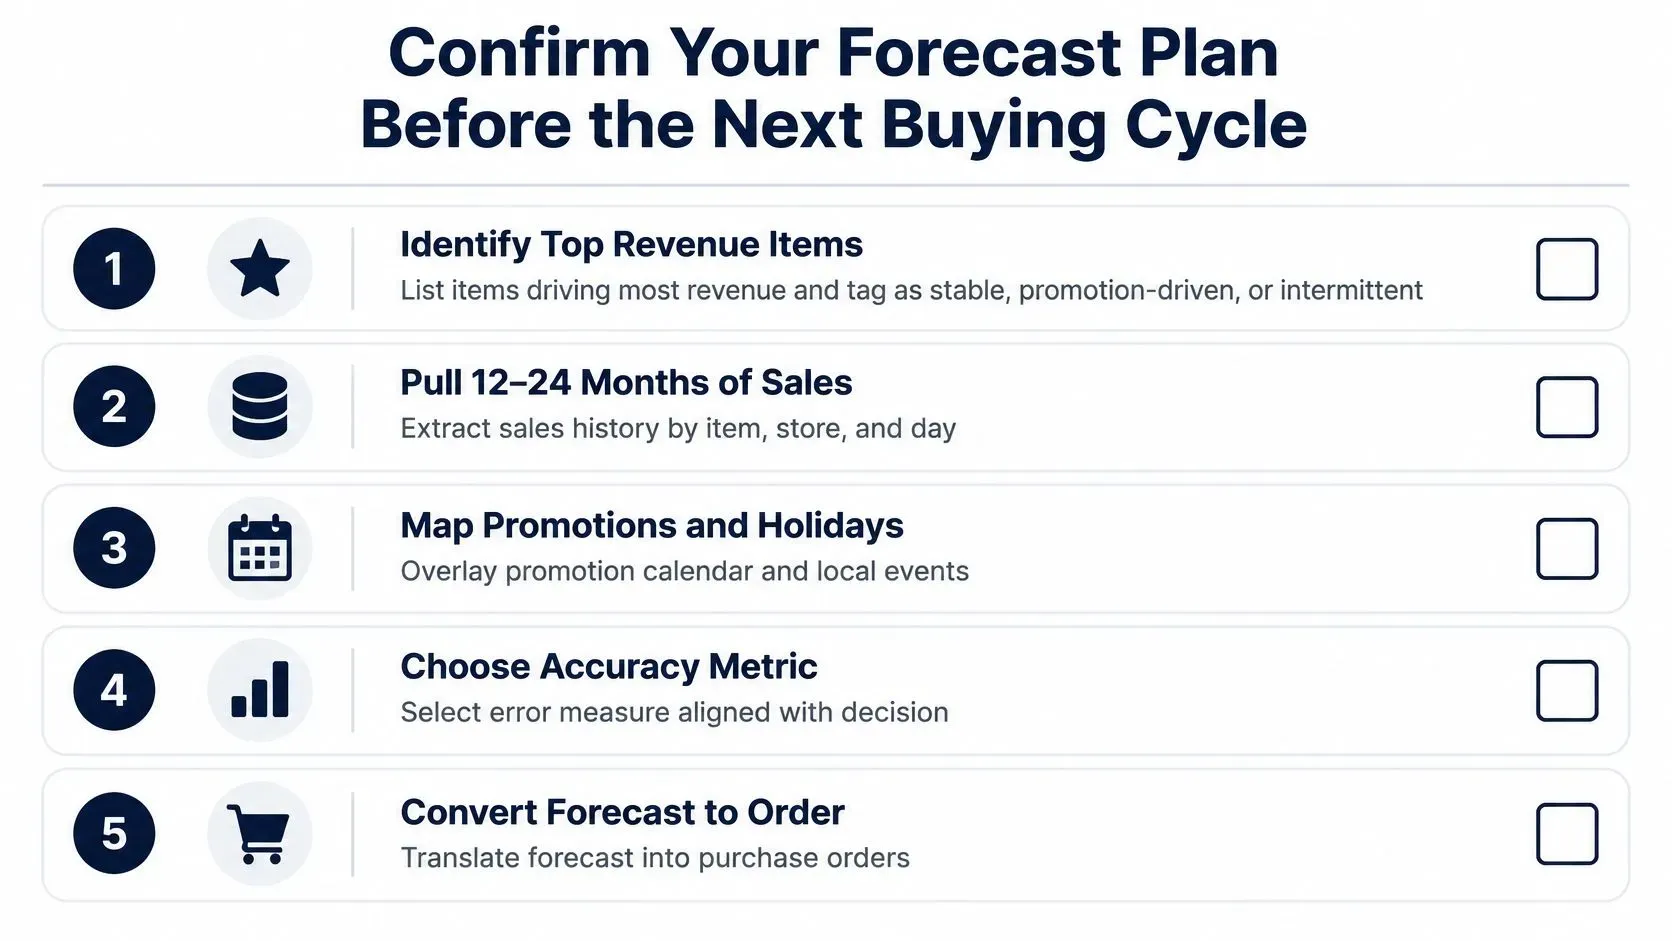
Цей посібник охоплює весь цикл. Ви побачите, що має давати прогноз, які вхідні дані мають найбільшу вагу, як шість поширених методів порівнюються за роздрібними сценаріями, чому товарам із повільним оборотом потрібна інша архітектура, як ажіотажні закупівлі та зміна каналів завищують видимий ефект промоакцій, якій метриці похибки довіряти для яких рішень, а також п'ятикроковий чек-лист для перевірки перед наступним циклом закупівель.
Що таке прогнозування попиту в торговому залі
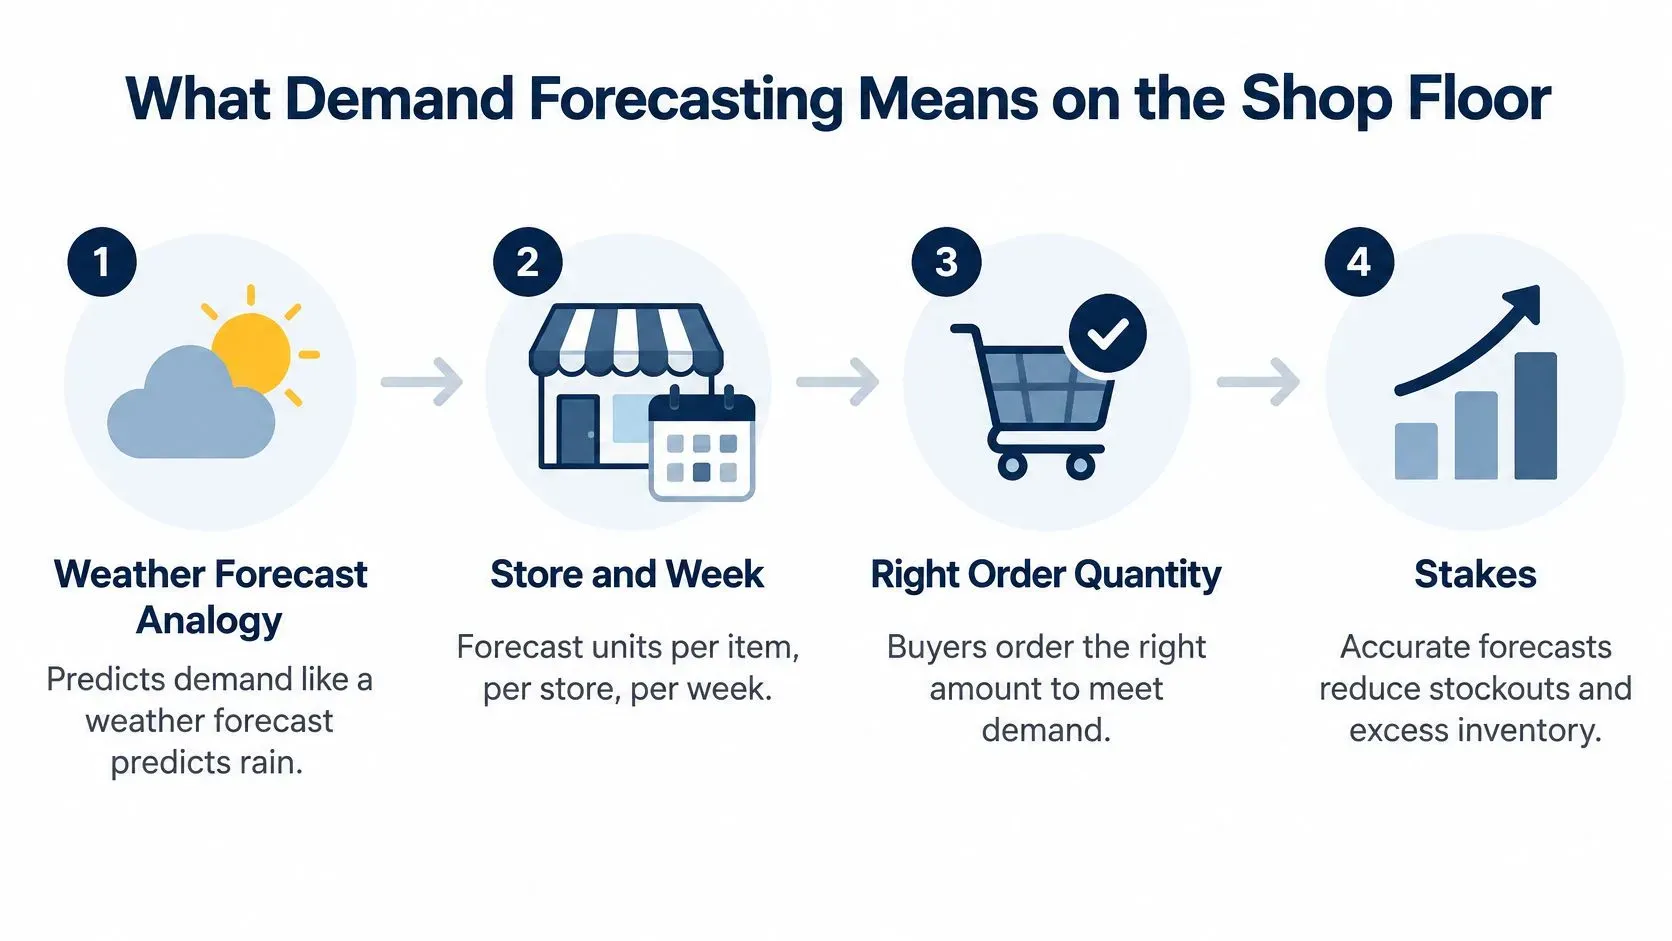
Прогнозу погоди довіряють, коли він локальний і прив'язаний до часу: ймовірності дощу у вашому місті у вівторок по обіді достатньо, щоб вирішити, чи брати парасольку. Прогнозування попиту виконує те саме завдання для запасів. Воно оцінює, скільки одиниць конкретного товару покупці придбають у конкретному магазині протягом конкретного тижня, щоб байєр замовляв потрібну кількість, а не просто правдоподібну.
П'ять кроків нижче — вся ідея в мініатюрі: від прогнозу до замовлення постачальнику, яке він має ініціювати.
Мета — попит, а не обсяг продажів, який випадково зафіксувала каса. Нуль, записаний тоді, коли полиця із шампунем була порожньою, — це цензурований попит; сплеск під час промоакції може бути «позичений» у наступних двох тижнів або відтягнутий із сусіднього магазину. Середні показники по категоріях і місячні звіти приховують ці проблеми на рівні товару й магазину, тому сигнал має залишатися деталізованим і часто оновлюватися.
Робочий цикл виглядає так:
- Зберіть історію продажів і запасів за товаром, магазином і днем, включно з днями, коли полиця була порожньою.
- Очистіть і узгодьте її: одна одиниця виміру, один календар, жодних дубльованих рядків, коли система магазину перераховує тиждень.
- Побудуйте модель і спрогнозуйте попит по кожній парі «товар — магазин» з тією деталізацією, якої потребує рішення про замовлення.
- Перетворіть прогноз на замовлення й страховий запас, враховуючи терміни поставки та обіцяний рівень сервісу.
- Вимірюйте похибки та коригуйте по кожному товару окремо, а не раз на рік під час складання бюджету.
Кожен крок захищає від однієї з трьох втрат. Занизили прогноз — і ви втрачаєте продажі, які не повернути: покупець бере замінник або йде. Завищили — гроші замерзають у запасах, які доведеться уцінювати. Якщо кількість приблизно правильна, а час неправильний, ви платите двічі: надбавками за термінове перевезення замовлення та витратами на зберігання надлишку.
Правило, яке заощаджує найбільше: прогноз виправдовує себе лише тоді, коли на його основі діє правило поповнення запасів. Ідеальна цифра у звіті нічого не змінює на полиці.
Вхідні дані та чому дефіцит їх спотворює
Перш ніж порівнювати моделі, подивіться, що в них закладається. Вхідні дані, які найбільше підвищують точність у рітейлі, передбачувані й буденні, але в багатьох команд бракує двох-трьох із них.
- Історія продажів за товаром, магазином і днем. Грубіша деталізація приховує тижні акцій і пікові вихідні, в яких міститься сигнал.
- Поточні залишки та тривалість дефіциту. Без них не відрізнити спокійний тиждень від порожньої полиці.
- Ціни та глибина знижок. Знижки 10% і 30% дають різну криву відгуку, тому зберігайте ціну на полиці, яку платить покупець, а не прайсову.
- Календар акцій, зокрема розміщення викладки та рекламну підтримку.
- Свята та місцеві події. Шкільний ярмарок за дві вулиці збільшує продажі питної води більше, ніж державне свято.
- Погода, особливо для свіжих, сезонних і садових категорій.
- Ціни конкурентів, якщо їх можна відстежувати стабільно.
- Терміни поставки та затримки постачальників, що визначають, який запас вам потрібен.
Чому порожня полиця записує хибний нуль
Припустімо, ваш шампунь продається в середньому по 40 одиниць на тиждень, а полиця три дні стоїть порожня. Ці дні фіксують нульові продажі. Модель, навчена на такій історії, робить висновок, що попит падає щоразу, коли закінчуються запаси, — а це протилежне правді. Покупці, які нічого не знайшли, не передумали: вони пішли в інше місце.
Постачальницькі затримки, повільне поповнення та ваші власні рішення щодо замовлень так само спотворюють продажі. Модель не відрізняє втрачений продаж від втраченого інтересу й далі недозамовлятиме товар, який розпродається найшвидше.
Ця проблема добре задокументована. Огляд 2026 року про машинне навчання в прогнозуванні для рітейлу називає причинами упереджених і нестійких моделей неповні набори даних, фрагментовані потоки даних, зміни поведінки клієнтів, акції, реакції конкурентів і сезонність. Той самий огляд наводить опитування 661 фахівця із запасів, у якому 51% іноді діяли за прогнозами, які самі вважали ненадійними, бо кращої альтернативи не було, а зміни тарифів і торговельної політики (19%) та коливання інфляції чи цін на сировину (17%) опинилися серед найбільших чинників збою.
Виправлення з чотирьох кроків, по порядку
- Позначте кожен день дефіциту в історії продажів, вказавши, скільки годин або днів товару не було в наявності.
- Оцініть втрачені продажі за ці дні на основі подібних товарів у тому самому магазині й тижні.
- Позначте кожен період як «товар у наявності» або «обмежена наявність» до початку будь-якого навчання моделі.
- Навчайте модель на скоригованій історії та порівнюйте результати на відкладених тижнях, а не на тих, які ви виправляли.
Для більшості малих і середніх підприємств ця робота підвищує точність більше, ніж зміна алгоритму. Модель може навчитися лише тому, що є в даних; якщо в них сказано, що попит обвалився під час дефіциту, складніша архітектура просто швидше вивчить хибну закономірність. У нашому посібнику ELECTE з інтеграції кількох джерел даних описано, як зібрати дані про продажі, запаси та промоакції в одну придатну до роботи таблицю.
Порівняння методів прогнозування за ситуаціями в роздрібній торгівлі
Найкращого методу не існує, є лише той, що підходить до ситуації. Таблиця нижче — це порівняння, яке я хотів би бачити закріпленим над столом планування.
Метод | Найкраща ситуація в рітейлі | Потрібні дані | Сильна сторона | На що зважати |
|---|---|---|---|---|
Ковзне середнє або експоненційне згладжування | Стабільні товари з великим обсягом продажів | 1–2 роки тижневих продажів | Простий, недорогий і легко пояснюється | Не враховує промоакції та сезонні зсуви |
Сезонні моделі, як-от SARIMA | Товари з чіткими тижневими або річними циклами | Історія щонайменше за два сезони | Враховує тренд і сезонність | Погано працює з тисячами рядів одночасно |
Методи сімейства Крості (Croston) | Товари (SKU) з нерегулярним, повільним попитом | Історія продажів з багатьма нульовими періодами | Окремо оцінює частоту продажів і їхній розмір | Хибний вибір для товарів зі стабільним попитом |
Регресія з ознаками промоакцій і цін | Категорії, що залежать від промоакцій | Календар промоакцій та історія цін | Показує, як кожен чинник впливає на попит | Не працює, якщо промоакцій мало |
Ансамблі дерев, як-от XGBoost або LightGBM | Великі портфелі «товар–магазин» | Продажі, календар, промоакції та ціни | Навчається на багатьох пов’язаних рядах | Потребує чистих даних і постійного моніторингу |
Гібридні ансамблі LSTM-XGBoost | Мережі з багатьма категоріями та багатими сигналами | 36 місяців даних касових систем і промоакцій | Зменшили середню абсолютну відсоткову похибку в середньому на 28,6% на горизонті чотирьох тижнів у одному дослідженні 14 роздрібних організацій | Складніше створювати й пояснювати |
Закономірність, що стоїть за цими рядками, важливіша за будь-який окремий рядок. В рецензованому огляді досліджень із прогнозування в роздрібній торгівлі повідомляється, що глобальні моделі машинного навчання, зокрема нейронні мережі прямого поширення та рекурентні, градієнтно-бустингові регресійні дерева й випадкові ліси, часто перевершують окремі моделі часових рядів і регресійні моделі, коли ритейлери прогнозують великі масиви рядів продажів. Ця перевага зростає разом із портфелем: тисячі комбінацій «товар — магазин», де попит на окремі товари розріджений, переривчастий, сезонний або чутливий до промоакцій.
Як виглядає порівняння в реальній мережі
Уявіть регіональну мережу з 40 магазинів. Для базових товарів зі стабільними тижневими продажами застосовують експоненційне згладжування, бо категорійний менеджер може прочитати результат і поставити його під сумнів. Для сезонного одягу з вісьмома промоакціями на рік використовують градієнтно-бустингову модель, навчену одразу на всіх магазинах, бо історії одного магазину замало, щоб вивчити криву реакції на знижку.
Огляд так само чітко наголошує, що старіші методи не застаріли. Вони залишаються конкурентними на менших наборах даних, для стабільних товарів і в умовах, де інтерпретованість і обмеженість даних важать більше за останній відсоток точності.
Стриманість окупається. В оцінці попиту в роздрібній торгівлі США за 2026 рік на наборі даних M5, що охоплює 25 940 рядів «товар — магазин» у п'яти ковзних 28-денних вікнах, середню зважену абсолютну відсоткову похибку знизили з 0,9006 для сезонно-наївного еталона до 0,7022 із моделлю LightGBM на історичному попиті, тобто приблизно на 22%. Додавання роздрібних і операційних змінних дало лише 0,6979, а запізнілі макроекономічні показники — 0,6978, тобто приріст приблизно 0,02%.
Спершу побудуйте базову модель. Сезонно-наївний прогноз або експоненційне згладжування, які можна отримати за пів дня, покажуть, чи виправдала модель машинного навчання свою складність. Запустіть обидві на тих самих відкладених тижнях і залиште переможця.
Вибір моделі має залежати від масштабу й структури портфеля, а не від того, наскільки метод новий. Цей принцип заощадить вам більше грошей, ніж будь-який підбір гіперпараметрів.
Повільним товарам і розрідженому попиту потрібна окрема модель
Деякі товари не мають рівня попиту. Вони мають подію попиту. Запчастина, що продається чотири рази на рік, варіант із довгого хвоста в e-commerce, комбінація «магазин — SKU», яка рухається на дві одиниці за місяць: стандартні сезонні моделі працюють із ними погано, і причина тут структурна.
Нулі та додатні продажі походять із двох різних процесів. Чи відбудеться продаж узагалі — одне питання. Який його обсяг, коли він відбувся, — інше. Методи типу Кростона оцінюють їх окремо, тому добре працюють на роздрібних даних із великою кількістю нулів. У бенчмарку прогнозування в роздрібній торгівлі для переривчастого попиту Кростон показує WAPE 93,15% і MASE 0,9852, випереджаючи наївну модель і SARIMAX, з якими його порівнювали. Розглядайте цей WAPE як відносний результат на рядах, повних нулів, а не як хорошу оцінку точності в абсолютному вимірі.
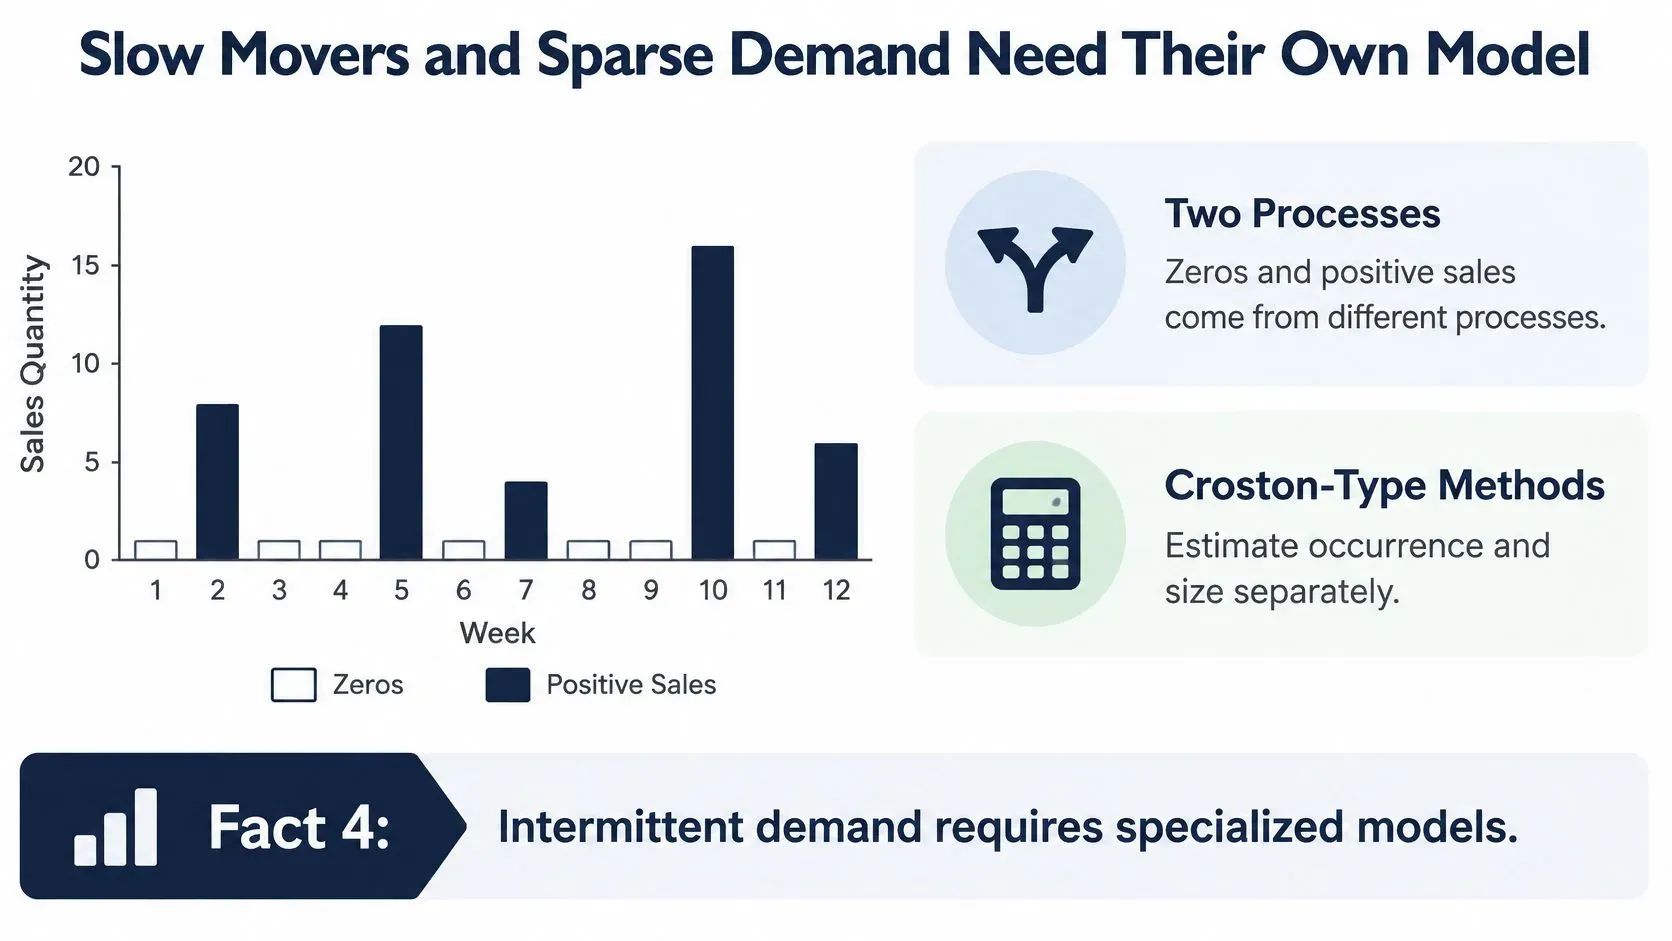
Цей збій має конкретний і дорогий вигляд. Стандартна регресійна або сезонна модель бачить серію нулів і робить висновок, що попит низький і стабільний, тому відповідно встановлює страховий запас. Повільний товар, який продається непередбачуваними сплесками, закінчується, а «мертвий» товар тим часом лежить із запасом на три місяці. Одна помилка коштує продажу, інша — грошей і місця на полицях.
У цій самій темі є й другий урок. Бенчмарк на даних про продажі з нерегулярним попитом, пропущеними спостереженнями та частою ротацією асортименту показав, що серед протестованих підходів найкраще спрацювали локалізовані моделі на основі дерев, а XGBoost досяг найменшої зафіксованої середньоквадратичної похибки — 4,833. Висновок не в тому, щоб «використовувати XGBoost усюди». Він у тому, що коли товари швидко змінюються, моделі, побудовані для окремих товарних родин, можуть перевершити одну узагальнену модель, змушену усереднювати несумісні закономірності.
Як маршрутизувати часовий ряд
- Класифікуйте до моделювання. Для кожного ряду обчисліть середній інтервал між випадками попиту та квадрат коефіцієнта варіації ненульового попиту. Перший показник — це типовий розрив у періодах між продажами; другий показує, наскільки сильно розмір продажів коливається від одного продажу до іншого.
- Спрямовуйте нерегулярні ряди до моделей родини Кростона, hurdle-моделей або моделей «поява — розмір».
- Стабільні товари з великим обсягом продажів віддавайте сезонним моделям або моделям машинного навчання — їхнє місце саме там.
- Перевіряйте класифікацію щокварталу. Товари переходять між категоріями, коли старіють, знімаються з продажу або набирають популярність, а правило маршрутизації, яке ніколи не перезапускають, погіршується.
Зберігайте класифікацію в таблиці, яку можна переглянути. Коли категорійний менеджер питає, чому товар прогнозують незвичним методом, відповіддю мають бути два числа, а не знизування плечима.
Промоакції, накопичення запасів і зміни каналів
Промотижні — не звичайні тижні, і змішування їх із базовим рівнем псує обидва. Моделюйте базовий попит і ефекти промоакцій окремо, а потім додавайте їх.
Порівняння підходів до прогнозування в роздрібній торгівлі показало, що ансамблі дерев рішень перевершують лінійну регресію, лінійну регресію зі штрафом і методи регресійних дерев для щоденного попиту на рівні мережі, коли SKU мали понад п'ять історичних промоакцій. П'ять — корисний поріг у цьому результаті. Нижче нього прикладів замало, щоб модель навчилася, як глибина знижки, час проведення промоакції та взаємодії з календарем товару впливають на попит, тому сильніша регуляризація або простіший еталон шкодять менше, ніж гнучка модель, що женеться за шумом.
Дайте моделі явні ознаки: статус промоакції, відсоток знижки, розміщення на викладці, близькість до свят і лагований попит після промоакції. Останню ознаку часто пропускають, хоча саме вона фіксує провал.
Провал, який ніхто не прогнозує
Припустімо, знижка 30% на шампунь підвищує продажі на один тиждень, а потім два тижні продажі залишаються нижчими за тренд. Покупці зробили запаси, але за квартал не стали купувати більше. Розглядайте весь тритижневий проміжок як одну одиницю аналізу. Похибка в період акції показує, чи ви замовили достатньо. Похибка після акції показує, чи не замовили ви забагато на решту місяця. Якщо оцінювати їх окремо, видно обидва рішення. Якщо разом, дві похибки взаємно гасяться, і звіт виглядає чистим, хоча обидва рішення були хибними.
Дослідження життєвого циклу промоакцій зазначає, що попередні роботи часто оминають післяакційну фазу, коли попит падає, бо клієнти зробили запаси під час акції, і повідомляє, що методи машинного навчання можуть покращити прогнози на всьому життєвому циклі, а не лише під час самої акції.
Канал додає ще один шар ілюзії. Дослідження багатоканальних промоакцій у регіональному бразильському супермаркеті оцінило зміщення попиту на 11,23% з фізичних магазинів в онлайн і 19,34% у зворотному напрямку, а скоординовані акції зменшили канібалізацію на 30,04%. Найбільший виміряний приріст дали програми лояльності: 3,5%. Якщо прогнозувати кожен канал окремо, ви двічі порахуєте попит, який просто змінив адресу.
Тоді дотримуйтеся чотирьох правил оцінювання:
- Оцінюйте акційні та неакційні періоди окремо, щоб вдалий тиждень не маскував поганий місяць.
- Порівнюйте з базовою моделлю приросту або подібною причинно-наслідковою базою, інакше ви лише міряєте, наскільки добре модель вивчила обсяг.
- Оцінюйте за SKU та за частотою акцій, адже поріг у п'ять акцій змінює те, чого можна очікувати.
- Залишайте в моделі ознаку післяакційного лагу, щоб вона могла відобразити спад, а не дивувалася йому.
Якщо знижки з'їдають вашу маржу, наш посібник про те, як захистити маржу під час кампаній зі знижками, розглядає цінову сторону тієї самої проблеми.
Вимірювання точності та перетворення прогнозів на замовлення
Обирайте метрику після того, як обрали рішення. Кожна міра відповідає на інше питання і приховує щось своє.
Метрика | Коли використовувати | На що звернути увагу |
|---|---|---|
WAPE (зважена абсолютна відсоткова похибка) | Порівняння точності для товарів різного масштабу продажів | Найбільшу вагу надає товарам із великим обсягом продажів |
MASE (середня абсолютна масштабована похибка) | Порівняння моделей на нерегулярних рядах або рядах із багатьма нулями | Для правильної інтерпретації потрібен наївний еталонний прогноз |
MAPE (середня абсолютна відсоткова похибка) | Проста звітність щодо стабільних товарів із великим обсягом продажів | Нестабільна або невизначена, коли фактичний попит дорівнює нулю |
Зміщення (bias) | Виявлення систематичного завищення або занищення прогнозу | Взаємно компенсовані похибки можуть приховати його, якщо не аналізувати по періодах |
Рівень сервісу | Перевірка, чи прогноз забезпечує наявність товару на полиці | Залежить від налаштувань поповнення запасів, а не лише від прогнозу |
Відсоткові похибки не працюють для товарів із повільним оборотом. Коли фактичний попит дорівнює нулю, знаменник теж нульовий, і метрика або «вибухає», або виключається із середнього. Обидва варіанти прикрашають результат моделі. Подавайте WAPE або масштабовану похибку разом із зміщенням (bias) і рівнем сервісу та аналізуйте їх за сегментами, а не як єдине число для всього каталогу.
Від прогнозу до точки перезамовлення
Прогноз перетворюється на замовлення через арифметику, яку може перевірити будь-хто в команді. Очікуваний попит за час поставки плюс страховий запас, розрахований під цільовий рівень сервісу, дають точку перезамовлення.
Припустімо, магазин очікує 40 одиниць за п’ятиденний термін поставки й тримає буфер у 10 одиниць. Точка перезамовлення — 50 одиниць. Коли наявний запас разом із замовленим опускається до 50, замовлення відправляється. Якщо закупівельник замовляє за 40, бо буфер ніколи не погоджували, полиця спорожніє вже в перший день затримки вантажівки.
Дві практики допомагають дотримуватися дисципліни. Налаштуйте сповіщення про винятки: якщо похибка прогнозу по товару перевищує ваш поріг два періоди поспіль або більше, хтось має переглянути товар, а не дашборд. Щомісяця перевіряйте зміщення за категоріями, щоб виявляти системове завищення чи заниження прогнозу, яке губиться в усереднених похибках окремих товарів.
Статистично точний прогноз усе одно може спричинити дефіцит, якщо неправильно відкалібровано час замовлення, частоту перегляду або страховий запас. Переглядайте прогноз і правила поповнення разом, інакше ви постійно виправлятимете не те.
У нашому посібнику ELECTE з аналітики даних про запаси докладніше розповідається, як пов’язати стан запасів із показниками, на які спираються закупівельники.
Підтвердьте план прогнозування перед наступним циклом закупівель
Перш ніж розмістити наступне замовлення, переконайтеся, що процес прогнозування відповідає товарам і рішенням, які він має підтримувати. П’ять перевірок зроблять план практичним:
- Розподіліть асортимент. Визначте товари, що приносять основну частину виручки, і віднесіть їх до стабільних, залежних від промоакцій або з нерегулярним попитом. Для решти може вистачити простішого правила.
- Перевірте історію продажів. Вивантажте дані за 12–24 місяці по товарах, магазинах і днях та позначте дні без залишків. Якщо доступно лише 12 місяців, використовуйте їх, але очікуйте більшої похибки.
- Порівняйте з базовою моделлю. Задайте сезонну базову модель і порівняйте з нею складніші моделі на тижнях, які не використовувалися для навчання. Результат M5 вище показує, чому складніша модель має заслужити своє місце.
- Налаштуйте процес вимірювання. Оберіть метрику для кожного рішення, а потім підтримуйте незмінними її поріг і періодичність перегляду від циклу до циклу.
- Розбирайте повторні промахи. Перш ніж розміщувати замовлення, перегляньте точки перезамовлення для товарів із повторюваними похибками прогнозу.
ELECTE застосовує до даних користувача шість методів прогнозування, порівнює їх між собою та обирає найточніший. Безкоштовний калькулятор точки перезамовлення допомагає розрахувати цей показник для окремого товару.
Прогнози знижують ризик, але не можуть врахувати всі зміни. Модель може не передбачити запуск нового товару чи промоакцію без порівнянної історії продажів. Підтримуйте регулярний перегляд поряд із прогнозом, щоб закупівельники могли реагувати, коли фактичний попит відрізняється від плану.
ELECTE об’єднує дані про продажі, запаси та промоакції, порівнює шість методів прогнозування на наявних даних і подає прогнози, точність та винятки у наочних дашбордах, якими можуть користуватися всі команди. Якщо ви представник роздрібної торгівлі й хочете оцінити прогнози попиту разом із власними даними про продажі, відвідайте ELECTE.
Коментарі
Коментарів поки немає — почніть обговорення.