Peramalan Permintaan untuk Ritel: Metode, Data, dan Manfaatnya
Pelajari cara kerja peramalan permintaan untuk ritel, metode apa yang bisa dipakai, data yang dibutuhkan, dan cara mengurangi stok kosong serta kelebihan stok lewat perencanaan inventaris yang lebih baik.

Stok kosong biasanya dituding sebagai kesalahan pemasok. Padahal sering kali penyebabnya lebih dekat. Sebuah studi inventaris ritel yang dipresentasikan di konferensi IEOM Society Bangladesh 2025 menunjukkan bahwa 51% hingga 73% stok kosong di supermarket berasal dari dalam operasional ritel itu sendiri, dengan peramalan yang tidak akurat (termasuk permintaan yang diremehkan) dan kesalahan pemesanan sebagai salah satu penyebab utama.
Temuan itu mengubah cara kita memandang pekerjaan ini. Peramalan permintaan untuk ritel bukan lomba memilih algoritma paling canggih. Ini adalah disiplin operasional: mengambil sinyal permintaan yang jujur dari data yang sudah terdistorsi oleh stok kosong dan promosi, mencocokkan metode dengan pola penjualan tiap produk, lalu menyambungkan hasilnya ke titik pemesanan ulang yang benar-benar dipakai pembeli pada Senin pagi.
Panduan ini membahas seluruh siklusnya. Anda akan melihat apa yang harus dihasilkan oleh peramalan, input mana yang paling berpengaruh, bagaimana enam metode umum dibandingkan menurut situasi ritel, mengapa produk berputar lambat membutuhkan arsitektur yang berbeda, bagaimana penimbunan oleh pembeli dan perpindahan kanal menggelembungkan lonjakan promosi yang tampak, metrik kesalahan mana yang layak dipercaya untuk keputusan tertentu, serta pemeriksaan lima langkah sebelum siklus pembelian berikutnya.
Arti Peramalan Permintaan di Lantai Toko
Prakiraan cuaca dipercaya jika bersifat lokal dan terikat waktu: peluang hujan di kota Anda pada Selasa sore sudah cukup untuk memutuskan apakah perlu membawa payung. Peramalan permintaan menjalankan tugas yang sama untuk inventaris. Ia memperkirakan berapa unit suatu barang yang akan dibeli pelanggan di toko tertentu pada minggu tertentu, sehingga pembeli memesan jumlah yang tepat, bukan sekadar jumlah yang masuk akal.
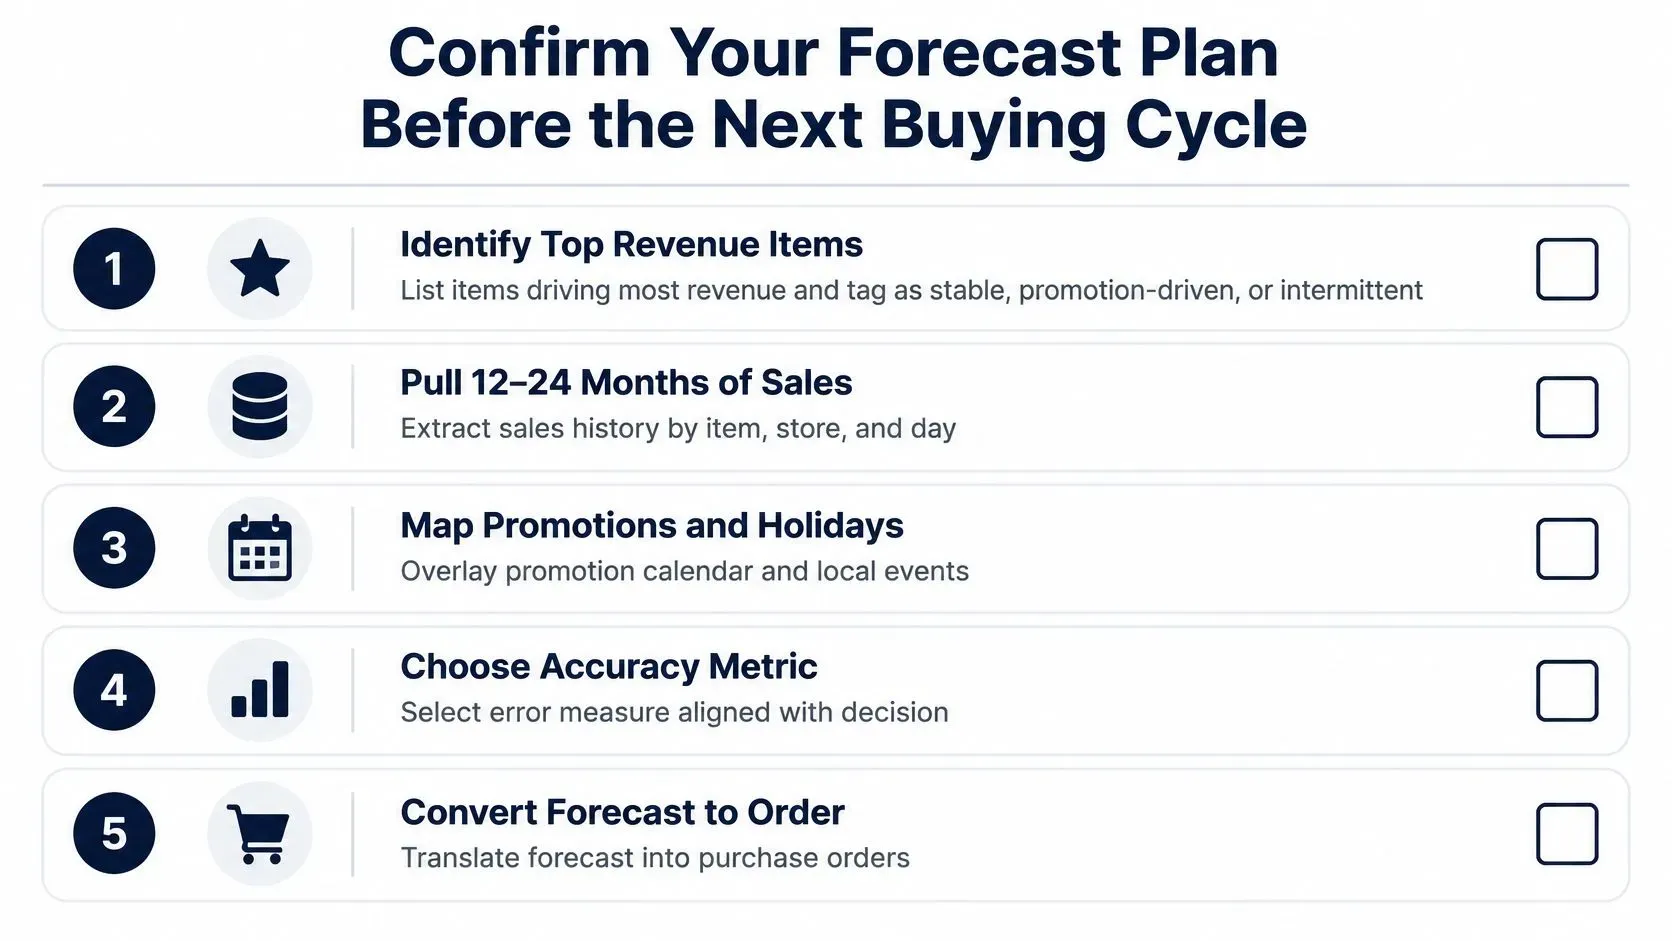
Lima langkah di bawah ini merangkum seluruh gagasannya, dari prediksi hingga pesanan pembelian yang harus dipicunya.
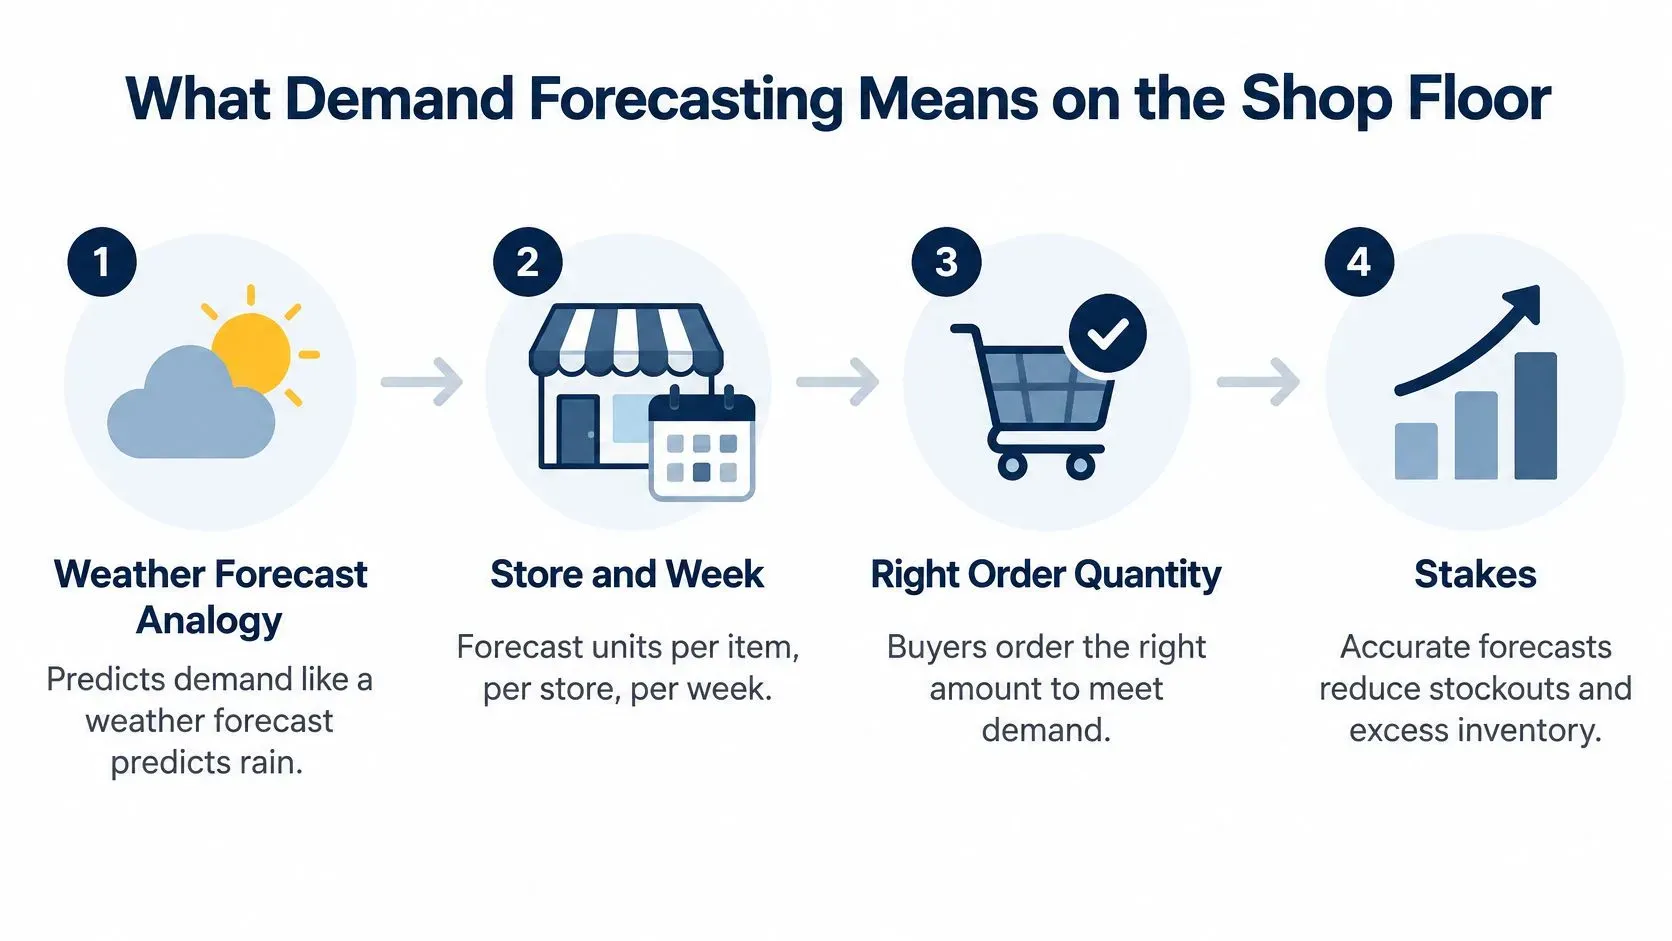
Targetnya adalah permintaan, bukan angka penjualan yang kebetulan tercatat di kasir. Angka nol yang tercatat saat rak sampo kosong adalah permintaan yang tersensor; lonjakan promosi bisa jadi dipinjam dari dua minggu berikutnya atau ditarik dari toko di dekatnya. Rata-rata kategori dan laporan bulanan menyembunyikan masalah tingkat barang-toko tersebut, sehingga sinyalnya harus tetap terperinci dan sering diperbarui.
Siklus kerjanya seperti ini:
- Kumpulkan riwayat penjualan dan stok per barang, toko, dan hari, termasuk hari ketika rak kosong.
- Bersihkan dan selaraskan: satu satuan ukuran, satu kalender, tanpa baris ganda saat sistem toko merevisi data satu minggu.
- Sesuaikan model dan buat peramalan permintaan per barang-toko, pada tingkat perincian yang dibutuhkan keputusan pemesanan Anda.
- Ubah peramalan menjadi pesanan dan stok pengaman, dengan memakai waktu tunggu dan tingkat layanan yang sudah Anda janjikan.
- Ukur kesalahan dan sesuaikan, barang demi barang, bukan setahun sekali saat penyusunan anggaran.
Setiap langkah melindungi dari salah satu dari tiga biaya. Jika peramalan terlalu rendah, Anda kehilangan penjualan yang tidak bisa dipulihkan, karena pembeli memilih barang pengganti atau pergi. Jika terlalu tinggi, uang tertahan di stok yang harus didiskon. Jika jumlahnya kira-kira tepat tetapi waktunya meleset, Anda rugi dua kali: biaya kirim kilat untuk pesanan mendesak dan biaya penyimpanan untuk kelebihan stok.
Aturan yang paling banyak menghemat biaya: peramalan baru bermanfaat jika ada aturan pengisian ulang yang menindaklanjutinya. Angka yang sempurna di dalam laporan tidak mengubah apa pun di rak.
Input Data dan Alasan Stok Kosong Mendistorsinya
Sebelum membandingkan model, lihat dulu apa yang dimasukkan ke dalamnya. Input yang paling meningkatkan akurasi ritel itu mudah ditebak dan membosankan, dan banyak tim belum memiliki dua atau tiga di antaranya.
- Riwayat penjualan per barang, toko, dan hari. Data yang lebih kasar menyembunyikan minggu promosi dan lonjakan akhir pekan yang membawa sinyal.
- Persediaan di tangan dan durasi stok kosong. Tanpanya, Anda tidak bisa membedakan minggu yang sepi dari rak yang kosong.
- Harga dan besarnya diskon. Potongan 10% dan 30% tidak menghasilkan kurva respons yang sama, jadi simpan harga rak yang dibayar pembeli, bukan harga resmi.
- Kalender promosi, termasuk penempatan display dan iklan unggulan.
- Hari libur dan acara lokal. Bazar sekolah dua jalan dari toko bisa menggerakkan lebih banyak air kemasan daripada hari libur nasional.
- Cuaca, terutama untuk kategori segar, musiman, dan perlengkapan taman.
- Harga pesaing, sejauh Anda bisa mengamatinya secara konsisten.
- Waktu tunggu pemasok dan keterlambatan pengiriman, yang menentukan seberapa besar cadangan yang Anda perlukan.
Mengapa Rak Kosong Menghasilkan Angka Nol Palsu
Misalkan sampo Anda rata-rata terjual 40 unit per minggu dan raknya kosong selama tiga hari. Hari-hari itu mencatat penjualan nol. Model yang dilatih dengan riwayat tersebut akan belajar bahwa permintaan turun setiap kali stok habis, padahal kenyataannya kebalikannya. Pembeli yang tidak menemukan barang tidak berubah pikiran; mereka pergi ke tempat lain.
Keterlambatan pemasok, pengisian ulang yang lambat, dan keputusan pemesanan Anda sendiri menyensor penjualan dengan cara yang sama persis. Model tidak bisa membedakan penjualan yang hilang dari minat yang hilang, dan akan terus memesan terlalu sedikit untuk barang yang paling cepat habis.
Kegagalan ini terdokumentasi dengan baik. Tinjauan 2026 tentang pembelajaran mesin dalam peramalan ritel menyebut dataset yang tidak lengkap, alur data yang terfragmentasi, perubahan perilaku pelanggan, promosi, reaksi pesaing, dan musiman sebagai penyebab model yang bias dan rapuh. Tinjauan yang sama mengutip survei terhadap 661 profesional inventaris yang 51% di antaranya kadang tetap memakai peramalan yang mereka anggap tidak andal karena tidak ada alternatif yang lebih baik, sementara perubahan tarif dan kebijakan perdagangan (19%) serta gejolak inflasi atau harga komoditas (17%) termasuk pengganggu terbesar.
Perbaikan Empat Langkah, Secara Berurutan
- Tandai setiap hari kehabisan stok dalam riwayat penjualan, dengan jam atau hari saat barang tidak tersedia.
- Perkirakan penjualan yang hilang pada hari-hari tersebut berdasarkan barang sebanding di toko dan minggu yang sama.
- Beri label pada setiap periode sebagai tersedia atau terbatas sebelum proses pelatihan apa pun dimulai.
- Latih model dengan riwayat yang telah disesuaikan, lalu bandingkan hasilnya pada minggu pengujian yang ditahan, bukan pada minggu yang telah Anda perbaiki.
Bagi sebagian besar UKM, pekerjaan ini meningkatkan akurasi lebih jauh daripada mengganti algoritma. Model hanya dapat mempelajari apa yang ada dalam catatan; jika catatan menunjukkan permintaan anjlok saat kehabisan stok, arsitektur yang lebih canggih hanya akan mempelajari hal yang salah dengan lebih cepat. Panduan ELECTE tentang integrasi multisumber kami membahas infrastruktur yang menyatukan data penjualan, stok, dan promosi ke dalam satu tabel yang siap pakai.
Perbandingan Metode Peramalan berdasarkan Situasi Ritel
Tidak ada metode terbaik, hanya metode yang sesuai dengan situasinya. Tabel di bawah ini adalah perbandingan yang menurut saya layak dipasang di atas meja perencanaan.
Metode | Situasi ritel yang paling cocok | Data yang dibutuhkan | Kekuatan | Perlu diwaspadai |
|---|---|---|---|---|
Rata-rata bergerak atau pemulusan eksponensial | Produk bervolume tinggi dan stabil | Penjualan mingguan selama 1-2 tahun | Sederhana, murah, dan mudah dijelaskan | Tidak menangkap promosi dan pergeseran musiman |
Model musiman seperti SARIMA | Produk dengan siklus mingguan atau tahunan yang jelas | Riwayat dua musim atau lebih | Menangkap tren dan musiman | Kesulitan menangani ribuan deret waktu sekaligus |
Metode keluarga Croston | SKU intermiten dan perputaran lambat | Riwayat penjualan dengan banyak periode nol | Memisahkan seberapa sering penjualan terjadi dari besarnya penjualan | Pilihan yang keliru untuk produk yang laku stabil |
Regresi dengan fitur promosi dan harga | Kategori yang digerakkan promosi | Kalender promosi dan riwayat harga | Menunjukkan bagaimana setiap faktor menggerakkan permintaan | Tidak andal jika promosi jarang dilakukan |
Ensambel pohon seperti XGBoost atau LightGBM | Portofolio produk-toko berskala besar | Penjualan, kalender, promosi, dan harga | Belajar dari banyak deret waktu yang saling terkait | Membutuhkan data bersih dan pemantauan berkelanjutan |
Ensambel hibrida LSTM-XGBoost | Jaringan multikategori dengan sinyal data yang kaya | Data point-of-sale dan promosi selama 36 bulan | Menurunkan mean absolute percentage error rata-rata sebesar 28,6% pada horizon empat minggu dalam satu studi terhadap 14 organisasi ritel | Lebih berat untuk dibangun dan dijelaskan |
Pola di balik baris-baris data lebih penting daripada satu baris mana pun. Tinjauan peer-reviewed atas riset peramalan ritel melaporkan bahwa model machine learning global, termasuk jaringan saraf feed-forward dan rekuren, gradient-boosted regression tree, dan random forest, sering mengungguli model deret waktu dan model regresi terpisah saat peritel meramalkan sejumlah besar deret penjualan. Keunggulannya makin besar seiring bertambahnya portofolio: ribuan kombinasi item-toko, dengan permintaan tiap produk yang jarang, tidak kontinu, musiman, atau sensitif terhadap promosi.
Seperti Apa Perbandingannya di Jaringan Ritel Nyata
Bayangkan jaringan regional dengan 40 toko. Item pokok dengan penjualan mingguan stabil memakai exponential smoothing, karena manajer kategori bisa membaca angkanya dan mempertanyakannya. Pakaian musiman dengan delapan promosi per tahun memakai model gradient-boosted yang dilatih dari semua toko sekaligus, karena riwayat satu toko terlalu tipis untuk mempelajari kurva diskon.
Tinjauan itu sama jelasnya bahwa metode lama belum usang. Kinerjanya tetap kompetitif pada dataset yang lebih kecil, produk yang stabil, dan situasi saat interpretabilitas dan keterbatasan data lebih penting daripada selisih akurasi terakhir.
Menahan diri itu menguntungkan. Evaluasi tahun 2026 atas permintaan ritel AS pada dataset M5, yang mencakup 25.940 deret item-toko dalam lima jendela bergulir 28 hari, menurunkan rata-rata weighted absolute percentage error dari 0,9006 pada tolok ukur seasonal-naive menjadi 0,7022 dengan model LightGBM yang memakai permintaan historis, perbaikan sekitar 22%. Penambahan variabel ritel dan operasional hanya mencapai 0,6979, dan indikator makroekonomi dengan jeda waktu mencapai 0,6978, peningkatan sekitar 0,02%.
Bangun baseline lebih dulu. Angka seasonal-naive atau exponential smoothing yang bisa dibuat dalam satu sore memberi tahu apakah model machine learning pantas dengan kompleksitasnya. Jalankan keduanya pada minggu hold-out yang sama dan pakai yang menang.
Pilihan model harus mengikuti skala dan struktur portofolio, bukan apakah metodenya lebih baru. Prinsip sederhana itu akan menghemat lebih banyak uang daripada pencarian hyperparameter apa pun.
Produk Lambat Laku dan Permintaan Jarang Butuh Model Tersendiri
Sebagian produk tidak punya tingkat permintaan. Mereka punya kejadian permintaan. Suku cadang yang terjual empat kali setahun, varian e-commerce long-tail, kombinasi toko-SKU yang bergerak dua unit per bulan: model musiman standar menanganinya dengan buruk, dan alasannya struktural.
Nol dan penjualan positif berasal dari dua proses berbeda. Apakah penjualan terjadi sama sekali adalah satu pertanyaan. Seberapa besar penjualan itu saat terjadi adalah pertanyaan lain. Metode jenis Croston memperkirakan keduanya secara terpisah, sehingga tetap andal pada data ritel yang dipenuhi nol. Benchmark peramalan ritel untuk permintaan intermiten melaporkan Croston dengan WAPE 93,15% dan MASE 0,9852, lebih baik daripada alternatif naive dan SARIMAX yang diujikan. Baca WAPE itu sebagai hasil relatif pada deret yang penuh nol, bukan sebagai skor akurasi yang baik secara absolut.
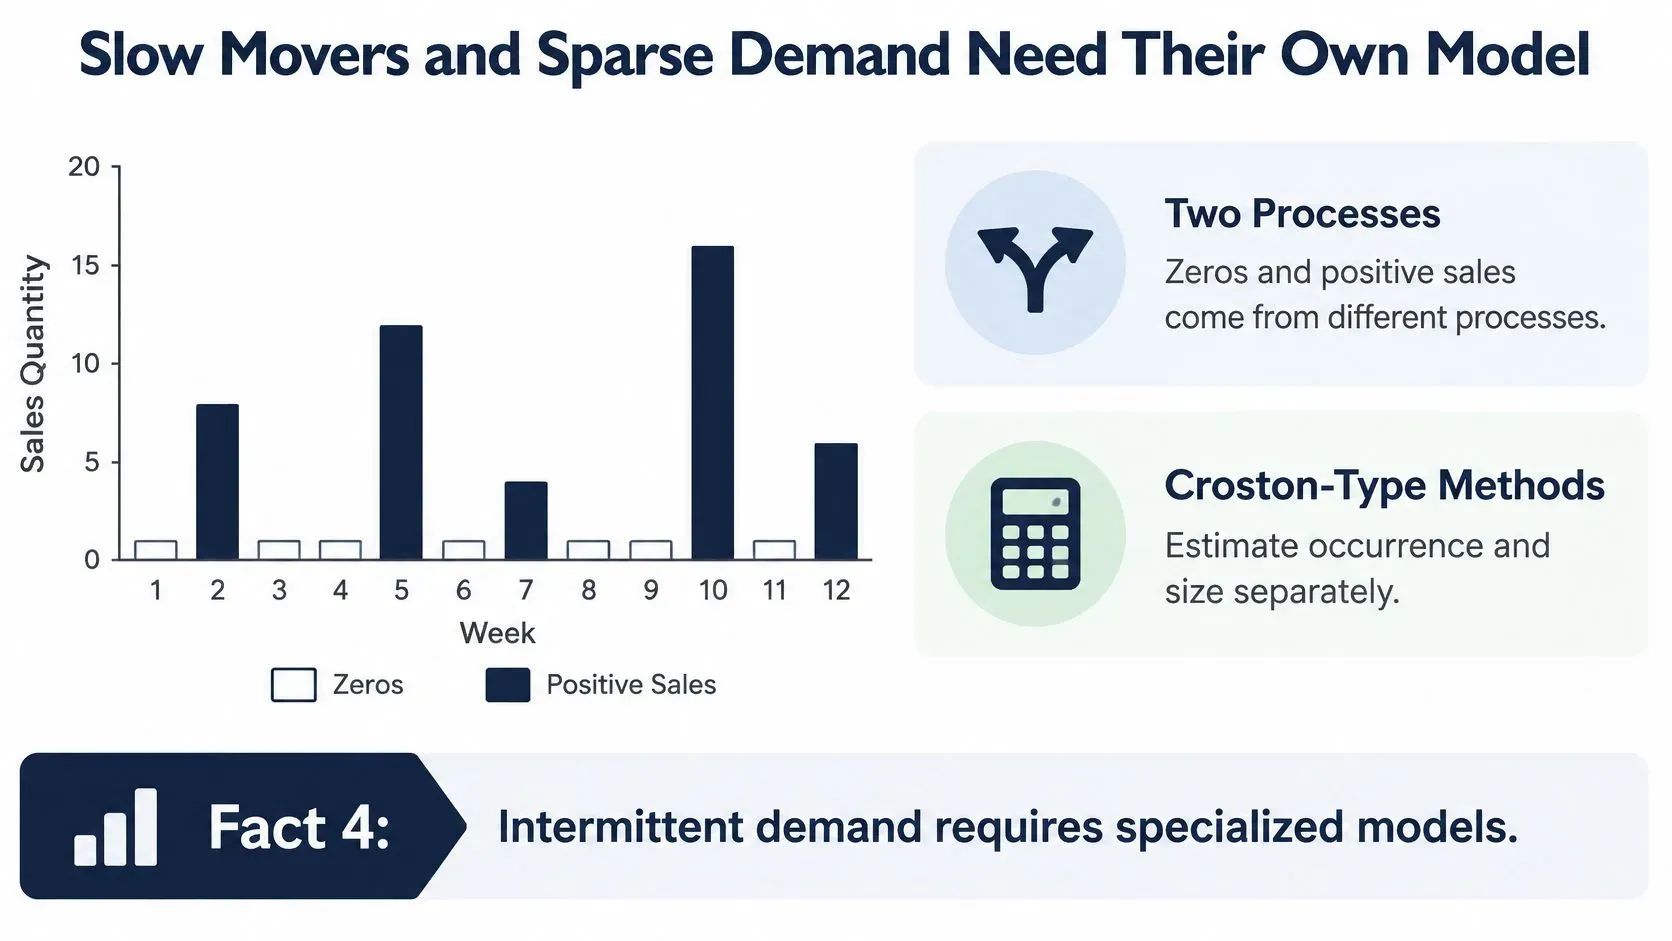
Kegagalannya spesifik dan mahal. Model regresi atau musiman standar melihat rentetan nol lalu menyimpulkan permintaan rendah dan stabil, sehingga menetapkan stok pengaman sesuai itu. Produk lambat laku yang terjual dalam lonjakan tak terduga akhirnya kehabisan stok, sementara item mati menyimpan cadangan tiga bulan. Satu kesalahan menghilangkan penjualan, yang lain menghabiskan kas dan ruang rak.
Ada pelajaran kedua di wilayah yang sama. Benchmark pada data penjualan dengan permintaan intermiten, observasi yang hilang, dan pergantian assortment yang sering menemukan bahwa model berbasis pohon yang terlokalisasi berkinerja terbaik di antara pendekatan yang diuji, dengan XGBoost mencapai root mean square error terendah yang dilaporkan, yaitu 4,833. Pesannya bukan "pakai XGBoost di mana-mana". Pesannya: saat produk cepat berganti, model per keluarga produk bisa mengungguli satu model umum yang dipaksa merata-ratakan pola yang tidak cocok.
Cara Mengarahkan Setiap Deret
- Klasifikasikan sebelum memodelkan. Hitung Average Demand Interval dan koefisien variasi kuadrat dari permintaan bukan nol untuk setiap deret. Yang pertama adalah jeda umum, dalam jumlah periode, antarpenjualan; yang kedua mengukur seberapa besar ukuran penjualan berfluktuasi dari satu penjualan ke penjualan berikutnya.
- Arahkan deret intermiten ke keluarga Croston, model hurdle, atau model kejadian-ukuran.
- Kirim item stabil bervolume tinggi ke model musiman atau machine learning, tempat yang semestinya.
- Periksa ulang klasifikasi setiap kuartal. Item berpindah kategori seiring usia, dihentikan, atau mulai laris, dan aturan pengarahan yang tidak pernah dijalankan ulang akan menurun kualitasnya.
Simpan klasifikasi dalam tabel yang bisa diperiksa. Ketika manajer kategori bertanya mengapa sebuah produk diramal dengan metode yang aneh, jawabannya harus berupa dua angka, bukan angkat bahu.
Promosi, Penimbunan, dan Pergeseran Kanal
Minggu promosi bukan minggu biasa, dan mencampurnya ke dalam baseline merusak keduanya. Modelkan permintaan baseline dan efek promosi sebagai hal terpisah, lalu jumlahkan.
Perbandingan pendekatan peramalan ritel menemukan bahwa ensemble pohon keputusan mengungguli regresi linear, regresi linear berpenalti, dan metode regression tree untuk permintaan harian tingkat jaringan ketika SKU memiliki lebih dari lima promosi historis. Lima adalah ambang yang berguna dalam hasil itu. Di bawahnya, contoh tidak cukup bagi model untuk mempelajari bagaimana kedalaman diskon, waktu promosi, dan interaksi kalender-produk menggerakkan permintaan, sehingga regularisasi lebih kuat atau benchmark yang lebih sederhana merugikan lebih sedikit daripada model fleksibel yang mengejar noise.
Berikan fitur eksplisit pada model: status promosi, persentase diskon, penempatan display, kedekatan dengan hari libur, dan permintaan pasca-promosi dengan jeda waktu. Yang terakhir sering ditinggalkan, padahal fitur itulah yang menangkap penurunannya.
Penurunan yang Tidak Diramal Siapa Pun
Misalkan diskon 30% untuk sampo mendongkrak penjualan selama satu minggu, lalu penjualan berada di bawah tren selama dua minggu berikutnya. Pembeli menimbun stok; mereka tidak membeli lebih banyak sepanjang kuartal. Perlakukan seluruh jendela tiga minggu itu sebagai satu unit analisis. Error pada periode promosi menunjukkan apakah pesanan Anda cukup. Error pasca-promosi menunjukkan apakah Anda memesan terlalu banyak untuk sisa bulan itu. Jika dinilai terpisah, kedua keputusan itu terlihat. Jika dinilai bersamaan, kedua error saling meniadakan dan laporan tampak bersih, padahal keduanya salah.
Riset tentang siklus hidup promosi mencatat bahwa penelitian sebelumnya sering mengabaikan fase pasca-promosi, ketika permintaan turun karena pelanggan menimbun stok selama acara berlangsung, dan melaporkan bahwa metode machine learning dapat memperbaiki prakiraan di seluruh siklus hidup, bukan hanya selama promosi itu sendiri.
Kanal menambahkan lapisan ilusi kedua. Sebuah studi tentang promosi multikanal di sebuah supermarket regional Brasil memperkirakan pergeseran permintaan sebesar 11,23% dari toko fisik ke online dan 19,34% ke arah sebaliknya, sementara promosi yang terkoordinasi mengurangi kanibalisasi sebesar 30,04%. Insentif loyalitas menghasilkan kenaikan terukur terbesar, yaitu 3,5%. Jika Anda memprakirakan tiap kanal secara terpisah, Anda akan menghitung ganda permintaan yang hanya berpindah tempat.
Lalu terapkan empat aturan dalam evaluasi:
- Nilai periode promosi dan non-promosi secara terpisah, agar satu minggu yang bagus tidak menutupi satu bulan yang buruk.
- Bandingkan dengan baseline base-lift atau baseline kausal serupa, jika tidak, Anda hanya mengukur seberapa baik model mempelajari volume.
- Evaluasi per SKU dan per frekuensi promosi, karena ambang lima promosi mengubah hasil yang bisa Anda harapkan.
- Pertahankan fitur lag pasca-promosi agar model dapat mengekspresikan penurunan itu, bukan terkejut olehnya.
Jika diskon menggerus margin Anda, panduan kami tentang melindungi margin selama kampanye diskon membahas sisi penetapan harga dari masalah yang sama.
Mengukur Akurasi dan Mengubah Prakiraan Menjadi Pesanan
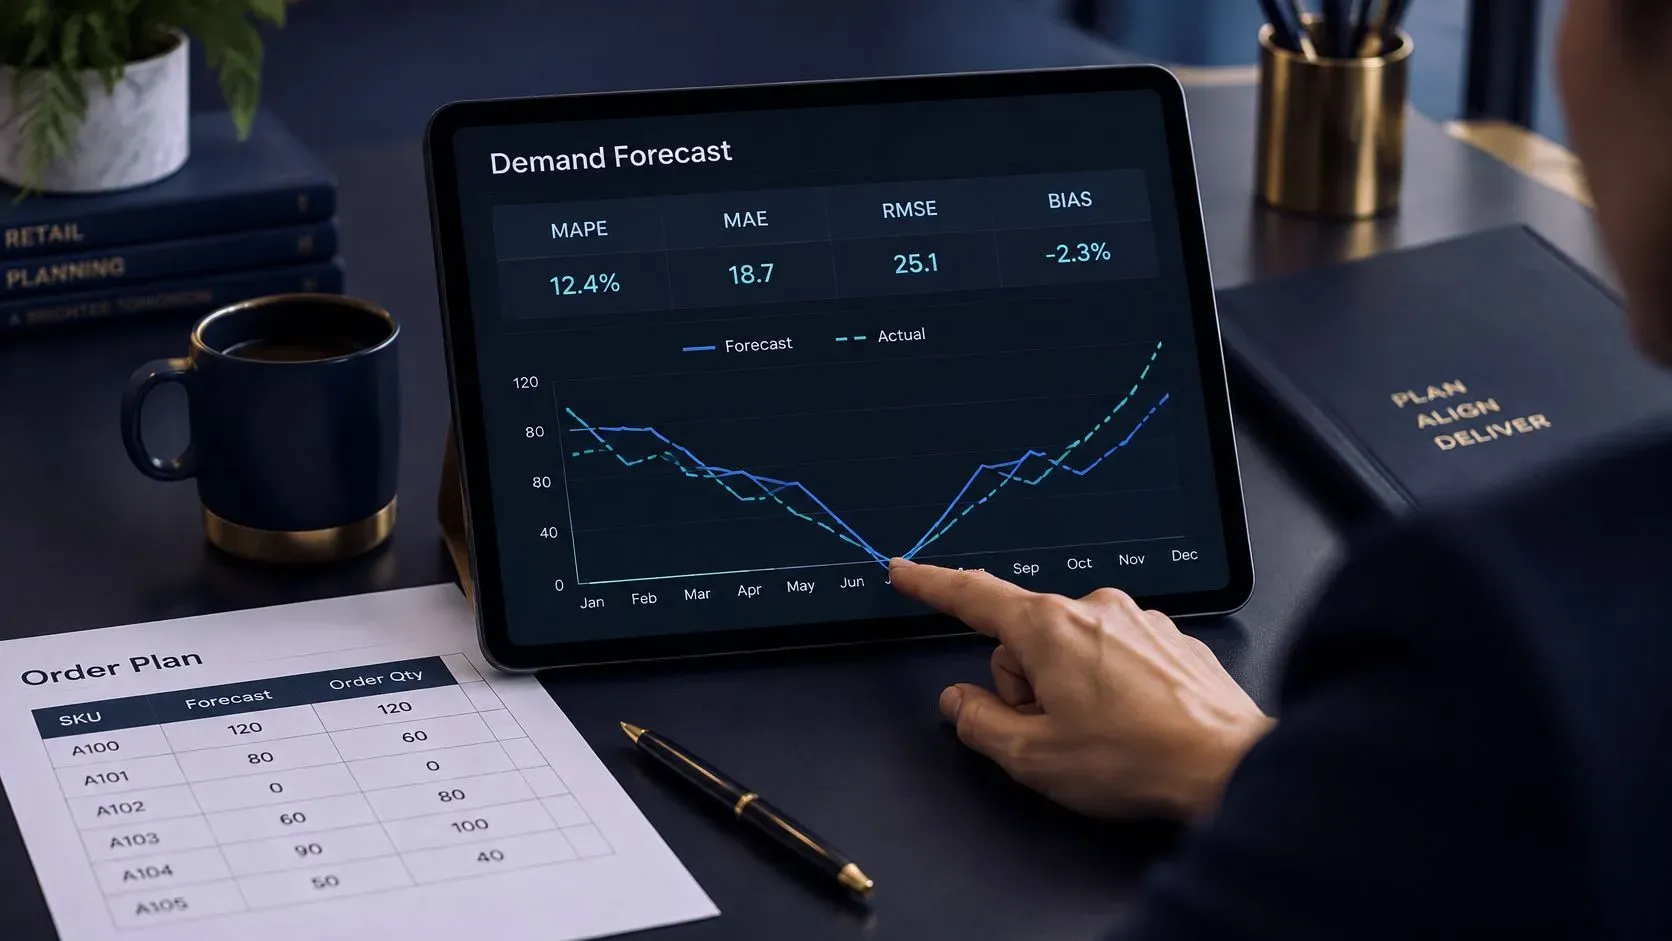
Pilih metrik setelah Anda menentukan keputusannya. Setiap ukuran menjawab pertanyaan yang berbeda dan menyembunyikan hal yang berbeda.
Metrik | Gunakan bila | Waspadai |
|---|---|---|
WAPE (weighted absolute percentage error) | Membandingkan akurasi antar item dengan ukuran berbeda | Memberi bobot paling besar pada item bervolume tinggi |
MASE (mean absolute scaled error) | Membandingkan model pada deret yang intermiten atau banyak nol | Perlu tolok ukur naif agar bisa dibaca dengan benar |
MAPE (mean absolute percentage error) | Pelaporan sederhana untuk item stabil dengan volume tinggi | Tidak stabil atau tidak terdefinisi saat permintaan aktual nol |
Bias | Mendeteksi prakiraan yang secara sistematis terlalu tinggi atau terlalu rendah | Error yang saling meniadakan dapat menyembunyikannya kecuali dibaca per periode |
Service level | Memeriksa apakah prakiraan menjaga ketersediaan di rak | Bergantung pada pengaturan replenishment, bukan hanya prakiraan |
Error persentase gagal pada item yang lambat terjual. Ketika permintaan aktual nol, penyebutnya nol dan metrik itu meledak atau dikeluarkan dari rata-rata, dan keduanya membuat model tampak lebih baik dari kenyataannya. Laporkan WAPE atau error terskala bersama bias dan service level, lalu baca per segmen, bukan sebagai satu angka untuk seluruh katalog.
Dari Angka ke Titik Pemesanan Ulang
Prakiraan menjadi pesanan lewat perhitungan yang bisa diperiksa siapa pun di tim. Permintaan yang diharapkan selama lead time, ditambah stok pengaman yang ditentukan sesuai target service level, menghasilkan titik pemesanan ulang.
Misalkan sebuah toko memperkirakan permintaan 40 unit selama lead time pemasok lima hari dan menyimpan buffer 10 unit. Titik pemesanan ulang (reorder point) adalah 50 unit. Saat stok di tangan ditambah stok yang sudah dipesan turun ke 50, pesanan dikirim. Jika pembeli memesan di angka 40 karena buffer tidak pernah disepakati, rak akan kosong pada hari pertama truk terlambat.
Dua rutinitas ini menjaga prosesnya tetap akurat. Atur peringatan pengecualian saat kesalahan forecast pada suatu item melewati ambang batas Anda selama dua periode berturut-turut atau lebih, sehingga ada orang yang memeriksa item tersebut, bukan hanya melihat dasbor. Jalankan pemeriksaan bias bulanan per kategori untuk menangkap forecast yang secara sistematis terlalu tinggi atau terlalu rendah, yang tersamarkan ketika kesalahan tiap item dirata-ratakan.
Forecast yang akurat secara statistik tetap bisa menyebabkan kekurangan stok jika waktu pemesanan, frekuensi peninjauan, atau safety stock tidak dikalibrasi dengan benar. Tinjau forecast dan aturan replenishment secara bersamaan, atau Anda akan terus memperbaiki hal yang salah.
Panduan analitik data stok ELECTE kami membahas lebih dalam cara menghubungkan posisi stok dengan angka yang menjadi dasar keputusan pembeli.
Konfirmasikan Rencana Forecast Anda Sebelum Siklus Pembelian Berikutnya
Sebelum pesanan berikutnya dibuat, pastikan proses forecast sesuai dengan produk dan keputusan yang harus didukungnya. Lima pemeriksaan berikut membuat rencana ini praktis:
- Pilah assortment Anda. Identifikasi item yang menyumbang sebagian besar pendapatan, lalu klasifikasikan sebagai stabil, didorong promosi, atau intermiten. Aturan yang lebih sederhana mungkin cukup untuk sisanya.
- Periksa riwayat penjualan. Ambil data penjualan 12 hingga 24 bulan per item, toko, dan hari, lalu tandai hari kehabisan stok. Jika hanya tersedia 12 bulan, tetap gunakan datanya, tetapi perkirakan kesalahan yang lebih besar.
- Uji terhadap baseline. Tetapkan baseline musiman dan bandingkan model yang lebih kompleks pada minggu data uji yang disisihkan. Hasil M5 di atas menunjukkan mengapa model yang lebih kompleks harus membuktikan nilainya.
- Tetapkan rutinitas pengukuran. Pilih satu metrik untuk setiap keputusan, lalu jaga ambang batas dan jadwal peninjauannya tetap konsisten di setiap siklus.
- Tinjau kesalahan yang berulang. Periksa kembali titik pemesanan ulang untuk item dengan kesalahan forecast berulang sebelum memesan.
ELECTE menjalankan enam metode forecasting pada data pengguna, menilainya satu sama lain, dan memilih yang paling akurat. Kalkulator titik pemesanan ulang gratisnya membantu menghitung titik pemesanan ulang untuk tiap item.
Forecast mengurangi risiko, tetapi tidak dapat mengantisipasi setiap perubahan. Model bisa melewatkan peluncuran produk baru atau promosi tanpa riwayat penjualan pembanding. Pertahankan rutinitas peninjauan di samping forecast agar pembeli dapat merespons ketika permintaan aktual berbeda dari rencana.
ELECTE menghubungkan data penjualan, stok, dan promosi, membandingkan enam metode forecasting pada data yang tersedia, serta menyajikan forecast, akurasi, dan pengecualian dalam dasbor visual yang dapat dibagikan tim. Bagi peritel yang menilai forecast permintaan bersama data penjualan mereka sendiri, kunjungi ELECTE.
Komentar
Belum ada komentar — mulai percakapannya.