Previsione della domanda nel retail: metodi, dati e vantaggi
Scopri come funziona la previsione della domanda nel retail, quali metodi usare, di quali dati ha bisogno e come ridurre rotture di stock e sovrastock con piani di inventario più accurati.

Una rottura di stock di solito viene attribuita al fornitore. Quasi sempre, però, il problema nasce più vicino a casa. Uno studio sull'inventario nel retail presentato alla conferenza IEOM Society 2025 in Bangladesh indica che dal 51% al 73% delle rotture di stock nei supermercati ha origine all'interno dell'operatività del punto vendita, con previsioni imprecise (inclusa la sottostima della domanda) ed errori d'ordine tra le cause principali.
Questo dato cambia il modo di impostare il lavoro. La previsione della domanda nel retail non è una gara per scegliere l'algoritmo più avanzato. È una disciplina operativa: estrarre segnali di domanda attendibili da dati già distorti da rotture di stock e promozioni, abbinare il metodo al modo in cui vende ciascun prodotto e collegare il risultato a punti di riordino che un buyer userà il lunedì mattina.
Questa guida copre l'intero ciclo. Vedrai cosa deve produrre la previsione, quali input pesano di più, come si confrontano sei metodi diffusi in base alla situazione del retail, perché i prodotti a bassa rotazione richiedono un'architettura diversa, come accaparramento e spostamenti tra canali gonfiano il lift apparente delle promozioni, quale metrica d'errore usare per ciascuna decisione e una verifica in cinque passaggi da eseguire prima del prossimo ciclo di acquisti.
Cosa significa prevedere la domanda sul punto vendita
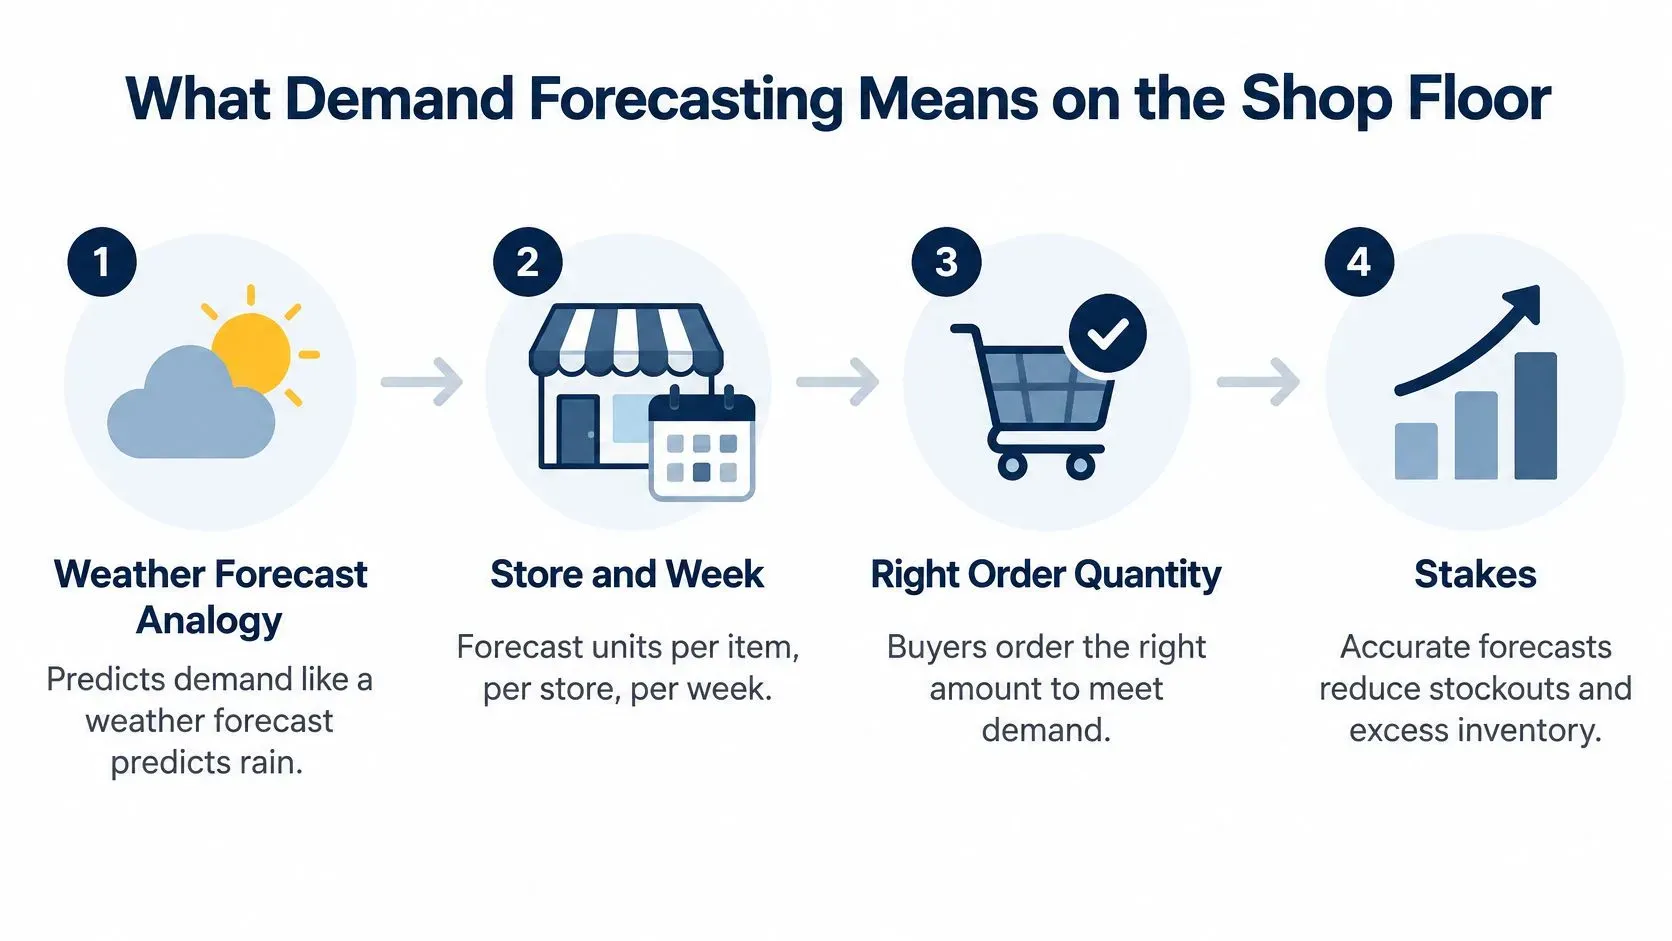
Una previsione meteo conquista fiducia quando è locale e puntuale: la probabilità di pioggia nella tua città martedì pomeriggio basta per decidere se portare l'ombrello. La previsione della domanda svolge lo stesso compito per l'inventario. Stima quante unità di un articolo specifico i clienti compreranno in un punto vendita specifico in una settimana specifica, così che il buyer ordini la quantità giusta e non una semplicemente plausibile.
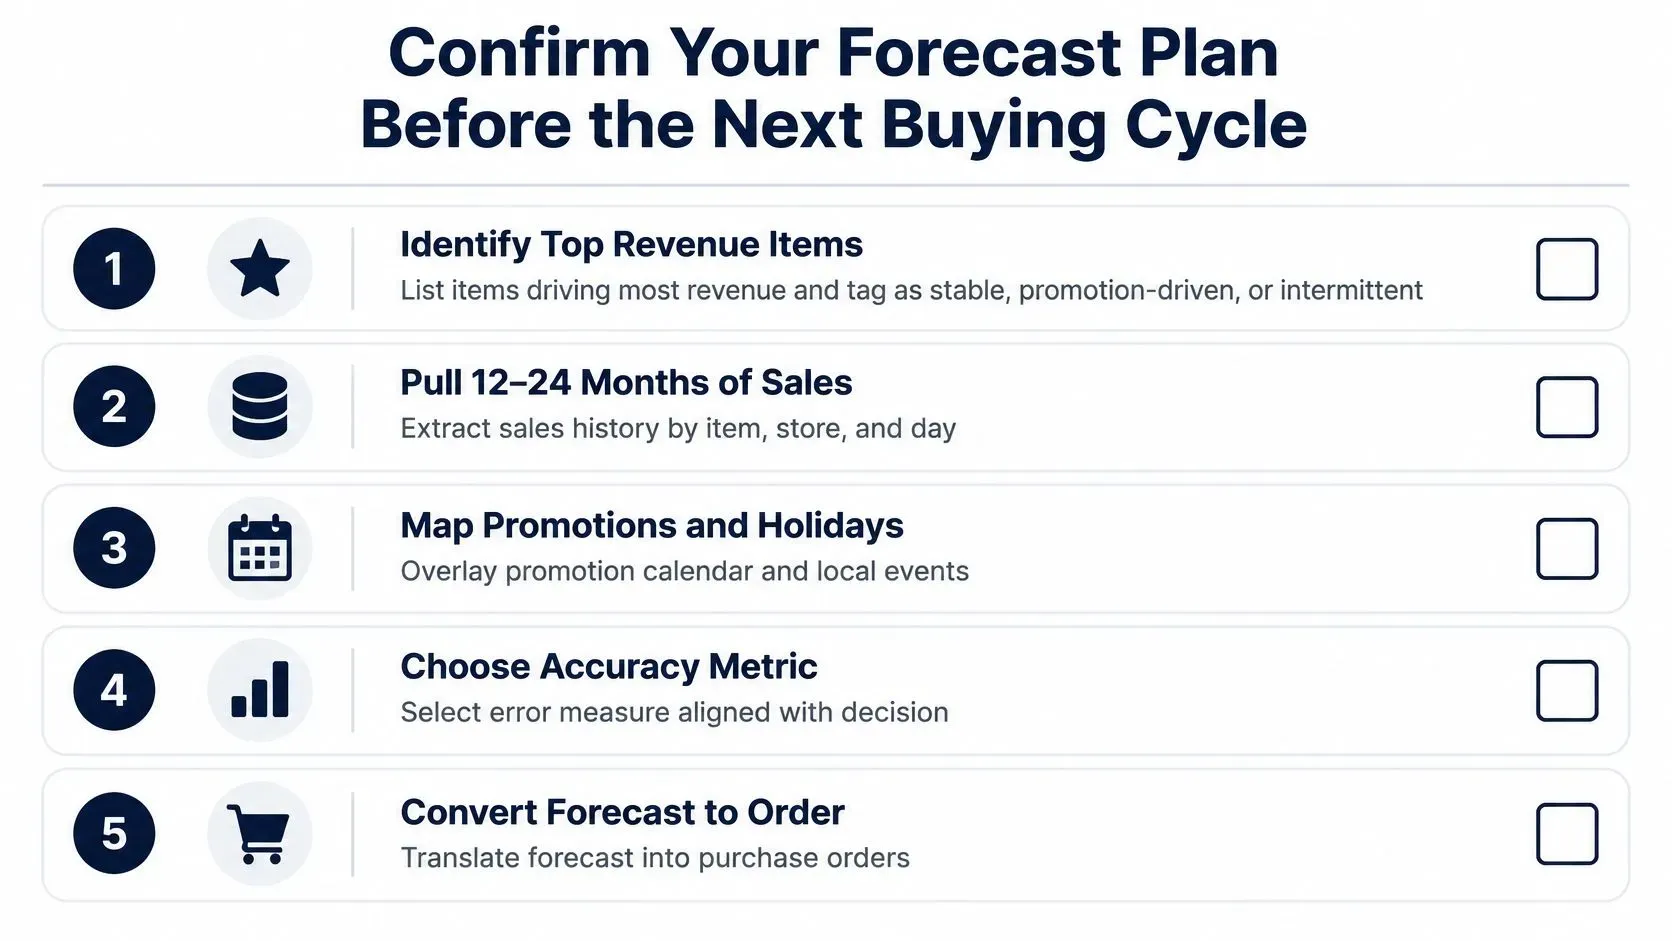
I cinque passaggi qui sotto riassumono l'idea in miniatura, dalla previsione all'ordine d'acquisto che dovrebbe far scattare.
L'obiettivo è la domanda, non il totale delle vendite che la cassa ha registrato. Uno zero registrato mentre lo scaffale dello shampoo era vuoto è domanda censurata; un picco promozionale può essere preso in prestito dalle due settimane successive o sottratto a un negozio vicino. Medie di categoria e report mensili nascondono questi problemi a livello di articolo e punto vendita, quindi il segnale deve restare granulare e aggiornarsi spesso.
Il ciclo operativo è il seguente:
- Raccogli lo storico di vendite e giacenze per articolo, punto vendita e giorno, inclusi i giorni in cui lo scaffale era vuoto.
- Pulisci e allinea i dati: una sola unità di misura, un solo calendario, nessuna riga duplicata quando un sistema di negozio ricalcola una settimana.
- Adatta il modello e prevedi la domanda per articolo e punto vendita, con la granularità richiesta dalla tua decisione d'ordine.
- Traduci la previsione in ordini e scorte di sicurezza, usando i lead time e il livello di servizio che hai promesso.
- Misura gli errori e correggi, articolo per articolo, anziché una volta l'anno al momento del budget.
Ogni passaggio protegge da uno di tre costi. Se sottostimi, perdi vendite che non recuperi, perché il cliente compra il sostituto o se ne va. Se sovrastimi, il denaro resta immobilizzato in merce che andrà scontata. Se la quantità è più o meno corretta ma i tempi sono sbagliati, paghi in entrambi i modi: sovrapprezzi di trasporto sull'ordine urgente e costi di stoccaggio sull'eccedenza.
La regola che fa risparmiare di più: una previsione vale solo se una regola di riassortimento agisce su di essa. Un numero perfetto che resta in un report non cambia nulla sullo scaffale.
Gli input di dati e perché le rotture di stock li distorcono
Prima di confrontare i modelli, guarda cosa ci metti dentro. Gli input che incidono di più sull'accuratezza nel retail sono prevedibili e poco appariscenti, e a molti team ne mancano due o tre.
- Storico delle vendite per articolo, punto vendita e giorno. Qualsiasi dato più aggregato nasconde le settimane promozionali e i picchi del weekend che portano il segnale.
- Giacenza a disposizione e durata delle rotture di stock. Senza questi dati non distingui una settimana tranquilla da uno scaffale vuoto.
- Prezzi e profondità dello sconto. Un taglio del 10% e uno del 30% non producono la stessa curva di risposta, quindi registra il prezzo a scaffale pagato dai clienti, non il prezzo di listino.
- Il calendario promozionale, incluse posizione espositiva e pubblicità in volantino.
- Festività ed eventi locali. Una sagra scolastica a due strade di distanza sposta più acqua in bottiglia di una festa nazionale.
- Meteo, in particolare per le categorie fresco, stagionali e giardinaggio.
- Prezzi dei concorrenti, ovunque tu riesca a rilevarli in modo coerente.
- Lead time dei fornitori e ritardi di consegna, che determinano quanta copertura serve.
Perché uno scaffale vuoto scrive uno zero falso
Supponi che il tuo shampoo venda in media 40 unità a settimana e che lo scaffale resti vuoto per tre giorni. Quei giorni registrano vendite pari a zero. Un modello addestrato su quello storico impara che la domanda cala ogni volta che finisce la merce, cioè l'opposto della realtà. I clienti che non hanno trovato nulla non hanno cambiato idea: sono andati altrove.
Ritardi dei fornitori, riassortimenti lenti e le tue stesse scelte d'ordine censurano le vendite esattamente allo stesso modo. Il modello non ha modo di distinguere una vendita persa da un interesse perso e continuerà a sottordinare l'articolo che si esaurisce più in fretta.
Il problema è ben documentato. Una rassegna del 2026 sul machine learning nella previsione retail individua dataset incompleti, pipeline di dati frammentate, comportamenti dei clienti in evoluzione, promozioni, reazioni dei concorrenti e stagionalità come cause di modelli distorti e fragili. La stessa rassegna cita un sondaggio su 661 professionisti dell'inventario in cui il 51% talvolta procedeva con previsioni che già riteneva inaffidabili perché non esisteva un'alternativa migliore, mentre le variazioni di dazi e politiche commerciali (19%) e le oscillazioni di inflazione o prezzi delle materie prime (17%) figuravano tra i principali fattori di disturbo.
La correzione in quattro passaggi, in ordine
- Segnala ogni giorno di rottura di stock nello storico vendite, indicando le ore o i giorni in cui l'articolo non era disponibile.
- Stima le vendite perse per quei giorni a partire da articoli comparabili nello stesso punto vendita e nella stessa settimana.
- Etichetta ogni periodo come disponibile o vincolato prima dell'avvio di qualsiasi addestramento.
- Addestra il modello sullo storico corretto e confronta i risultati su settimane di test escluse dall'addestramento, mai sulle settimane che hai corretto.
Per la maggior parte delle PMI questo lavoro migliora l'accuratezza più che cambiare algoritmo. Un modello può imparare solo ciò che i dati contengono: se lo storico dice che la domanda è crollata durante una rottura di stock, un'architettura più sofisticata imparerà la cosa sbagliata più in fretta. La nostra guida ELECTE all'integrazione di più fonti descrive l'infrastruttura che porta dati di vendite, scorte e promozioni in un'unica tabella utilizzabile.
Metodi di previsione a confronto per situazione di vendita
Non esiste un metodo migliore in assoluto, ma solo un metodo adatto alla situazione. La tabella qui sotto è il confronto che vorrei vedere appeso sopra la scrivania di chi pianifica.
Metodo | Situazione retail ideale | Dati necessari | Punto di forza | Attenzione a |
|---|---|---|---|---|
Media mobile o smorzamento esponenziale | Articoli stabili ad alto volume | 1-2 anni di vendite settimanali | Semplice, economico e facile da spiegare | Non coglie promozioni e variazioni stagionali |
Modelli stagionali come SARIMA | Articoli con chiari cicli settimanali o annuali | Storico di due o più stagioni | Cattura trend e stagionalità | Fatica con migliaia di serie contemporaneamente |
Metodi della famiglia Croston | SKU intermittenti a bassa rotazione | Storico vendite con molti periodi a zero | Separa la frequenza delle vendite dalla loro entità | Scelta sbagliata per i prodotti a vendita costante |
Regressione con variabili di promozione e prezzo | Categorie trainate dalle promozioni | Calendario promozionale e storico prezzi | Mostra come ogni fattore influenza la domanda | Perde efficacia quando le promozioni sono rare |
Ensemble di alberi come XGBoost o LightGBM | Grandi portafogli articolo-punto vendita | Vendite, calendario, promozioni e prezzi | Apprende da molte serie correlate | Richiede dati puliti e monitoraggio continuo |
Ensemble ibridi LSTM-XGBoost | Catene multicategoria con segnali ricchi | 36 mesi di dati di punto vendita e promozioni | Ha ridotto l'errore percentuale assoluto medio del 28,6% in media a un orizzonte di quattro settimane in uno studio su 14 organizzazioni retail | Più oneroso da costruire e da spiegare |
Lo schema che emerge dalle righe conta più di una singola riga. Una rassegna peer-reviewed della ricerca sulle previsioni nel retail riporta che i modelli globali di machine learning, tra cui reti neurali feed-forward e ricorrenti, alberi di regressione gradient-boosted e random forest, spesso superano modelli separati di serie storiche e di regressione quando i retailer prevedono grandi insiemi di serie di vendita. Il vantaggio cresce con le dimensioni del portafoglio: migliaia di combinazioni articolo-punto vendita in cui i singoli prodotti hanno una domanda sporadica, intermittente, stagionale o sensibile alle promozioni.
Come appare il confronto in una catena reale
Immaginate una catena regionale con 40 punti vendita. Gli articoli di base con vendite settimanali stabili usano il livellamento esponenziale, perché un category manager può leggere il numero e metterlo in discussione. L'abbigliamento stagionale con otto promozioni l'anno usa un modello gradient-boosted addestrato su tutti i punti vendita insieme, perché lo storico di un solo negozio è troppo scarso per ricavarne una curva di sconto.
La rassegna è altrettanto chiara sul fatto che i metodi più datati non sono obsoleti. Le loro prestazioni restano competitive su dataset più piccoli, prodotti stabili e contesti in cui interpretabilità e dati limitati contano più dell'ultimo punto di accuratezza.
La sobrietà paga. Una valutazione del 2026 sulla domanda retail negli Stati Uniti sul dataset M5, che copre 25.940 serie articolo-punto vendita su cinque finestre mobili di 28 giorni, ha ridotto l'errore percentuale assoluto ponderato medio da 0,9006 per un benchmark seasonal-naive a 0,7022 con un modello LightGBM basato sulla domanda storica, un miglioramento di circa il 22%. Aggiungere variabili retail e operative ha portato solo a 0,6979, e gli indicatori macroeconomici ritardati a 0,6978, un guadagno di circa lo 0,02%.
Costruite prima la baseline. Un numero seasonal-naive o di livellamento esponenziale, che richiede un pomeriggio di lavoro, vi dice se il modello di machine learning ha meritato la sua complessità. Eseguite entrambi sulle stesse settimane di test e tenete il vincitore.
La scelta del modello dovrebbe seguire la scala e la struttura del portafoglio, non la novità del metodo. Questo solo principio vi farà risparmiare più di qualsiasi ricerca di iperparametri.
Prodotti a bassa rotazione e domanda sporadica richiedono un modello dedicato
Alcuni prodotti non hanno un livello di domanda. Hanno un evento di domanda. Un ricambio che si vende quattro volte l'anno, una variante e-commerce di coda lunga, una combinazione negozio-SKU che muove due unità al mese: i modelli stagionali standard li gestiscono male, e la ragione è strutturale.
Gli zeri e le vendite positive nascono da due processi diversi. Se una vendita avvenga o meno è una domanda. Quanto sia grande quando avviene è un'altra. I metodi di tipo Croston stimano le due cose separatamente, ed è per questo che reggono sui dati retail ricchi di zeri. Un benchmark di previsione retail sulla domanda intermittente riporta per Croston un WAPE del 93,15% e un MASE di 0,9852, davanti alle alternative naive e SARIMAX con cui è stato confrontato. Leggete quel WAPE come un risultato relativo su una serie piena di zeri, non come un buon punteggio di accuratezza in termini assoluti.
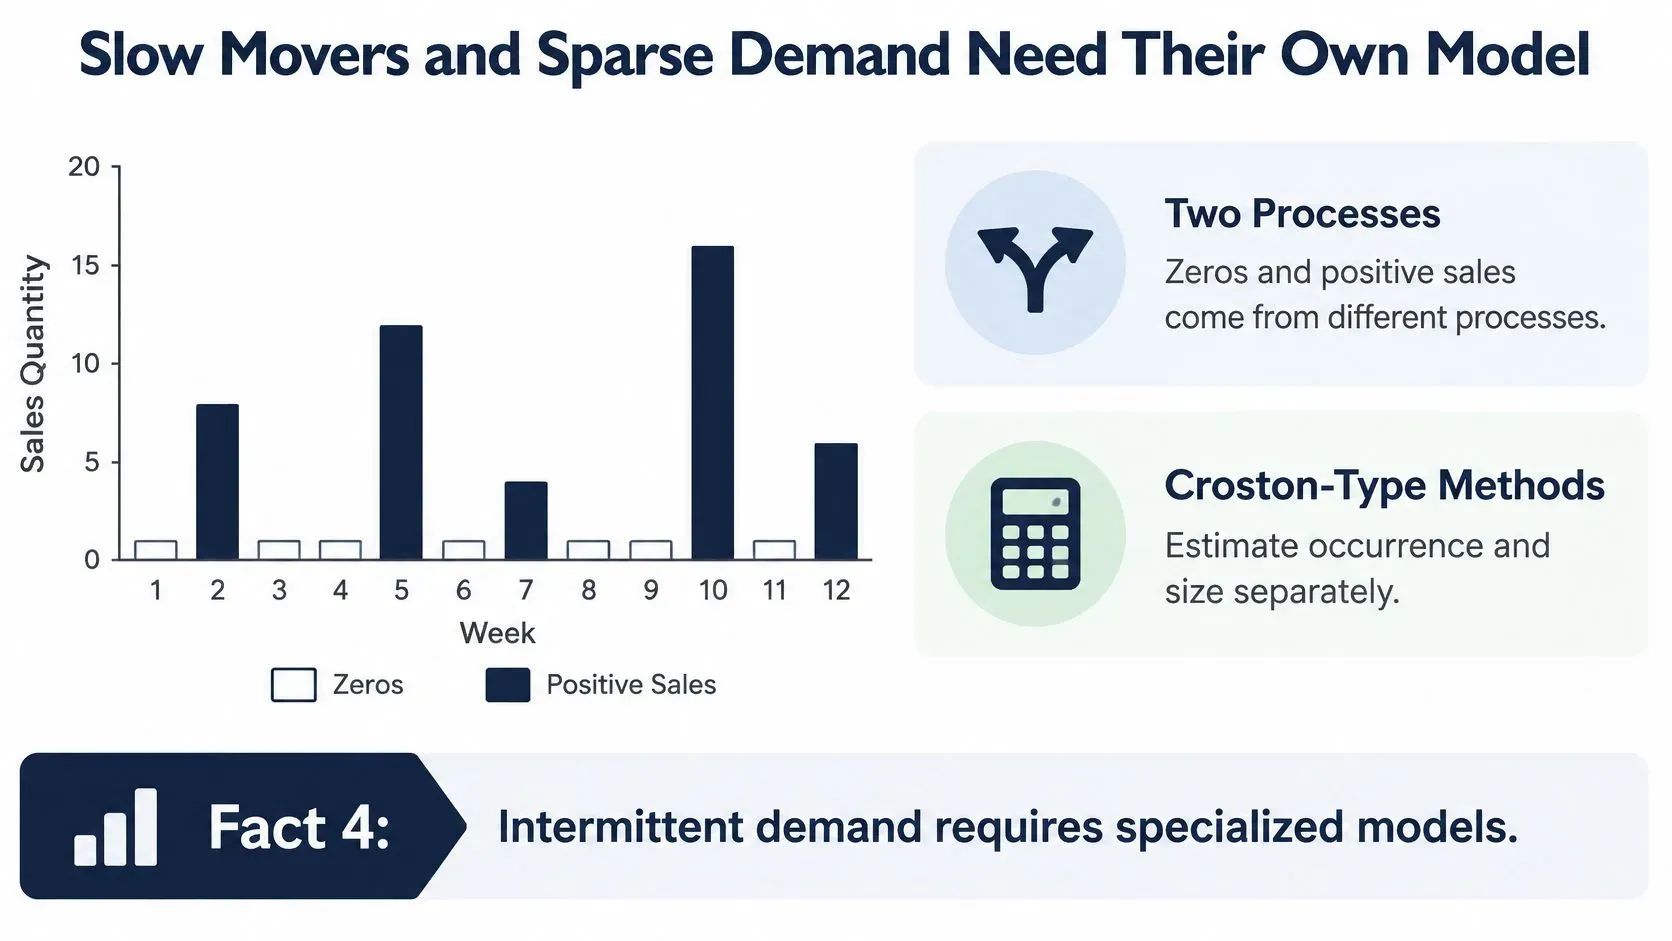
Il modo in cui il modello fallisce è specifico e costoso. Un modello di regressione o stagionale standard vede una serie di zeri e conclude che la domanda sia bassa e stabile, quindi imposta di conseguenza la scorta di sicurezza. Il prodotto a bassa rotazione che si vende a raffiche imprevedibili va poi in rottura di stock, mentre l'articolo morto mantiene tre mesi di copertura. Un errore costa una vendita, l'altro costa liquidità e spazio a scaffale.
Nello stesso ambito c'è una seconda lezione. Un benchmark su dati di vendita con domanda intermittente, osservazioni mancanti e frequente ricambio dell'assortimento ha rilevato che i modelli localizzati basati su alberi hanno ottenuto i risultati migliori tra gli approcci testati, con XGBoost che ha raggiunto il più basso errore quadratico medio riportato, pari a 4,833. La conclusione non è "usate XGBoost ovunque". È che, quando i prodotti ruotano rapidamente, i modelli costruiti per famiglia di prodotto possono battere un unico modello generalizzato costretto a fare la media tra schemi incompatibili.
Come instradare una serie
- Classificate prima di modellare. Calcolate l'intervallo medio di domanda e il coefficiente di variazione al quadrato della domanda non nulla per ogni serie. Il primo è la distanza tipica, in periodi, tra le vendite; il secondo misura quanto la dimensione di quelle vendite oscilla da una vendita all'altra.
- Instradate le serie intermittenti verso modelli della famiglia Croston, hurdle o di occorrenza-dimensione.
- Inviate gli articoli stabili e ad alto volume ai modelli stagionali o di machine learning, a cui appartengono.
- Riverificate la classificazione ogni trimestre. Gli articoli cambiano categoria quando invecchiano, vengono dismessi o prendono piede, e una regola di instradamento che non viene mai rieseguita peggiora.
Tenete la classificazione in una tabella consultabile. Quando un category manager chiede perché un prodotto è previsto con un metodo insolito, la risposta devono essere due numeri, non una scrollata di spalle.
Promozioni, accaparramento e cambi di canale
Le settimane promozionali non sono settimane ordinarie, e mescolarle nella baseline corrompe entrambe. Modellate la domanda di base e gli effetti promozionali come cose separate, poi sommateli.
Un confronto di approcci di previsione nel retail ha rilevato che gli ensemble di alberi decisionali superavano la regressione lineare, la regressione lineare penalizzata e i metodi ad albero di regressione per la domanda giornaliera a livello di catena quando gli SKU avevano più di cinque promozioni storiche. Cinque è la soglia utile in quel risultato. Al di sotto non ci sono abbastanza esempi perché un modello impari come profondità dello sconto, tempistica della promozione e interazioni con il calendario dei prodotti muovano la domanda, quindi una regolarizzazione più forte o un benchmark più semplice fa meno danni di un modello flessibile che insegue il rumore.
Date al modello variabili esplicite: stato della promozione, percentuale di sconto, posizionamento espositivo, vicinanza alle festività e domanda post-promozione ritardata. L'ultima viene spesso tralasciata, eppure è la variabile che cattura il calo.
Il calo che nessuno prevede
Supponiamo che uno sconto del 30% sullo shampoo faccia crescere le vendite per una settimana, e che poi per due settimane le vendite restino sotto il trend. I clienti hanno fatto scorta; non hanno comprato di più nel trimestre. Considera l'intera finestra di tre settimane come un'unica unità di analisi. L'errore nel periodo promozionale ti dice se hai ordinato abbastanza. L'errore post-promozione ti dice se hai ordinato troppo per il resto del mese. Se li misuri separatamente, emergono entrambe le decisioni. Se li misuri insieme, i due errori si compensano e il report sembra pulito, mentre hai sbagliato in entrambi i casi.
La ricerca sul ciclo di vita promozionale osserva che i lavori precedenti trascurano spesso la fase post-promozionale, in cui la domanda cala perché i clienti hanno fatto scorta durante l'evento, e riporta che i metodi di machine learning possono migliorare le previsioni sull'intero ciclo di vita e non solo durante la promozione.
Il canale aggiunge un secondo livello di illusione. Uno studio sulle promozioni multicanale in un supermercato regionale brasiliano ha stimato uno spostamento di domanda dell'11,23% dai punti vendita fisici all'online e del 19,34% nella direzione opposta, mentre le promozioni coordinate hanno ridotto la cannibalizzazione del 30,04%. Gli incentivi di fidelizzazione hanno prodotto l'incremento misurato più alto, pari al 3,5%. Se prevedi ogni canale in modo indipendente, conterai due volte una domanda che ha solo cambiato indirizzo.
Poi applica alla valutazione quattro regole:
- Valuta separatamente i periodi in promozione e quelli senza promozione, così una buona settimana non maschera un cattivo mese.
- Confronta con una baseline di tipo base-lift o con un'altra baseline causale simile, altrimenti misuri solo quanto bene il modello ha imparato i volumi.
- Valuta per SKU e per frequenza promozionale, perché la soglia delle cinque promozioni cambia ciò che puoi aspettarti.
- Mantieni attiva una feature di ritardo post-promozione, così il modello può esprimere il calo invece di esserne sorpreso.
Se gli sconti stanno erodendo il tuo margine, la nostra guida per proteggere i margini durante le campagne di sconto affronta il lato prezzi dello stesso problema.
Misurare l'accuratezza e trasformare le previsioni in ordini
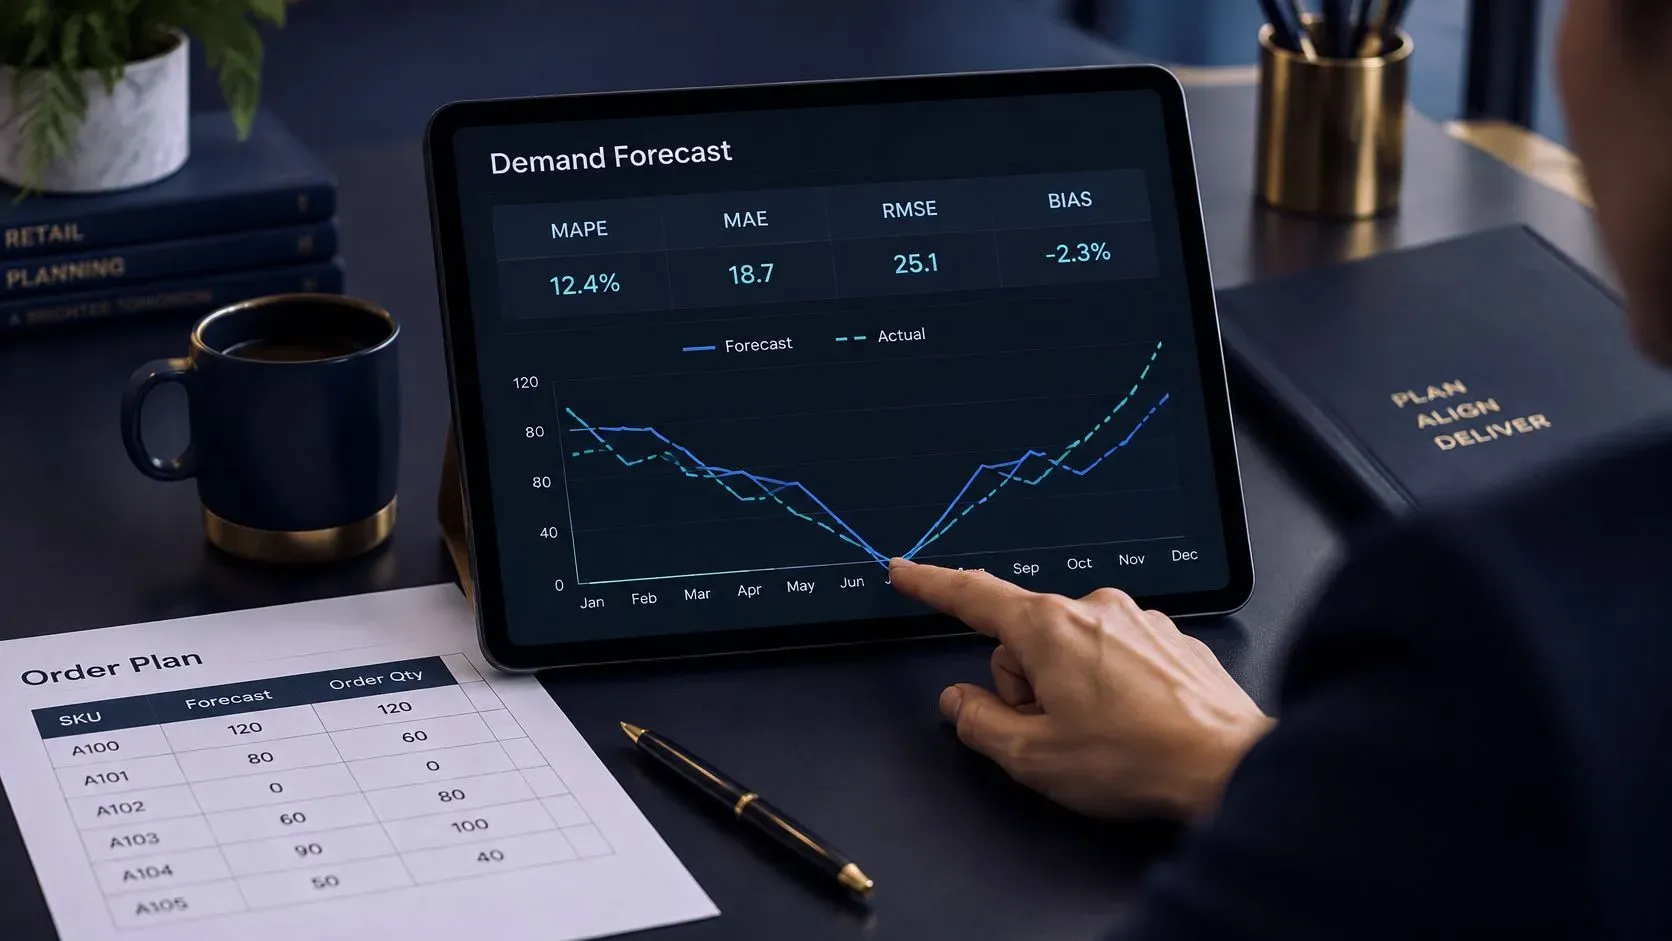
Scegli la metrica dopo aver scelto la decisione. Ogni misura risponde a una domanda diversa e nasconde qualcosa di diverso.
Metrica | Quando usarla | Attenzione a |
|---|---|---|
WAPE (errore percentuale assoluto ponderato) | Confrontare l'accuratezza tra articoli di dimensioni diverse | Dà il peso maggiore agli articoli ad alto volume |
MASE (errore assoluto medio scalato) | Confrontare modelli su serie intermittenti o con molti zeri | Richiede un benchmark naive per essere letta correttamente |
MAPE (errore percentuale assoluto medio) | Reportistica semplice su articoli stabili e ad alto volume | Instabile o indefinita quando la domanda effettiva è zero |
Bias | Individuare sovrastime o sottostime sistematiche | Errori che si compensano possono nasconderlo, se non lo si legge per periodo |
Livello di servizio | Verificare se la previsione protegge la disponibilità a scaffale | Dipende dalle impostazioni di riordino, non solo dalla previsione |
Gli errori percentuali non funzionano sugli articoli a bassa rotazione. Quando la domanda effettiva è zero, il denominatore è zero e la metrica esplode oppure viene esclusa dalla media: in entrambi i casi il modello ne esce favorito. Riporta WAPE o un errore scalato insieme a bias e livello di servizio, e leggili per segmento invece che come un unico numero per l'intero catalogo.
Da un numero a un punto di riordino
Una previsione diventa un ordine tramite un calcolo che chiunque nel team può verificare. La domanda attesa durante il lead time, più una scorta di sicurezza dimensionata sul livello di servizio obiettivo, dà il punto di riordino.
Ipotizziamo che un negozio preveda 40 unità in un lead time del fornitore di cinque giorni e mantenga un buffer di 10 unità. Il punto di riordino è 50 unità. Quando la somma tra giacenza e ordinato in arrivo scende a 50, parte l'ordine. Se il buyer ordina a 40 perché il buffer non è mai stato concordato, lo scaffale si svuota il primo giorno in cui il camion è in ritardo.
Due routine aiutano a mantenere i dati affidabili. Imposta avvisi di eccezione quando l'errore di previsione su un articolo supera la tua soglia per due o più periodi consecutivi, così qualcuno guarda l'articolo e non solo la dashboard. Esegui ogni mese un controllo del bias per categoria, per individuare sovrastime o sottostime sistematiche che gli errori dei singoli articoli, in media, nascondono.
Una previsione statisticamente accurata può comunque causare carenze di stock se i tempi di ordine, la frequenza di revisione o la scorta di sicurezza sono tarati male. Rivedi insieme la previsione e le regole di riordino, altrimenti continuerai a correggere quella sbagliata.
La nostra guida ELECTE all'analisi dei dati di magazzino approfondisce come collegare le giacenze ai numeri su cui agiscono i buyer.
Conferma il piano previsionale prima del prossimo ciclo di acquisto
Prima di effettuare il prossimo ordine, verifica che il processo di previsione sia adatto ai prodotti e alle decisioni che deve supportare. Cinque controlli rendono il piano concreto:
- Fai una selezione dell'assortimento. Individua gli articoli che generano la maggior parte del fatturato, poi classificali come stabili, guidati dalle promozioni o intermittenti. Per gli altri può bastare una regola più semplice.
- Controlla lo storico delle vendite. Estrai da 12 a 24 mesi di vendite per articolo, punto vendita e giorno, e segnala i giorni di stockout. Se hai solo 12 mesi, usa comunque i dati, ma aspettati un errore più ampio.
- Testa rispetto a una baseline. Definisci una baseline stagionale e confronta modelli più sofisticati su settimane escluse dall'addestramento. Il risultato M5 citato sopra mostra perché un modello più complesso deve guadagnarsi il suo posto.
- Definisci la routine di misurazione. Scegli una metrica per ogni decisione, poi mantieni coerenti soglia e cadenza di revisione da un ciclo all'altro.
- Rivedi gli errori ripetuti. Ricontrolla i punti di riordino degli articoli con errori di previsione ricorrenti prima di effettuare l'ordine.
ELECTE applica sei metodi di previsione ai dati dell'utente, li confronta tra loro e seleziona il più accurato. Il suo calcolatore gratuito del punto di riordino aiuta a calcolare il punto di riordino del singolo articolo.
Le previsioni riducono il rischio, ma non possono tenere conto di ogni cambiamento. Un modello può non cogliere il lancio di un nuovo prodotto o una promozione senza storico di vendite comparabile. Affianca alla previsione una routine di revisione, così i buyer possono reagire quando la domanda reale si discosta dal piano.
ELECTE collega i dati di vendite, giacenze e promozioni, confronta sei metodi di previsione sui dati disponibili e presenta previsioni, accuratezza ed eccezioni in dashboard visive che i team possono condividere. Se sei un retailer e vuoi valutare le previsioni di domanda insieme ai tuoi dati di vendita, visita ELECTE.
Commenti
Ancora nessun commento — inizia tu la conversazione.